
Guides / 视频转图文攻略
7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
七分钟图解:自回归 LLM 如何成为工作流自动化瓶颈、Jev 并行采样如何实现 70–500ms 响应,以及专精模型在 Pareto 前沿的位置。
分步图文攻略
- 1
理解 AI 应用栈如何反向塑造模型设计
从 ChatGPT(2022)到编程 Agent(2025),模型持续优化人类辅助与可验证编程奖励。工作流自动化——邮件分拣、RAG 路由、游戏 tick、模型路由——在 Demo 中可行,却在生产规模下因延迟与成本崩溃。TypeSafe AI 认为瓶颈在架构:把聊天优化模型硬塞进确定性自动化是错误抽象。
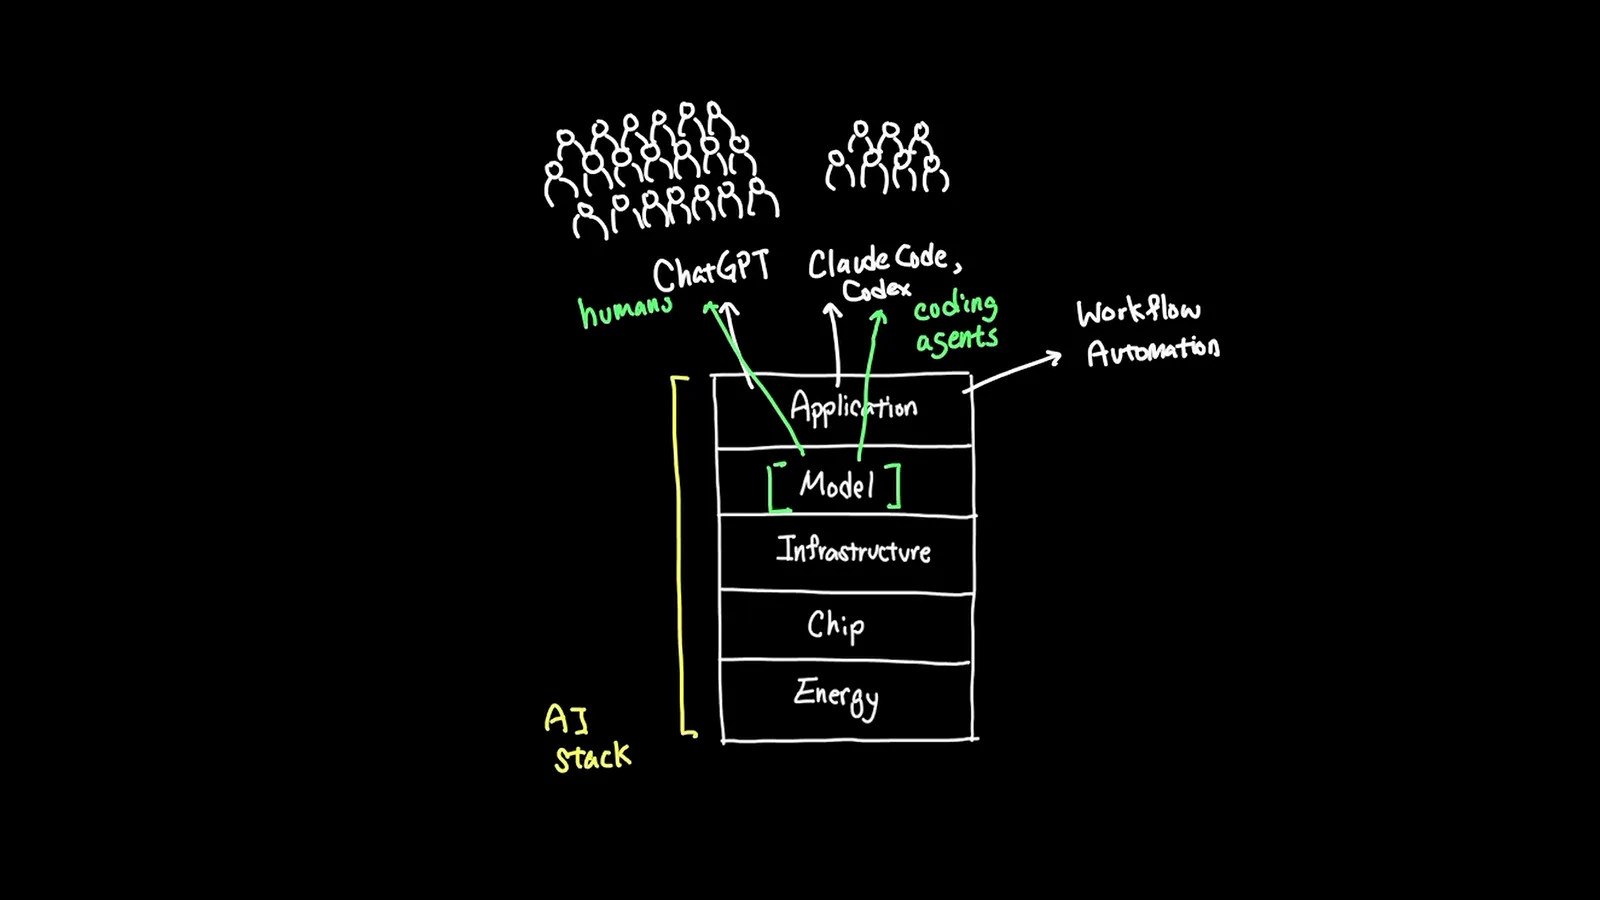
应用层对速度的诉求,拉动整个栈向决策原生模型演进。跳转至 0:45 - 2
对比自回归延迟与 Jev 并行采样
LLM 可以 mimic Jev 的 JSON 输出,但必须逐 Token 生成直至结束——无法在规模上匹配 70–500ms 端到端。Jev 为并行采样与 typed 概率决策而设计,单次前向完成。社区项目首先展示速度:收件箱分流、RAG 改进、Doom 以 10 QPS 运行约 $7/小时——LLM 能做,但达不到自动化级节拍。
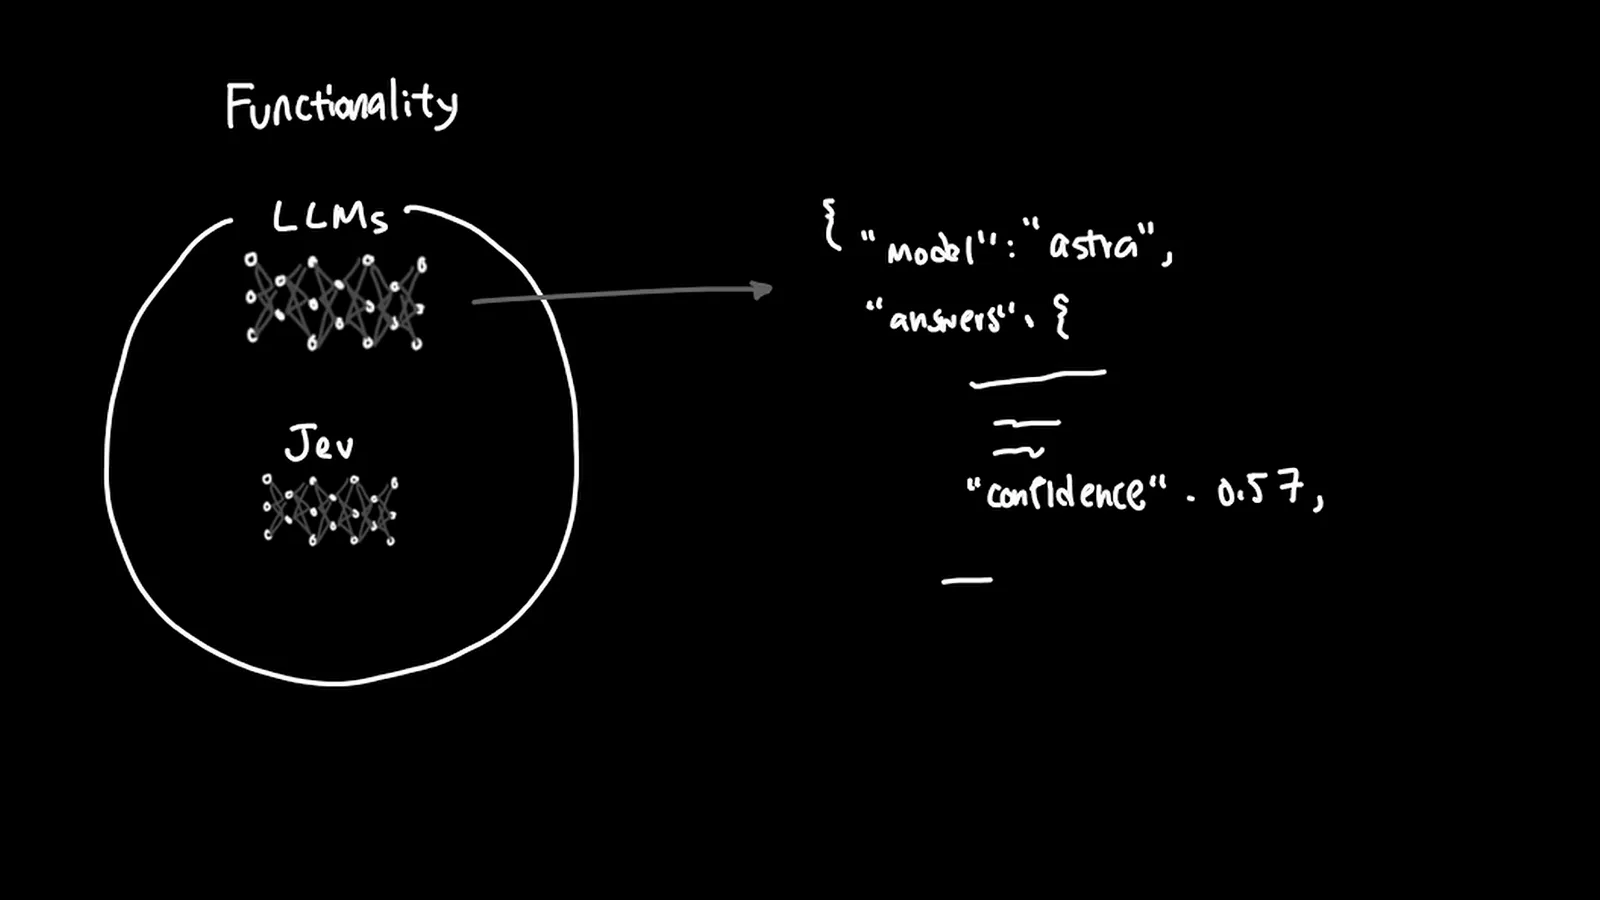
端到端 70–500ms vs 多秒自回归循环——自动化的分水岭。跳转至 2:20 - 3
把 Choice、Score、Noul 当作软件逻辑门
Jev 禁止 raw-text 问答。输入是结构化 state,输出是 schema 上的概率分布。Choice 选类别,Score 在你的刻度上排序,Noul 返回 P(yes)。三者像寄存器与逻辑门组合——工程师在其上堆叠抽象,而非解析 LLM 自由文本。用 Claude Opus 排序长植物列表需数秒;Jev 一至两秒完成。
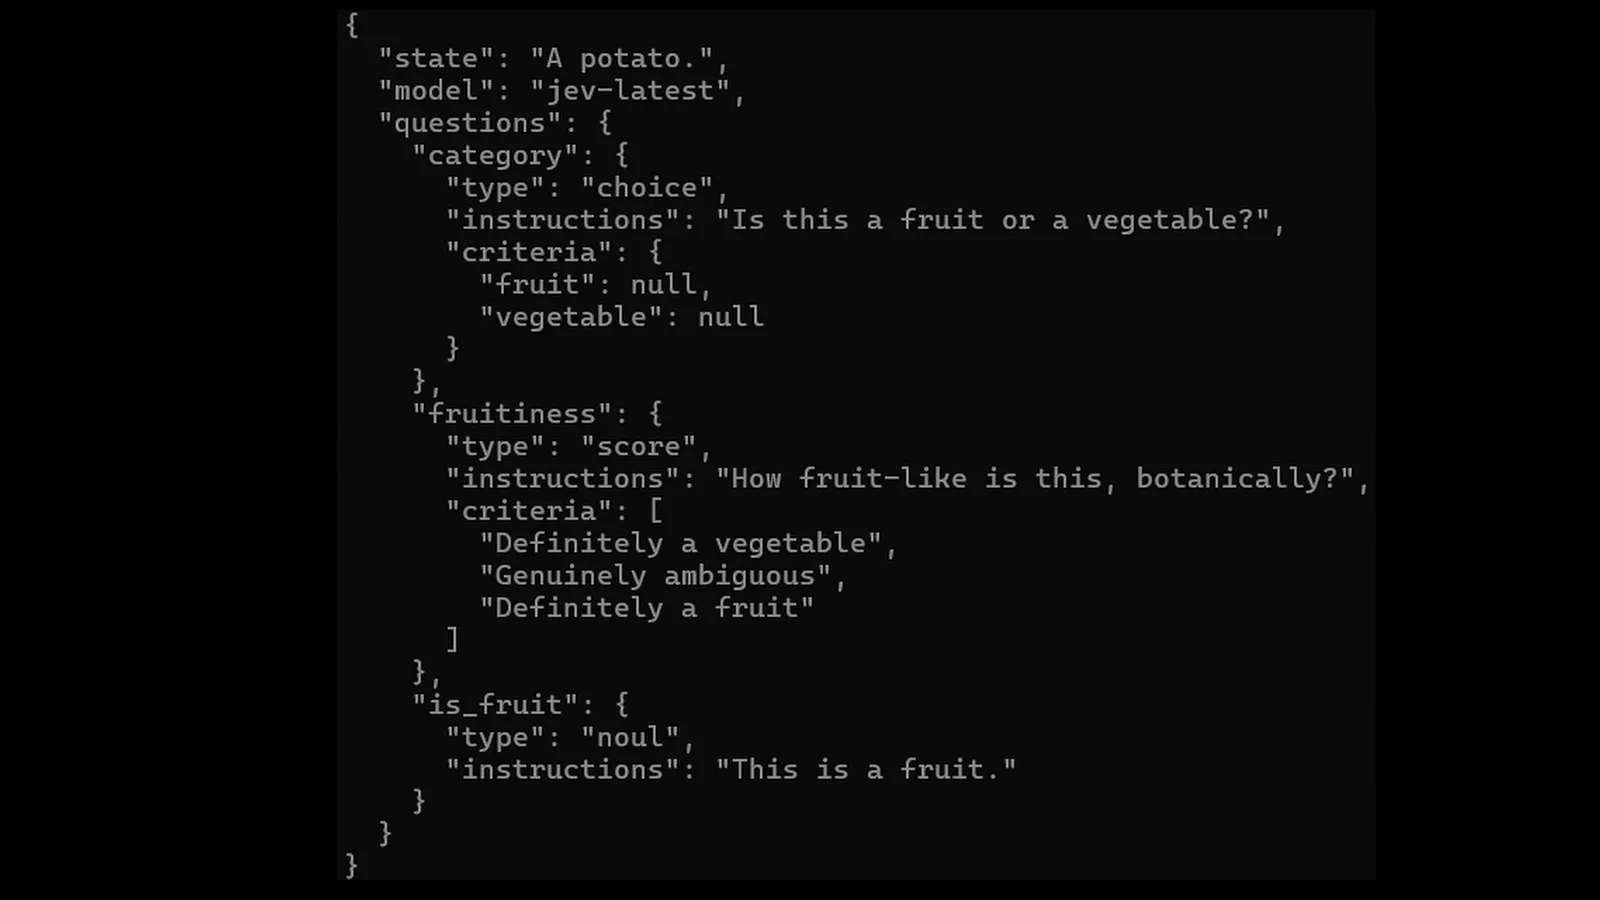
三大 typed 原语取代模糊自然语言指令。跳转至 4:30 - 4
在 Pareto 前沿上定位 Jev 专精模型
在工作流专用任务上,Jev 与 Flash/Nano 档(GPT-5.6 Luna、DeepSeek v4 Flash、Sonnet 5)在速度与成本上竞争——而非开放式推理。愿景是横向扩展:前沿模型负责创意,日常模型负责闲聊,Jev 等决策模型填充自动化象限。生成式 AI 之前就有窄模型;Jev 让这一类别再次清晰可见。
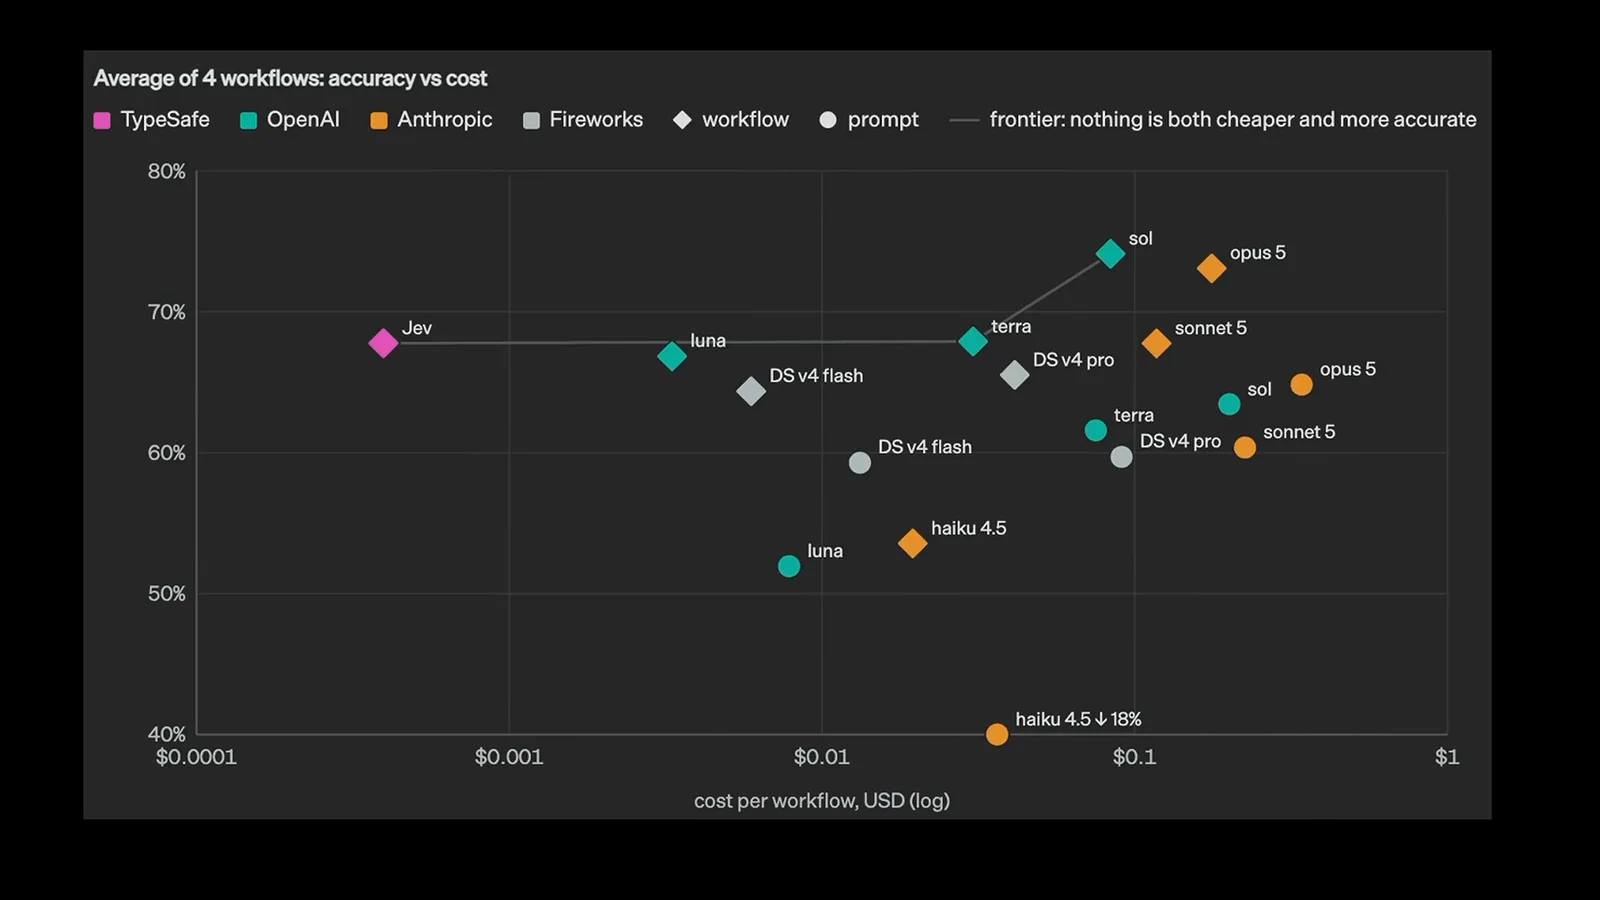
专精决策模型在成本/延迟前沿占据独立生态位。跳转至 5:30
常见问题(FAQ)
前沿 LLM 能否完全复制 Jev 的输出?
功能上可以——Structured Outputs 与 JSON Mode 能返回类似标签。但要匹配 Jev 延迟(70–500ms)与校准概率,需要不同架构(并行采样、RLCD 训练),而非在自回归模型上写更长 Prompt。
RLCD 是什么,为何对自动化重要?
Reinforcement Learning for Calibrated Decisions 按 empirical 结果优化概率输出,而非人类偏好的聊天语气。RLHF 可能让模型「听起来自信却错了」;RLCD 追求认知诚实——90% 置信度在 aggregate 上应接近 90% 准确率,可安全用于 if/else 自动化。
Jev 是更小 LLM 还是新架构?
TypeSafe AI 尚未发布完整架构论文。推测为利用 prefill 阶段 head 做分类/回归的 transformer,而非顺序解码——但运营层面的保证是 schema 有界输出与并行推理,而非仅靠模型尺寸。
何时仍应使用通用 LLM 而非 Jev?
开放式生成、多步推理、代码合成与创意写作仍是 LLM 主场。当软件需要带置信度的 typed 决策——路由、审核门禁、Agent 工具选择、游戏状态分类或任意规模化 smart if——时使用 Jev。