
Jev 入门 / 体系化学习路径
Jev 入门教程:从概念到第一个可运行决策
告别难以预测的聊天大模型。按“核心概念、输出类型、API 接入、工程容错”的体系化路径,将业务决策转化为确定性的类型化代码。
速查导读:什么是 Jev 学习路径?
Jev 是专为软件业务逻辑设计的类型化 AI 决策模型(System One Model)。与传统聊天大模型输出非结构化文本不同,Jev 接收上下文 state 与问题规范,直接输出离散选项(Choice)、连续分值(Score)或二值判断(Noul),并原生附带置信度(Confidence)。学习 Jev 的核心不是学 Prompt 技巧,而是将业务逻辑转化为明确的 schema,并在代码中设置严格的 fallback 边界。
Learning Tracks
三条推荐学习路径
根据你的技术背景和项目阶段,选择最适合的切入点:
在线体验与概念建立
适合初次接触 Jev 的开发者。无需配置本地环境,直接在网页中理解输入 state、typed answer 与 confidence 概率分布。
- 打开 Playground 在线体验
- 阅读 Jev 是什么
- 区分 Choice 与 Score
API 协议与代码工程化
适合正在为生产系统接入自动化决策的工程师。学习标准 HTTP 请求结构,并在 Node.js 或 Python 中编写类型安全的调用。
- 阅读 Jev API 协议规范
- 选择 TypeScript 或 Python SDK
- 用 zod 校验返回值结构
Schema 设计与生产兜底
适合负责业务规则系统、工单流转、安全审核的架构师。把自然语言业务规范转为清晰 criteria,并制定熔断策略。
- 使用 Schema Builder 建模
- 研究 5 大生产级 Recipes
- 制定置信度与 Fallback 策略
Curriculum
核心专题指南
六大技术主题,覆盖从原理、输出规范到双语言接入与安全防护:
Jev 是什么?
区分 decision model 与普通生成式聊天模型,理解 state、question 和 typed answer 的运作机理。
阅读指南Choice、Score、Noul 怎么选
从软件下一步动作出发,掌握三种原生输出类型的适用场景与最小化验证原则。
阅读指南Jev API 怎么接
详解标准请求结构、API key 认证、多 provider 调度、usage 统计与错误响应生命周期。
阅读指南用 Python 调 Jev
适合后端脚本、Jupyter Notebook、数据批处理管道和离线评测任务的最小可复现示例。
阅读指南用 TypeScript 调 Jev
在 Node.js API 路由、Next.js 或 Cloudflare Worker 中严格校验类型并隔离 provider 细节。
阅读指南Confidence 与 Fallback
不要把置信度等同于绝对正确率;在业务层预先定义当模型犹豫时由谁接管系统动作。
阅读指南Video Guides
精选视频图文攻略
把 YouTube 演示整理为分步图文攻略,附经核对的截图、独立图片说明和原视频时间点。
Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
OpenRouter 接入、三大原子类型与真实概率分布,覆盖路由、情绪与二值门禁场景。
阅读攻略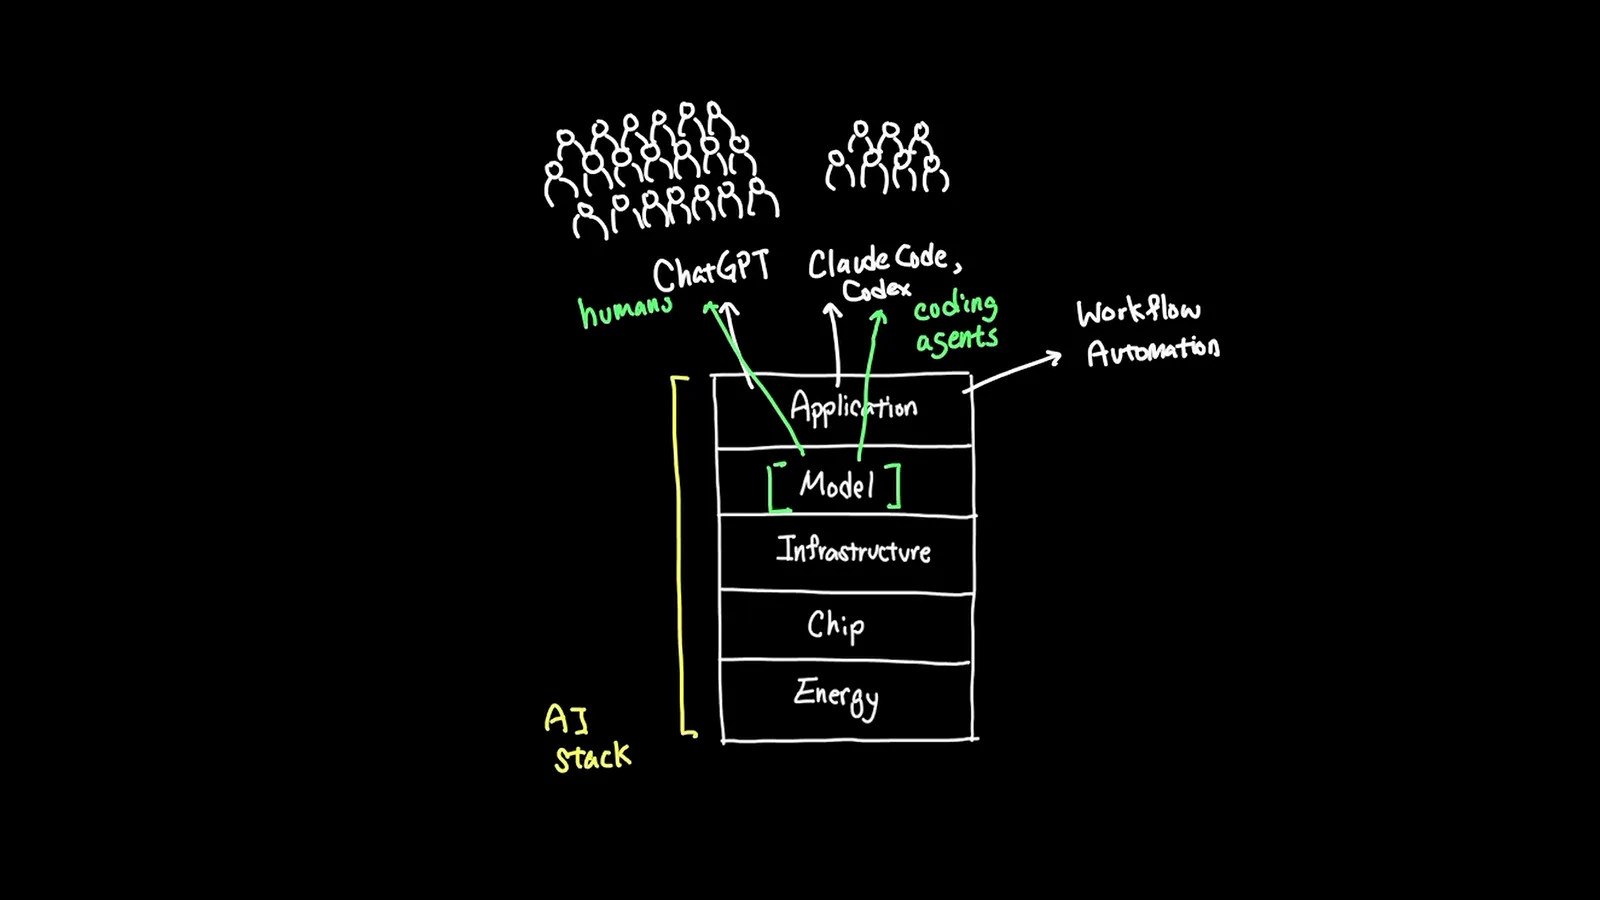
7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
解释聊天优化 LLM 为何无法满足自动化 SLA,以及 Jev 并行采样如何成为 70–500ms 的逻辑门层。
阅读攻略
Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
DOM 快照过滤、Parallel Sampler 动作映射、RLCD 校准与双模型循环,实现亚秒级浏览器自动化。
阅读攻略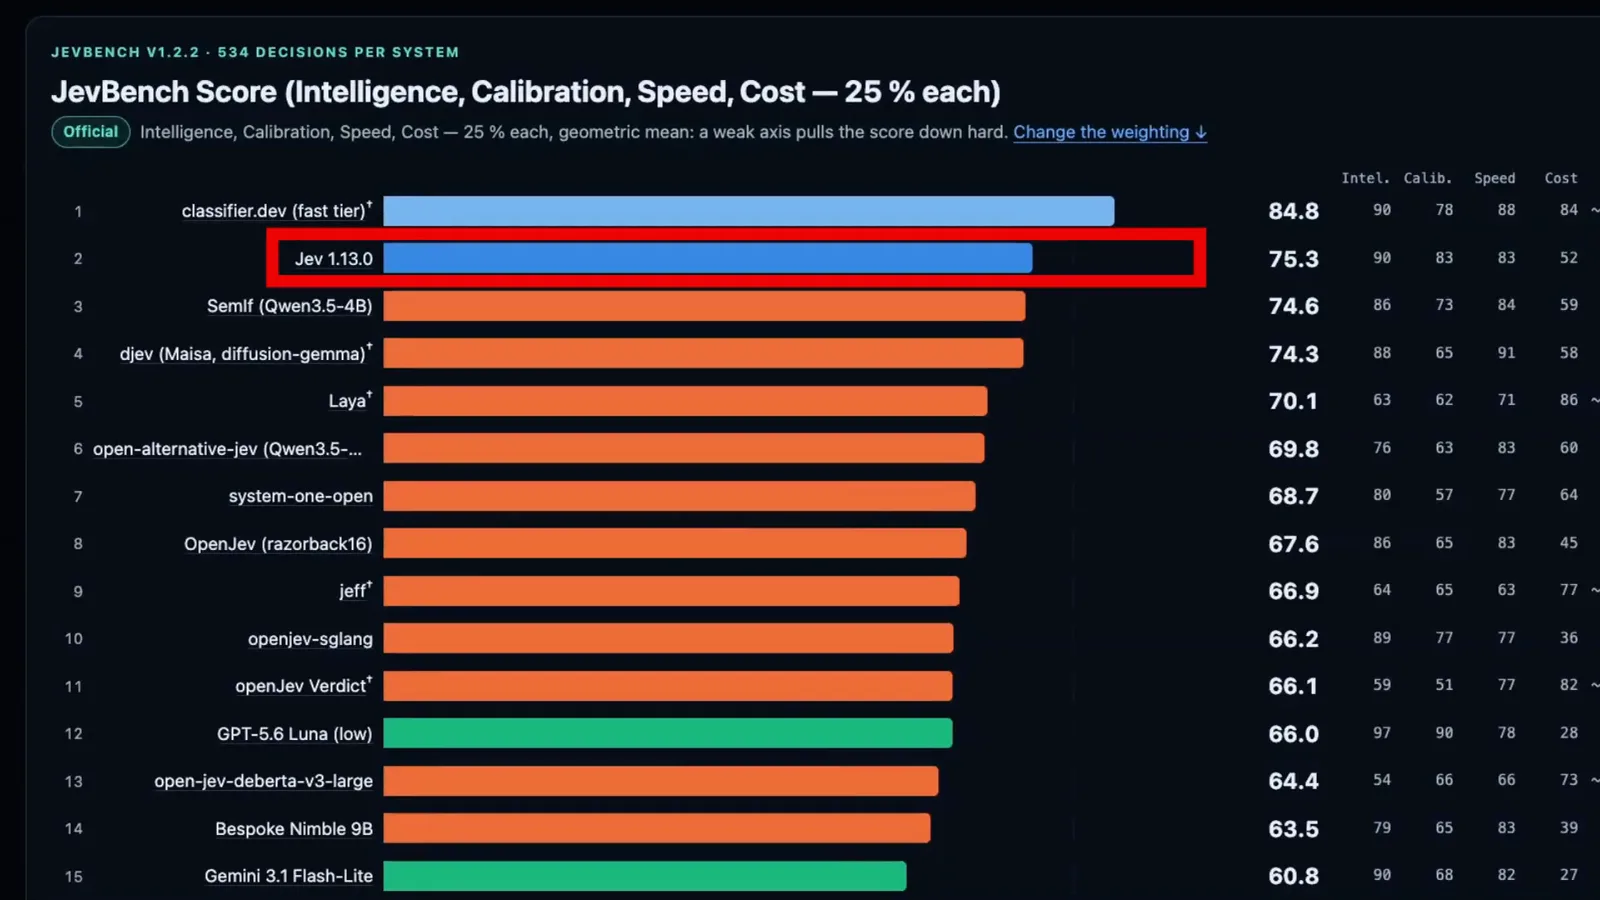
OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
开源 Jev 生态全景:六套开源实现各自怎么工作、JevBench 怎么排名、哪一套适合在本地跑起来。
阅读攻略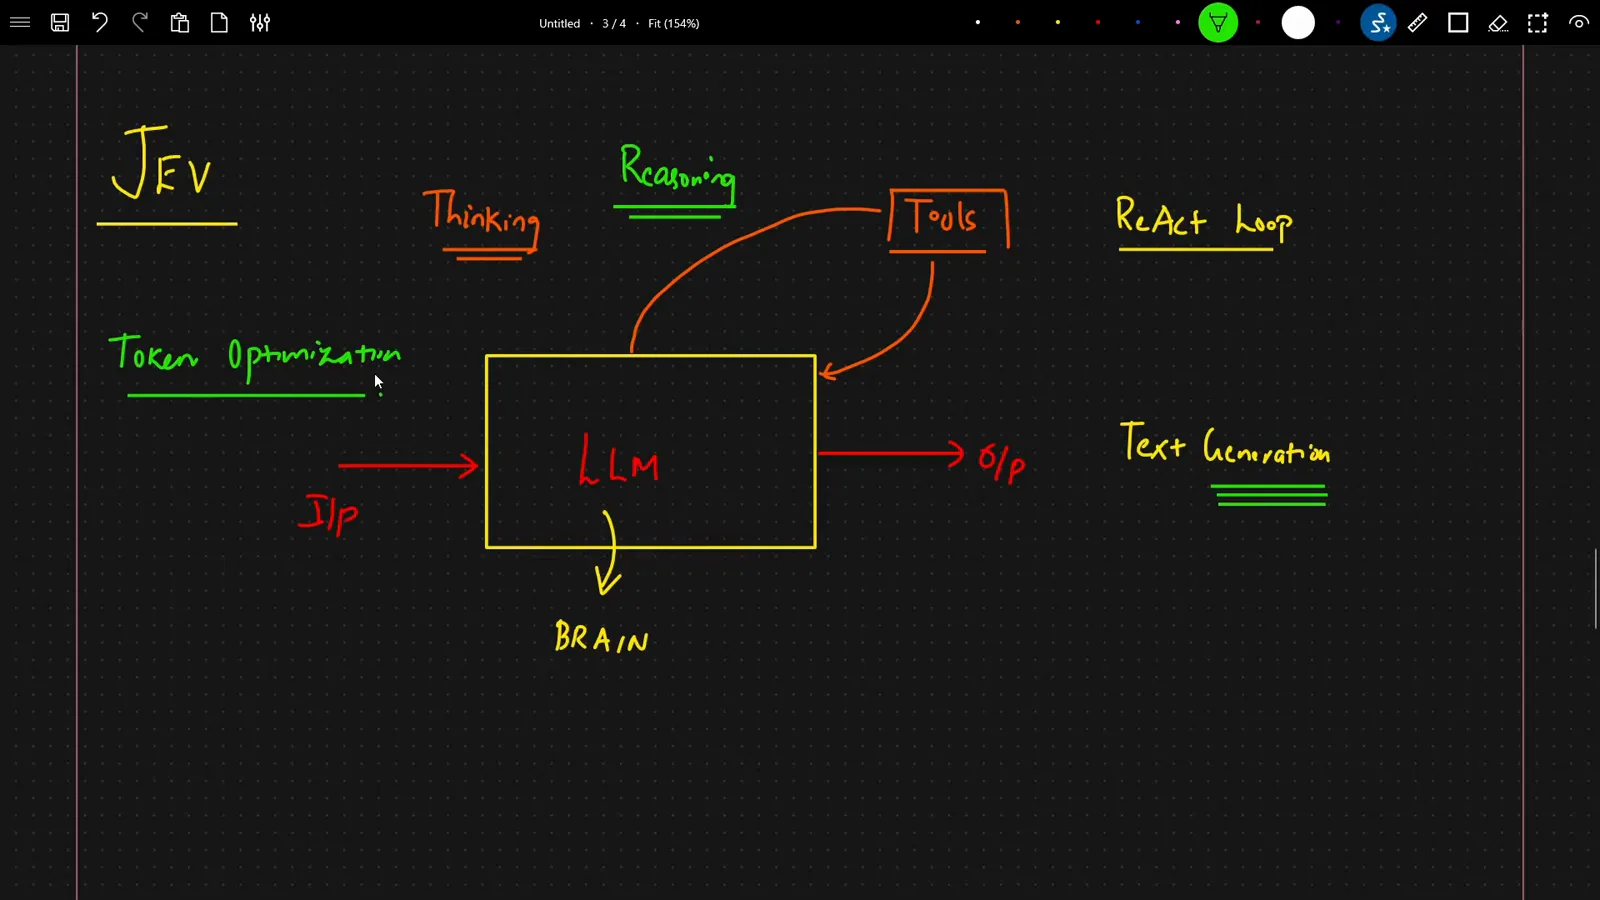
Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
一份 Jev vs LLM 的白板图解:ReAct 循环的 Token 代价、Jev 如何把非结构化查询变成概率分布,以及两者协作的混合架构。
阅读攻略
Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
六分钟跑通 Jev Trader:clone 仓库、bun 安装、分离 RPC 通路、通过 18ms 基准,亲眼看 dry-run 做市机器人在 300ms 出块窗口里思考。
阅读攻略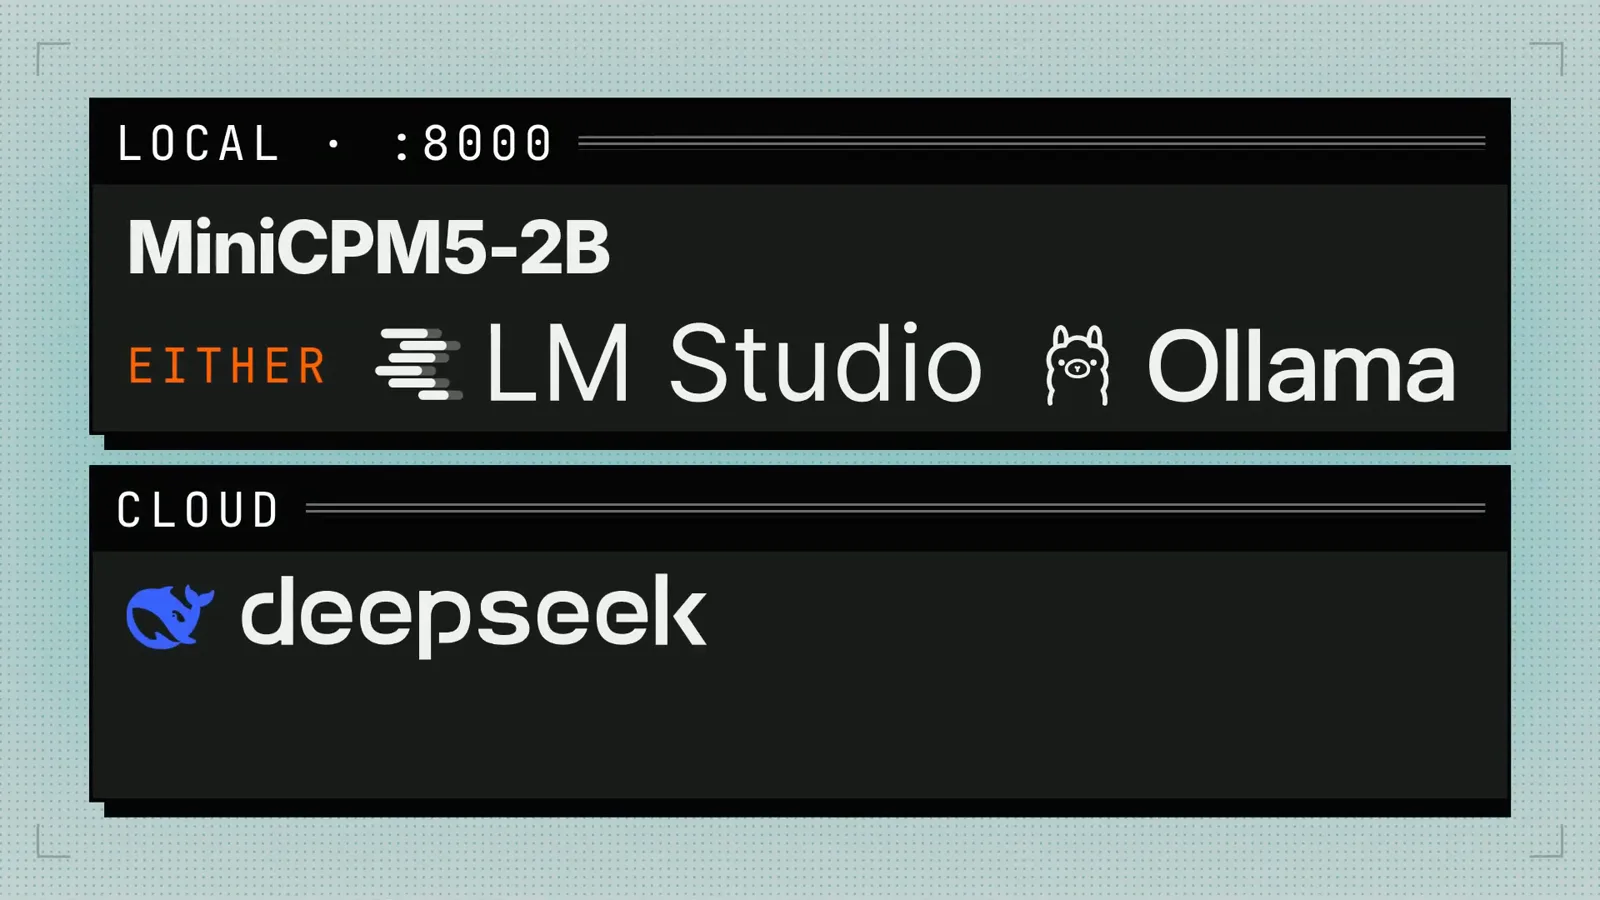
Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
19 分钟搭好本地模型路由器:一次 Jev 调用选定通道、拦下隐私、75% 请求全程不出本机。
阅读攻略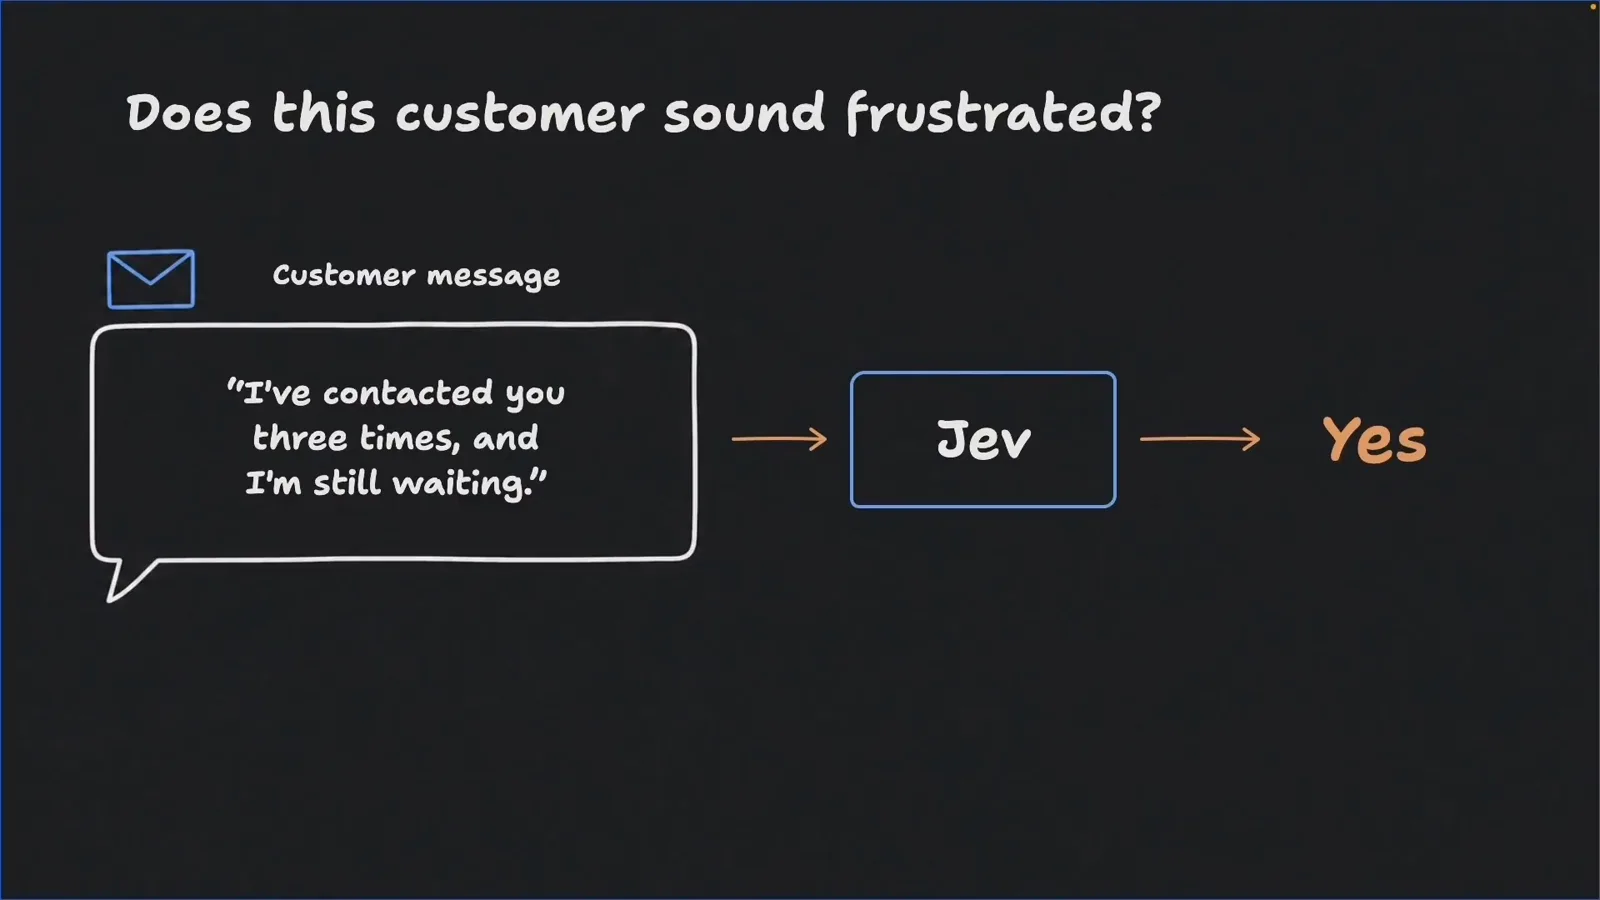
Jev 入门教程:State、三类问题与 TypeScript SDK 实操
22 分钟零基础 Jev 课,重排成六步图文:从「会听人话的 if 语句」到跑通 TypeScript SDK。
阅读攻略
本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
在自己硬件上跑哪一种 Jev 系模型:Kev、SemIf 还是 Von——基准数据与硬件分级一次讲清。
阅读攻略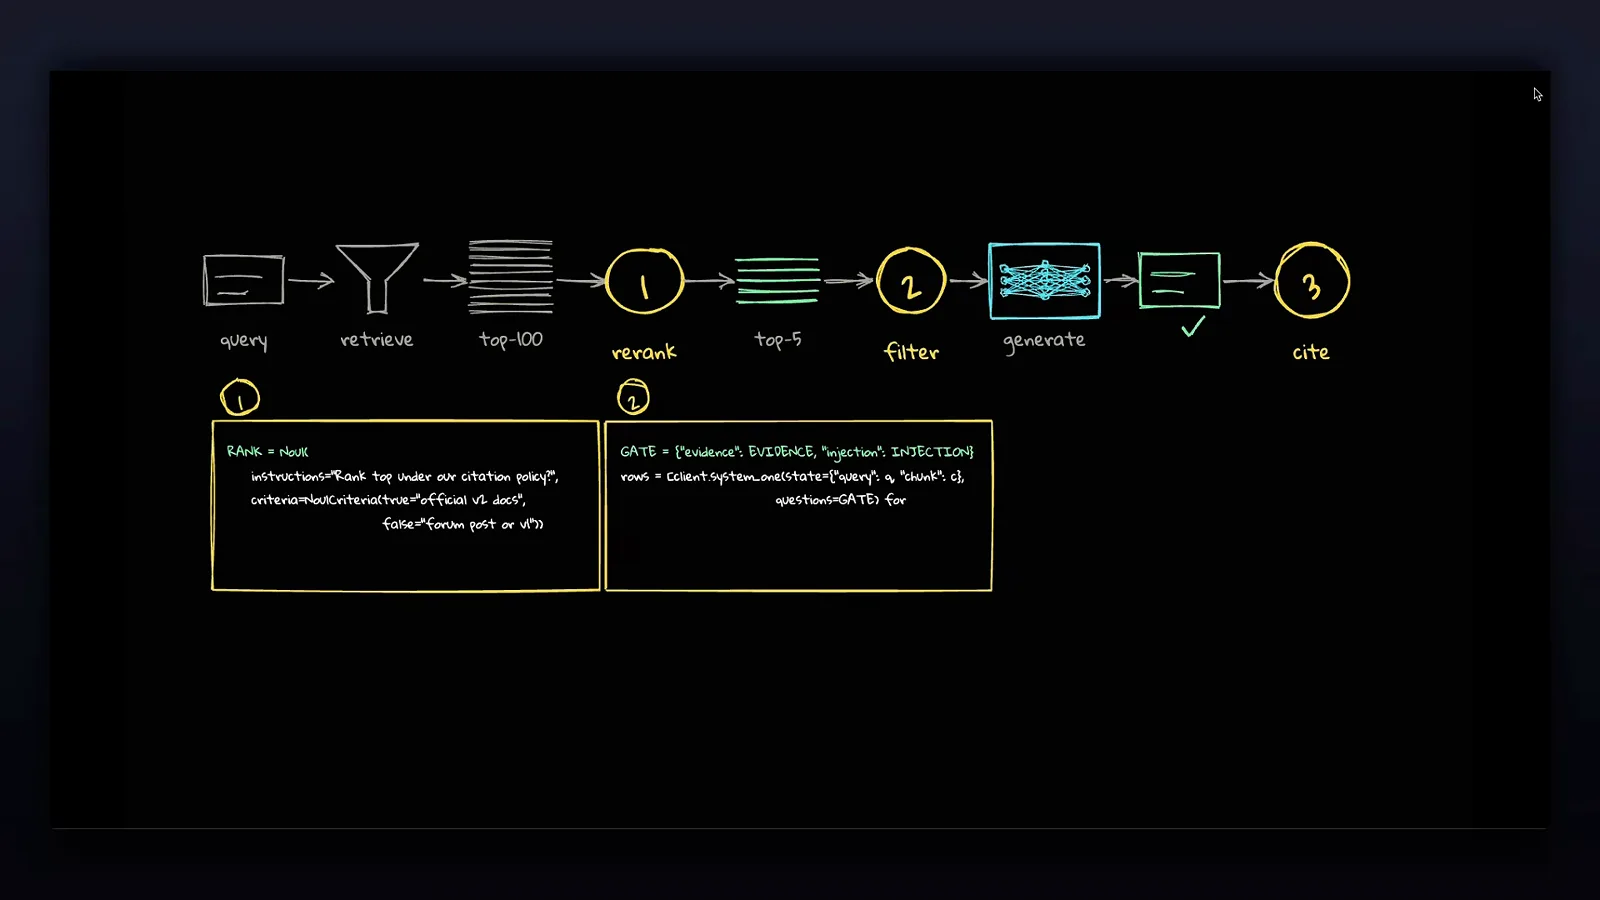
Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
11 分钟看懂 Jev 当 RAG 重排器:criteria 写成可执行策略,top-100 收窄到 top-5,策略一改排名就翻转,BM25 top-1 准确率 21% 提到 54%,成本几乎持平。
阅读攻略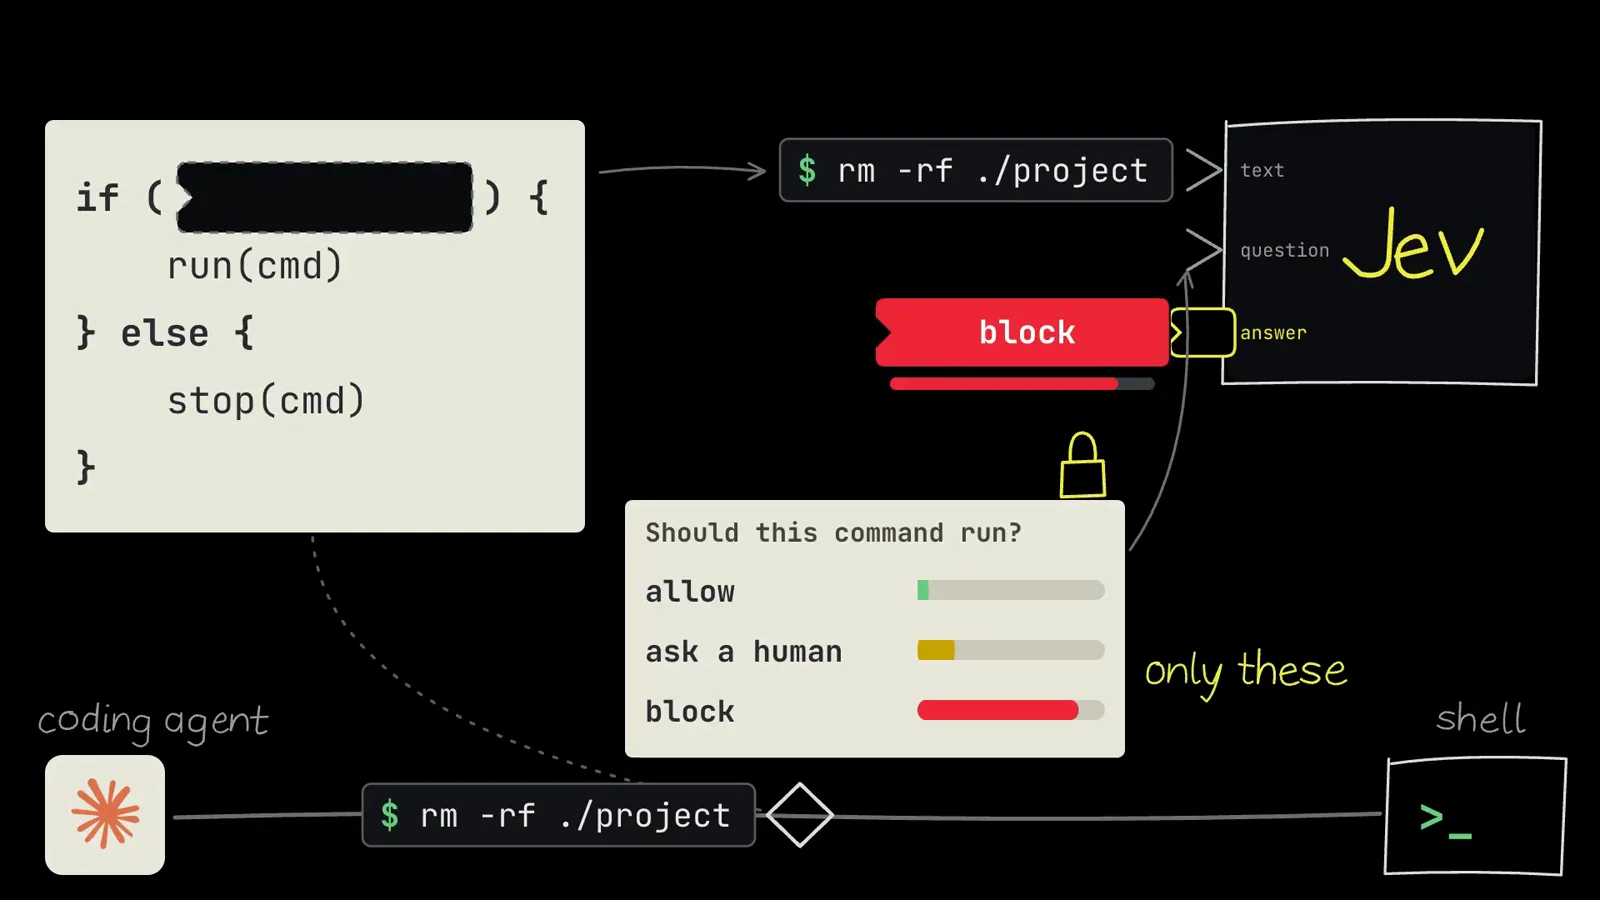
Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
16 分钟工程审计:独立实测里 Jev 的夸张倍数缩水到 3 倍快、12 倍省,窄问题加加权才能打赢宽问题。
阅读攻略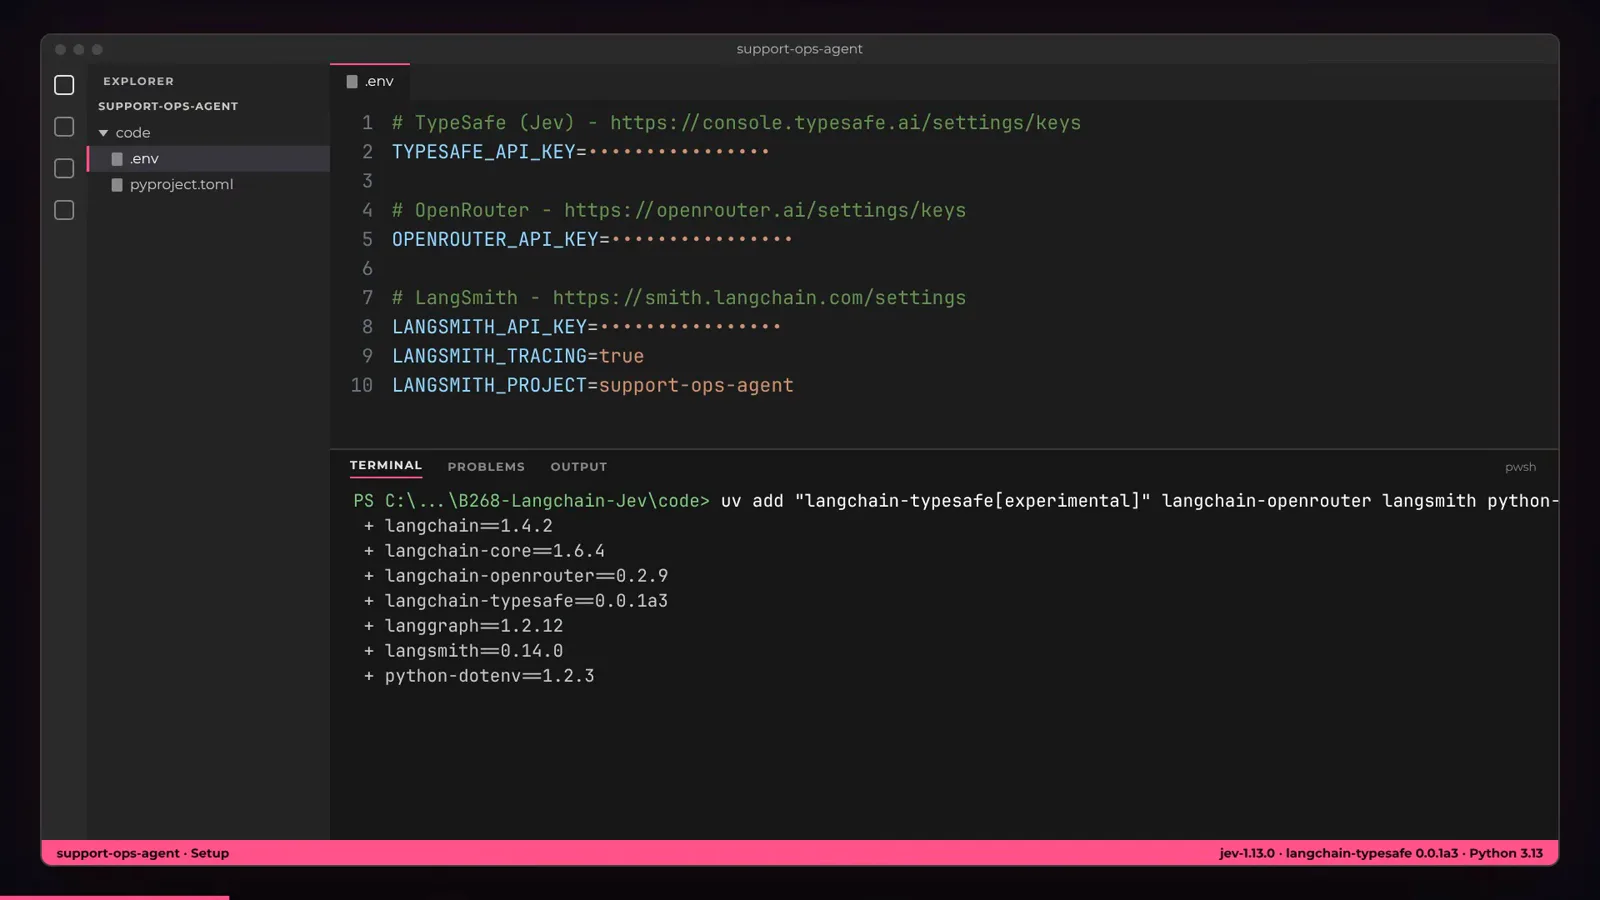
LangChain + Jev 集成实战:路由、护栏与评测
17 分钟的 LangChain 集成课:一次类型化 Jev 调用、三个中间件(triage、router、guard),外加一个判词与 Sonnet 一致、价格约其 1/230 的裁判。
阅读攻略
Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
Jev 没有官方 MCP server——官方只出 Agent Skill,社区建了 20+ 个。用 22 分钟的抽帧吃透它们共同封装的 state + 类型化问题决策层。
阅读攻略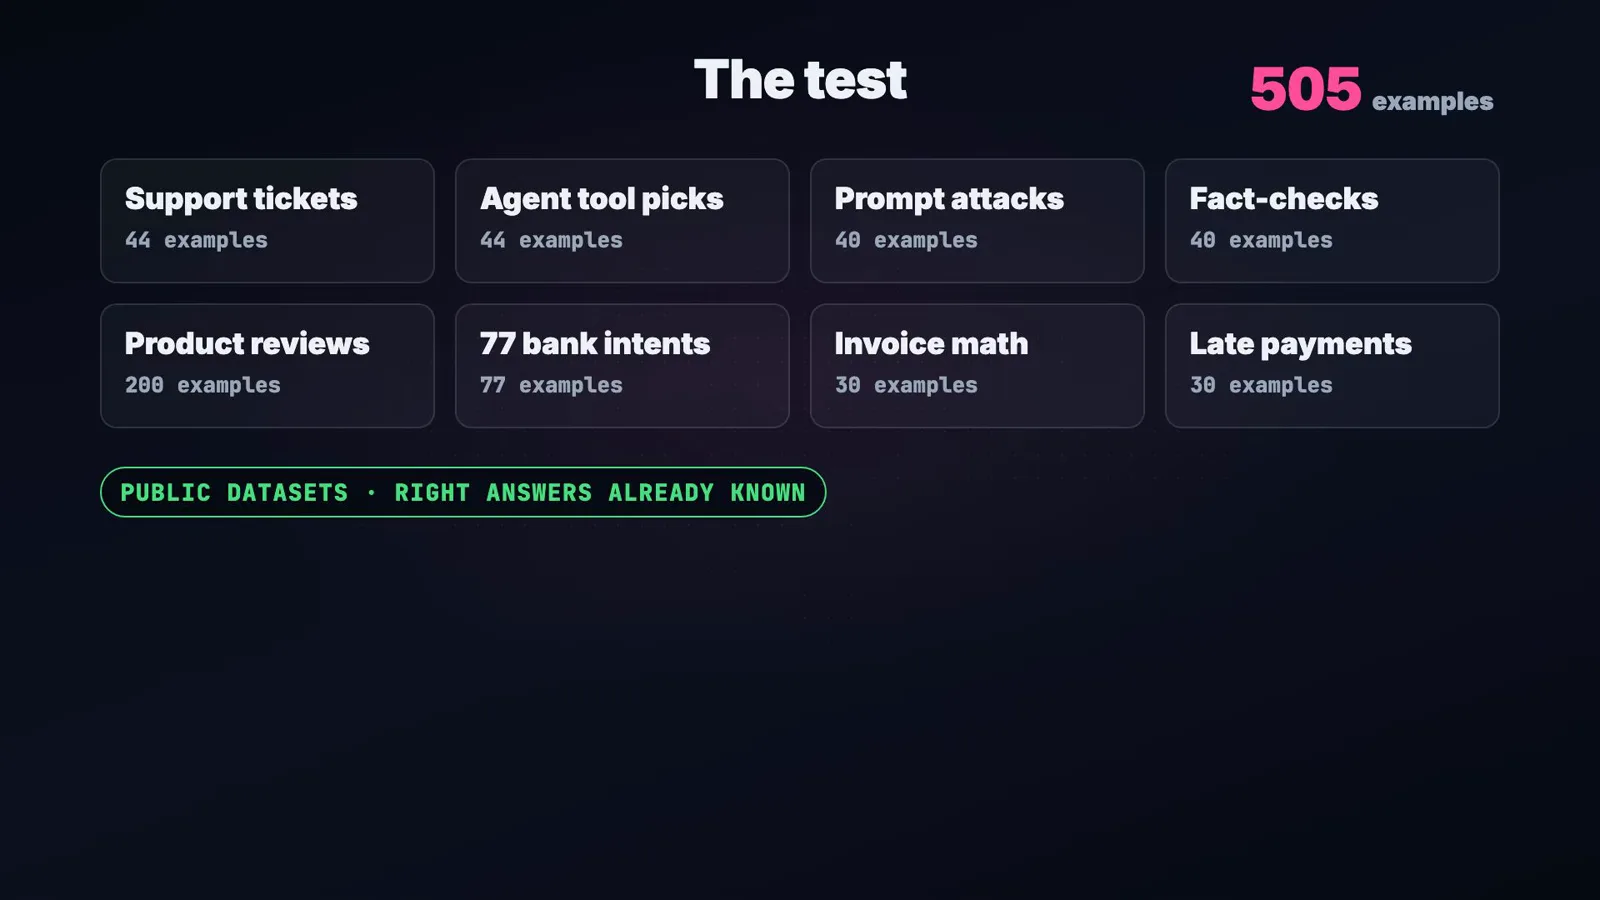
Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
两场独立基准——505 个带标准答案的决策 + 200 次价格竞猜——让 Jev 与 GPT-5.6 Luna、Terra、Claude Opus 5.5 正面交锋。
阅读攻略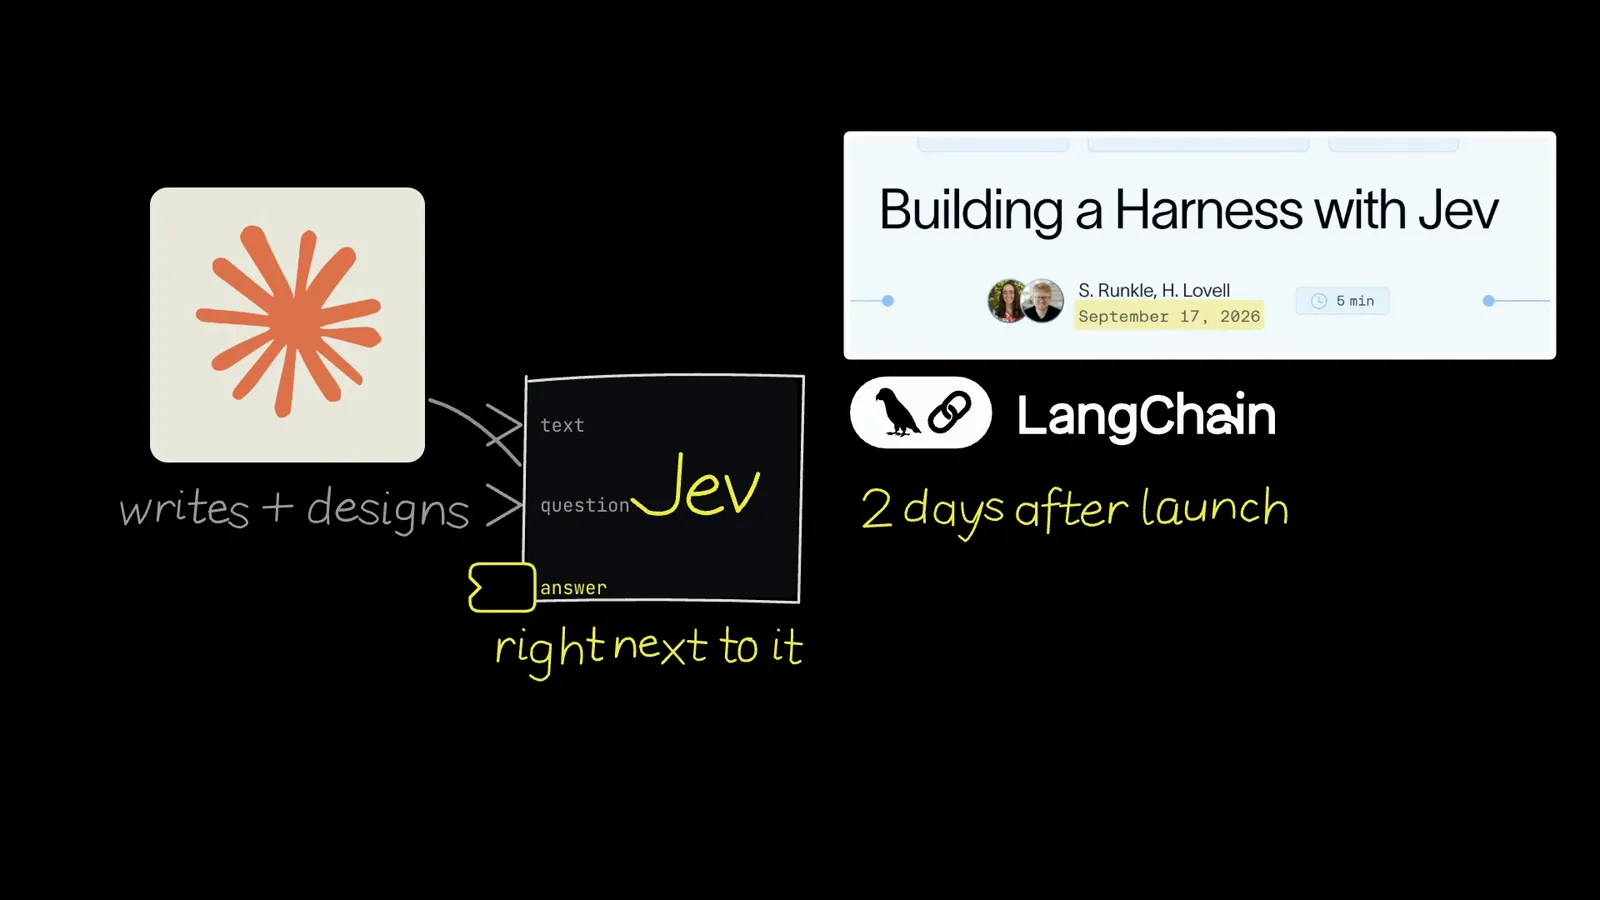
Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
Jev 在 agent harness 里的位置:启动前路由、循环内守住每次工具调用、写作留给 LLM——附带实测收益与准确率警示。
阅读攻略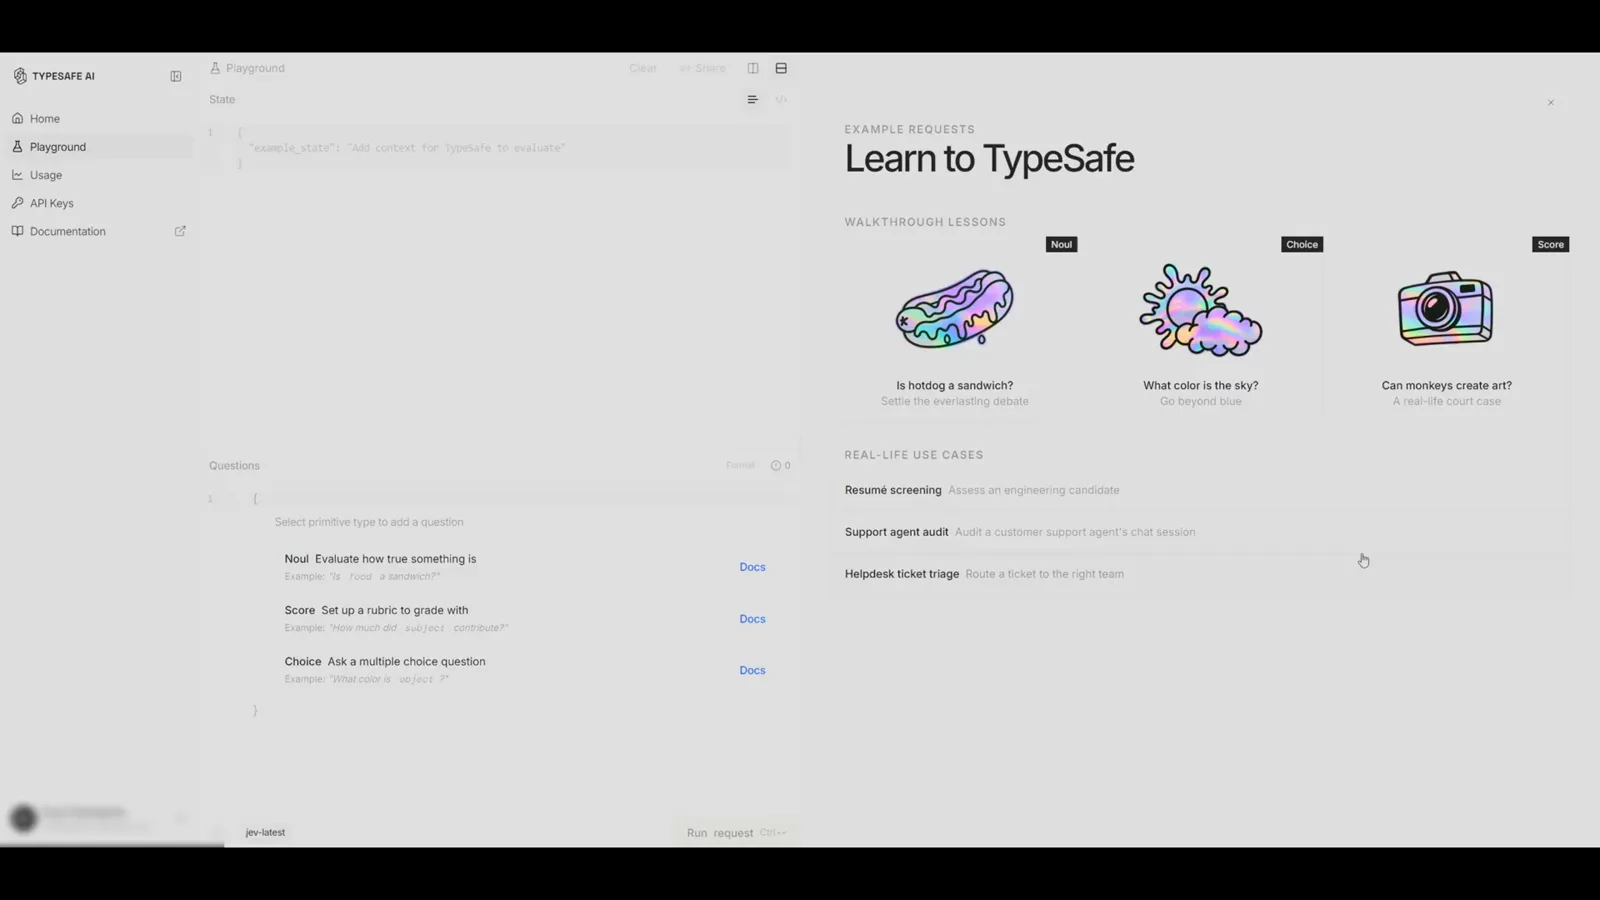
Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
纯录屏的 TypeSafe 控制台 Playground 实测:学三种原语、校准热狗课程、搭立方体规则 Choice 问题,再把同一提示词与 GPT-5.6 Luna、Sonnet 5、Gemini 3.7 Flash 对账单。
阅读攻略
Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
装好 classifier.dev,在终端里批量分类文本文件,用置信度做门禁,再调 REST API 读回 label、confidence、scores 与 ms。
阅读攻略
Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
从一次真实调试会话里提炼可复制的 Jev API 示例:curl、Python requests、JavaScript fetch——一个 state、若干类型化问题、带校准概率的答案。
阅读攻略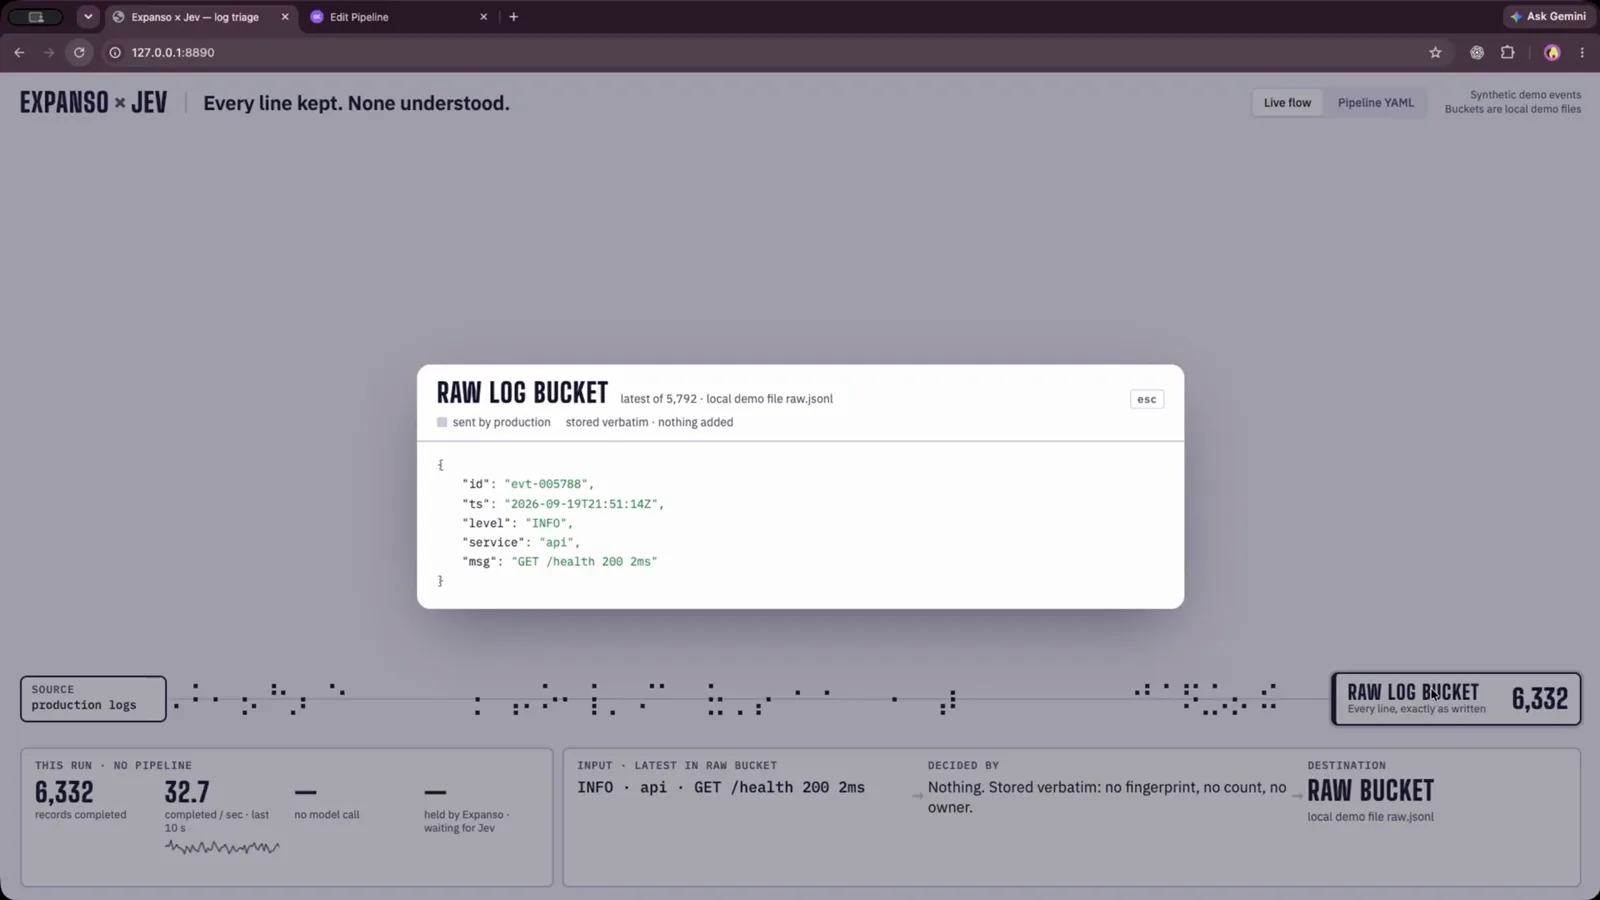
用 Expanso Edge 和 Jev 搭建日志分流流程
逐屏拆解 Expanso Edge 与 Jev 的日志分流演示:使用合成事件和本地文件,先走确定性处理,再按需判断并路由结果。
阅读攻略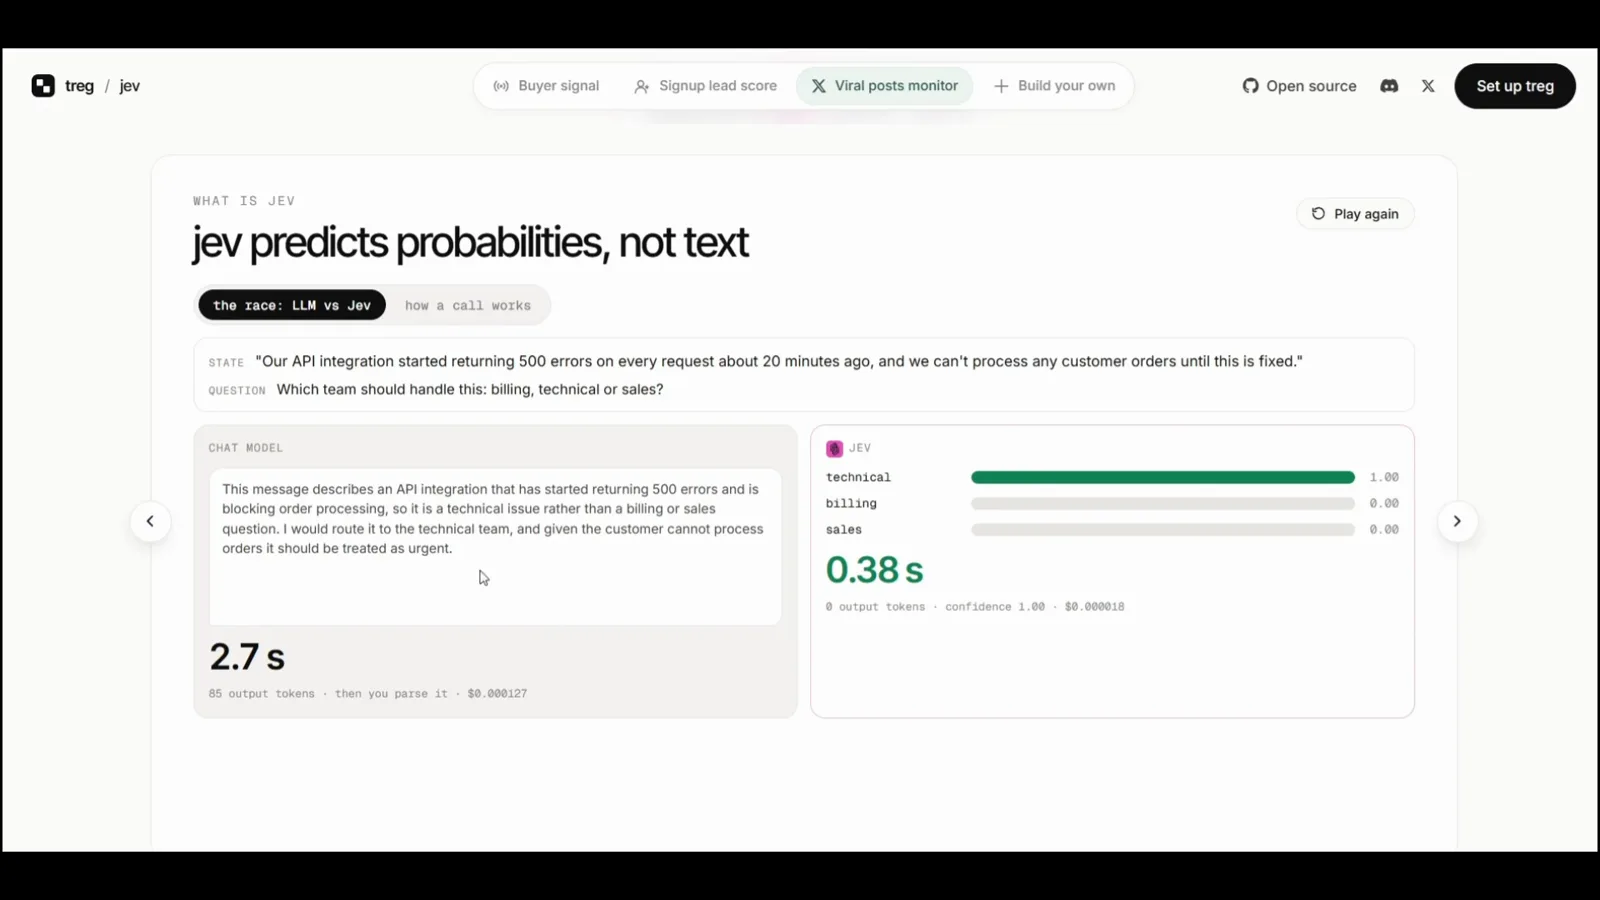
Treg + Jev 线索丰富:ICP 分类与注册用户评分
在 Treg 中把 LinkedIn 互动与注册用户转成 Jev 类型化决策,同时把视频里的数字明确限定为作者展示的演示样例。
阅读攻略
在 Heym 中使用 Jev 决策节点:语言判断与模型路由
逐屏拆解 Heym 中的 Jev 工作流:配置路由选项、测试 Noul 语言判断,并从执行 trace 查看运行时选模。
阅读攻略
Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
基于 Alex Hitt 的 9 分钟白板讲解视频整理的分步 Laya 图文教程:写对 state + questions 载荷、守住 192 token 选项预算、校准到 ECE 0.081、按 0.85 置信度门槛分流、接好多语言路由,最后把两份 checkpoint 预加载进显存。
阅读攻略
训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
围绕 TerraNet 4 分钟微调讲解视频、并用两个真实复刻项目交叉核实的分步图文教程——Hassan 在 Together AI 上花 $17、CoderOne 在 Modal 上花 $4.17,各自训练了一个 Jev 式决策模型:哪些东西能训、38,000 道训练题从哪来、校准怎么做得诚实可靠、这条流水线什么时候回本。
阅读攻略
Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
从 Codevolution 43 分钟最佳实践 deep dive 里提炼的 8 条 Jev 实战技巧:state 写成对象、事实让代码先算、只发问题需要的上下文、按「判断真假还是排序」选 Noul/Choice/Score、用 criteria 定义每一个答案(讽刺语气靠分级 signals 收服)、独立问题合并成一次请求、每个动作配自己的 confidence 阈值。
阅读攻略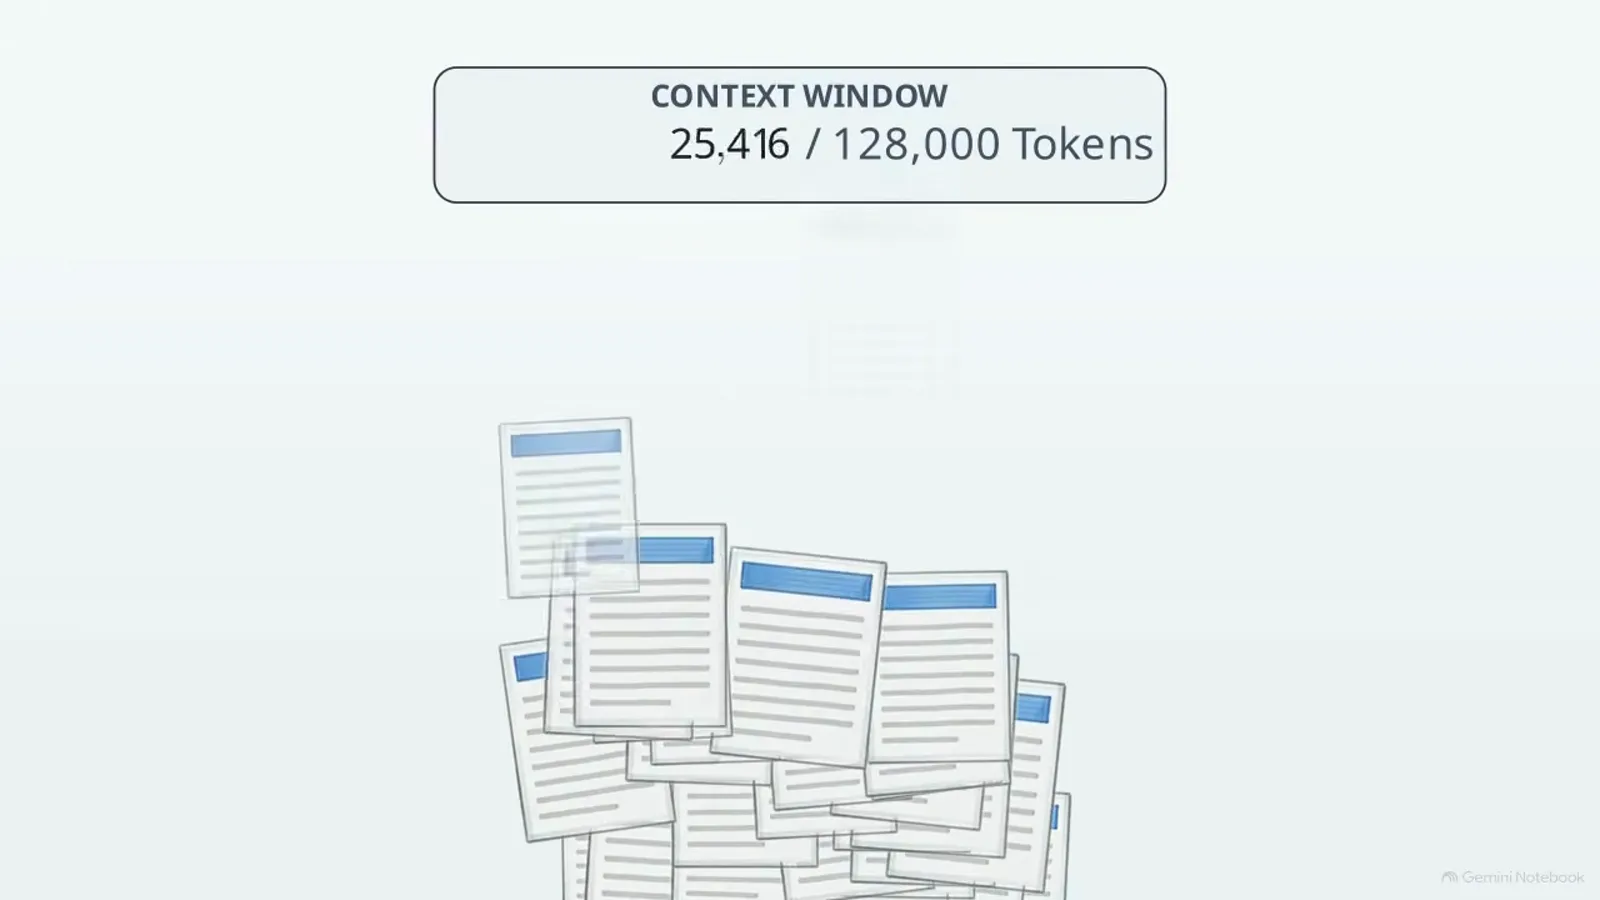
Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
fast-jev-compaction 用类型化的 Jev 评估取代生成式自压缩:锚定会话首尾,把中部压进 25,000 token 的状态上限,再让每条工具调用面对两道是非题,由置信度决定原文保留、截断还是删除。
阅读攻略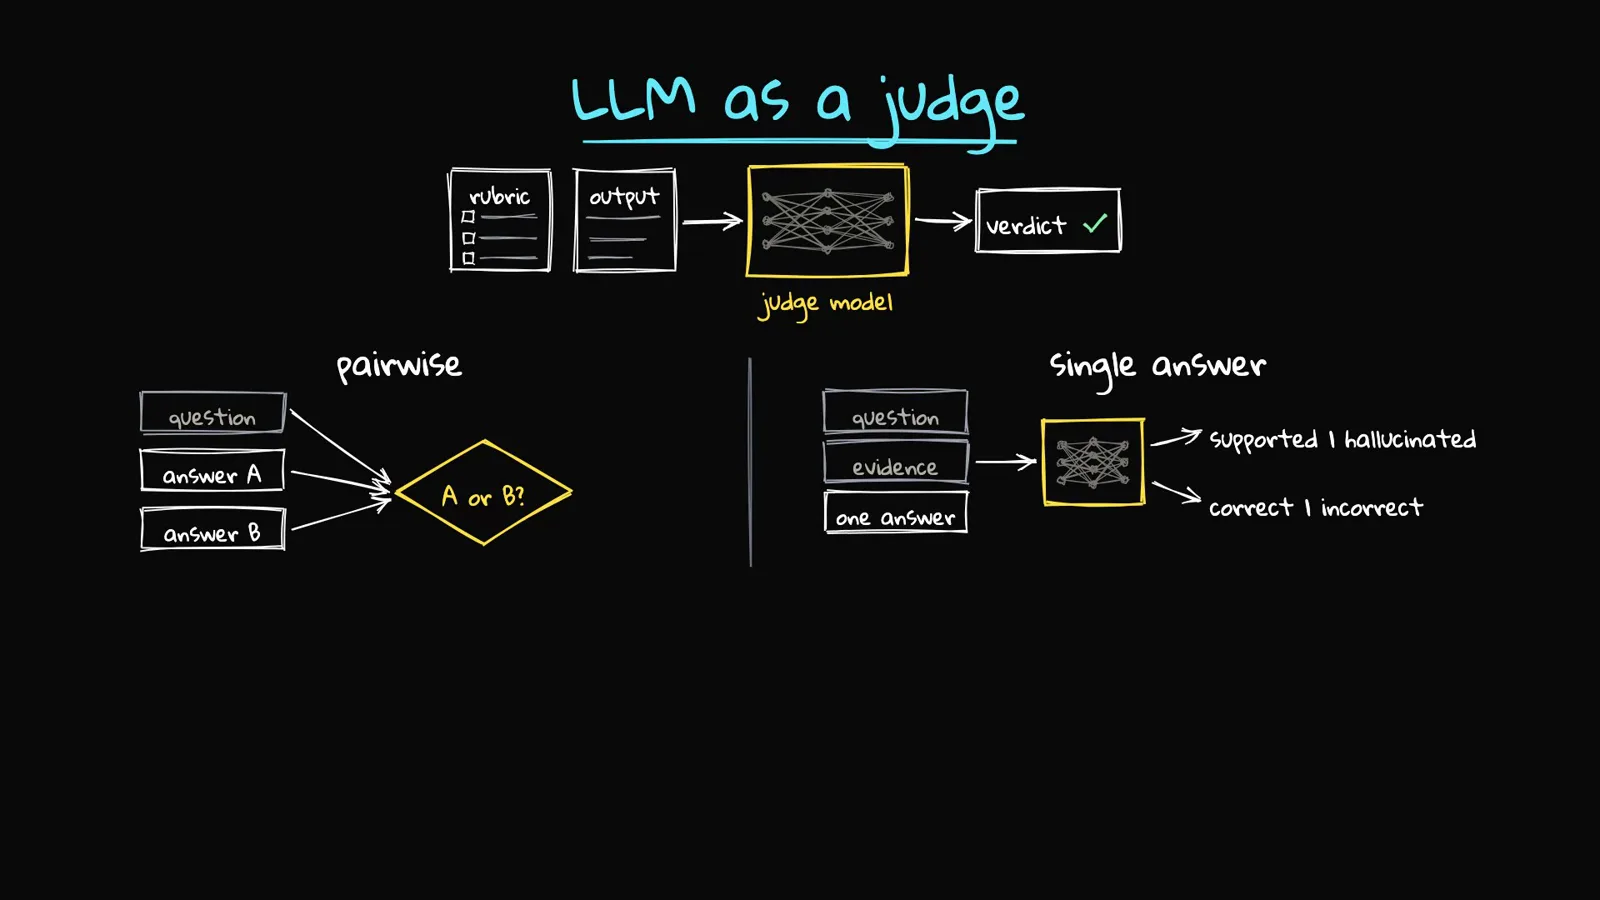
Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
卡内基梅隆的研究让 Jev 1.13 对战 16 个评审:在普通偏好和证据溯源任务上与 GPT-6 相差约 3 分以内,成本 $0.044 对 $12.18/千次——而且它的置信度足够诚实,可以用级联保住强评审 99% 的精度、只付 57% 的费用。
阅读攻略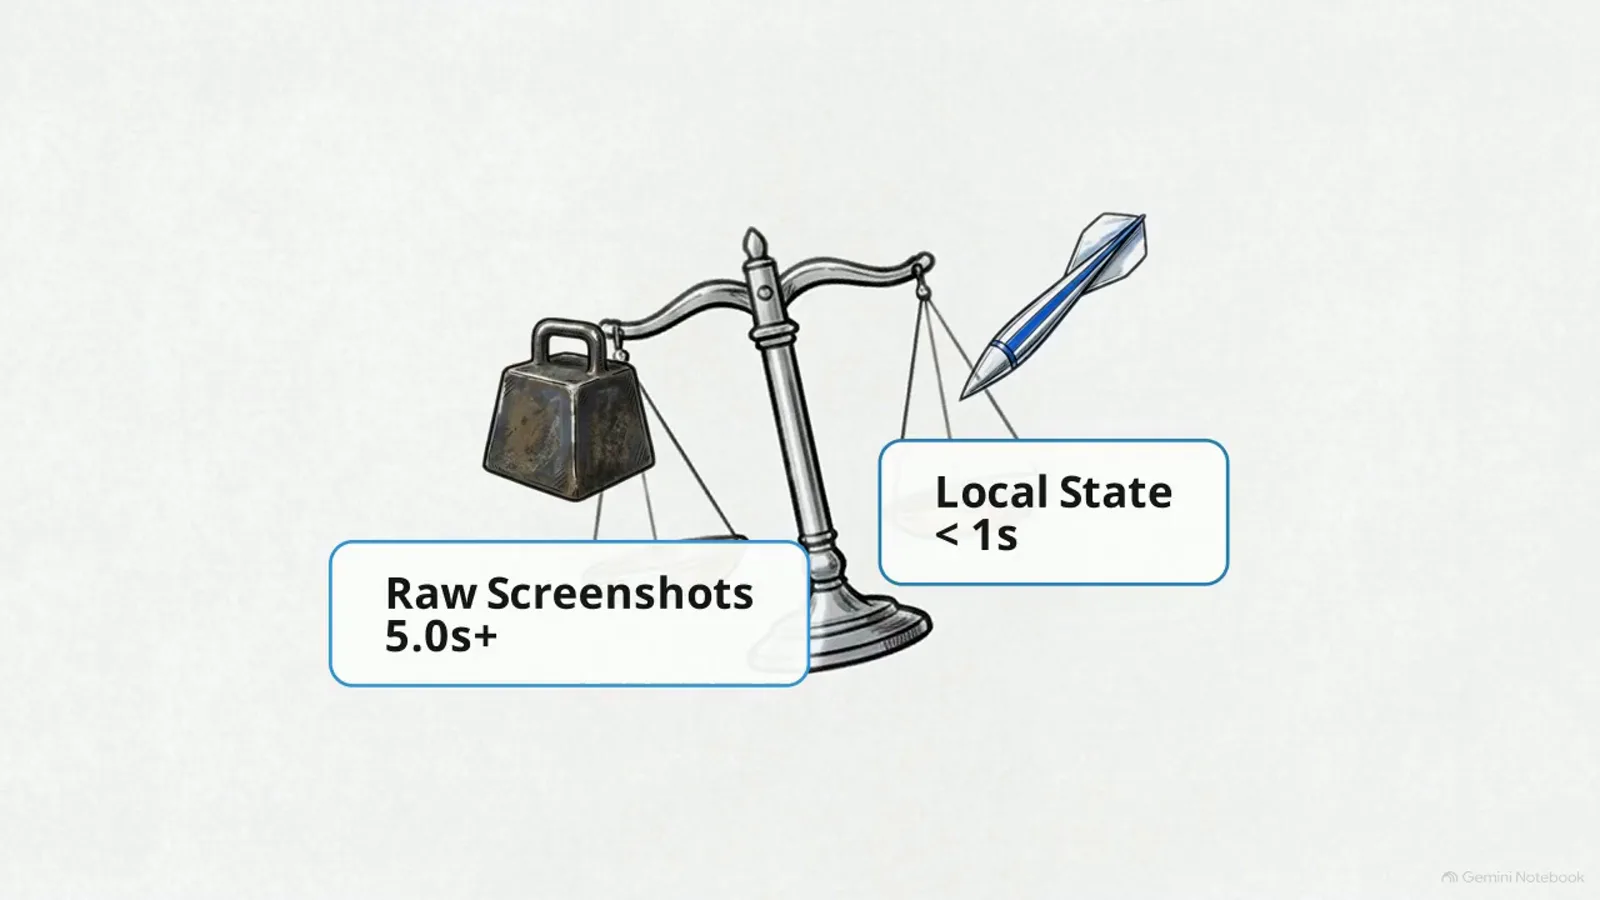
TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
typesafe-computer-use 用本机 Vision OCR + 辅助功能树解析加每步一次 Jev 分类,取代「多 MB 截图调前沿模型」——每步 $0.0002、不到一秒,配硬性候选动作清单和硬件级急停。
阅读攻略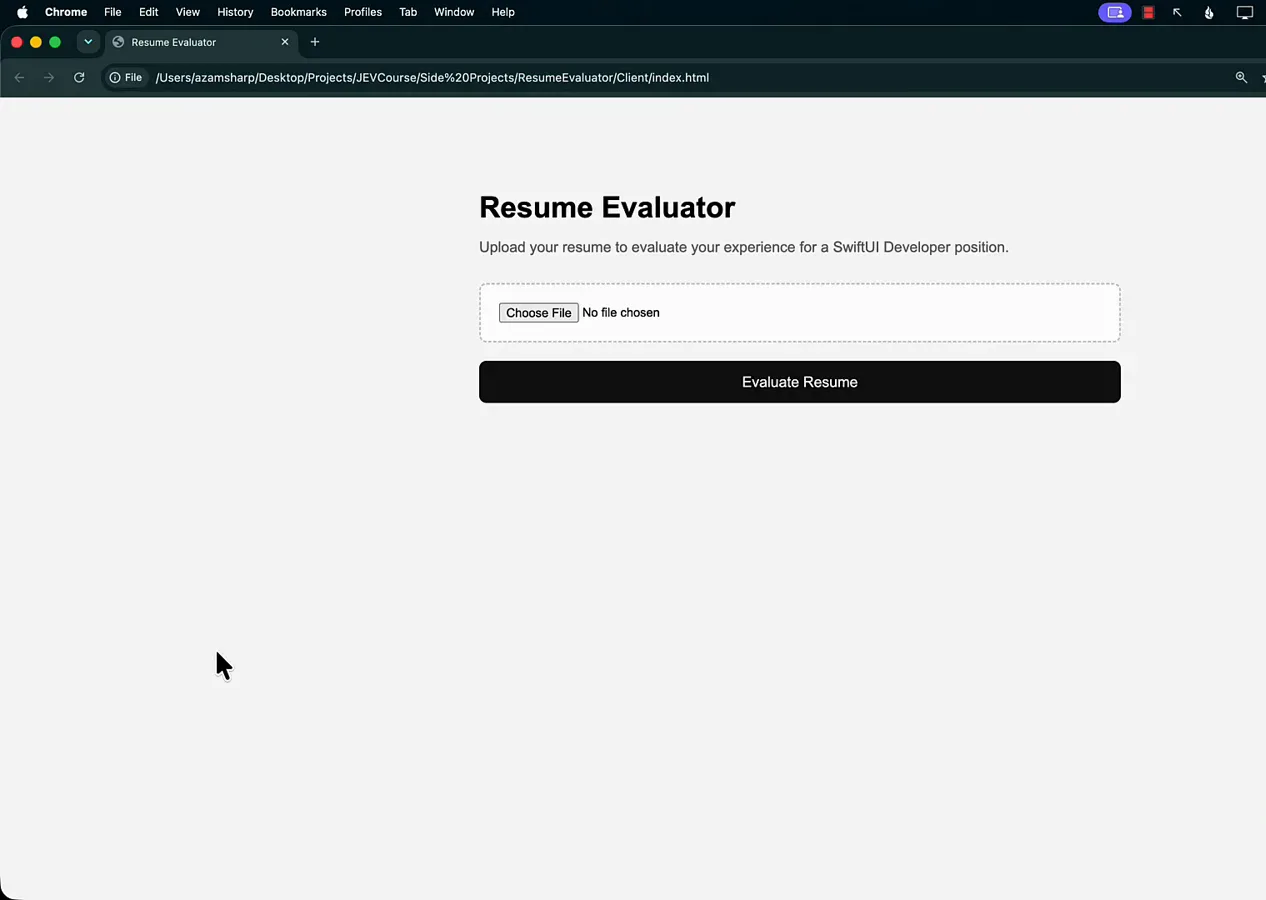
Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
一支 6 分 48 秒的 Jev 简历筛选演示:Express 端点抽取上传 PDF 的文本,10 道类型化问题(noul、choice、score)为 Senior SwiftUI Developer 岗位给候选人打分,再由映射函数把 noul 概率变成带置信度百分比的 Yes/No 技能卡和匹配裁决。
阅读攻略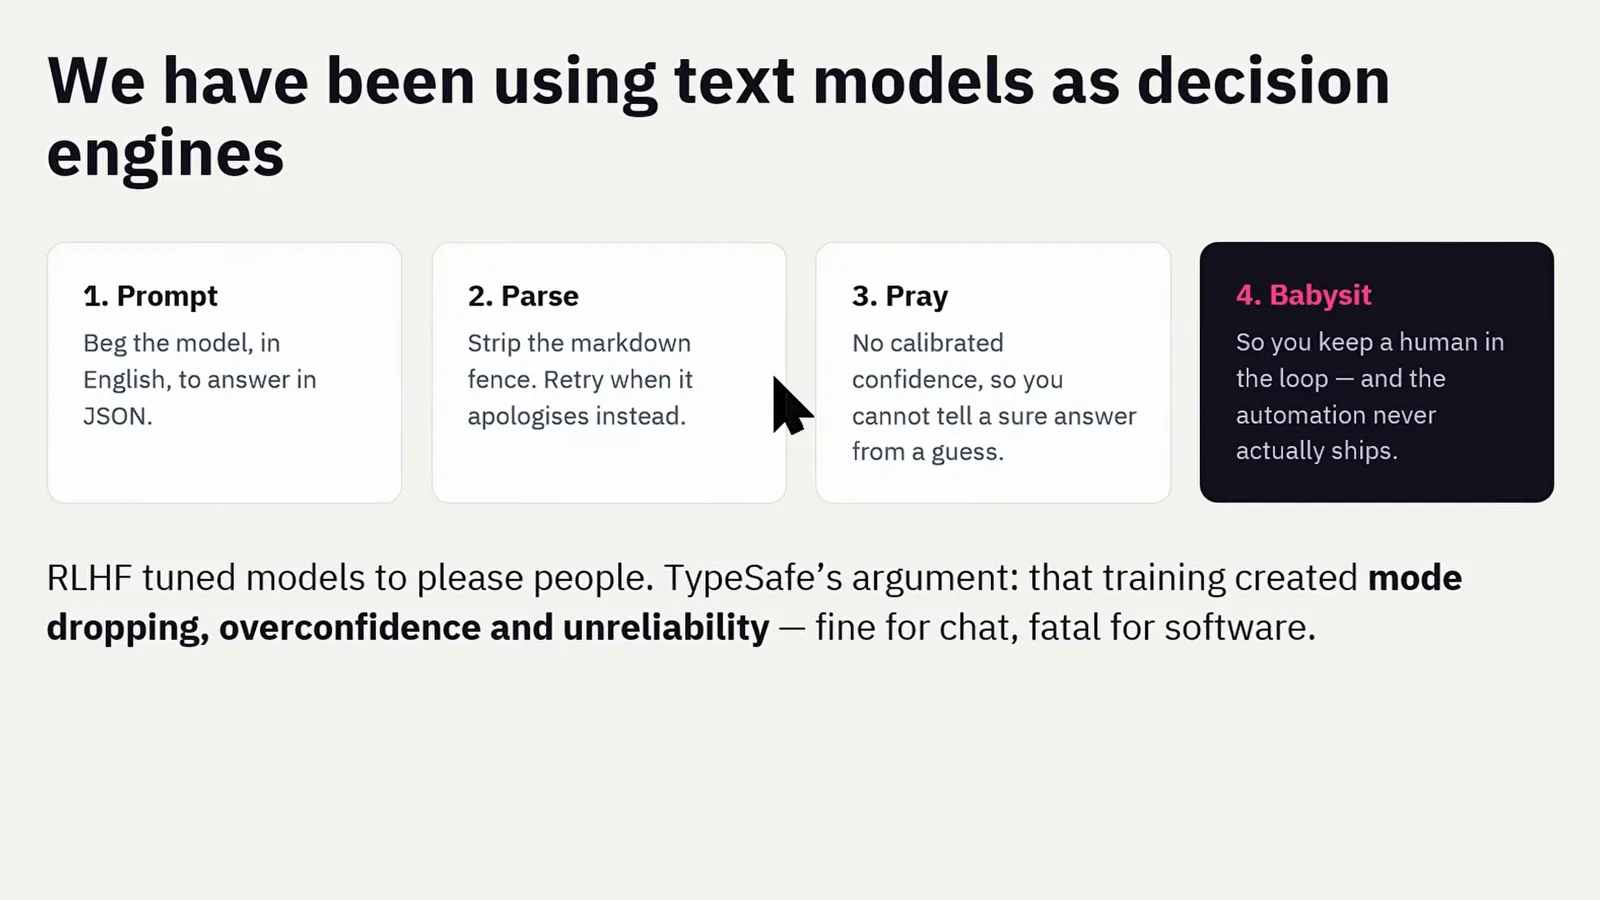
Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
一支 18 分 25 秒的 Agent 集成实战:为什么文本 LLM 当不好决策引擎、Jev 三大类型化原语如何带着可见置信度路由 Stripe 工单、决策成本低到 $0.042/百万输入 Token,以及 voice-chrome 项目如何用 mic → Whisper → Jev → Playwright 让一句「Click on videos」以 P=0.78 点中正确链接。
阅读攻略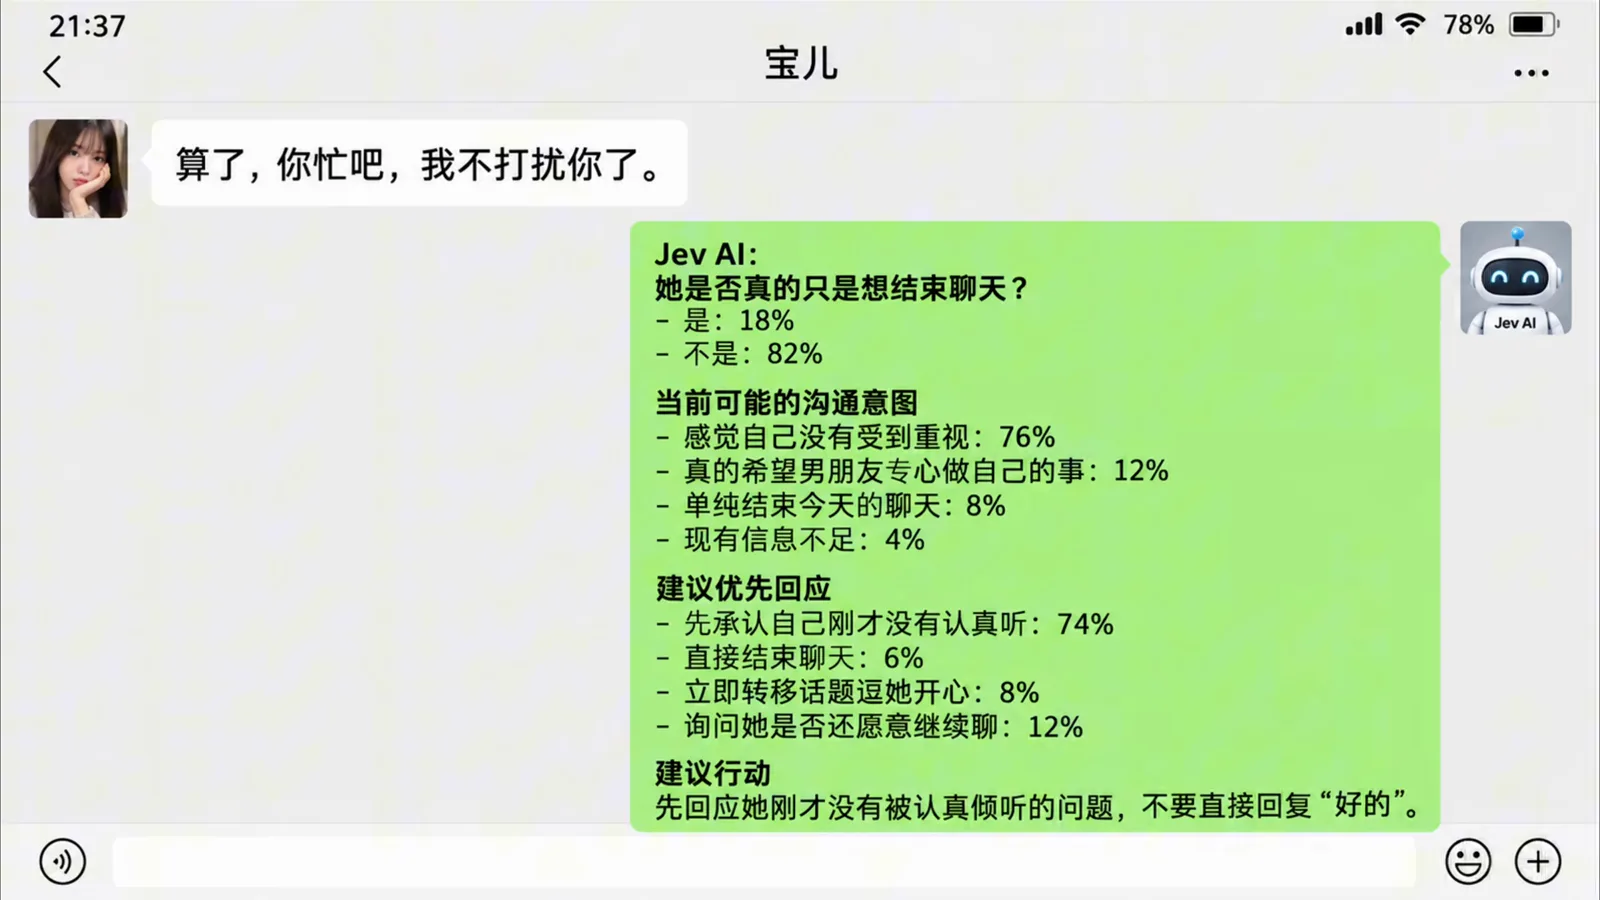
Jev 接入 Codex 实操:typesafe-ai/skills 安装与 Gmail 30 封邮件分诊
typesafe-ai/skills 教会编程智能体「什么时候、怎么调 Jev」。这条中文教程把它装进 Codex,先在 Playground 把三种题型练熟,再配好 TYPESAFE_API_KEY,最后让 Codex 读 30 封真实 Gmail 按优先级分诊——Jev API 只承担了其中 1.19 秒,剩下的分零几秒都是 Codex 自己在思考。
阅读攻略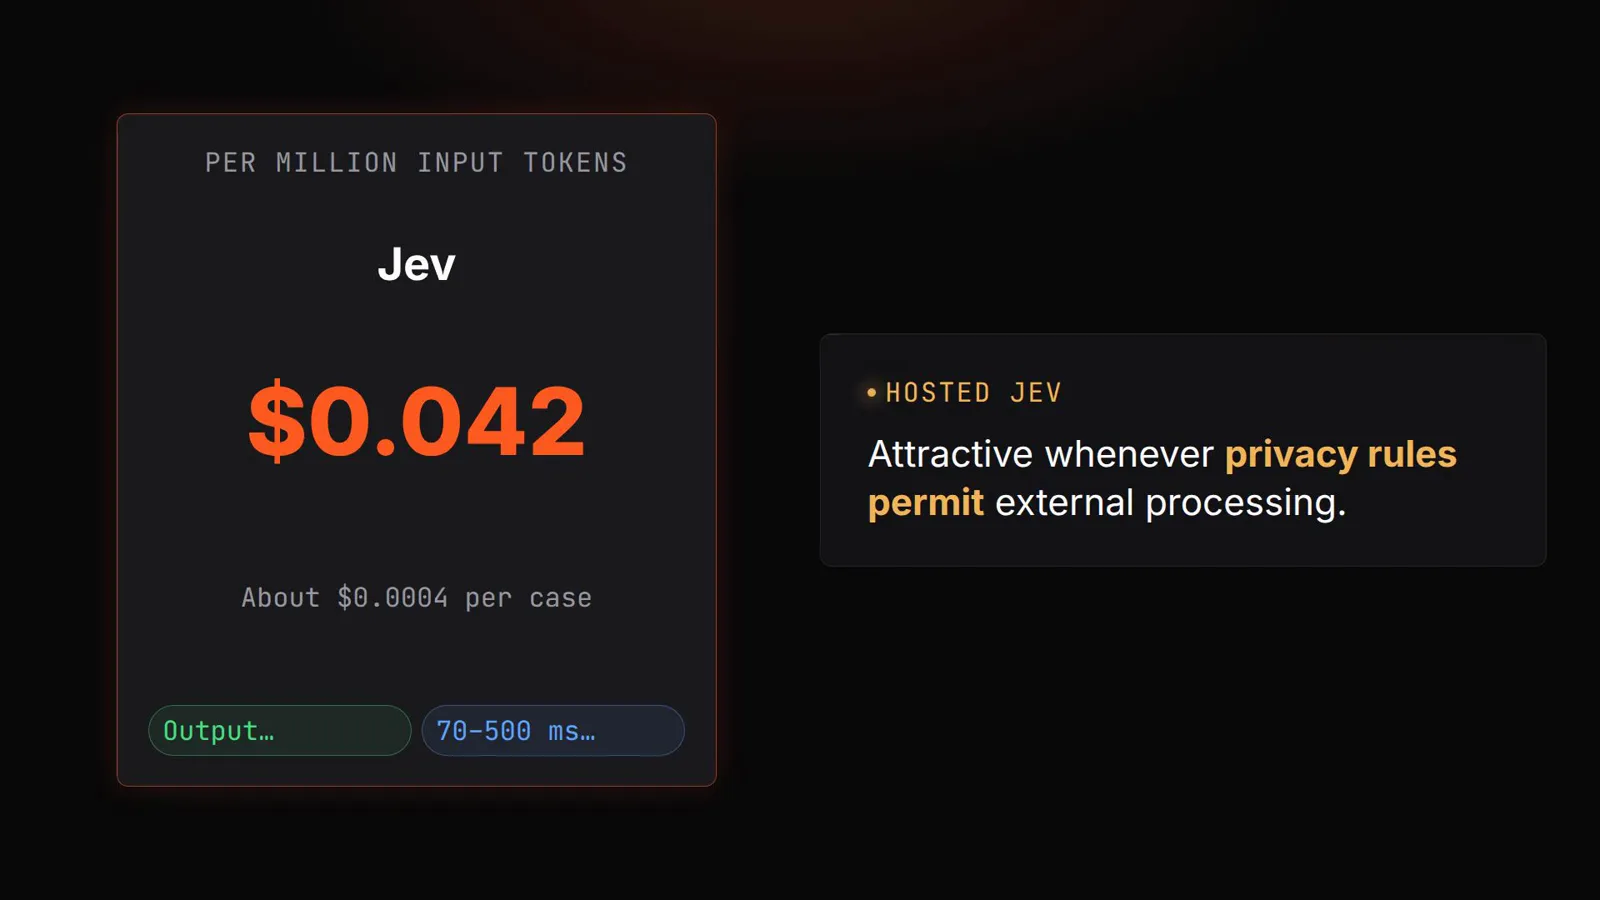
Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
托管 Jev 每次决策约 $0.0004;Kev 在 127.0.0.1 上提供同一套 System One 接口——精度、延迟、校准三组数字,决定本地什么时候真的划算。
阅读攻略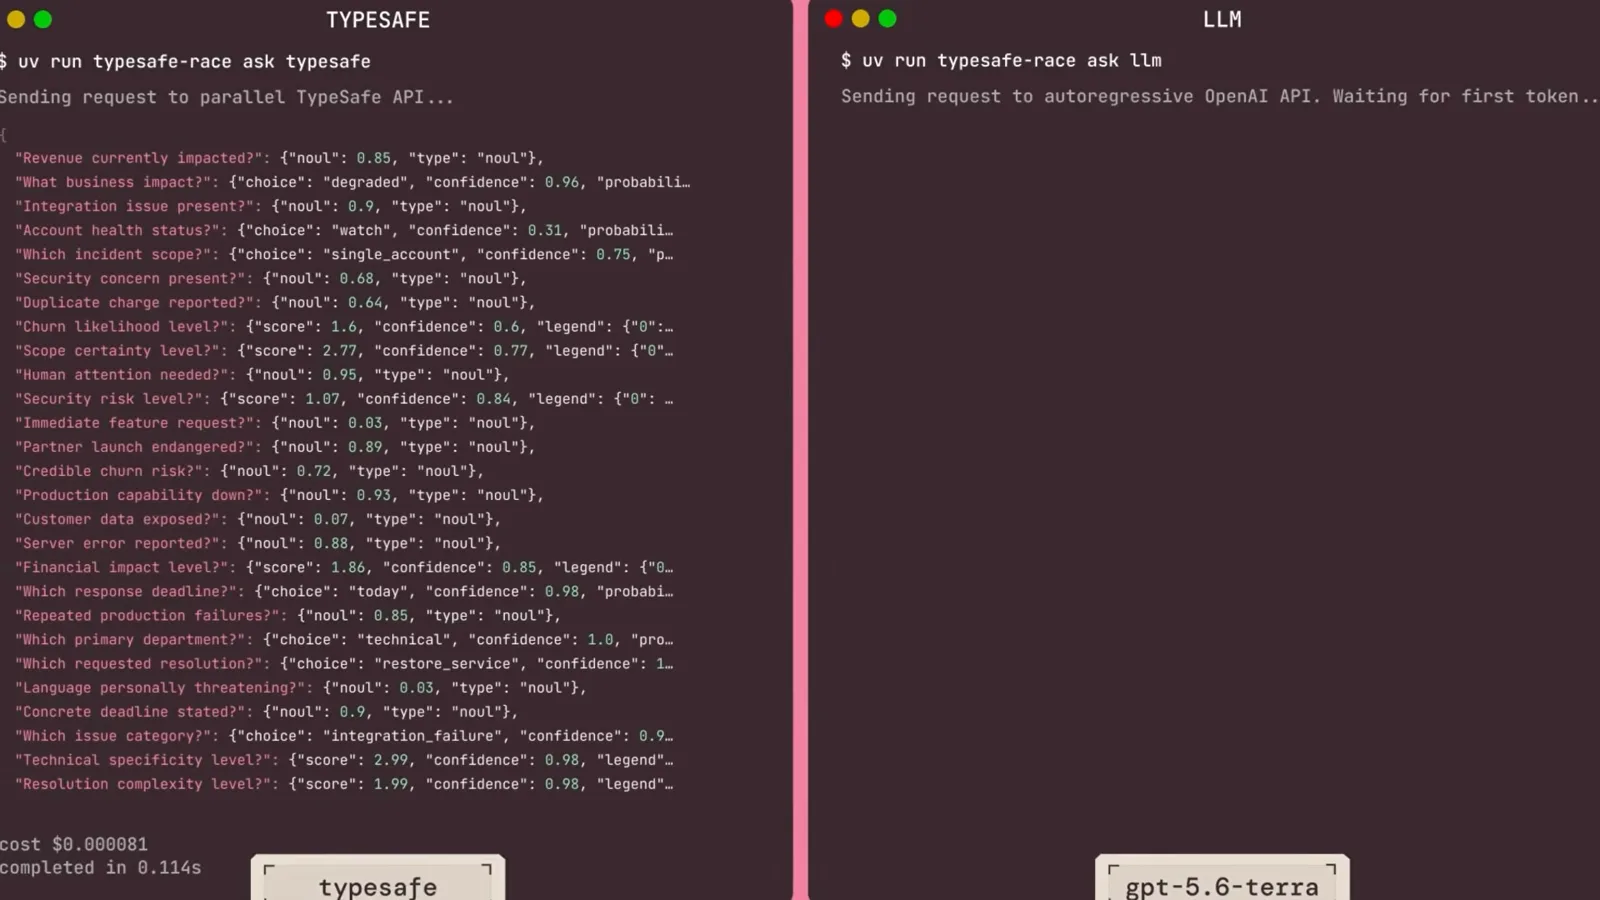
自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
从大 45 倍的教师蒸馏出的 0.6B 学生单次前向就能选出 Doom 动作——未见回合采纳率 93/100,比让教师亲自答题快约 900 倍。
阅读攻略
CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
2.8MB 的字节级打分器为每个表单字段单次前向评出 fill/check/click/skip——真实填表决策 99.7%,纯 CPU 运行时 GPU 只有 9MiB。
阅读攻略
用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门
规则解决它们本来就会解的;Jev 对剩下的回答一个类型化问题;0.85 置信度策略闸门让每一条拿不准的告警都留在分析师手里。
阅读攻略
Ollama 决策模型实测:tev1 + nimble 跑在 8GB 显卡上
Ollama 0.35 上线 /v1/systemone 端点与两个 Jev 系模型族——tev1 与 Nimble。一张 8GB 卡上,tev1 4B 以 470ms 路由工单且置信度可用;强制 JSON 的 Qwen 3.5 聊天模型精度打平,却不给置信度、还会在多次调用间翻转答案。
阅读攻略
Jev 生产环境护栏:五步接入实战手册
把 Jev 接成决策护栏层的五步 playbook——数字同样诚实:路由类决策上 Jev 比聊天模型便宜约 4 倍、快 10–25 倍,但在复杂任务上精度仍落后前沿模型——这正是阈值与人工复核排在第三步和第五步的原因。
阅读攻略
Pi Agent 防跑偏插件实战:让 Jev 出概率,让代码做决定
一个能用的 Pi Agent 插件:在上下文被污染之前拦住会话跑偏——里面最有教学价值的一课是:Choice 选项语义重叠时概率会被分摊(0.45/0.47 双不过阈),在代码里把同类概率加起来,「模型出概率、代码做决定」。
阅读攻略
Tev1 用例实测:50 个任务看尽本地决策模型的能力边界
一张 RTX 4060 8GB 显卡、50 个任务、单次请求 $0。44 项文本测试里,tev1 0.8B(812MB)以平均 190ms 拿下约 73%,4B(4.5GB)以 360ms 拿下 91%——路由工单与模型、审核内容、筛简历、97ms 分拣日志,甚至下井字棋,每个答案都带置信度。
阅读攻略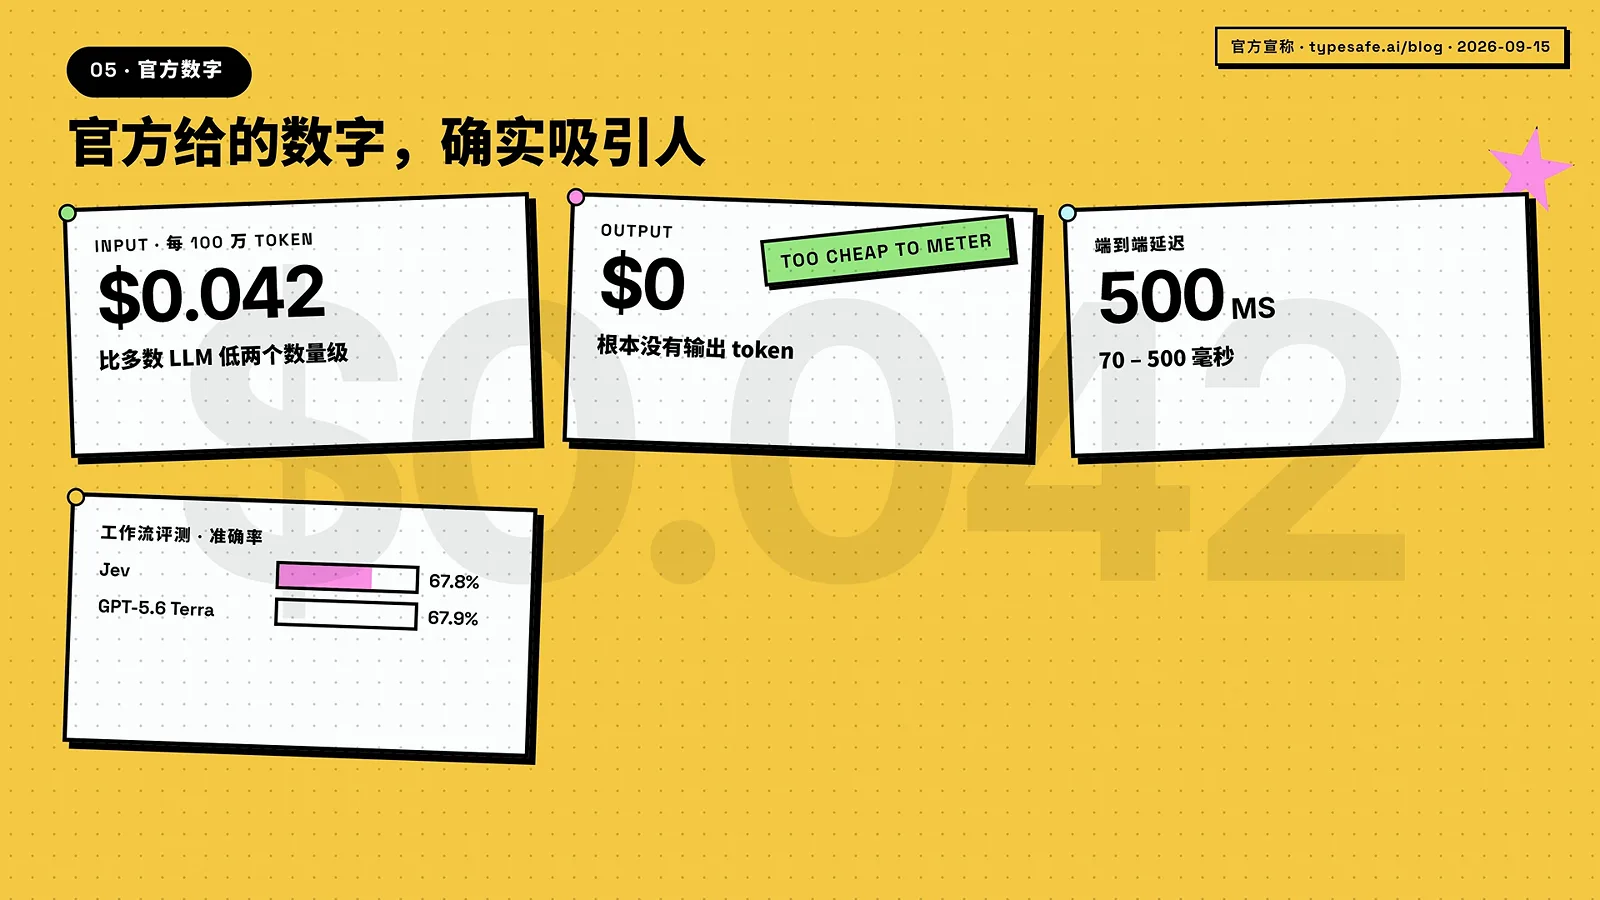
Jev 实测:官方宣称与独立复测之间的距离
一支中文频道的独立对账:官方 20-400 倍对上第三方复测的 5-25 倍、延迟 1.6-3.7 秒看链路、校准不可验证、「不幻觉」不成立——外加四条接入路径与 Playground 六场景的图文帧记。
阅读攻略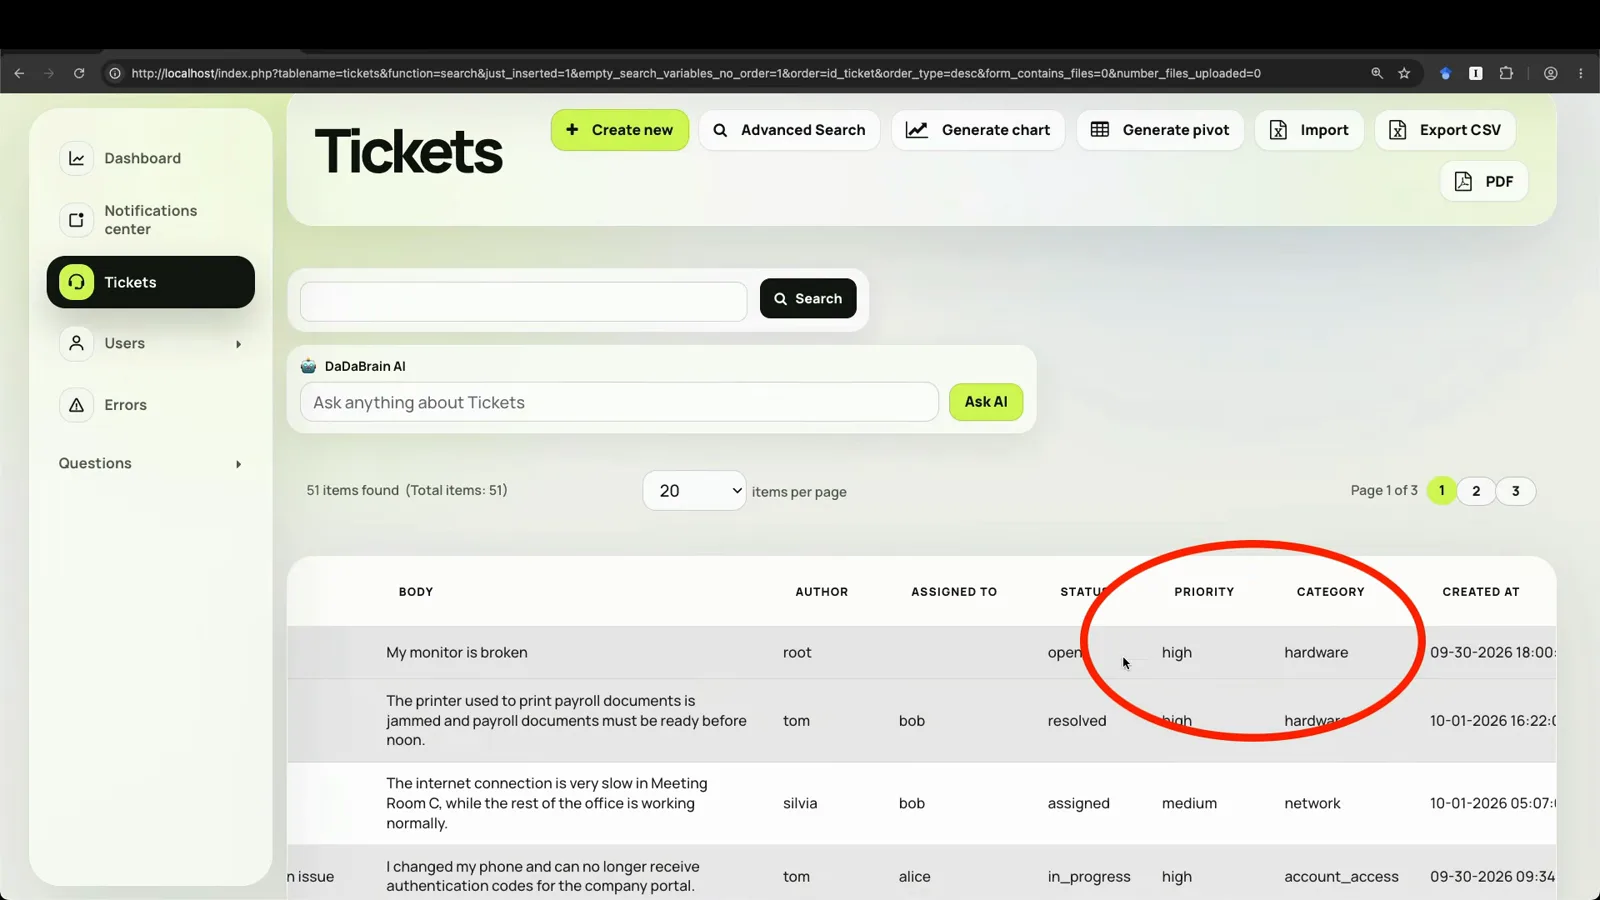
Jev 工单分类实战:after-insert hook 与计算字段两种接法
把 Jev 工单分类接进真实应用的两种接法——after-insert hook 与计算字段,附 50 条实测 47 条命中、0.9 置信度转人工示例规则和 $0.003 的账单。
阅读攻略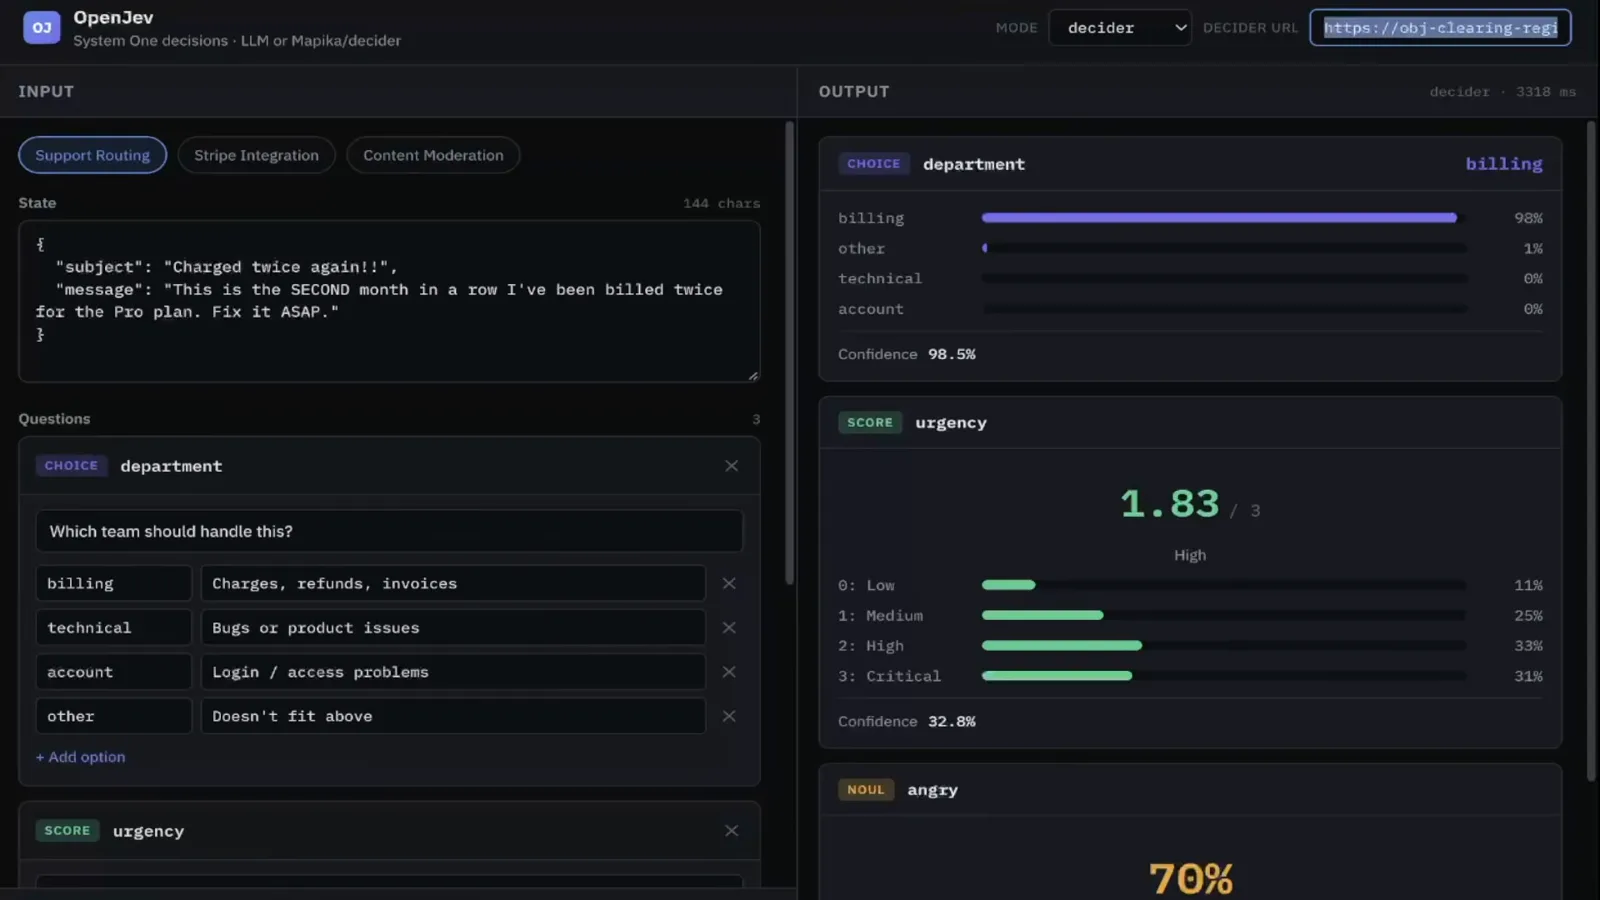
OpenJev RLCD 实操:开源校准决策模型本地部署全指南
OpenJev(开源版 Jev 技术栈)加入了对 decider 模型的支持:把控制台指向 Mspika/decoder 仓库的 RLCD 模型,它就能用带校准概率的类型化答案回应,线格式与 TypeSafe Jev API 非常接近。视频把同一笔重复扣费投诉分别跑过 decider(urgency 1.83 High、angry 70%)与 Groq 上的 Qwen 并行 LLM(urgency 2.38、angry 95%),并给出诚实结论:简单任务上,九个并行 LLM 调用快过 Kaggle 旧 GPU 上的一次慢速 decider 调用。
阅读攻略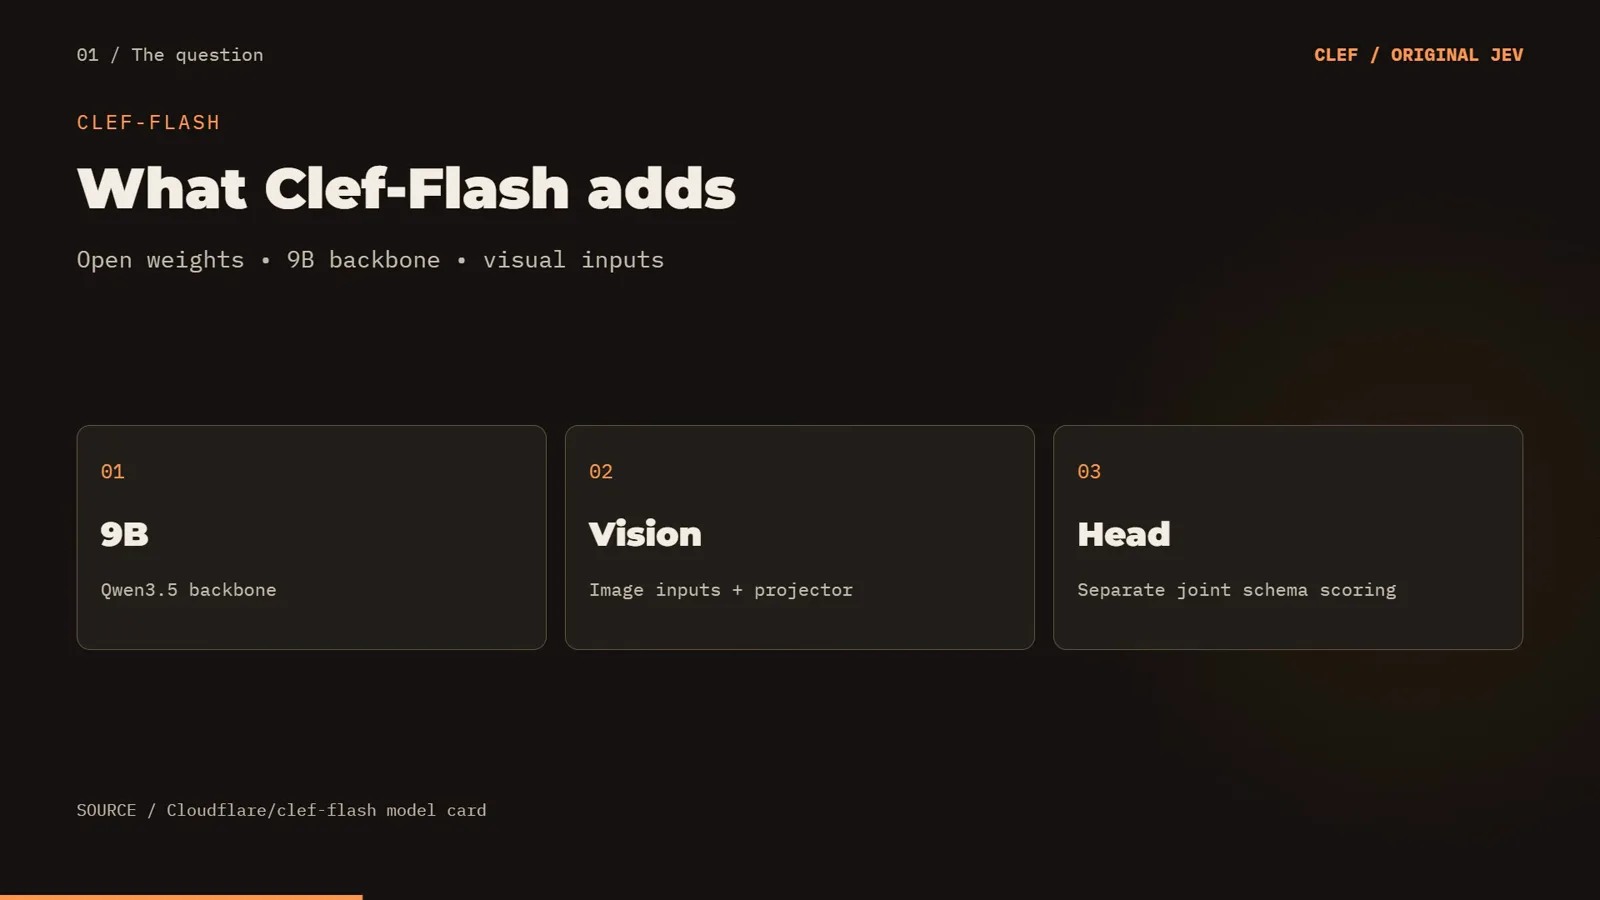
Clef-Flash vs Jev 实测:把 Cloudflare 决策模型装进 Ollama(Q4_K_M)
bartowski 的 Clef-Flash Q4_K_M 量化版能在 RTX 4060 笔记本上经 Ollama 0.35 跑起来:schema 约束的支持工单路由输出合法 JSON(热请求约 1.4–2 秒)、视觉 demo 以 1.35 秒读出比耶手势——但同一句宕机工单在零温度复跑时从 technical 翻成了 billing,且检查量化文件只有 427 个 backbone 张量、零 schema head 匹配。公开的 Clef vs Jev 数字真实存在,但出自 Cloudflare 托管评测,不是这台笔记本。
阅读攻略
Clef-Flash 实操教程:在 Ubuntu 上从零安装并本地运行 Cloudflare 9B 多模态决策模型
Clef-Flash(Hugging Face 上的 Cloudflare/clef-flash,Apache-2.0)是 Cloudflare Clef 家族里 90 亿参数的多模态成员——为结构化决策而生、不做自由对话:你定义一个文本 state,可选附一张原始照片,提多选问题,拿回每个选项的校准 JSON 概率。Ubuntu 上的安装只要五条命令:sudo apt update && sudo apt upgrade,建 testClef2 工作目录,python3 -m venv env1,然后 pip install torch transformers accelerate pillow huggingface_hub torchvision(约 2–3GB——作者明言这套最小配置试了很久)。可选加速库 causal-conv1d 与 flash-linear-attention 需要 CUDA 工具链和 GCC,首次安装本地编译。模型经 snapshot_download 加载,模型卡 Usage 区(录制时画面)写明在单张 H200 上以 torch 2.11 与 transformers 5.10.2 测试,图像与视频输入另需 pillow。两个 demo 打通全链路:纯文本发票(Acme,1250.0 美元,状态 overdue)判回 overdue 0.9728;碎屏手机装在皱纸填充纸箱里的照片判回 cracked 0.9626,外加「箱里有没有纸或泡泡纸」0.957 的 yes。作者的 RTX 3090 上,nvtop 显示 python3 test2.py 进程吃掉约 18.7GB,占这张 24GB 显卡的大头,此时 760/760 权重已驻留显存。
阅读攻略
CLM-8B 架构深潜:44 毫秒打分 1,024 个候选的对比决策模型(比 Jev 快 13 倍)
CLM-8B(CLM-v0.1,斯坦福 + NVIDIA Research 团队)是一个 8B 的「决策版 CLIP」:冻结的 Qwen3-8B 骨干负责编码态势,两个各约 2,000 万参数的小头把 state 和动作嵌入同一个空间——决策就是嵌入空间里的距离。动作只嵌一次、永久缓存,之后每步只花一次 state 编码加几次点积,所以候选列表再长延迟也几乎不动:视频曲线上 1,024 个候选 44 毫秒,Jev 570 毫秒。API 与 Jev 同形(yes/no、多选、打分三原语),fine print 也同款:永远不会发明列表外答案,但可能自信地选错列表内答案。本页走完双塔架构、三阶段对比训练(6,000 万 QA 对 → 3,000 万 Gemini 难负样本 → 100 万 agent 轨迹)、冻结骨干的经济学(单卡 RTX 4090 约 1 小时跑完全量预训练)、DGX Spark 实操(客服工单 urgent 84% / billing 99% / very angry,缓存复问 <2 毫秒)、1,080 工具路由与 WikiRace 复刻——以及诚实的边界:8 个工具准确率 86%,1,080 个工具掉到 17%。
阅读攻略
Nox 4B 实测教程:本地跑通 Decision 2.0 决策模型,四道真实考题与一次诚实的失败
Nox 4B(Hugging Face 上的 vllm-sr/Decision-2.0-Nox-4B)是 Decision 2.0 家族的推荐中坚——vLLM semantic-router 团队出品的六款 Apache 2.0 决策模型,从 0.6B 到 27B 共用一套接口。安装就是一行 from_pretrained,决策只需一次 system_one(state, questions) 调用,支持三种问题类型(noul 是/否、choice 多选、score 打分),毫秒级返回概率、不生成任何文本。视频四道实测里,它一次前向路由愤怒客服工单(billing 89.4%、urgent 77.8%、frustration 1.40/2),在社会工程陷阱上失败——85.2% 放行数据库访问、识破率仅 22.1%;餐厅卫生检查 96.9% 判 fail 并建议停业;高风险房贷申请以 19.4% 的 approve 概率拒绝,最终决策置信度只有 13.3%——这个数字本身就在说「该交给人审」。官方卡面:JevArena 同尺寸第一(63.6)、Yes/No(88%)与 Score(66%)两类最强、显存不到 10GB。
阅读攻略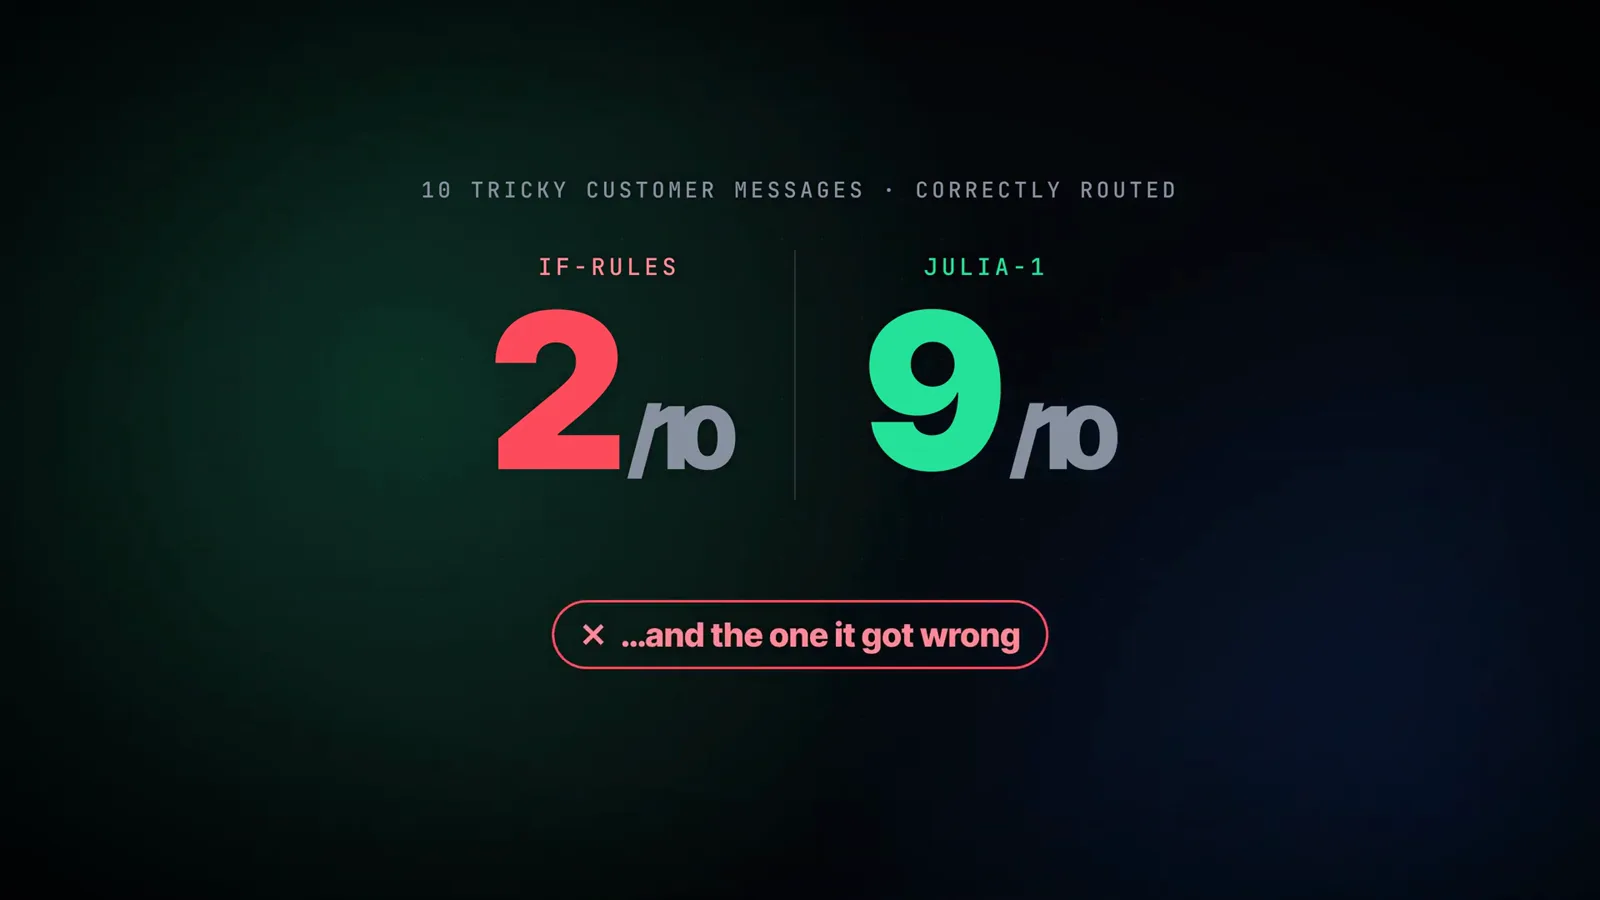
Julia-1 实操教程:纯 Python 装上开源 Jev 替代品,10 条客服消息实测 9 比 2
Julia-1(Supersonic Labs 出品)是免费、纯 CPU 的决策模型,三条命令装完:建 venv、snapshot_download 拉取约 550MB 的 Hugging Face 仓库、pip install -e ./Julia-1。它只做一件事:对 state 提 typed 问题——choice 多选(2–20 个带描述的选项)或 noul 是/否——返回每个选项的概率。视频 demo 里,10 条真实风格客服消息 if 关键词规则对了 2 条,Julia-1 对了 9 条,赢在否定式、无关键词、拼写变体和葡语;输的那条是「付款成功但包裹没到」——它以 100% 置信度送去了 billing。2 核云机实测:加载约 9 秒,之后约 40 毫秒一次决策。
阅读攻略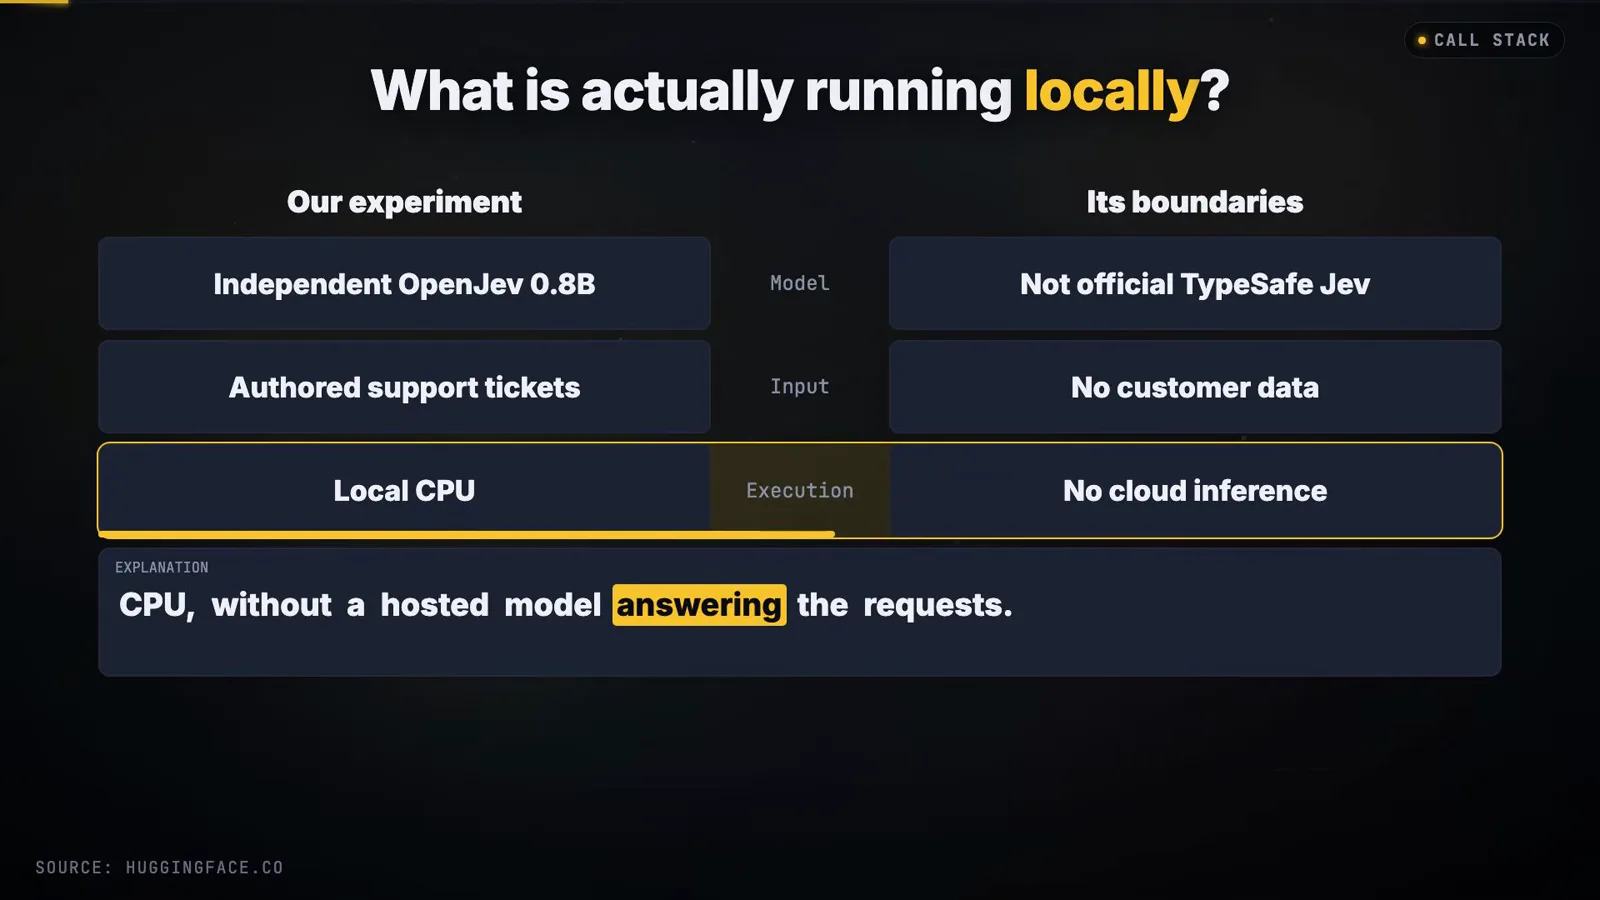
OpenJev 0.8B CPU 实战:用工单收件箱校准 NLI 路由阈值
Call Stack 在 AlexWortega 独立发布的 OpenJev 0.8B NLI 检查点上搭了一个能跑的工单收件箱:每张自写工单作为 premise,对 refund/billing/login/bug 四条部门假设分别输出 contradiction/entailment/neutral 三个分数,应用直接读分数、不让模型生成回复。工程主线是阈值校准:v1(最大蕴含 ≥0.60 且领先 0.10)在 billing 0.97、login 0.78 双过阈时藏掉了第二个真实问题;v2 把多命题过阈转人工复核,却也让本该命中的退款工单(0.9883 对 0.7277)进了复核队列;4 条校准 + 12 条留出用例最终 2/4 与 7/12——视频明确说明这不是独立模型准确率。全程 CPU float32:权重 1.71GB、峰值内存 3.20GB、每请求中位 5.63 秒,下载后完全离线。
阅读攻略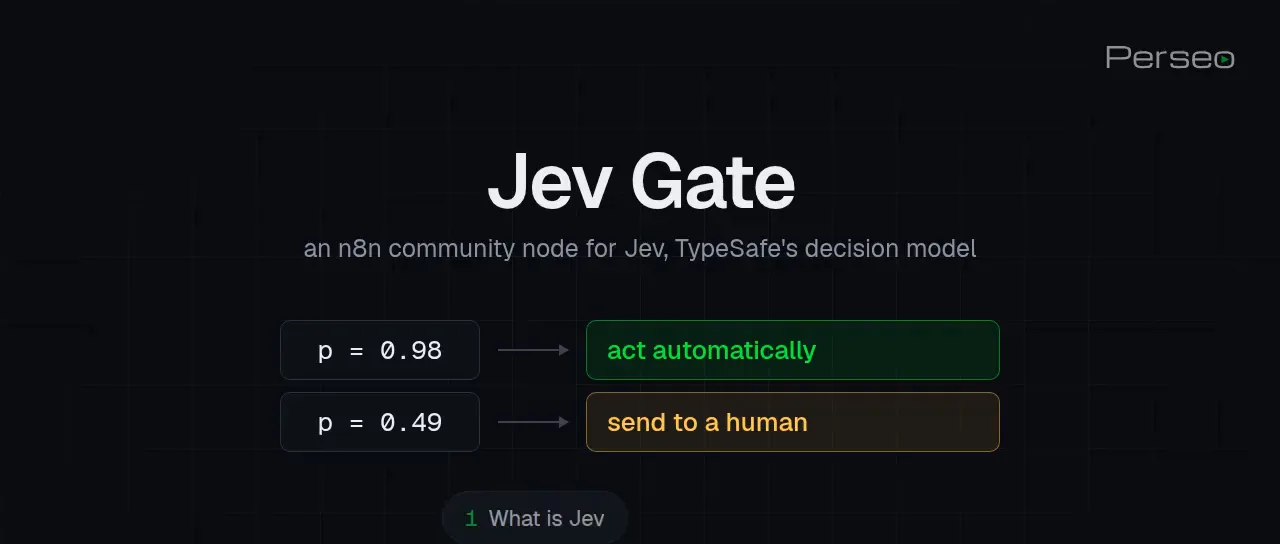
Jev n8n 集成实战:JevGate 社区节点分步攻略(附纯 HTTP 备选路线)
JevGate(n8n-nodes-jev-gate)把 TypeSafe 的 Jev 决策模型接进 n8n:Decide 按置信度阈值给每条数据分流,Calibrate 用有标注样本找阈值(demo 12 条消息推荐 0.7),Route 给每个选项独立出口、review 殿后;装不了社区节点的团队,用原生 HTTP Request 节点直调 OpenRouter 也能搭出同款。
阅读攻略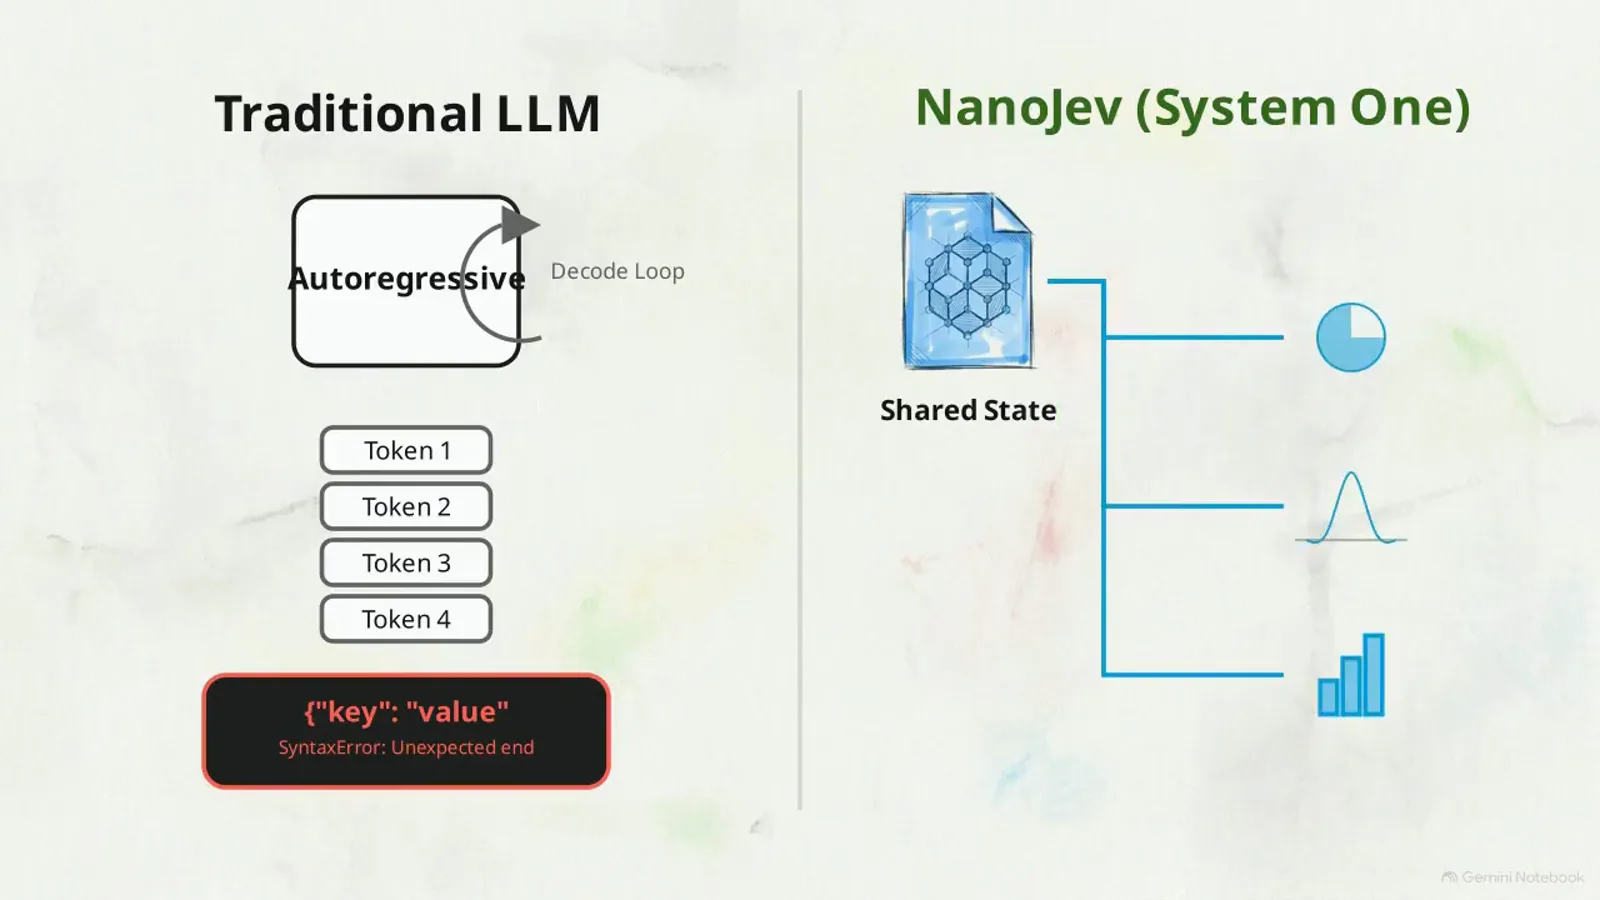
NanoJev 实操教程:本地部署 0.6B 开源 Jev 复刻,亲眼看它以 47ms 跑迷宫、按概率做路由
NanoJev(GitHub TianyuCodings/NanoJev,Hugging Face C-Tianyu/NanoJev)是社区复刻的 Jev System 1 架构纳米版:0.6B 并行决策模型,Qwen3-0.6B 底座加决策头,压根没有词表生成头——架构上就吐不出一句话。状态和问题进、完整概率分布出,单次矩阵扫过,视频实测 34-47ms。本页跟着视频从 git clone 走到路由脚本:装锁死 torch==2.14.0 的 requirements-toy.txt(新卡如 RTX 5090 要手动换 CUDA 兼容二进制,否则静默回退 CPU、延迟从约 50ms 涨到 400ms 以上);snapshot_download 拉 unified-games-v1 checkpoint 并按 allow_patterns 只留 best.safetensors;双终端起服务(推理引擎 8765 端口 + HTML 前端 8080),浏览器里看 NanoJev 走 50×50 迷宫、每步方向实时置信条;然后写 Python 路由脚本——入口契约是不收对话式 prompt,先建共享状态 payload(应用日志 / code diff / 解析后的 DOM 树),再挂并行类型化问题(choice 0.842、boolean 0.991、score 0.740),一次前向全部返回归一化浮点数。路由层是不对称错误原则:≥85% 自主执行、50-85% 转人工、<50% 转后备 frontier 模型。视频结尾的诚实段原样保留:unified checkpoint 被游戏空间机制深度条件化——空间导航约 88%,语义文本上直接坍塌——上自己的领域前,先跑一遍你自己的监督微调。
阅读攻略
PPLX Decider 实操教程:Perplexity 开源 27B 决策模型、Decisions API 与 12 张工单的分诊实测
PPLX Decider(Hugging Face perplexity-ai/pplx-decider-v1-27b)是 Perplexity 开源的决策模型:以 Apache 2.0 许可证从 Qwen3.8-27B 微调而来,用概率而不是文本作答——是非概率、给定选项中的一个、或评分量表上的一个等级。本页跟着视频走完全程:模型卡(Text Classification、multimodal、custom-code、apache-2.0),2026 年 9 月在固定 2,710 行数据集上测得的 11 项基准面板(Decider 总分 85.71%,Jev 84.51%,自家底座 Qwen3.8-27B 只有 74.76%——厂商自报口径,卡面自带的免责声明原样保留),以及社区 Jev Decision Index——排行榜自己的悬浮卡写着 Jev 57.9 排名 #1(中位延迟 524ms、托管 API),pplx-decider-v1-27b 56.4 排名 #4(101ms、28B、全量微调)。然后是托管半场:Decisions API 的三类问题原语——noul(是非概率)、choice(1 到 255 个选项、逐选项概率加置信度)、score(最多 10 级的有序量表加期望分)——state 可携带 base64 截图(上限 2,048 个 32×32 像素图块),单请求最多 128 个问题、约 26.2 万输入 token。结尾是 Perplexity 官方 cookbook:每张工单三个概率问题,12 张工单约 2.5 秒分诊完毕,3 张升级,且只有这 3 张会送去昂贵的 Agent API。视频之后有两件事变了:输入定价已腰斩至每百万 token $0.02(视频里说的是 $0.04),v1.1 checkpoint 已把 Decision Index 提到 61.56——反超 Jev。
阅读攻略
AutoTrust JEV-27B 本地实测:四臂对照、72 道 held-out 题,和一个 0.969 高分的错误答案
AutoTrust JEV-27B(huggingface.co/autotrust/JEV-27B)是 AutoTrust AI Lab 第二个 System 1 + System 2 一体化开源模型:冻结的 Qwen3.8-27B 骨干上挂了约 1.09 亿训练参数——决策 adapter 加打分头——从 TypeSafe 托管 Jev 蒸馏决策行为,本地权重自带训练增件、无需回调 teacher。先说清命名,再谈别的:它不是唯一的开源 27B Jev 系模型——ZefanCai/Open-Jev-27B-v1.1 是另一个社区发布、以 LoRA adapter 形式挂在同一个 Qwen3.8-27B 底座上——AutoTrust 自己还有一个视觉姊妹版 JEV-27B-VL;本页讲的是视频里这支文本模型。这支视频来自 RUNTIME. 频道,是一支十分半钟的 DGX Spark(GB10)独立实测,权重为 16 位 BF16:四臂同题计分——小型确定性规则解析器、训练好的决策头、同一骨干的普通生成、以及先思考再打分的推理路径——横跨 72 道 held-out 政策路由题外加 96 个扰动变体。记分板:普通生成 50/72,快答决策头 63/72,推理路径 71/72,规则程序 70/72。接下来是宣传稿会剪掉、本页完整保留的段落:测试方发现自己有 5 道路由题存在词面冲突(policy exception 把计费问题送 Security 人工审计,而 Security 选项自己描述的是未授权账户活动),剔除后重算——推理路径 67/67 满分;他们在 24 道 dev 题上扫了 0.50 到 0.95 六档置信度阈值,无一达标,所以这支视频里不存在可用的混合门控;核心错例更是教科书级:快答头在一道错题上打出 0.969 的高分,最高阈值 0.950 照样放行。Spark 上的端到端时延中位数:快答头 0.65 秒、普通生成 2.34 秒、推理路径 102.20 秒——推理路径在 72 题里有 20 题撞上 512-token 预算上限,下载体积约 50 GiB。这支视频最终挣到的结论是:偏好分数不等于经过验证的可靠性——清晰条件留在代码里,先测再上生产。
阅读攻略
Clef 27B 本地实战:Cloudflare 多模态决策模型一次读懂图片、视频和乌兹别克语报纸
Clef 27B(Hugging Face:Cloudflare/clef)是 Cloudflare 出的开源多模态决策模型:27B 参数、BF16 张量、Apache 2.0 许可证,模型卡一句话说清契约——状态可以是文本、JSON、图片或视频,配上一组类型化问题,单次前向为每个问题的每个允许选项给出校准概率,全程零 token 生成。视频的定位很传神:之前拿 CLM、Laya、Jev、Julia 测过的所有东西,这回长了眼睛。本页跟着视频一场测试一场测试地走,所有数字都对着终端帧逐一放大核对过:复跑频道招牌的社工陷阱(员工索要生产库紧急访问权 + 未核实的管理员批准),Clef 一发回四答——grant access 5.9%、风险等级 2.48/3(High)、社工检出 76.1%、处置动作 escalate——与 CLM、Jev 同列检出组,而 Kev、Laya、OpenJev 在前几期里都中过钩。官方 parallel-outputs 图解释了单次前向为什么重要:一条「API 挂了、订单停摆」的工单加两个问题,同一拍返回部门 Technical 100%、紧急度 Yes 100%。显存这关是真实的:租来的 NVIDIA H100 PCIe 上,nvtop 读数 52.06 GiB / 79.65 GiB,python app.py 占 52,682 MiB——口播「全载不到 54 GB(含 KV cache)」与卡面完全对上,BF16 想原生跑就按 80 GB 卡做预算。接着是多模态五连:AI 生成的办公室三角剧照片读出 primary stress 是工作 94.5%、老板真心爱意仅 7.3%(口播翻转即 92.7% 不是动心)、她的选择 neither 71.9%、结局「乱糟糟但她能活」;8 秒 AI 生成雪地蜡烛男短片压成 192 帧,读出情绪 ritual 72.2%、危险 16.2%、蜡烛含义 memorial 60.2%、结局「他独自活下来」;Cloudflare 官方基准表上 Clef 领跑 ToolRet(69.19)、BANKING77(94.20)、CLINC150+OOS(97.43),但「何时该转人工」的 When2Call 一行仍归 Jev(80.97 对 72.37);无翻译直读 kun.uz 截图,语言识别 uzbek 95.9%、乌克兰冲突提及 97.8%,唯一失手是 UN 提及 39.6%——BMT 是乌兹别克语的联合国缩写;最后是大学级滴定曲线:图型 titration 99.1%、二元酸 97.8%、两个等当点 96.7%、终 pH twelve 97.3%。想让决策模型「看见」世界,当前的标准参照物就是它。
阅读攻略
Ollaya 实操指南:装好「决策模型界的 Ollama」,看清每一个厂商口径数字,再亲手补上它留白的 CPU 实测
Ollaya(GitHub ollaya-dev/ollaya,官网 ollaya.dev)的自我定位只有一句话——「在本地运行开源决策模型:拉取并提供 Laya、decider、NLI 和 GliClass,藏在一个 TypeSafe 兼容 API 背后。决策模型界的 Ollama」——这句定位是双刃剑:它是最快的解释,也是最常见的误听来源。本页跟着 LocalLayer 九分半钟的上手实测,从身份一路讲到留白的终点。Ollaya 是 Rust CLI 加常驻后台 daemon:CLI 发请求给 daemon,daemon 用本地 HTTP API 暴露一切;运行时 Apache-2.0,自带模型分持 MIT(llama.cpp、NLI)与 Apache-2.0(Laya、Decider、Kev)双许可证;安装是一条 curl | sh 脚本,零编译。卖点在延迟:TypeSafe 托管 Jev API 报价 236-276ms 每次调用,而 Ollaya 在 RTX 4090 上跑 laya:en 报告 8-10ms——含完整 HTTP 往返,不只是卡上算力——未预热首查 8.1ms,decider 2B 约 190ms 证明不是所有模型都这么快。视频自己打出「Every number here is vendor-reported」的字幕,本页给每个数字保留这个标签。线级兼容是迁移故事:现有托管 API 客户端直接改指本地 daemon——streaming 格式完全一致,原生端点 /v1/systemone,/v1/decisions 是精确别名,鉴权头 Bearer local。热度段用同一把诚实的尺子读 Hacker News:一个帖子(「Ollaya – Ollama for open-source, Jev-style decision models」,提交人 Ardakilic,item 49848269)直播快照 586 分 / 139 评,18 小时口径 489 分 / 122 评——同一帖两个时点——同周另一个第三方 Web UI 帖停在 5 分。质疑段单独成节:HN 用户 hbrn 的「决策模型只是营销话术,决策模型 = 分类器」,视频的回应是开箱——nli 435M 和 qwen3guard 600M 本来就是分类器,kev 9B 和 winnow 12B 是被改造成给选项打分的 decoder,而罩在它们上面的是同一份契约:书面问题 + 输入状态 → 单次前向 → 校准概率图,解码循环被跳过。榜单段引用 benchmarkheaven.com 并重复到刻进脑子:第三方、未审计、分数会漂——live 快照,不是认证基准——Jev 1.13.0 capability 64.7 / composite 63.3,Laya(ModernBERT-Large 421M,卡面署名 Convai Innovations,Ollaya 只打包不训练)双榜 #41:49.9 / 30.3,每千次决策约 $0.0029。然后是实操回报:一个 daemon 扛工单分诊、shell 命令过滤、agent 工具调用三件事,MCP 支持让 Claude Code 用一次工具调用顶替一整次 LLM 调用,端到端 demo 对重复扣费工单返回 billing 置信 0.78 外加纳秒级耗时收据——eval_duration、load_duration、total_duration。视频收在一个开放练习上:没有任何厂商发布过 CPU-only 数字,所以它镜头前跑 OLLAYA_DEVICE=cpu,然后拒绝读出结果——本页同样把这个数字留白。跑一下 CPU 测试,你的 eval_duration 是多少?
阅读攻略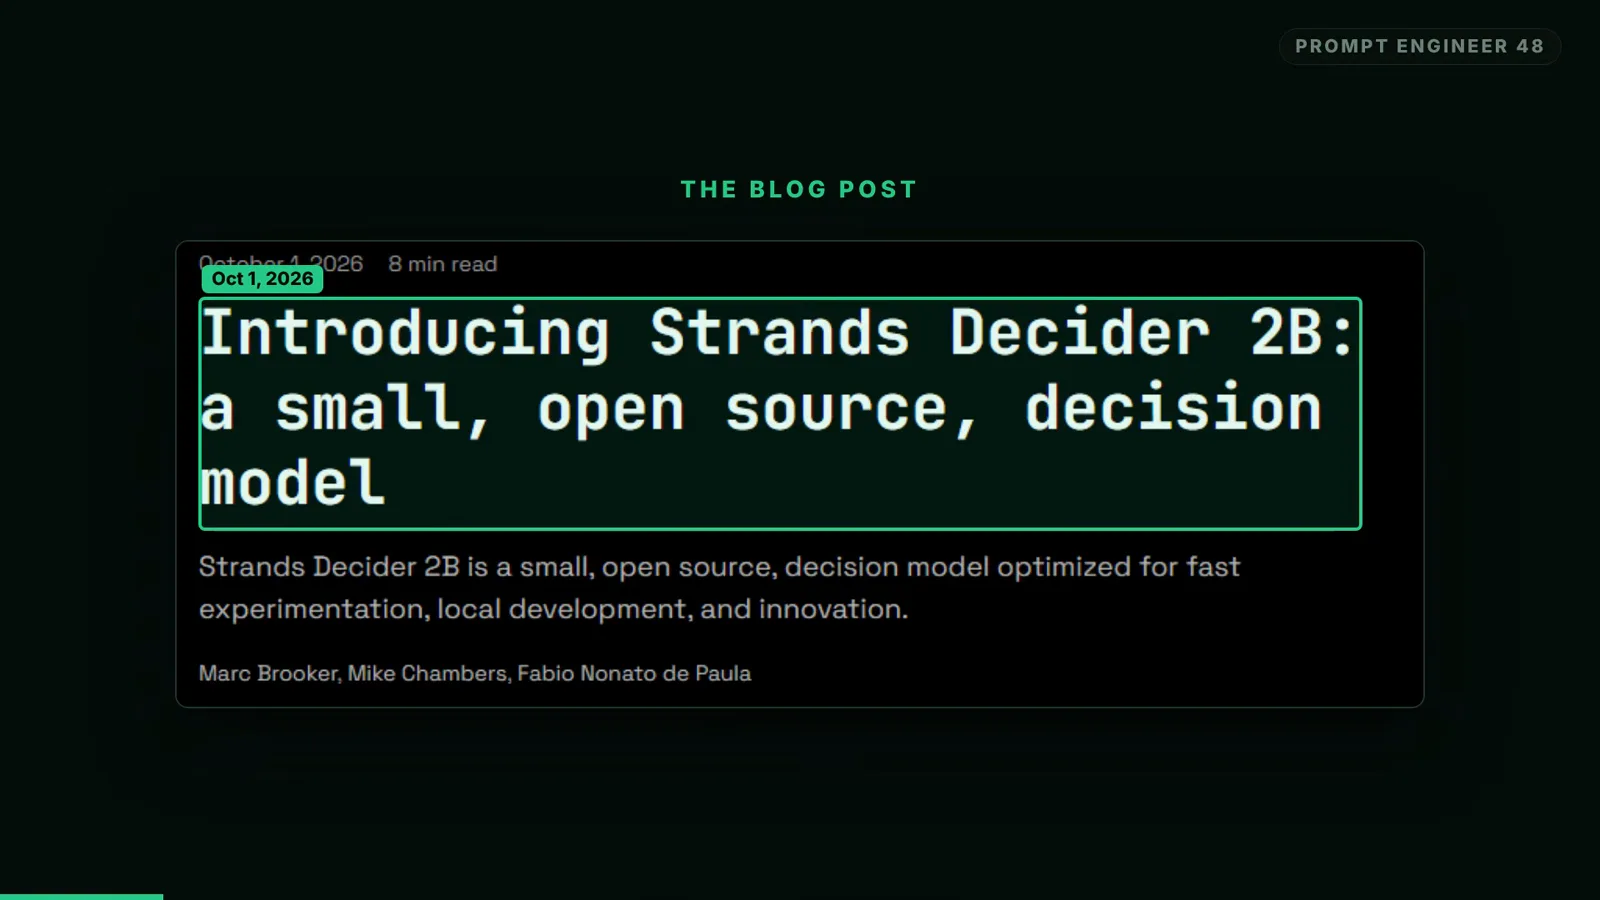
Strands Decider 2B 实测:8GB 笔记本本地安装 AWS Strands 系决策模型,把失败段也留在这页里
Strands Decider 2B(Hugging Face StrandsAgents/strands-decider-2B-hobson-v19,GitHub strands-labs/strands-decider)是 Strands 团队出品的开源 Apache 2.0 决策模型——与发源于 AWS 的 Strands Agents SDK 同一生态,builder.aws.com 的训练手记与 VentureBeat/marktechpost 的 Amazon/AWS 表述共同坐实归属——项目博客 2026 年 10 月 1 日发布。它是一个「system one」模型:在你写进请求的选项里挑一个、在有序量表上打分、用概率回答是否题,而且完全不能生成文本——Qwen3.5-2B-Base 底座的 LM head 被摘掉,换成了约 1M 参数的 fp32 pointer head(LoRA r16 训练,总参 1.9B)。本页跟着视频从 pip install 走到收尾判定:逐位复现博客工单路由例(billing 置信 0.768)、熬过 Windows 笔记本上带快核回退警告的 229.75 秒首次加载、serve 起服务后 POST /v1/systemone 拿到带概率、token 用量与 latency_ms 的 JSON 响应、看选项描述把同一问题的置信从 0.768 拉到 0.922、五问一发约 518ms、RTX 4060 笔记本 30 次热请求实测 178ms 中位对照官方 RTX 3090 的 115ms repo claim、按置信路由大小模型(法国首都 0.913 走小模型;证明题 0.565 但置信仅 0.13)、接 before_tool_call 工具守卫(西雅图瞎猜被判 GUIDE、巴黎仅以 0.011 的边际 PROCEED),以及刻意保留的失败段——strawberry P(yes) 0.463、注入文本注入问 0.656 但 policy 问 allow 0.757「别当唯一防线」。repo 口径 v19 在 JevBench 231 题拿下 72.3%(167/231,2B 级 33 支中第 3),单卡 RTX 3090 训练 11 小时,v20 没打过 v19 也照发。
阅读攻略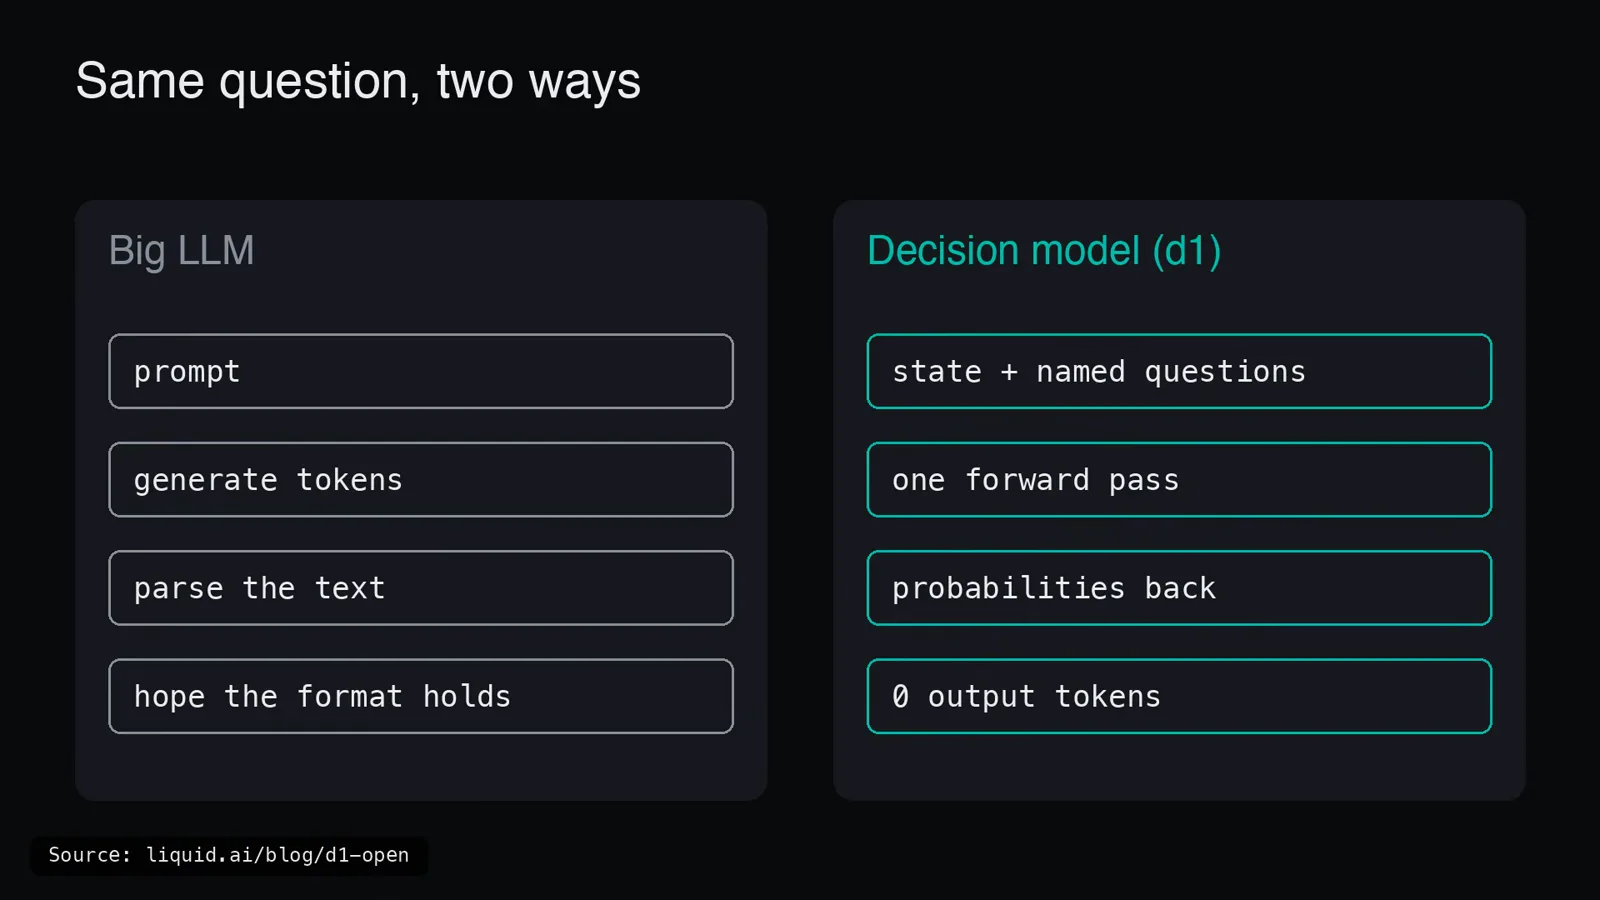
Liquid AI Open d1 本地实测:d1-3B 与 d1-omni-600M 跑进 MacBook Air M5
Open d1 是 Liquid AI 从闭门演示走向开放权重的一步:2026 年 10 月 7 日在 X 与 liquid.ai/blog/d1-open 同步公布的两款开源多模态决策模型,读一遍 state、直接还你概率,全程一个 token 都不生成。d1-3B(约 3.1B 参数、文本+图像、32K 上下文、LFM2.5-VL-3B 底座)与 d1-omni-600M(约 587M 参数、文本+图像或文本+音频、16K 上下文、实验性 checkpoint)共用同一套三类问题:noul 是否题({"noul": 0.93})、choice 在你命名的选项里挑一个({"choice": "billing", "confidence": 0.81})、score 按你定义的刻度打分({"score": 2.4, "confidence": 0.77})。官方对照卡把品类说穿了——大模型路线是 prompt → 生成 token → 解析文本 → 祈祷格式不崩,d1 路线是 state+命名问题 → 一次前向 → 概率返回 → 0 输出 token。3B 内部走 SigLIP2 视觉编码器(27 层)加分词器合流,序列穿过 LFM2.5-2.6B 主干(30 层因果层),LM head 只读序列中每问题一个标记位就出分布;训练法是两个底座取平均、换种子换数据重训多份再合并,官方说最大收益来自「输入文本加长、选项顺序打乱」这类朴素操作。omni 换成双向的 LFM2.5-Encoder-350M(16 层),视觉用 12 层 SigLIP2 或音频用 17 层 FastConformer(二者永不同时),顶部换成决策头、分阶段训练。Liquid 自家 Decision Index v0.2.1 上 d1-3B 拿 48.57——10B 以下第一、与约 35B(大它 12 倍)的模型持平——omni 只有 15.95,但毒性检测与复述识别两张文本表仍是 omni 登顶;7 项文本任务均分依次为 82.9(d1-3B)、81.1(Decider 4B)、78.4(omni)、77.1(Decider 2B)。厂商口径的单问延迟:RTX 4090 8 毫秒、Jetson AGX Thor 16 毫秒、Jetson AGX Orin 64GB 26 毫秒、Orin Nano 50 毫秒、M5 Pro 30 毫秒,llama.cpp 首日即支持。这条视频的另一半是诚实部分:全部实测跑在一台无风扇 MacBook Air M5 上(Hugging Face Transformers + Apple GPU、零云端),无风扇的代价照单全收——单问 78 毫秒对官方 30、约 3.4K token 日志 2649 毫秒、64 条 state 打包每秒 8 条对官方 78。随后四场测试:智能体护栏放行只读与跑测试,拦下强推 master、删表、bash 直跑外网脚本、5000 美元转账和一封全员邮件(需人审 YES 0.94),14/14 与标签一致、每次约 155 毫秒;屏幕检查器每张截图都认对(连删除与截屏对话框都叫得出名字)却在支付表单和登录页放行——8/10,教训是这类场景仍要留硬规则;全站唯一的音频测试里 d1-omni-600M 不经任何语音识别直吞波形,在 lights/music/timer_alarm/weather/call/cancel 六个工具里做路由,「屋里太暗了」没说 light 也命中灯光,但栽在「忘掉我刚说的话」——8/10、每条 45–84 毫秒;文档分诊 d1-3B 8/8(中位 1989 毫秒/页)、omni 仅 2/8 还把几乎每页都判成法律通知。限制卡同样实在:不是聊天模型、omni 属早期研究、omni 配图时文本截到 896 token、音频仅英语且最长 30 秒且无托管、无风扇设备跑大图大批次很慢,而且作者自己的测试是小样本单次自打标签——找感觉可以,当基准不行。权重挂在 Hugging Face(lfm1.0 许可),transformers、llama.cpp、vLLM、SGLang 皆可跑,NVIDIA Jetson AI Lab 已收录,托管走 Liquid console、OpenRouter 或 Vercel AI Gateway——如果你的应用调大模型只为拿一个标签,这就是最值得试的一次替换。(顺带辨析:这个 d1 不是 Cloudflare 的 D1 数据库、不是 NCAA 一级联盟、也不是某个地板清洁剂品牌——搜这个名字时的乌龙盘面,与模型无关。)
阅读攻略
图像决策模型实战 RPA:Imajev-4B 与 Jev-Omni 无 OCR 直读 W-8BEN 税表,90% 置信阈值以下转人工审核
图像决策模型就是「拿原始图像当 state」的 Jev 系决策模型——不走 OCR、不做文本抽取,像素进、校准概率出。本页跟着 Sam Witteveen 的 Form Decision Inspector 演示走:两个社区开源模型并跑审查扫描表单——Imajev-4B(Hugging Face:mohit67890/imajev-4b)和 Jev-Omni(akhilaaa3/Jev-Omni)——所有数字都对着帧逐一核对过。叙事框架是 RPA 的兴衰:UiPath 在 2018 年令人惊艳,2021 年以约 300-400 亿美元估值 IPO、股价高位在 70 美元档,如今每股只剩 13-14 美元、市值不足 65 亿美元——从业者的诊断不是产品烂,而是那个年代的深度学习要按任务重度调参,没有一个能扛住多任务高准确率的通用分类器。基准卡是 ImageJevBench v0.1.3,「面向图像决策系统的 held-out 对比」:684 个计分项(228 公开 + 456 封存,另有 93 项退役不计分),卡面自曝 333 个新封存项是合成图像,综合榜共 49 个系统——Imajev-4B 以 76.39 居首(一人、15 天、1,200 美元 GPU 租金训成,作者是写过 Reddit 帖讲「客户流程图里几乎每个决策节点最终都落在人身上」的业务流程顾问),其后是 Jev-Omni 73.10、NeoHorse Jev 4B 71.94、Visual-Jev 4B Answer-SFT 69.81、JPT-4B 69.55。演示表单是一份未签名的 W-8BEN(打印名 Oliver Bennett、日期 03-25-2026、出生日期已填、签名行为空),问题集覆盖:是否签名、签名旁日期、邮寄地址、出生日期、缺哪个必填项、表型、字迹清晰度。首轮:7 个问题共 3.3 秒,Imajev-4B 单页 3,159 毫秒对 Jev-Omni 1,072 毫秒。签名题上,Imajev-4B 答 True 91.5% 越过 90% 自动采纳阈值(Auto 徽章),Jev-Omni 答 False 73.2% 被打上 Human 旗——而被打旗的才是对的,因为表单根本没签名。Auto 代表自信,不代表正确。改写成选择题(「签名栏上是什么?」)后双双答 typed name only——74.2% ≡ 75.1%,中间是 agree 标记——这是本页的核心方法论:这类模型做分类题比判断题稳,而哪个题型配哪个模型必须实测。追问邮件(「请在签名栏签名后寄回」)是挂在那条 missing 答案(page 1、signature、92.5%、Auto)上的纯条件逻辑——没有一个字是 LLM 写的。往 missing 问题里加一个 date of birth 选项——真的就是加一个文本框、无需重训——Imajev-4B 依旧稳答 signature 94.5%,Jev-Omni 却漂成 nothing missing 45.3%(date of birth 以 30.7% 居次),并在一栏出生日期明明填了的表单上答出 False 88.1%(Imajev:True 99.4%)。第二份「有签名、缺出生日期」的表单随后显示:双模型一致确认签名、一致抓出缺失的 DOB(置信度不同)。收束建议:先测哪些题型适配你的目的、再测哪个模型适配这些题型,按问题各自设置信阈值——RPA、快速图像分类、大规模图像处理,都是这套打法的用武之地。
阅读攻略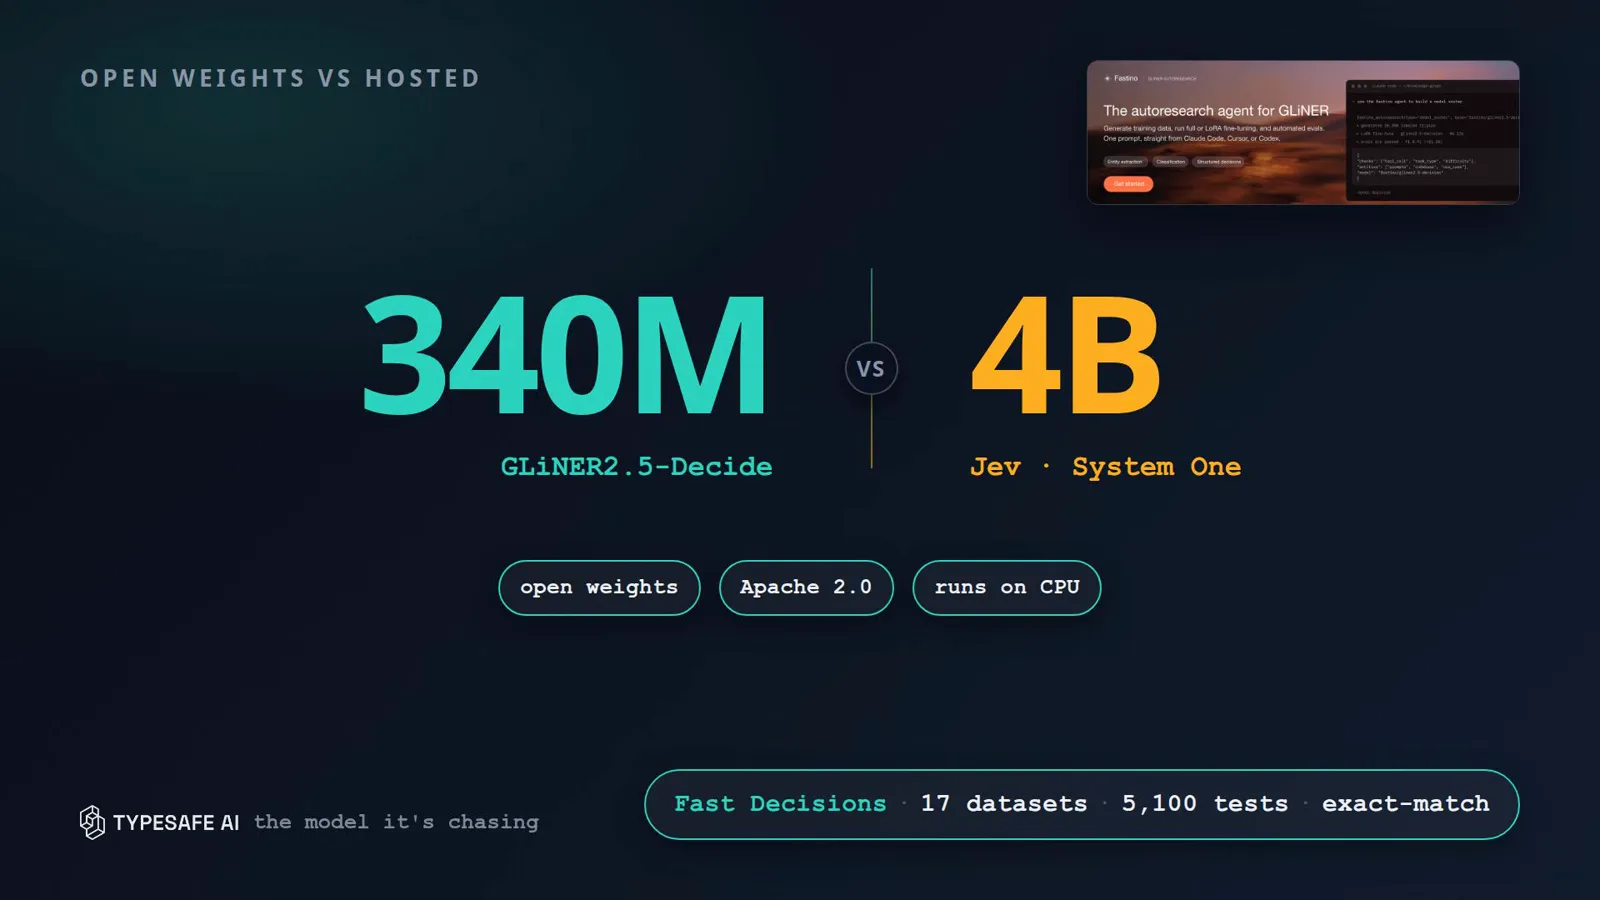
GLiNER2.5-Decide (340M) 对比 Jev (4B):决策模型到底谁赢?逐帧核对选型指南
GLiNER2.5-Decide 是 Fastino 发布的 3.4 亿参数文本编码器——在自家 GLiNER-2-large 路线上微调而来,底座编码器是 DeBERTa-v3-large(本页直接核对了 Hugging Face 上 fastino/GLiNER2.5-Decide 的 config,口播把这个名字念岔了)——这支视频的论点很直白:在 17 个真实路由与分类数据集、5,100 条留出测试、exact-match 计分上,它跑赢了一批 40 亿参数的决策模型,而且以 Apache 2.0 开放权重、CPU 可跑。本页跟着视频一张卡一张卡地走,每个数字都对帧核对过:两行接入(pip、AutoExtractor、一个普通 Python dict 标签集——无 prompt 模板、无生成 token、无 API key);Kahneman 式定位里 Jev 扮演 System 1,三原语(choice、score、noul)逐问并行、概率经校准,输入 token 每百万 0.042 美元、输出免费——TypeSafe 公开定价首次出现在本站;架构分岔处,GLiNER 单次前向给每个许可答案打兼容分,再由约束解码器搜出规则允许的最高联合赋分,而 Jev 家族逐问独立并行、问与问互不可见;中心案例里,一条提示注入攻击被逐问打分成 harm_type=prompt_injection 0.82、safety=safe 0.52——它看见了攻击却仍标安全——直到加一条「检出危害 ⇒ 不安全」的规则,联合解码才返回连贯对(safety=unsafe、harm=prompt_injection),而两路独立读数就把它放过去了;Fastino 自家的 fast-decisions 基准(17 子集 × 300 留出 = 5,100 条、全英语、错一个标签整个决策判错);记分板上 GLiNER2.5-Decide 均分 60.2,领先 Decide-1B 59.6、JevK5 57.6、GLiNER2.5-multi 56.7、SemIf 56.4、GLiFormer 49、Laya 46.6——support intent 75.3%(领先第二名 18.6 分)、banking intent 64.3%(+8.6)、17 个数据集独占领跑 9 个;batch 1、64 token 下 V100 延迟 38.3 毫秒、五卡相差不到 9 毫秒、纯 CPU 的 48 vCPU Xeon 167.3 毫秒;以及反账本——JevBench v1.4.2,独立、MIT 许可、四轴混合分——decider-4b v2 居首,Jev 1.13.0 以 63.29 坐第二,JevK5 第三 62.04,GLiNER 家族则交出 63.1(multi)与 62.1(small,经抽帧放大定谳)。不同的榜,不同的赢家。视频随后主动交底三条保留意见,最后落在一格刻意留空的 2×2 选型矩阵:要托管加校准选 Jev,要气隙自有算力加跨问规则与字符级 span 选 GLiNER2.5-Decide,要 Jev 请求形状的开源权重选 JevK5。
阅读攻略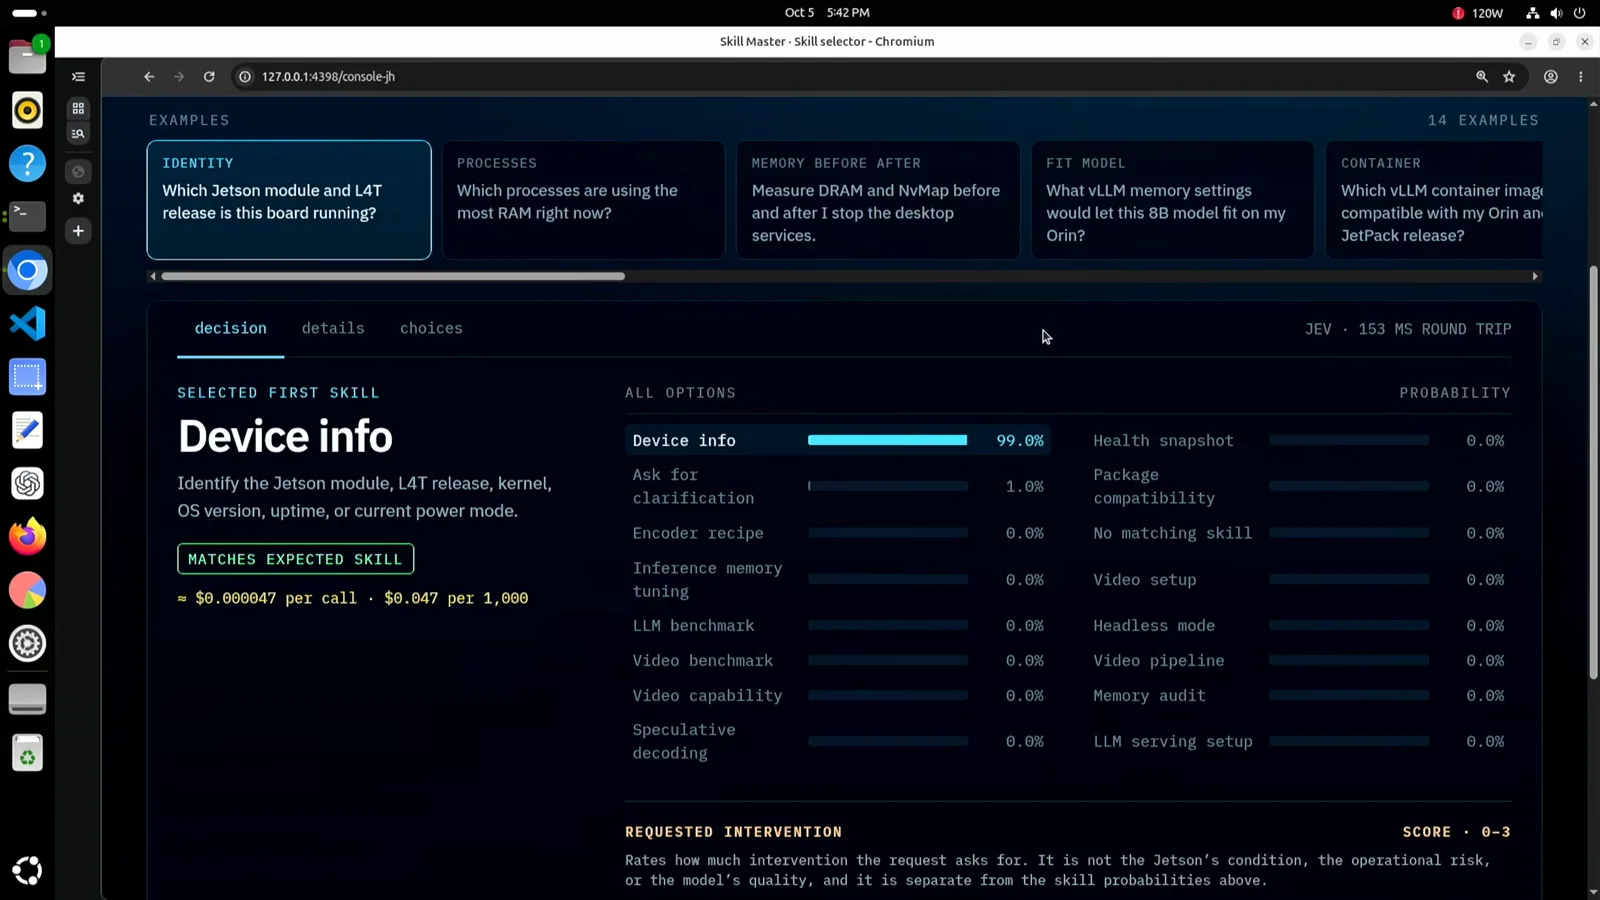
Jetson 边缘实测:Jev、Strands Decider 2B、Laya、d1-3B 四模型横评——Skill Master 记分卡、Thor 延迟账与 JevBench 逐帧核对
Skill Master 是 jetsonhacks.com 的 Jim 为一个问题搭的测试台:新一代决策模型在 Jetson 级硬件上到底行不行。这个本地 Web 应用把同一个查询发给多个模型、把答案并排画出来——托管 Jev 的标签页旁边站着三个小尺寸开源权重模型:AWS Strands Decider 2B、Laya 和 Liquid AI 的 d1-3B,选它们的理由只有一条:小到能装进 Jetson 的内存。十四道例题(identity、processes、memory before/after、fit model、container、serve、LLM performance、speculate、codec support、video ready、transcode、video speed,外加一道故意含糊的和一道目录外的)逐个发给每个模型,本页每个数字都对过卡面。开场题「Which Jetson module and L4T release is this board running?」Jev 以 Device info 99.0% 作答(Ask for clarification 拿走剩下的 1.0%,其余全为 0.0%),153 毫秒往返,界面还标出单价约每次调用 0.000047 美元。随后他故意上难度:一道 vLLM 部署题,胜出选项「LLM serving setup」只有 45.0%(Ask for clarification 27.0%、Package compatibility 15.0%)——低于他给出的经验线「置信度通常要过 60% 才可信,重要问题要更高」;但同一响应里的干预评分毫不犹疑:0–3 刻度上打出 2.99、置信度 99%、最可能等级 3「Change and verify」,整次往返就是他口播引用的 137 毫秒。模糊的「Can you check it?」返回 Ask for clarification 100.0%(干预 0.11、最可能等级 Inspect——他觉得这个评级有点不对劲);「写一首关于机器恐龙的诗」则被 No matching skill 以 100.0% 拒之门外——请求很清楚,但目录里没有合适的技能。线上格式是 TypeSafe 的 SystemOne API(api.typesafe.ai/v1/systemone):model 填 jev-latest,用户请求原文放进 state,名为 skill 的 choice 问题在 instructions 里写明何时选 clarify、何时选 no_matching_skill,criteria 把全部选项——14 个 Jetson 技能加 clarify 与 no_matching_skill——逐个配上人话描述;响应以 model jev-1.13.0 返回,答案带类型、带置信度,score 型问题还附图例与逐级概率(干预刻度为 0 Inspect / 1 Measure / 2 Recommend / 3 Change and verify)。一张图解卡把品类钉死:三类模型共享输入阶段——prompt、编码(pre-fill)、上下文表示——分歧只在下游:分类器输出训练时固定的标签,LLM 逐 token 写自由文本,决策模型在运行时任选选项、单次前向回答 noul、choice 或 score。然后是硬件:在 Orin Nano 上 Strands 与 d1-3B 会吃掉大部分内存,Laya——全场最小也最弱的模型——勉强塞下;更大的 Orin 与 Jetson AGX Thor 则绰绰有余。成绩卡按张读:Jev 14/14 全对、平均每次决策 150 毫秒(平均 1109 token 进、222 出;12 个 A、1 个 B、1 个 C——C 正好落在 serve 题,对应那次 45% 的低置信答案);Strands 14/14、平均 353 毫秒(794 进 354 出;10 A、4 B);Laya 8/14;d1-3B 14/14(9 A、4 B、1 C)。识别题拉开差距——Jev 99%、Strands 犹豫的 61%、Laya 直接选错、d1-3B 居中;维护题把顺序翻了过来——d1-3B 打出四个模型的最高概率,Strands 远超 Jev,后者的 serve 答案只有 45%。拿 Claude 做基线:平均约 2.5 秒选一个技能,Jev 约 135 毫秒,18 倍差距——「比常规 LLM 快 10–20 倍」的宣传在这场测试里完全成立。部署账单是本页的核心:直跑 Thor,这些小模型 30–50 毫秒出决策;包进一台模拟 TypeSafe Jev API 的 FastAPI 服务,要多付 75–100 毫秒——所以「基准数字其实低估了本地模型」,绕过服务器直连还能再快约一倍。JevBench 记分卡:Jev 1.13.0 86.6%(200/231)、d1-3B 75.3%(174/231)、Strands V19 72.3%(167/231)——简单题三家几乎持平,标准题 Jev 小胜,难题显著拉开;但聚焦到这些模型真正被雇用的任务类型(路由、策略决策、工具选择、复杂路由),三家本质等价,而只有本地模型能按你的工作负载微调。收尾卡是全场论点:决策表由应用定义——一道 noul、一道把 clarify 也当选项的 choice、一道 0–3 的干预评分——新决策只需要新上下文,不需要重训;但这份灵活性会在应用侧收费:instructions、类别清单、组合测试都归你写、你测。模型更简单、快得多;系统可未必。
阅读攻略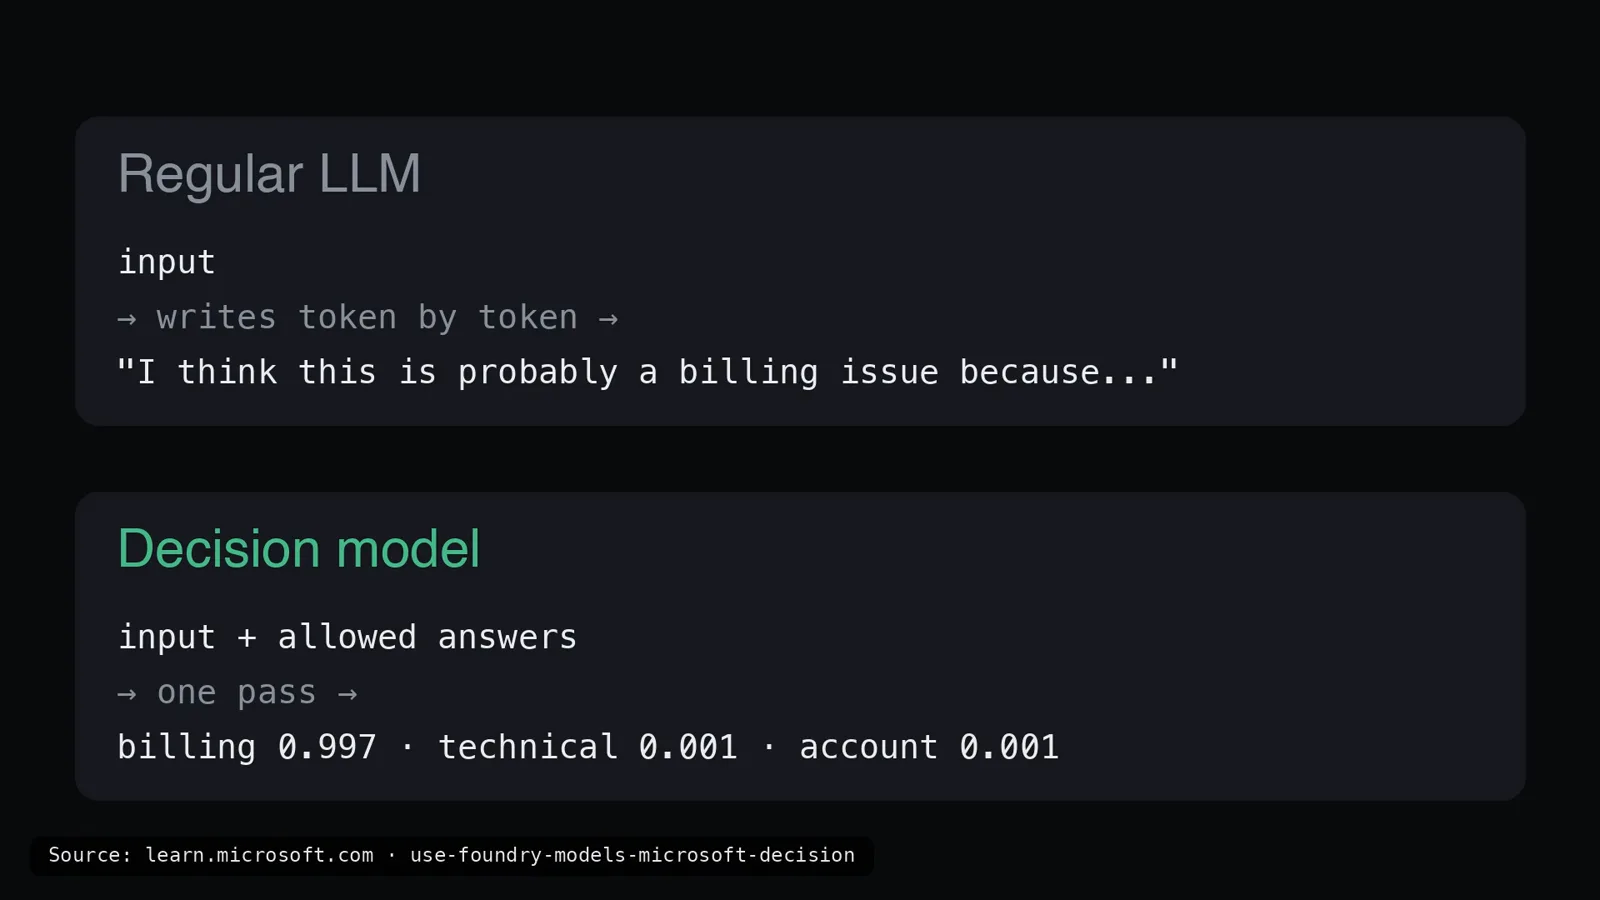
微软 Decision-1 实测:146 道独立测试、93% 均分、高置信时 124/125——每个数字逐帧核过
Microsoft Decision-1(2026 年 10 月 9 日发布,OpenRouter 上的模型 id 是 microsoft/microsoft-decision-1)是微软投进决策模型浪潮的入场券:一个永不写句子的模型——把 state 读一遍,为每个合法答案返回一个校准过的概率,输入 0.042 美元/百万 token、输出免费。写数字之前先辨析一个名字:Decision-1 是带连字符的产品名,不是「第一个决策模型」的宣言——视频自己的时间线卡显示它在这波浪潮里压轴登场。那张卡把五周历程收进一行:Jev(TypeSafe,9 月)→ Laya(开源,9 月)→ Clef(Cloudflare,10 月 1 日)→ Decider v1.1(Perplexity,10 月 6 日)→ Decisions API(OpenAI,10 月 6 日)→ d1(Liquid AI,10 月 7 日)→ Decision-1(微软,10 月 9 日)——而且微软连自评都用的 Jev 基准。按视频说法,底座是阿里巴巴开源的 Qwen3.5(90 亿参数),被微软改造成单次前向出评估结果的形态,官方称后续会把这套做法迁移到微软自家与 OpenAI 模型上;当前只有一个尺寸、只读文本。说明卡出自微软自家文档,把品类界线画得干干净净:普通大模型拿到输入后逐 token 写「我觉得这大概是计费问题,因为……」,而决策模型拿到输入加允许答案集,一次前向直接返回 billing 0.997、technical 0.001、account 0.001——代码拿到数字就行动:有信心就继续,没信心就转给人。厂商卡的头衔写得规规矩矩:「Microsoft says / vendor-reported」:36 个基准、约 15 万道没学过的 held-out 题上准确率最高;中位响应速度比 GPT-6 Sol 快 35 倍;Xbox 团队用它分拣一万多条玩家反馈,质量与 GPT-6 Sol 相当而成本只有约 1/200;请求改写或乱序时只有 1.3% 的答案翻转。评测者要的是自己的数字:146 道题、17 组、每道都预先写好标准答案,外加 36 次长文档调用(把一条条款藏在开头、中段或结尾)和 180 个改写乱序请求——全程走 OpenRouter、完全不配 Azure,从班加罗尔的笔记本上跑完,每张卡的 source 行都记着日期:2026 年 10 月 12 日。结果:均分 93%,17 组里 10 组满分——工单路由、玩家反馈主题、钓鱼邮件、提示注入、内容审核、JSON 校验、多语言(10 种语言加混语输入:印地语、卡纳达语、泰米尔语、日语、阿拉伯语,还有「Bro, OTP is not coming at all」这种 Hinglish)、代码漏洞、CSV 行欺诈检测、HTML 页面类型;镜头里,法语「我想要上个月付款的发票」以 99.9% 路由到 billing,德语「包裹标记已送达但从没到货」以 99.9% 路由到 shipping。剩下的七组就是失分的地方:模型路由 90%、缺陷严重度 88%、多问题调用 88%、LLM 裁判 81%、日志分诊 81%、智能体护栏 80%、搜索相关性 75%——失分全是判断题,而且引用的两处错例都错在偏谨慎这边(无害代码修复前先要批准;把一条真实的附加事实判成幻觉),评测者认为这恰是护栏该有的失败方向。校准双卡是整支视频的核心:置信度超 90% 时 124/125 答对;低于 70% 时只有 2/7 答对;全程校准误差 0.025(越低越好)——所以置信度数字真的能当路由闸门用:有信心就让模型行动,其余转给人或更大的模型。鲁棒性:打乱选项、换顺序、改名 A/B/C、改写问题、加随机空格、整段包进 JSON——180 个请求零翻转,微软那个 1.3% 在这套数据上显得保守(往好的方向)。长文档:藏在租约里的宠物条款,约 19,000 token 以内每次都找得到;约 33,000 token 时 API 直接拒绝——硬上限是 32,768 token、含决策 token(HTTP 422),长输入请先切分。速度:班加罗尔经 OpenRouter 到 Azure 的中位数约 620 毫秒,OpenRouter 自己页面标的是约 230 毫秒——大头是网络。整个实验的总账单:约一美分。收尾论点也正好是本页的论点:别把 Decision-1 当聊天机器人,把它当 agent 的管理层——负责指挥、打标签、评估、拦截的东西——准确、不怕改写、而且最重要的是知道什么时候自己不确定。这正是放手让 agent 自主行动之前需要的东西。以上每个数字都对照它出处的卡面核过,所有自测数字都是上传者自己的小样本,不是基准。
阅读攻略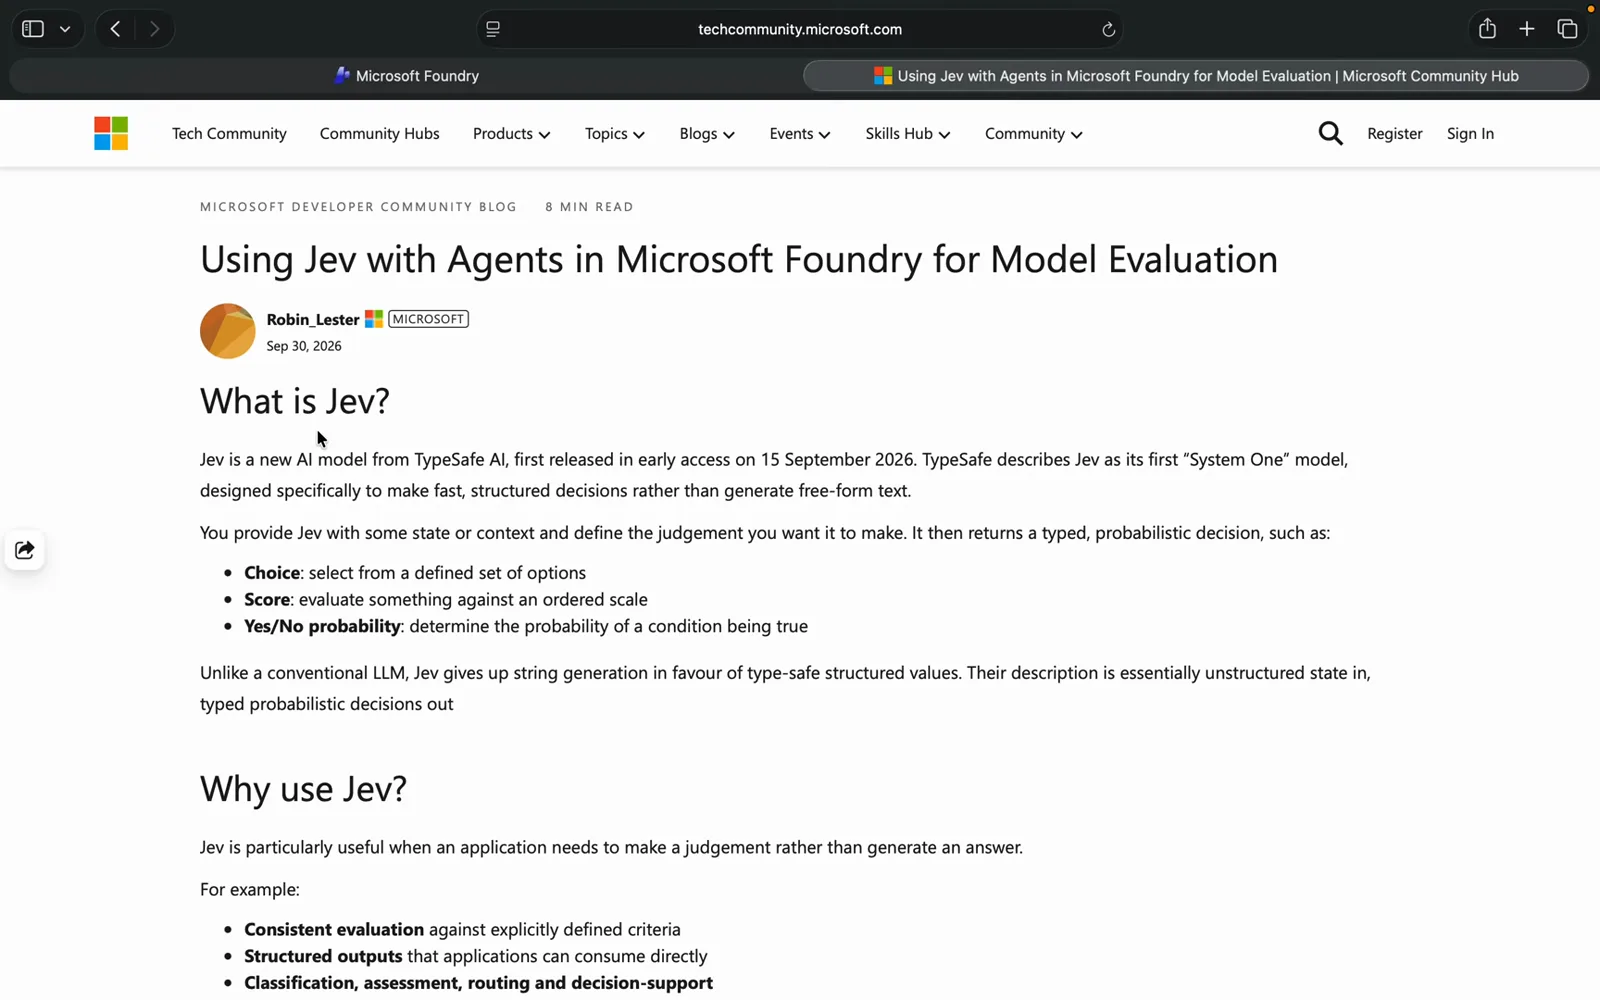
Jev 接入 Azure AI Foundry 实战:OpenAPI 工具、分诊指令与首跑失败复盘
Azure AI Foundry 是 Jev 集成家族的第七面墙,Mohamed Naji Aboo 在镜头前把整条路走了一遍,底稿是 Robin Lester 发在 Microsoft Tech Community 的教程《Using Jev with Agents in Microsoft Foundry for Model Evaluation》(2026 年 9 月 30 日)。模式很简单:Foundry 智能体跑 GPT-5 mini 当对话层,Jev——TypeSafe AI 的「System One」决策模型,2026 年 9 月 15 日起早期访问——以 OpenAPI 自定义工具的身份挂进来,给每条客户消息做判定。抽帧走过的流程:部署 gpt-5-mini(400K 上下文、文本+图像输入、文本输出,token 限额 272k 输入 / 128k 输出);创建智能体(自动命名 sincere-agent-21673j20y4、Text 交互模式);去 console.typesafe.ai 领 5 美元免费额度并创建 API key;在 Tools 里从 OpenAPI tool、MCP、Agent2Agent 三条路里选 OpenAPI tool;命名为 JevTest,把 TypeSafe 密钥放进新建连接(host 填 https://api.typesafe.ai);整段粘贴教程约两百行的 OpenAPI 3.0 schema——POST /eval 要求且仅要求 state、model、questions 三个字段,model 枚举锁死 jev-latest,apiKey 头部安全由连接凭证满足;最后保存分诊指令:「For every customer-support message you MUST call the evaluate_with_jev tool… Do not classify the ticket yourself. Use the values returned by Jev. Always show the Jev output at the end of the response.」。随后测试工单「The room had no water in and one of the towels was dirty」贡献了全片最有价值的几分钟:第一跑回了一封无懈可击的道歉信,Jev 零调用,甚至自己招认「I attempted to run our automated classifier but it was unavailable」然后越权自分类;复跑则明说工具「在这里不可用」,转而打出三段问题载荷(计费用 noul;语气用 choice,分 calm/frustrated/angry;紧急度用 score,1–3 刻度)外加一段示例响应——noul「true」、choice「frustrated」、score 3。镜头里的两次运行都没有出现真实回调:接线是本片的课,失败复盘是本片的诚实,而那个响应形状就是你要在自己项目的 Traces 里验证的东西。
阅读攻略心智模型转变:传统 LLM vs Jev 决策模型
| 对比维度 | 传统生成式 LLM(Chat / Text) | Jev 类型化决策模型 |
|---|---|---|
| 输出形式 | 自由文本字符串,需借助正则或 prompt 强行约束 JSON | 原生离散分类(Choice)、标量数值(Score)或二值门禁(Noul) |
| 代码集成 | 解析可能损坏的 JSON,偶发格式解析异常 | 直接作为条件分支 `if (answer === "refund")`,天然类型安全 |
| 置信度度量 | 无法可靠获知模型犹豫程度,自我评估往往过度自信 | 原生给出归一化概率分布(如 `shipping: 0.91`),可用于量化门限 |
| 失败兜底 | 输出胡言乱语或幻觉,难以在程序中安全熔断 | 低置信度自动转由人工审核队列或降级规则兜底 |
| 推理延迟 | 需要逐步自回归生成数十到上百个 Token,延迟通常在 1s 以上 | 单步前向分类输出,毫秒级快速响应,极低 Token 消耗 |
常见学习问题(FAQ)
Jev 和 GPT-4o / Claude 的 Structured Outputs / JSON Mode 有什么不同?
传统 LLM 的 Structured Outputs 仍然是通过自回归生成逐字产生 JSON 文本,耗费大量生成 Token 和延迟,且模型本身不提供严格校准的单选概率。Jev 属于分类与决策模型,在推理层直接计算离散标签的概率分布,具有更低的延迟、更确定的输出约束以及原生置信度输出。
学习 Jev 需要掌握复杂的 Prompt Engineering 技巧吗?
不需要。Jev 的输入由两部分组成:作为事实上下文的 `state`,以及定义选择意图与每个选项判决标准的 `criteria`。你只需要用清晰、无歧义的业务语言写明每个分类的定义(例如“退款申请:用户明确要求退还资金”),无需使用诸如“一步步思考”、“你是一个资深专家”等对抗性提示词。
什么是置信度(Confidence),应该如何设置业务阈值?
Confidence 是模型对其预测答案的后验概率估计(0 到 1 之间)。在客服路由或垃圾过滤等任务中,通常建议将 0.85 或 0.90 设为全自动流转阈值;处于 0.50 到 0.85 之间的中置信度请求移入人工初审队列;低于 0.50 的请求则走默认安全规则(如转人工或安全拦截)。
如何在现有全栈项目中引入 Jev?
推荐采用“分层适配”模式:在你的服务端框架(如 Next.js API Route、Hono 或 Express)中建立一个轻量 adapter,将外部用户请求抽取为关键字段作为 state,调用 Jev API,校验置信度后触发业务动作。绝不建议在浏览器前端直接暴露 Jev API Key 进行调用。
Jev 会发生大模型常见的幻觉(Hallucination)问题吗?
由于 Jev 的输出空间被严格约束在预定义的选项集合(Choice)、数值区间(Score)或二值状态(Noul)中,它不可能凭空生成 schema 外的未知文字或虚构事实。主要风险在于边缘样本的分类漂移,因此配合置信度检查与 Fallback 兜底是最佳工程实践。