
Guides / 视频转图文攻略
Jev n8n 集成实战:JevGate 社区节点分步攻略(附纯 HTTP 备选路线)
Perseo 的 JevGate 是把 Jev 逐选项概率变成 n8n 分支决策的 MIT 社区节点:配置 Decide、用 Calibrate 标定阈值、给每个选项一条 Route 出口。装不了社区节点?文末附 OpenRouter 纯 HTTP 备选路线,逐步截图。
速览结论
JevGate 是 Perseo 出品的 MIT 开源 n8n 社区节点(收尾卡给出的包名:n8n-nodes-jev-gate),把 TypeSafe 的决策模型 Jev 装进三个 n8n 操作:Decide、Route、Calibrate。Jev 不写文本:你给它要读的字段和一个只含可接受选项的问题,它给每个选项返回一个概率。节点要做的事就是把概率变成工作流动作:高于阈值直通,低于阈值——或者答案不在你的选项里——就带着原因进 review。视频 demo 让 6 条支持消息过一道闸:4 条 confident 直通,2 条 review 留下(一条香蕉面包食谱、一句光杆「hi」,都被节点自动附加的「none of these」选项接住)。Calibrate 在 0.5–0.99 的阈值上扫标注样本(12 条),推荐 0.7(0.5 漏进 1 条错误答案,0.7 零漏过)。本页还记录了第二条独立路线,给装不了社区节点的团队:flownix 的搭法用 n8n 原生 HTTP Request 节点 POST 到 openrouter.ai/api/alpha/decisions,IF 节点对分数做闸,Telegram 消息节点充当人工复核队列。诚实口径:这是一支 2:39 的短视频、一组很小的 demo(6 条消息、12 条标注样本)——这些数字标定的是那一个工作流,不是品类基准。
分步图文攻略
- 1
认识 JevGate:把概率变成决策的 n8n 节点
开场一卡讲完整个产品:Jev Gate 是把 Jev(TypeSafe 的决策模型)接进 n8n 的社区节点。左边两个概率,右边各自的去向:p = 0.98 越过阈值线,路由到「自动处理」;p = 0.49 差一口气,路由到「转人工」。这就是全部心智模型——本页剩下的内容都是配置细节。这个节点存在的理由很直接:躺在 JSON 字段里的概率什么也不会做,得有人决定拿它怎么办;而在工作流画布里做这个决定,决策逻辑就和它喂给的分支摆在一起,看得见、改得动。
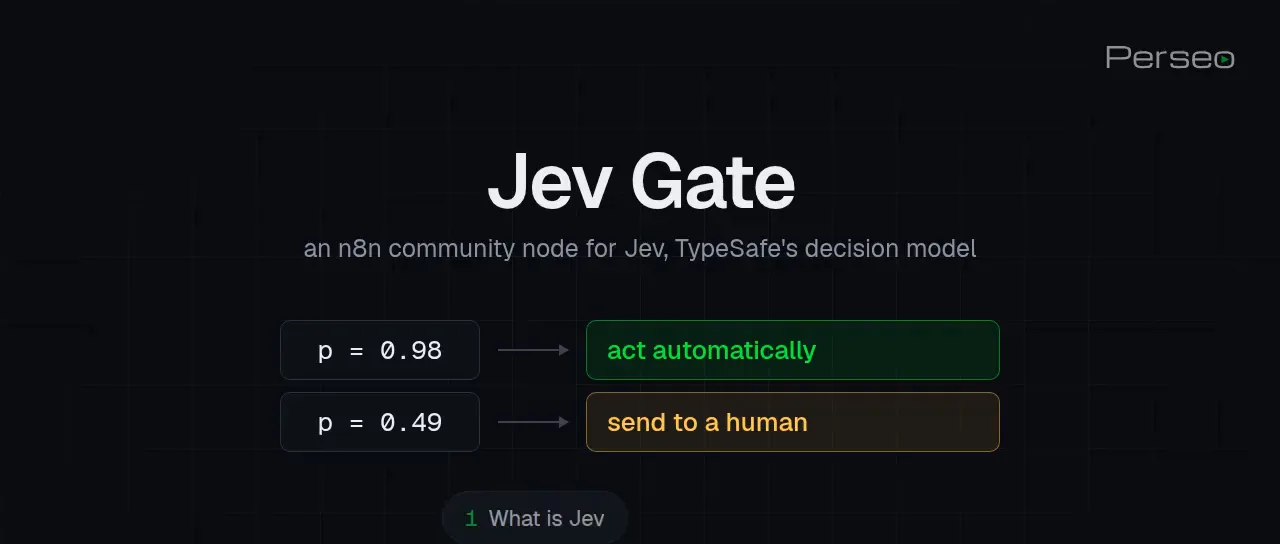
一帧讲清定位:高于阈值的概率自动执行,低于阈值的概率交给人。跳转至 0:06 - 2
Jev 回答什么——它在工作流里站哪个位置
进 demo 之前,视频先画了两条边界。第一条,Jev 是什么:一个不写文本的决策模型。你给它要读的文本和一个只含可接受选项的问题,它对每个选项返回一个概率。LLM 负责起草回复;Jev 负责回答「是哪个、多确定」。第二条,它适合哪一段:工作的确定性一端——给工单路由、给线索打标、核对抽取结果、过滤信息流——明确不包括「写回复」。放进 n8n 的语境:Jev 是「有东西进来」和「有东西发生」之间的那个节点——读一个字段,用输出决定哪条分支被触发。视频剩下的部分,搭的正是这一段。
- 3
三种问题类型:Choice、Score、Yes/No
Jev 接受三种 typed 问题,演示卡把三种连同 demo 工作流的真实答案一起摆了出来。Choice 从你的选项里挑一个:「这条消息该由哪个团队处理?」返回 billing 1.00、technical 0.00、sales 0.00。Score 把条目放到你定义的刻度上:「写这条消息的人有多恼火?」读出 Calm 0.78、Annoyed 0.22、Angry 0.00,选中的 0.22 分对应 Calm。Yes/No 返回一个陈述为真的概率:「这紧急吗?」返回 0.08——否,置信度 0.92。同一个输入字段,三种输出形状;每个答案都自带置信度,而这正是后面那道闸要消费的东西。
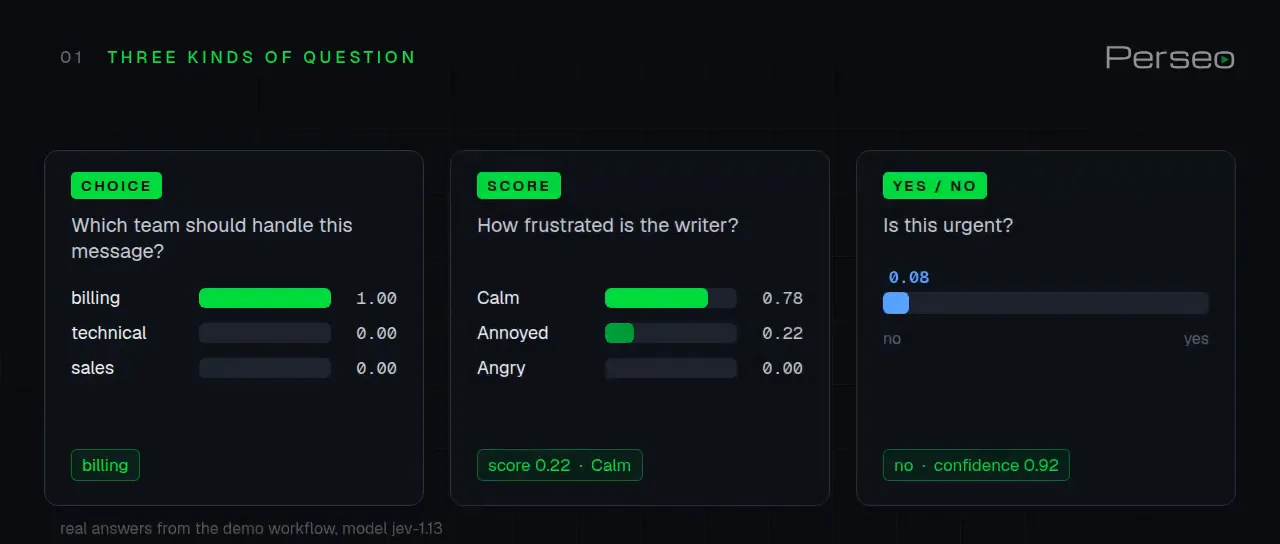
Choice 做选择、Score 打分、Yes/No 做门禁——每个答案都带自己的置信度。跳转至 0:31 - 4
两个约束:64k 窗口与不到一美分的价格
两个实用限制框住每一次集成。上下文窗口总量 64,000 token——卡片把「你的 state 加最长的问题」画进 64k 预算条(demo 用量标在 32k)——所以送真正要读的那个字段,别送整条记录。然后是价格,按卡面口径:输入 $0.042/百万 token,输出 token 免费,卡下方一行实测:12 条消息一次请求分类完花费 $0.000085——不到一美分的百分之一,和旁白的「under 1/100 of a cent」对得上。这个价格结构让「每条消息都问一遍」变得可负担:你可以对每条消息都发起提问,让阈值而不是批处理任务来决定什么值得关注。
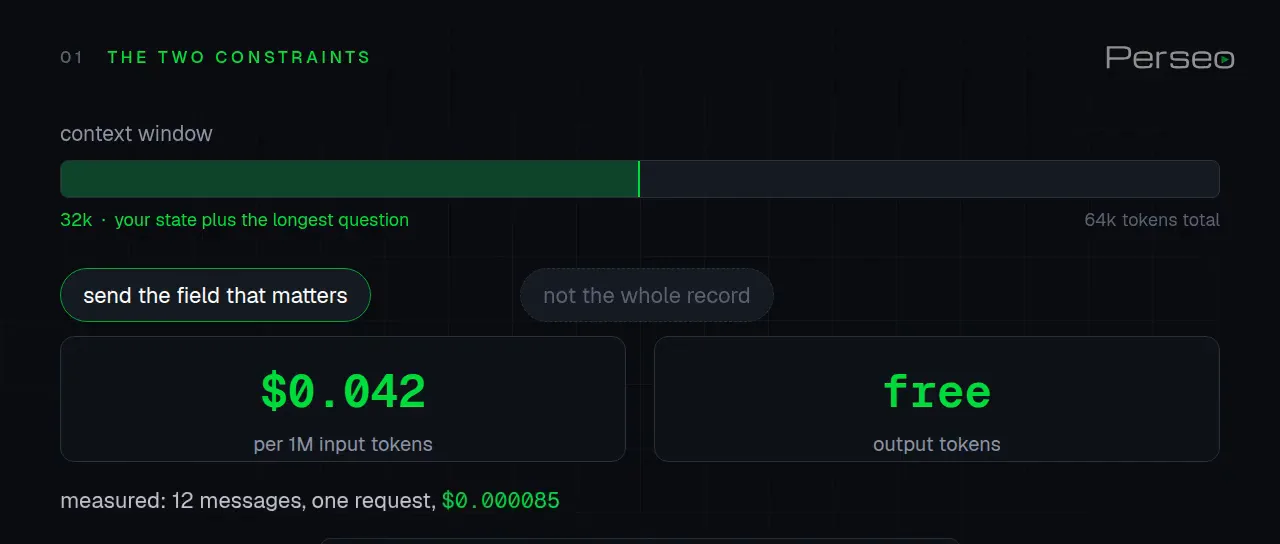
送字段、别送整条记录:64k 窗口,输入 $0.042/百万 token,输出免费。跳转至 0:55 - 5
一次配好节点:读哪个字段、问什么问题
节点在 n8n 里的样子。Jev Gate Triage 节点挂着「Jev Gate account」凭证,Operation 选 Decide,Data Source 选 Selected Fields,字段只勾一个:message。Define Questions 设为 Using Fields;问题本身是 Answer Key 填「team」、Answer Type 选「Choices」、提问文本「Which team should handle the support message in the field message?」。旁白总结的全部配置就是这些:选模型要读的字段、写问题、设一个阈值。没有提示词工程面板,没有温度参数,没有 system message——问题本身就是配置。
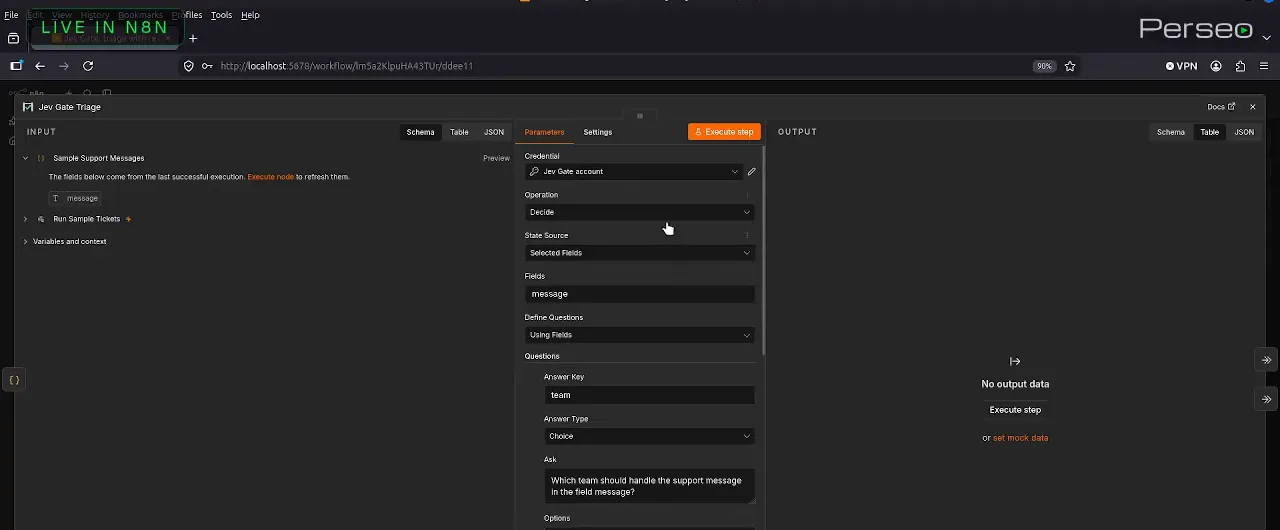
一个 Decide 操作:读哪个字段、问什么问题、接受哪些选项。跳转至 1:26 - 6
Demo 实跑:6 条工单进来,4 条 confident,2 条 review
执行过的工作流用分支上的数字讲故事:Run Sample Tickets(1 项)喂给 Sample Support Messages(6 项)进入 Jev Gate Triage,节点的两个输出把流量劈开——Confident 带着 4 项进 Act Automatically,Review 带着 2 项进 Human Review。每条流经的数据都带着:选中的选项、每个选项的概率、置信度、本次调用的成本;每条 review 数据还多带一样——它为什么在这。这次被留下的两条是一条香蕉面包食谱和一句光杆「hi」:节点会给每个问题自动附加一个「none of these」选项,跑题文本永远不会被硬塞进你的业务类目。这正是大多数提示词路由方案会藏起来的失败模式。
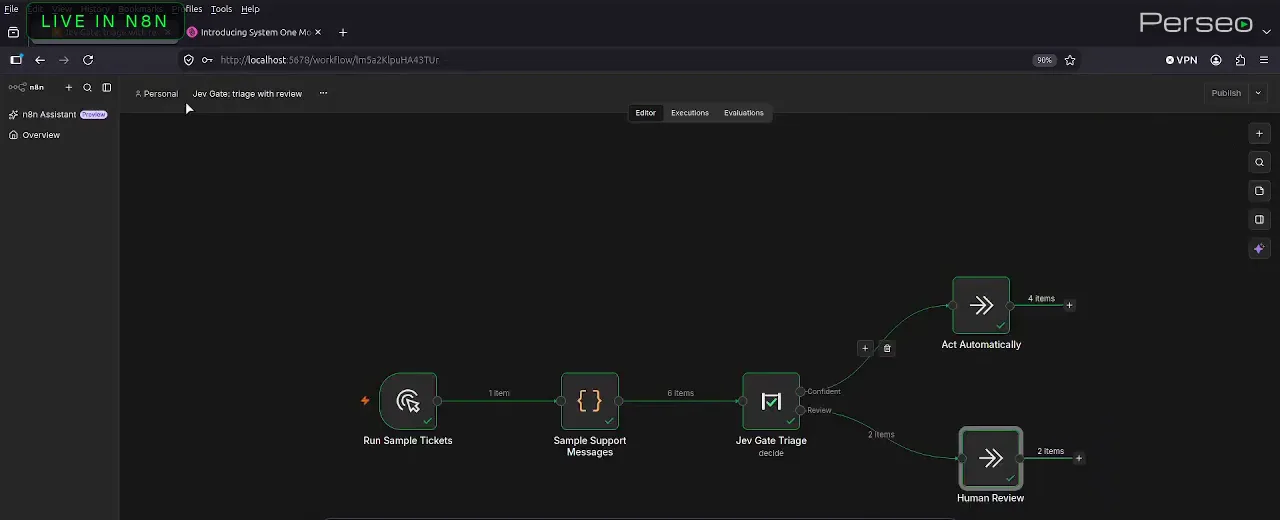
6 条工单进来:4 条直通,2 条留下等人。跳转至 1:59 - 7
Calibrate:让有标注的样本替你定阈值
阈值不该拍脑袋,视频用 Calibrate 操作证明了这一点。Jev Gate Calibrate 节点吃有标注的消息——这里 12 条,每条带一个 label 字段——返回你列出的每个阈值的准确率与覆盖率(Thresholds 字段里填的是 0.5、0.7、0.8、0.9、0.95、0.99)。输出表先给出诚实的基线:accuracyWithoutGate 0.9166,也就是不加闸时 12 条对 11 条。这一跑里,0.5 的阈值放进了 1 条错误答案,0.7 则让每条 confident 答案都保持正确——于是节点打印出 recommendedThreshold: 0.7。先拿自己的标注集扫一遍,再写死数字;「对的阈值」是你的类目和流量的属性,不是模型的属性。
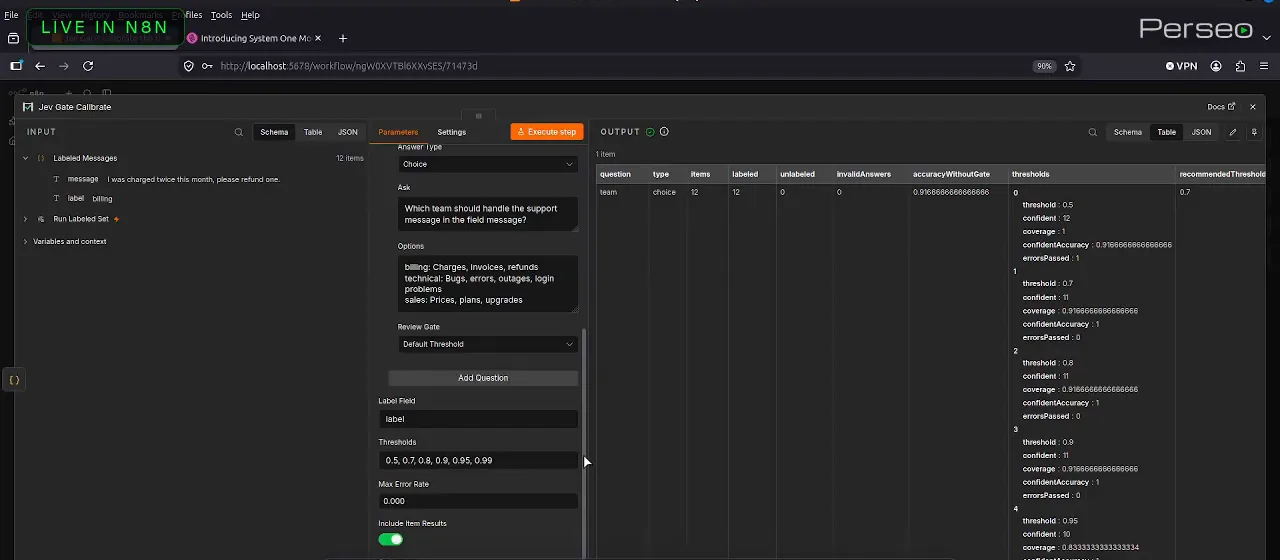
节点替你扫完阈值并打印推荐值:0.7。跳转至 2:03 - 8
Route:每个选项一条出口,review 永远殿后
Decide 给你两扇门;Route 给每个选项各一扇。视频里的 Route 操作给每个选项起名并用平实英文描述它——billing:「Charges, invoices, refunds」;technical:「Bugs, errors, outages, login problems」;sales:「Pricing, plans, upgrades」——置信度阈值设 0.65,并且永远把 review 放在最后一个输出。如此一来,不确定的条目永远有去处。旁白把运营收益讲得很准:confident 的部分没有人也照常运转,而人只看真正不确定的那几条。在一个繁忙的工作区里,这就是「没人看的分拣队列」和「只装着真拿不准项的审核队列」之间的区别。
- 9
你在装的是什么:n8n-nodes-jev-gate,MIT,23 个单元测试
收尾卡报出包名:n8n-nodes-jev-gate——Decide、Route、Calibrate——MIT 许可,Perseo 出品。旁边的工程卡列出作者做过的验证:23 个单元测试、对 API 的 live 验证、n8n 内执行。把范围说诚实:这是一支 2:39 的视频、一组很小的 demo——6 条消息过闸、12 条标注样本过 Calibrate。这些数字标定的是那个 demo 工作流;它们不是 Jev 或这个节点的基准测试。视频真正确立的是集成的形状,而这个形状正是你为自己的类目要重搭的东西。
n8n-nodes-jev-gate:Decide、Route、Calibrate——MIT 许可,Perseo 出品。跳转至 2:38 - 10
装不了社区节点?原生 HTTP Request 节点干同样的活
从这里开始的画面来自另一支独立视频——flownix 的 n8n + Jev 实操(每步附时间戳直达)——它什么都不装也到了同一个终点。n8n 原生 HTTP Request 节点配置 Method 为 POST、URL 为 https://openrouter.ai/api/alpha/decisions,Authentication 下拉(None / Predefined Credential Type / Generic Credential Type)就是挂 OpenRouter 密钥做 header 认证的地方。下游用一个普通 IF 节点把返回分数和数字比大小(「is greater than」)——这就是手搓版的阈值。代价是节点便利性的反面:没有自动附加的「none of these」选项、没有 Calibrate 扫描、没有逐选项的 Route 出口。你换来完全的控制和零安装;闸门的每一块也都得自己负责。
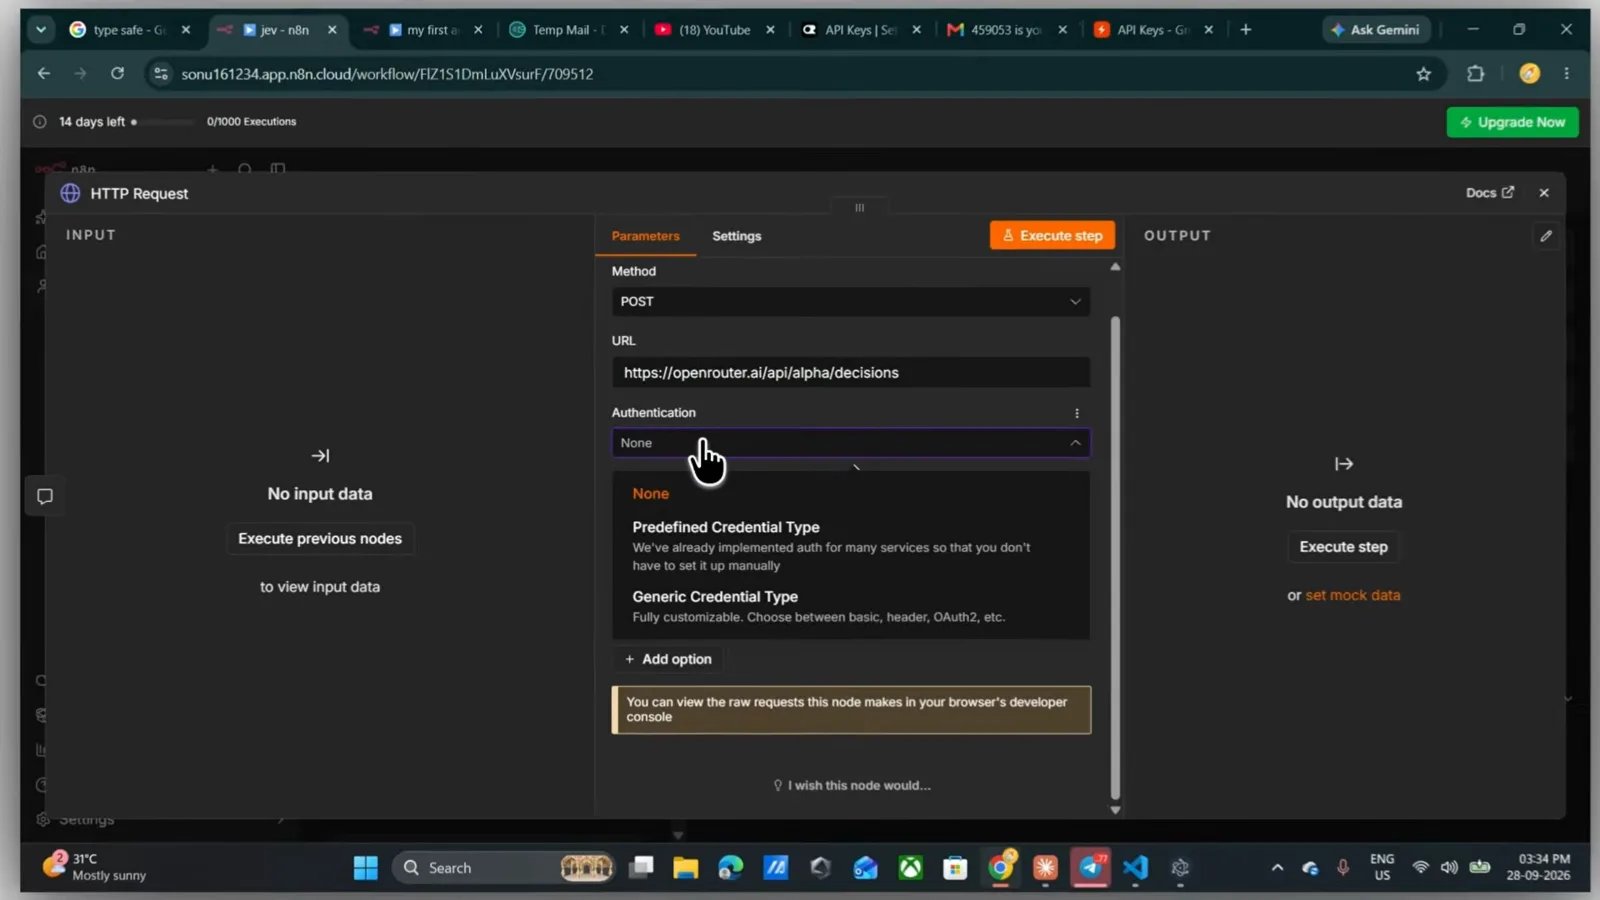
画面来自 flownix 的另一支独立视频(时间戳跳转到该视频):用 n8n 原生 HTTP Request 节点做同一件事。跳转至 1:40 - 11
把拿不准的交给人:Telegram 充当复核队列
同一支来源视频的下一段管线:Telegram 的「Send a text message」节点。配置里是已连接的「Telegram account」凭证(来自你的 bot token)、Resource 为 Message、Operation 为 Send Message、复核人的 Chat ID、以及一个映射自聊天输入的 Text 字段——Reply Markup 设为 None。这套搭法里 IF 闸把低置信消息路由到这里,复核人的 Telegram 就是复核队列;其余消息流向一个 AI Agent(提示词选 Define below,响应模式「Using Response Nodes」),普通消息照常得到回复,拿不准的那条则叫人。说明一句:这支视频的印地语旁白只有机翻字幕,以上细节以画面为准,别拿字幕文本当依据。
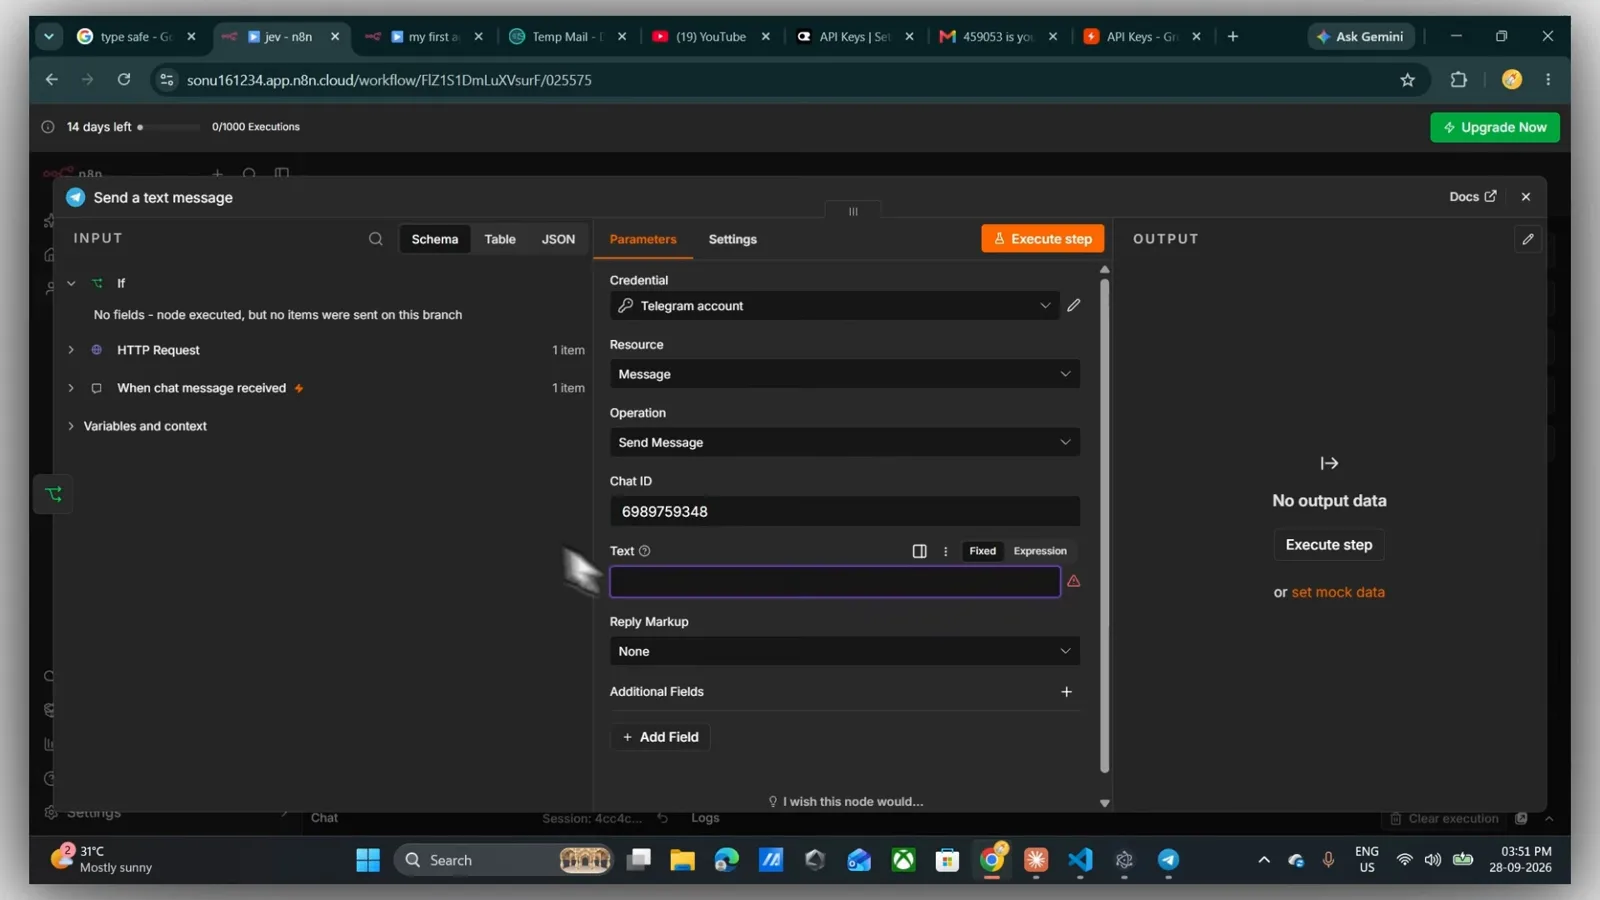
同一支 flownix 视频、同一个思路:复核人的 Telegram 聊天就是复核队列。跳转至 5:00 - 12
端到端跑通:拿不准的那条工单找到了人
验证跑。一条聊天消息进来——「Help! My payments have been failing for 3 days and nobody answers support.」——执行日志摆出路径:When chat message received、HTTP Request、Send a text message 全部成功,画布上方是「Workflow executed successfully」徽章。Agent 在聊天里回复用户,同时复核消息落到复核人的 Telegram 上。两种实现、一个形状:有东西读消息,一个带分数的决策被执行,而置信度——不是运气——决定这件事由软件还是由人接手。这个形状是可移植的:JevGate 节点把它打包好,HTTP 路线把它组装出来;两条路线终点相同,也是诚实自动化该有的终点:人,但只在真正需要时。
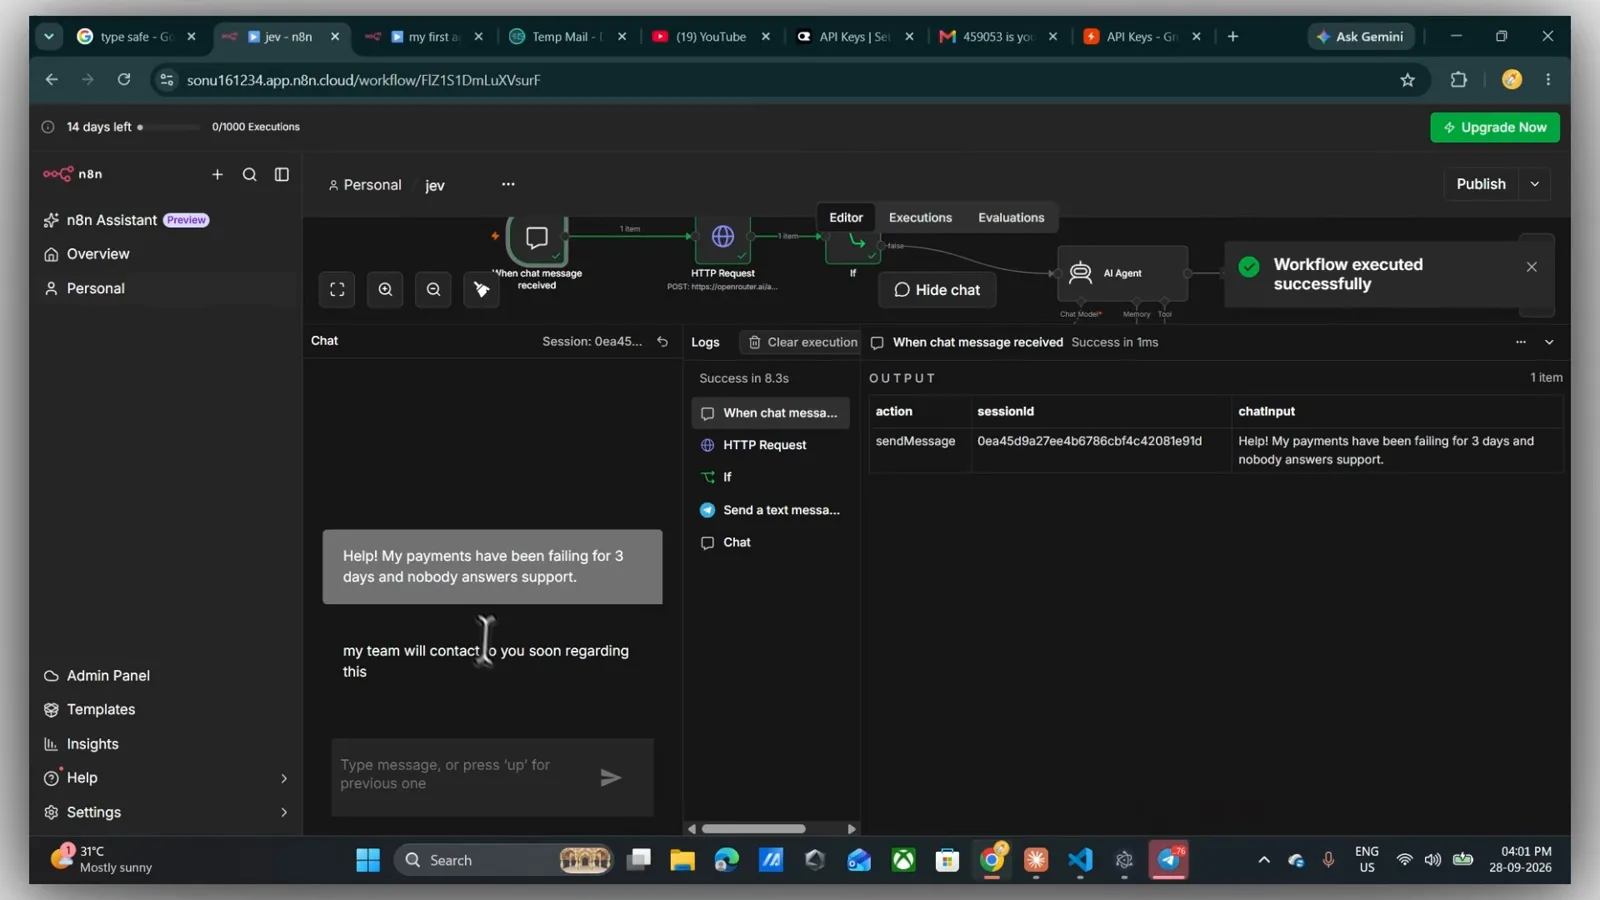
flownix 视频里的端到端:决策完成、Agent 回复、拿不准的那条叫人。跳转至 8:14
常见问题(FAQ)
JevGate 是什么?怎么装进 n8n?
JevGate 是 Perseo 出品的 MIT 开源 n8n 社区节点,封装 TypeSafe 的 Jev 决策模型。收尾卡公布的包名是 n8n-nodes-jev-gate;社区节点从 n8n 的 Settings → Community Nodes 用这个包名安装。它带来三种操作——Decide(按置信度阈值给每条数据分流)、Route(每个选项一条出口,review 殿后)、Calibrate(在有标注样本上扫阈值)——外加一个「Jev Gate account」凭证。视频本身从安装之后开始,展示的是配置环节:选模型要读的字段、写带可接受选项的问题、设一个阈值。
为什么 Jev 的输出不计费?
因为 Jev 不生成文本。读你的字段、给可接受选项打分在一次前向推理里完成,没有「生成的输出 token」可计费——视频定价卡上输出免费,输入 $0.042/百万 token。卡上的实测行让这件事很具体:12 条消息一次请求分类完花费 $0.000085,不到一美分的百分之一。定价以卡面(和 TypeSafe 官方定价)为准——旁白只是把输入价粗略说成了「四美分」。
置信度阈值该怎么定?
标定它,而不是猜它。Calibrate 操作吃有标注样本——demo 里 12 条——返回你列出的每个阈值(0.5 到 0.99)的准确率与覆盖率。那一跑里,不加闸的基线是 0.9166(12 条对 11 条),0.5 的阈值放进 1 条错误答案,0.7 则让每条 confident 答案都保持正确,于是节点推荐 0.7。诚实的警示:那 12 条消息标定的是那个 demo 工作流,不是你的类目体系——写死数字之前,先把自己的真实流量过一遍 Calibrate,类目变更后也要重跑。
n8n 里 review 分支到底怎么走?
低于阈值的条目——或者答案不在你的选项里的条目——从 review 输出流出,并附带原因:low_confidence(置信度不足)、none_of_these(跑题输入)、no_answer(无效答案)。demo 里 6 条支持消息分成 4 条 confident、2 条 review,被留下的两条是一条香蕉面包食谱和一句光杆「hi」。因为节点给每个问题自动附加「none of these」选项,跑题文本永远不会被硬塞进你的业务类目。Route 补全全图:每个选项都有自己的输出,review 永远排在最后——不确定的条目永远有去处。接一个 Telegram 节点或工单分派,人只会看到真正拿不准的那几条。
装不了社区节点,还能在 n8n 里用 Jev 吗?
能——这就是本页的第二条路线,取自 flownix 的独立实操。原生 HTTP Request 节点 POST 到 openrouter.ai/api/alpha/decisions,header 认证带 OpenRouter 密钥;IF 节点把返回分数和数字比大小;低于阈值的进 Telegram「Send a text message」节点,其余由 AI Agent 回复。你换来零安装和完全控制,同时也得手工重搭 JevGate 开箱即用的东西:没有自动「none of these」、没有 Calibrate 扫描、没有逐选项 Route 出口。另注:来源视频旁白为印地语、字幕系机翻——这些细节以画面为准。
什么样的工作流适合用 Jev?什么不适合?
适合放在工作流的确定性一端:给工单路由、给线索打标、核对抽取结果、过滤信息流——任何「一个概率应该变成带逃生通道的 if/else」的地方。不适合:写回复本身(Jev 不生成文本)、开放式生成、以及低置信条目没有去处的流程——没有 review 路径的闸门只会悄悄丢掉拿不准的案例。本页两条路线的终点刻意一致:confident 的部分没有人也照常运转,人只看真正不确定的那几条。
相关推荐
LangChain + Jev 集成实战
代码优先的姊妹篇:langchain-typesafe、ModelRouter 与护栏,全部以 TypeScript 落地。本页在画布上拖节点,那页把同样的决策写成代码。
阅读Heym 的 Jev:决策节点与模型路由
同一个「决策节点」思路在 Heym 平台里的样子。一个模型、三种接法:Heym 内置节点、LangChain 代码,以及本页的 n8n 无代码工作流。
阅读Jev 工单分类实战:Hook 与计算字段两种接法
完全不用工作流画布的工单路由——帮助台产品里的 Hook 与计算字段。拿它的类目设计和本页 Route 里的选项描述对照着看。
阅读Jev API 示例
本页两条路线底下的原始请求:JevGate 节点封装的东西,和 HTTP Request 节点实际发出的东西。
阅读支持工单路由 Recipe
把分流管线写成一步一步的 recipe:在真实工单流上用 Choice、Score、Noul 提问——正是 JevGate 打包进一个节点的逻辑。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
- Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
- Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
- Jev 接入 Codex 实操:typesafe-ai/skills 安装与 Gmail 30 封邮件分诊
- Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
- 自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
- CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
- 用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门
- Ollama 决策模型实测:tev1 + nimble 跑在 8GB 显卡上
- Jev 生产环境护栏:五步接入实战手册
- Pi Agent 防跑偏插件实战:让 Jev 出概率,让代码做决定
- Tev1 用例实测:50 个任务看尽本地决策模型的能力边界
- Jev 实测:官方宣称与独立复测之间的距离
- Jev 工单分类实战:after-insert hook 与计算字段两种接法
- OpenJev RLCD 实操:开源校准决策模型本地部署全指南
- Clef-Flash vs Jev 实测:把 Cloudflare 决策模型装进 Ollama(Q4_K_M)
- Julia-1 实操教程:纯 Python 装上开源 Jev 替代品,10 条客服消息实测 9 比 2
- OpenJev 0.8B CPU 实战:用工单收件箱校准 NLI 路由阈值