
Guides / 视频转图文攻略
Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
逐板书解读 Agent Engineering 这支 11 分钟深潜视频:评审偏差与校准方法、卡内基梅隆 Jev 1.13 对战 16 个评审的研究、以及保住 GPT-6 99% 精度只花 57% 费用的置信度级联配方。
速览结论
Agent Engineering 这支 11 分钟板书视频从零讲透 LLM-as-a-judge,最后附上论文的级联配方。评审基础:pairwise(两个答案哪个更好)和单答案打分(supported/hallucinated、correct/incorrect)都受位置偏差、冗长/文风偏差和自我偏好影响——而推理型评审每出一个裁决都要写 token,可信度和价格同时成为工程问题。重头戏是卡内基梅隆团队(Li、Miao、Krishnan & Padman)让 Jev 1.13 对战 16 个评审——GPT 系直到 GPT-6 Astra、Claude Sonnet 5、Gemini、Qwen 和两个奖励模型——覆盖 RewardBench(普通偏好,400 题)、JudgeBench(高难度正确性,350)、HaloEval(证据溯源事实性,240)和 RM-Bench(文风改写对,140);阈值在 40% 选择集上拟合、冻结后在 60% 留出集测试。守住阵地:RewardBench 92.2 对 GPT-6 的 93.5,HaloEval 87.5 对 86.7,最终答案裁定差距 3.2 分以内——价格是每千次 $0.044 对 $12.18(0.36%),中位延迟 0.15 秒对 1.89 秒。失守阵地:JudgeBench 高难正确性 78.6 对 93.1(推理 68 对 96、代码 76 对 98),错答案写得更花哨时文风对抗对从 84.0 掉到 74.8,四选一需要先验证。翻盘属性是校准:正确裁决堆在概率 1.0,错误摊在 0.5–0.9;低于 0.6 时 Jev 正确率只有 47.7%(抛硬币),满置信度时 322 题对 99.1%(AUROC 0.83)。这份诚实撑起了级联:Jev 双序评审每条 trace(对齐概率取平均同时消除位置效应),冻结的 0.9 阈值直接接受 53.7% 的对,其余全部升级给 GPT-6——92.5 对 93.1,保住强评审 99% 以上的精度、只花 57% 的费用(视频自算混合成本 $5.73 对 $12.18/千次)。论文的规则:在选择集上拟合阈值、碰测试数据前冻结、把置信度当升级信号而非证书——这也是视频的收尾金句:先在自己的流量上测好校准再信任这道闸。
分步图文攻略
- 1
认清两种评审格式——和三种偏差
LLM-as-a-judge 就是给一个有能力的模型一份评分规则(rubric),让它给另一个模型的输出打分。Pairwise 偏好:同一个问题展示两个答案,问哪个更好;单答案打分:给一个答案(常带证据或参考答案)和标签,如 supported/hallucinated、correct/incorrect。两种格式都继承失败模式:位置偏差(偏先出现的答案)、冗长/文风偏差(奖励更长更精致的答案)、对自家模型家族的自我偏好。规模化的还有成本:推理型评审每条裁决都要写 token。
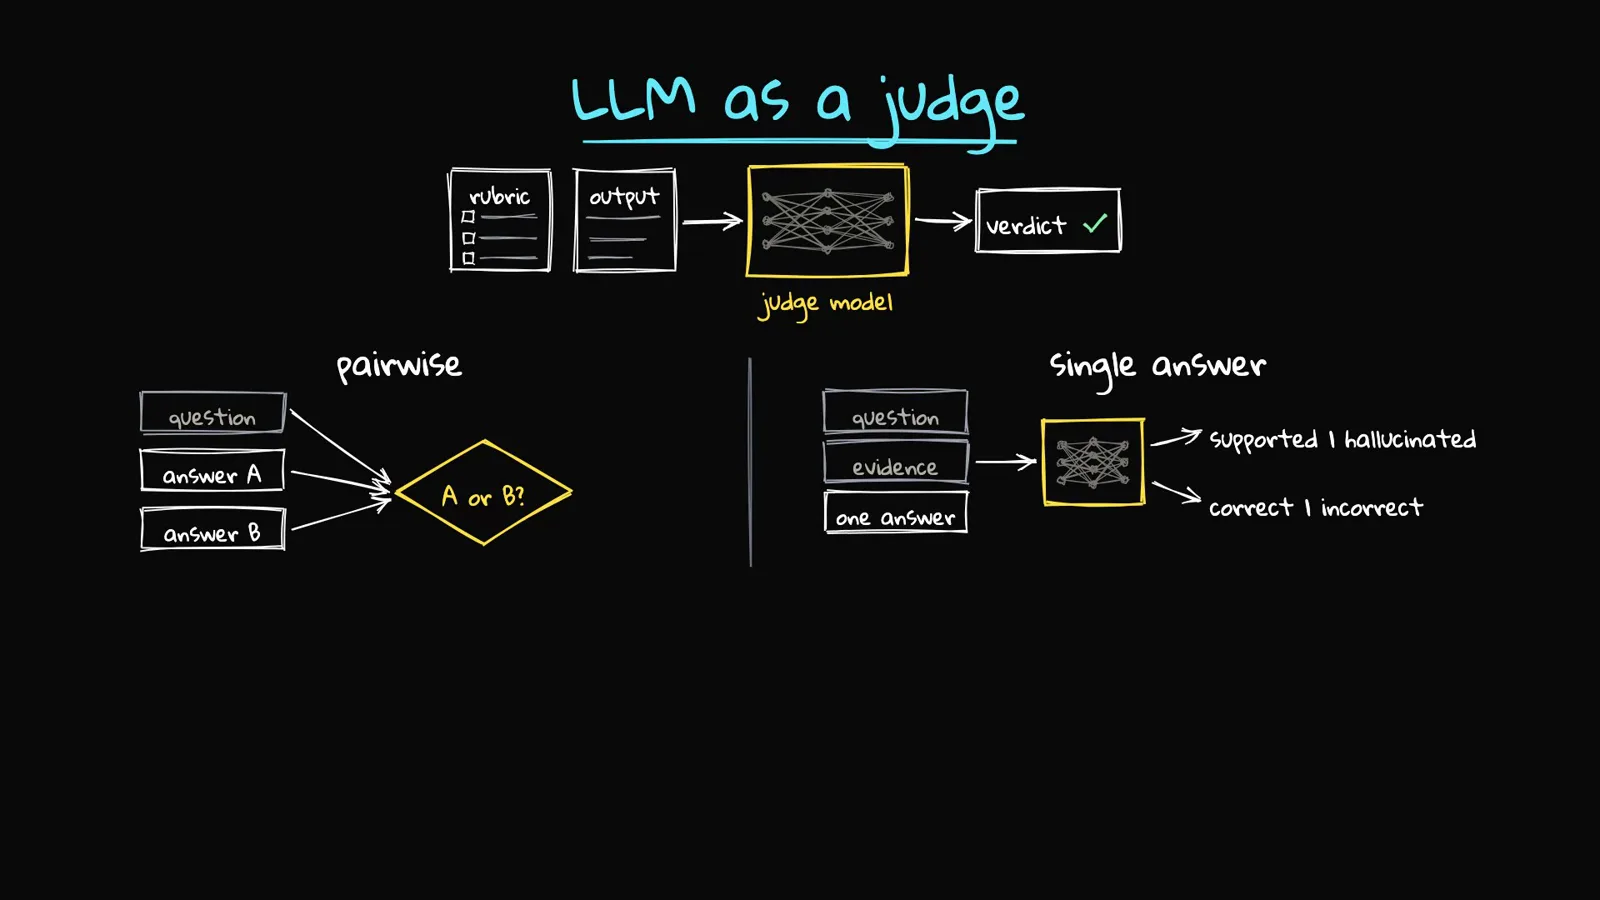
两种格式、三种偏差——外加评审写下的每一个 token 的账单。跳转至 1:02 - 2
研究设置:Jev 1.13 对战 16 个评审,阈值冻结
卡内基梅隆团队(Li、Miao、Krishnan & Padman)让 Jev 1.13 当评审,对线 16 个比较者——GPT 系直到 GPT-6 Astra、Qwen、Claude Sonnet 5、以及 PairRM 和 SigLiom 两个奖励模型。工作负载:RewardBench 普通偏好(400 题)、JudgeBench 高难正确性(350)、HaloEval 证据溯源事实性(240)、RM-Bench 文风改写对(140 难集)。方法论值得照抄:Jev 与 GPT-6 不一致的地方由一名队员盲裁 183 条;阈值在 40% 选择集上拟合、冻结后在 60% 留出集上打分——你自己也该这么做。
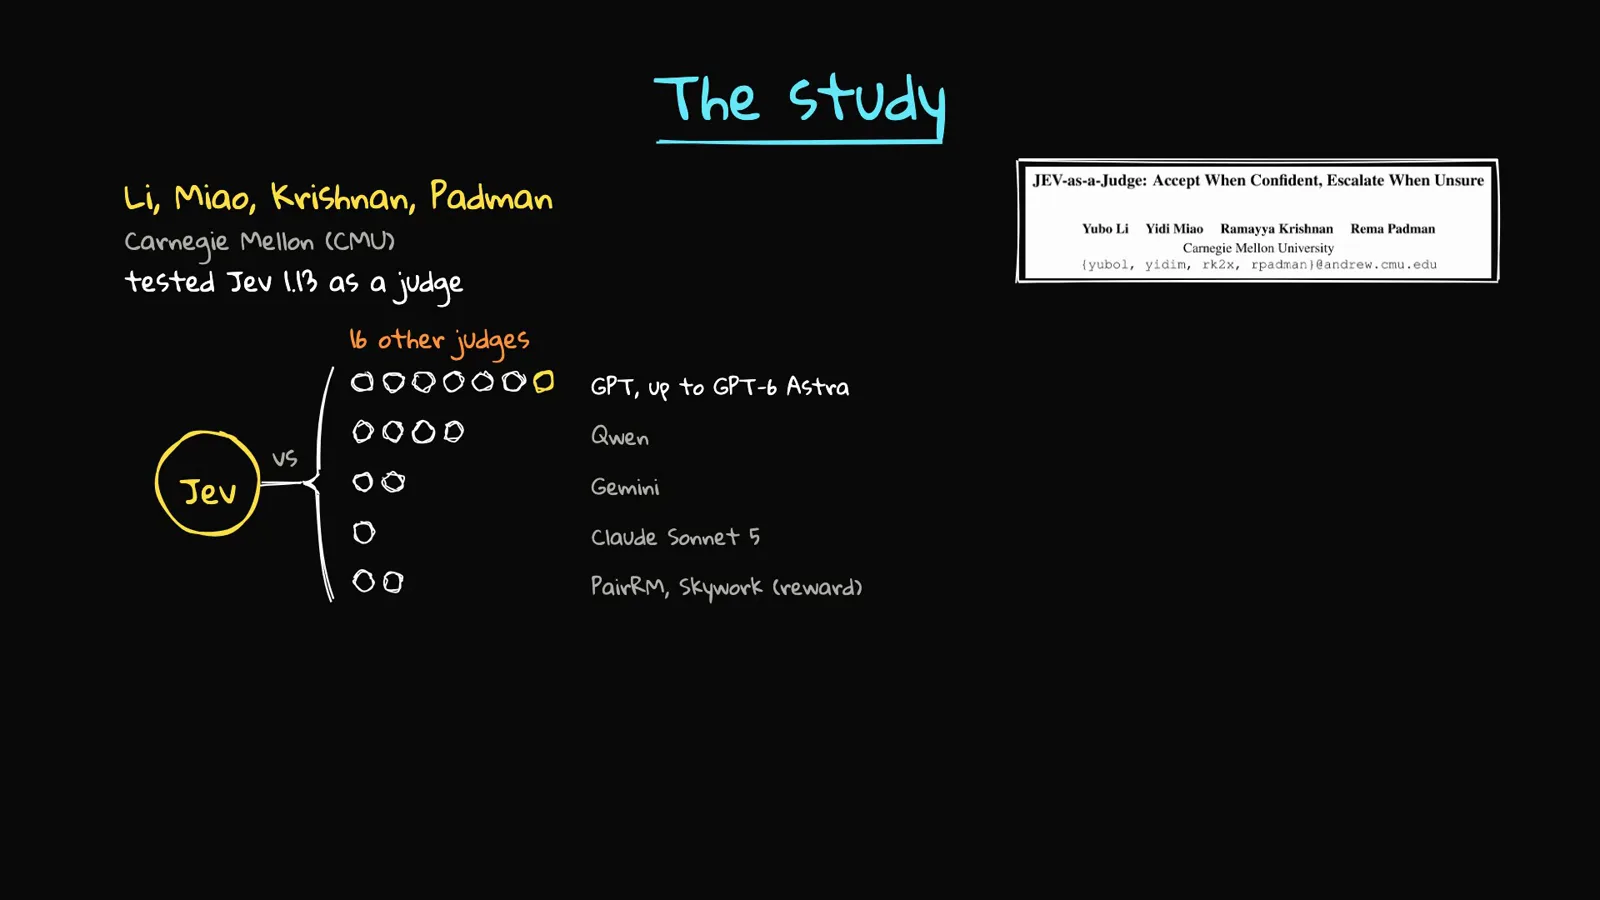
16 个评审、4 个工作负载,外加一套你可以直接抄的冻结阈值协议。跳转至 2:43 - 3
守住阵地:差距 3 分以内,价格 0.36%
表二就是作战包线。普通偏好(RewardBench):Jev 92.2 对 GPT-6 的 93.5——用 Jev。证据溯源事实性(HaloEval):87.5 对 86.7——还是用 Jev。最终答案裁定差距 3.2 分以内。标着 escalate 的行是 Jev 认输的地方:同文风对 84.0 对 97.3、文风对抗 74.8 对 94.6、四选一 75.8 对 94.0、有据摘要 71.2 对 72.5。价格:每千次裁决约 $0.044,GPT-6 是 $12.18——0.36%。盲评人稍偏向 GPT-6,但 Jev 咬住 3 分以内。
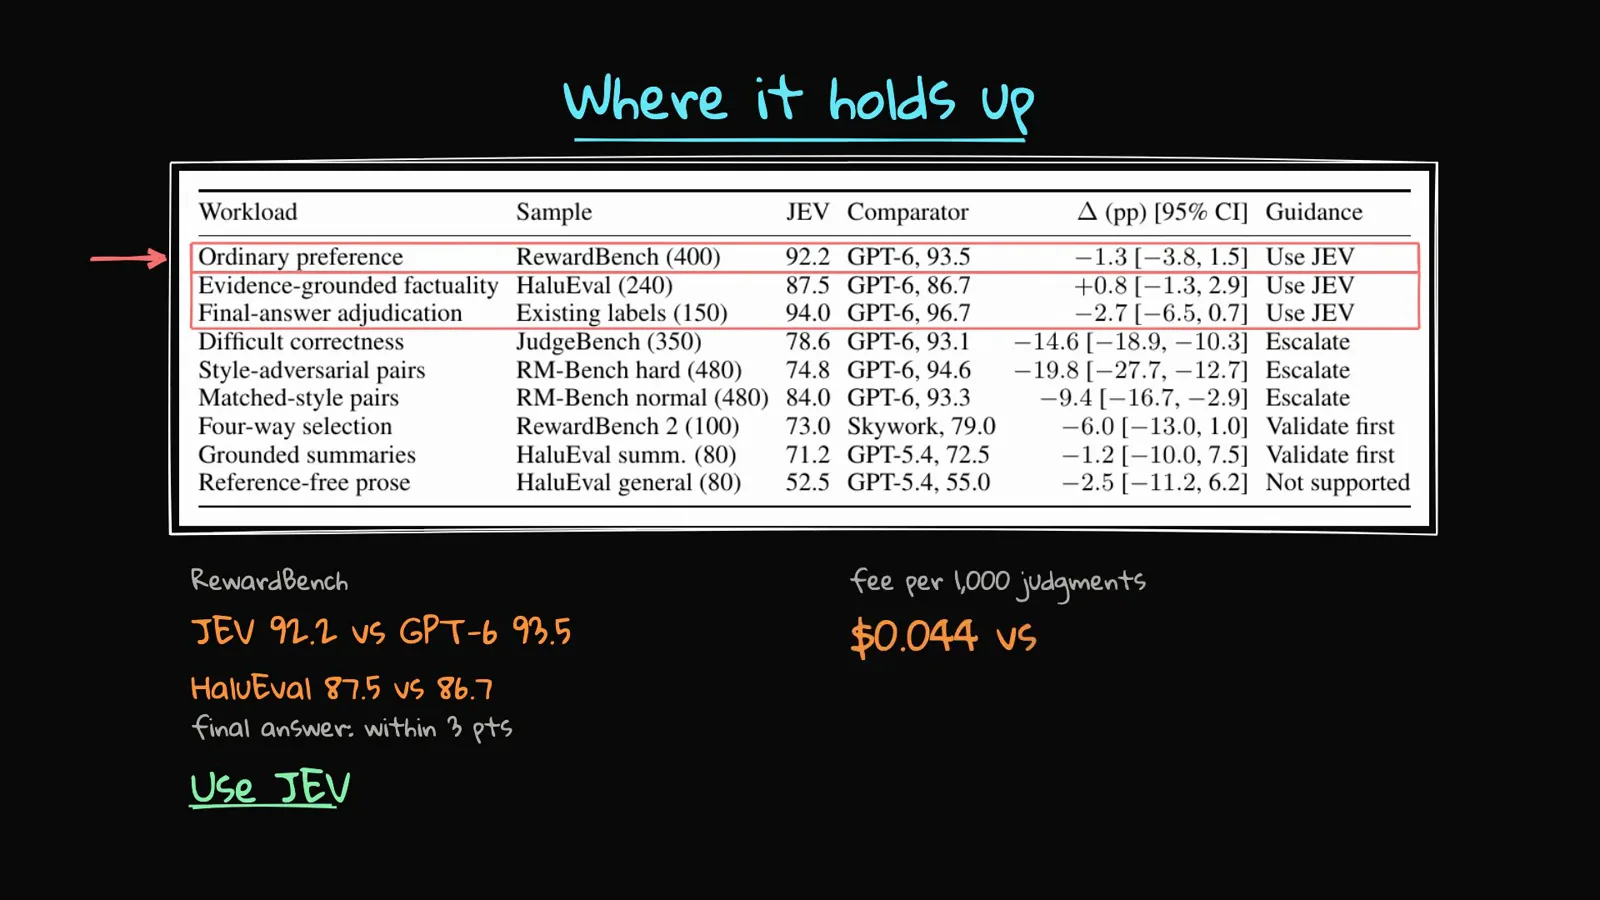
普通偏好和证据溯源是 Jev 的主场;一切要验证推导的都升级。跳转至 4:02 - 4
失守阵地:推导、代码和有说服力的错答案
JudgeBench 要求评审真正验证正确性,差距就在这里拉开:总体 78.6 对 93.1,分领域看推理 68 对 96.1、代码 76 对 98、知识 84.4 对 93.8。论文判词:凡是要核对推导的地方就是最弱项。盲评记录证明这不是标签噪声——争议项上人类把 57 票投给 GPT-6,只给 Jev 1 票。第二个弱点是文风:错答案写得更精致时,Jev 从 84.0 掉到 74.8,GPT-6 几乎不动(97.3 → 94.6)——选出更好的答案和抵抗有说服力的错答案是两种能力。
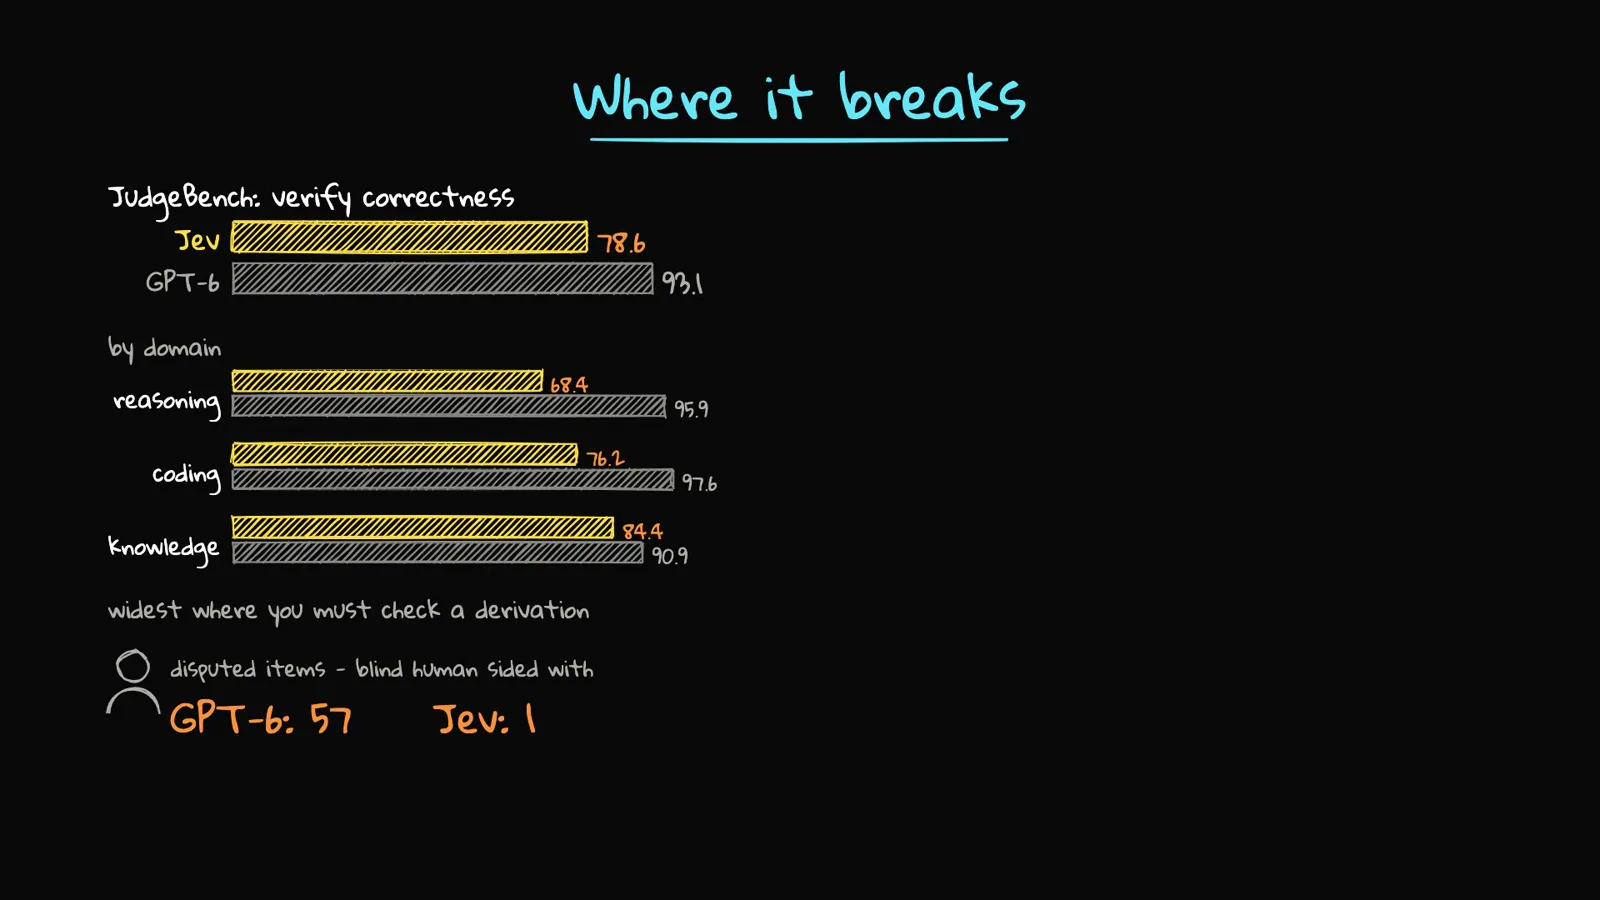
验证是墙:推导和代码直接送强评审,别让便宜评审硬上。跳转至 4:40 - 5
置信度给错误排序
图三是便宜评审的救命属性。横跨 RewardBench、JudgeBench 和 HaloEval:蓝绿色柱(正确裁决)堆在最大概率 1.0,红色柱(错误)摊在 0.5–0.9。HaloEval 上置信度 ≥0.9 时,Jev 199 裁决错 10 次,GPT-6 是 233 错 28。这张直方图是后面一切的视觉论证:Jev 的错误集中在它不确定的地方——恰好是闸门能拦住的地方。
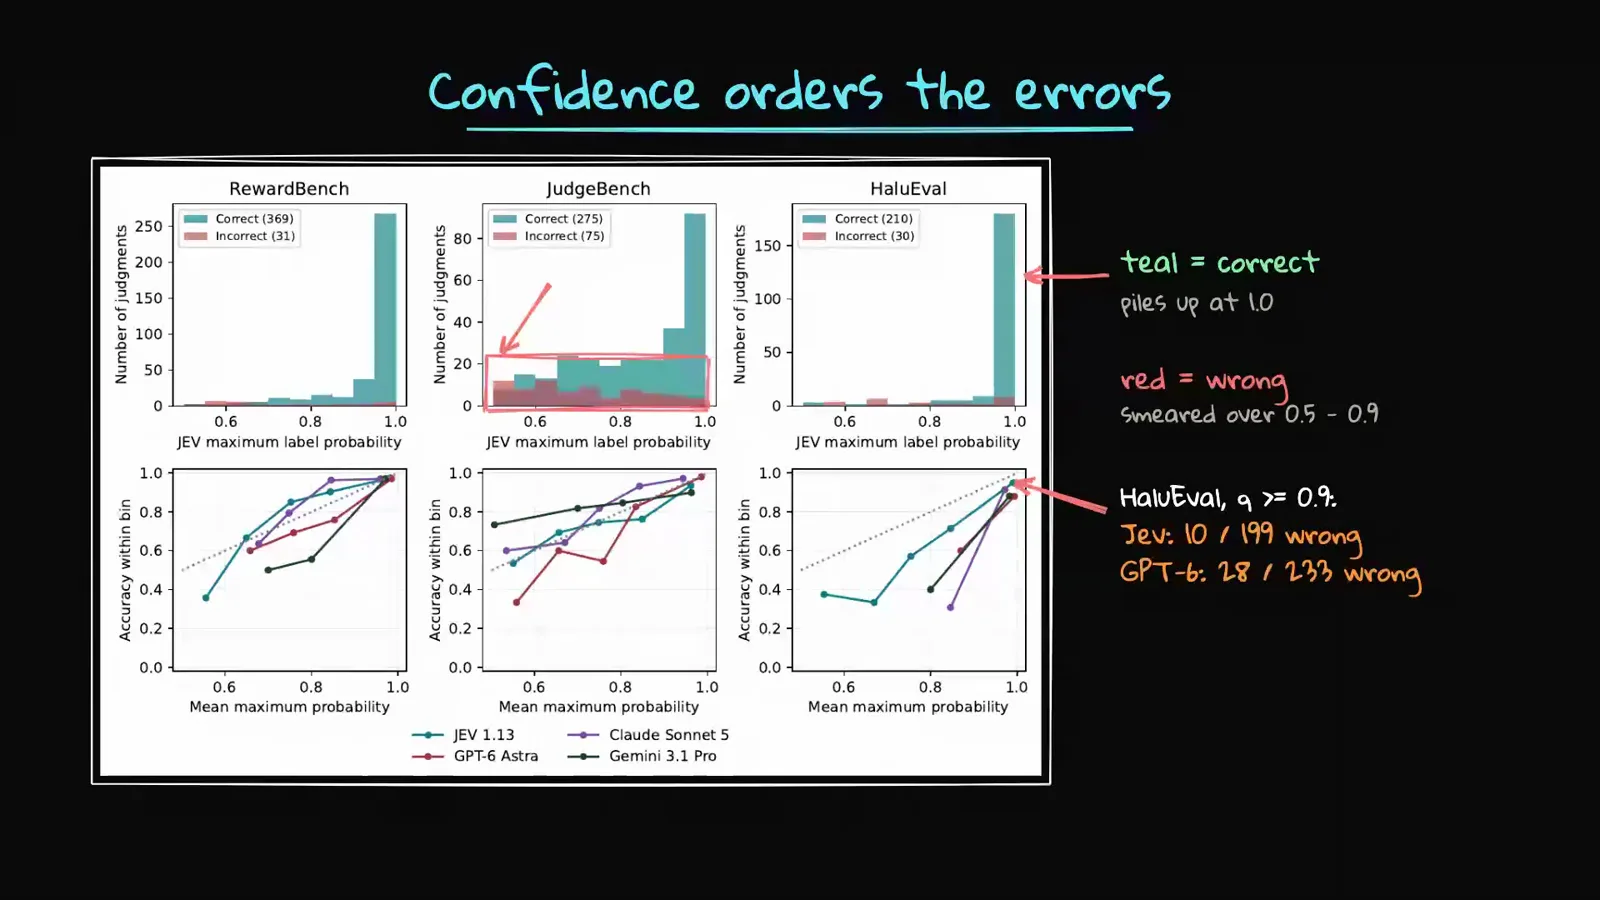
错答案躲在低置信度里——这正是升级策略的原料。跳转至 6:02 - 6
校准量化:低于 0.6 对 47.7%,满置信度对 99.1%
把 990 条裁决按 Jev 置信度分箱,诚实程度有了数字:低于 0.6 时 Jev 正确率仅 47.7%——基本是抛硬币。满置信度时 322 题对 99.1%,同一批题 GPT-6 只从 78.5 涨到 99.1——它的优势恰好活在 Jev 不确定的地方(AUROC 0.83)。在 Jev 敢以 0.9 接受的题目上两家几乎等价(95.8 对 96.5);升级段 GPT-6 领先 15 分——强评审就在那里赚回票价。
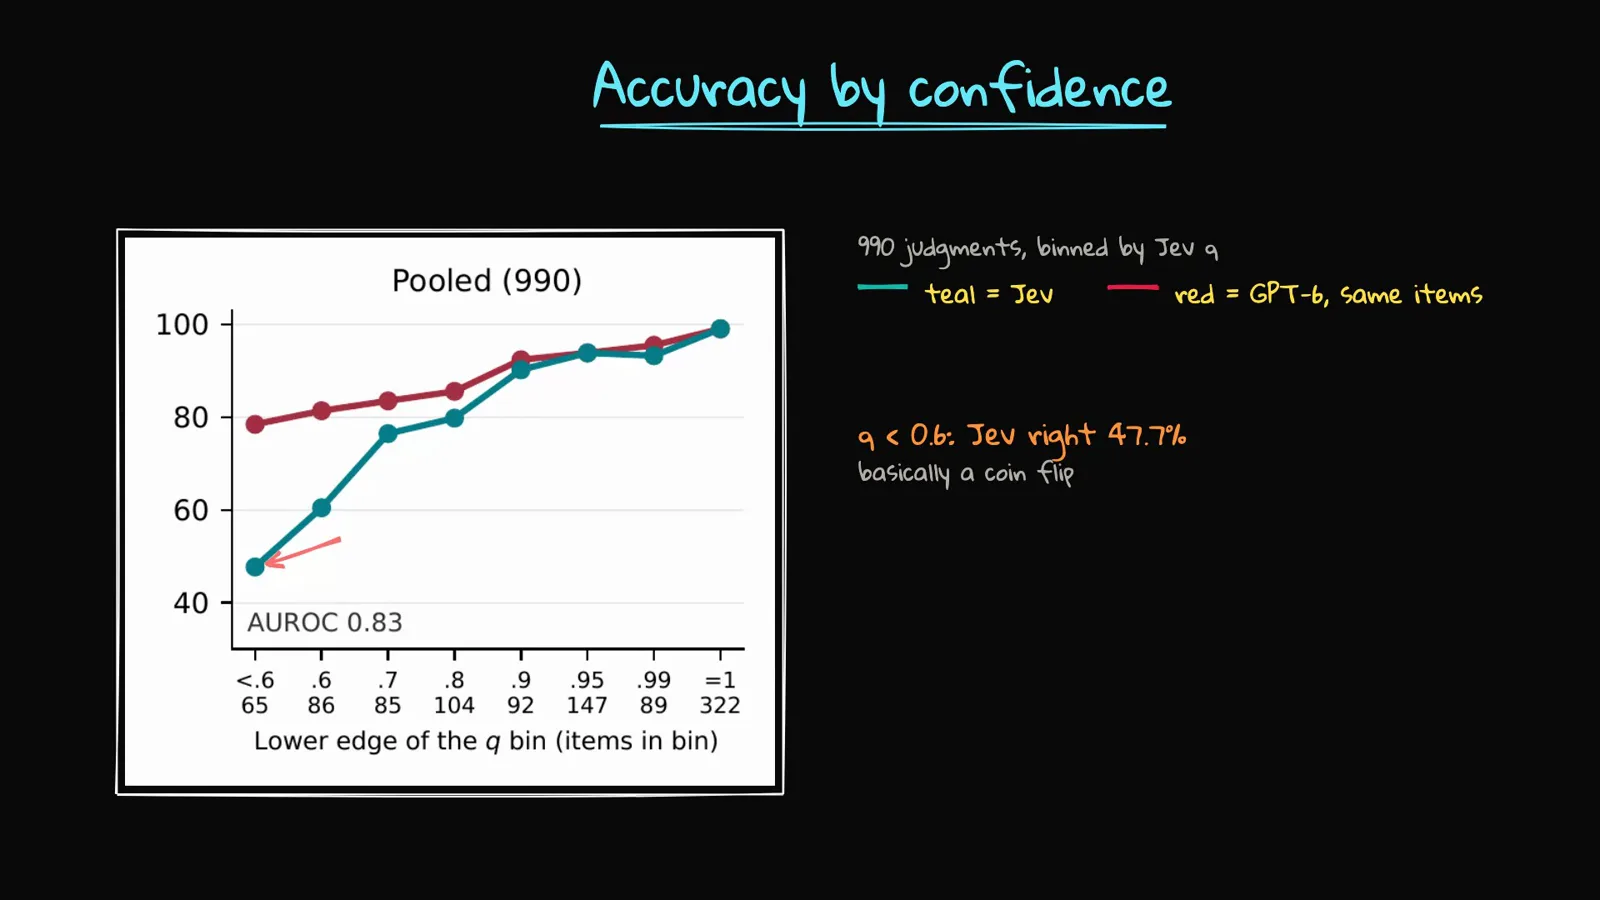
便宜评审不必全对——只要在不确定时够诚实。跳转至 6:25 - 7
级联:Jev 把关,GPT-6 仲裁
图四把系统拼起来。每条生产 trace 先给 Jev——pairwise 任务跑双序,因为对齐概率取平均 p(A) = ½[p(A|A,B) + 1 − p(B|B,A)] 顺带消除位置效应。置信度 q 与冻结阈值 tau 比较:过线就接受裁决、几乎不再花钱;不过线就升级给强评审,它的裁决是终审。GPT-6 兜底、tau 0.9 时,级联直接接受了 510 个留出对的 53.7%,得分 92.5 对 93.1——保住 GPT-6 99% 以上的精度、只花 57% 的费用。RewardBench 上级联甚至反超 GPT-6 单干,因为两个评审犯的错不同。
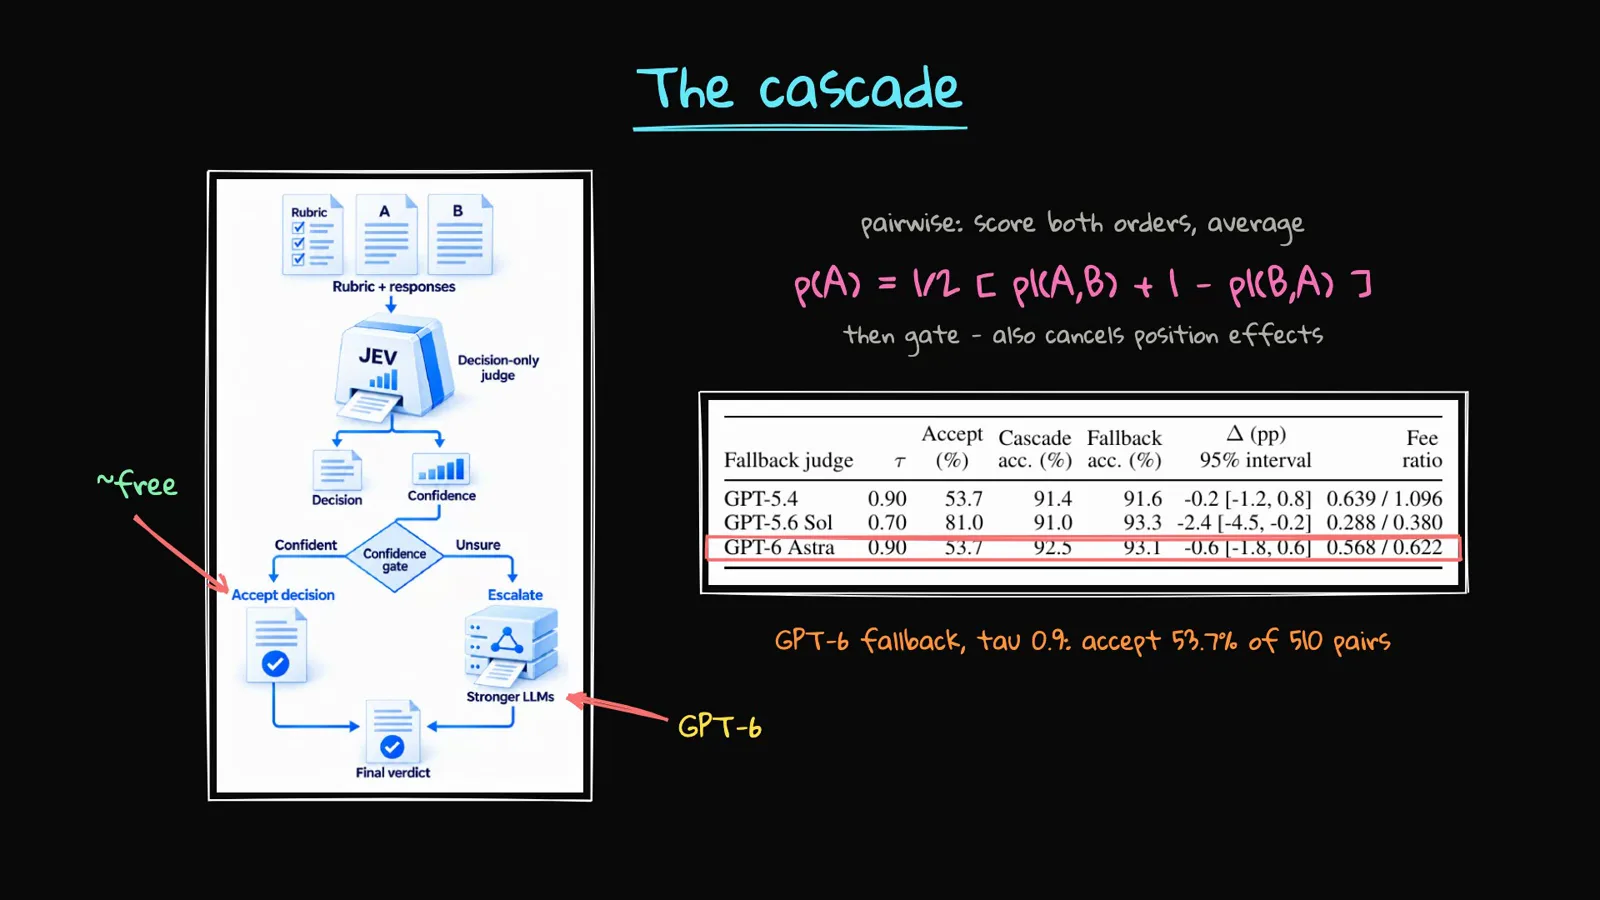
便宜评审初审、强评审终审——双序打分顺带完成去偏。跳转至 8:02 - 8
为什么阈值必须冻结
tau 在选择对上拟合、上锁、只在留出集上测一次。规则:在选择集精度与兜底评审差距 2 分以内的前提下尽可能多接受。冻结是 53.7% 接受率诚实的来源——而且它不保证迁移:换成 GPT-5.6 兜底时,选好的 0.7 阈值接受了 81%,留出集却掉了 2 分多。阈值是你工作负载的属性、不是评审的属性;换任务、换 rubric、换模型版本都要重新校准。
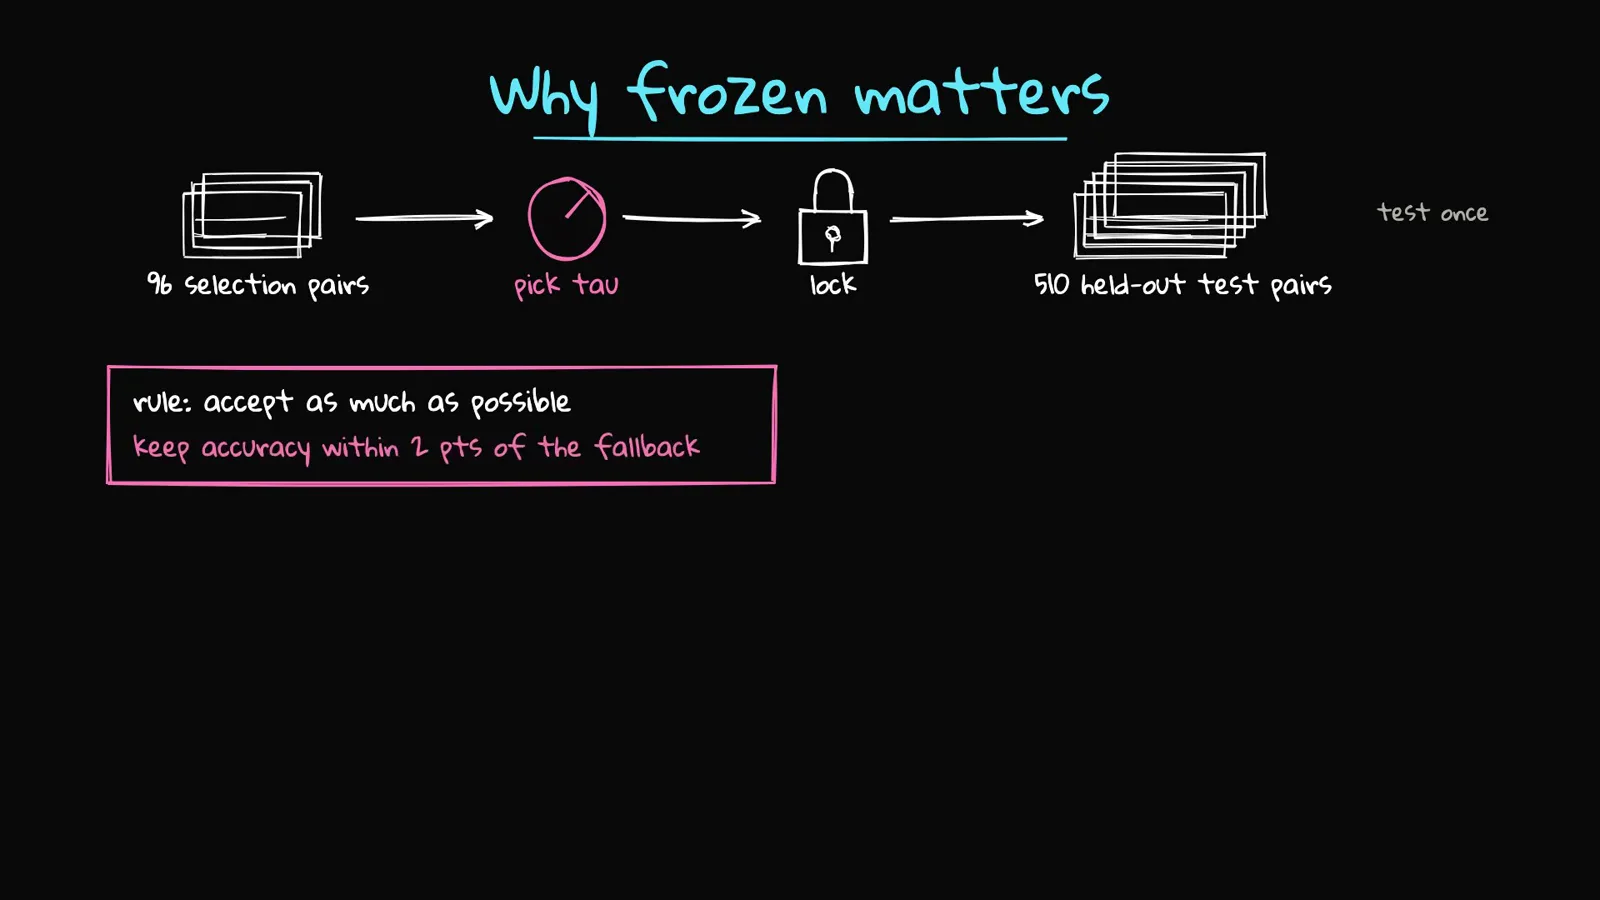
在选择集上定 tau、锁死,让留出集宣判。跳转至 8:22 - 9
能在自己评测上跑的配方
视频把论文清单浓缩成五步:一、从自己的流量标注几百条,分成选择集和留出集;二、便宜评审双序打分,按置信度分桶,做出自己的可靠性表;三、对着目标定 tau——与强评审精度差 2 分以内,或固定升级预算;四、冻结,在留出集复检,任何无效裁决自动升级;五(频道补充):推导、代码、长篇有说服力的答案直通强评审,无参考的事实核查交给证据或人类。
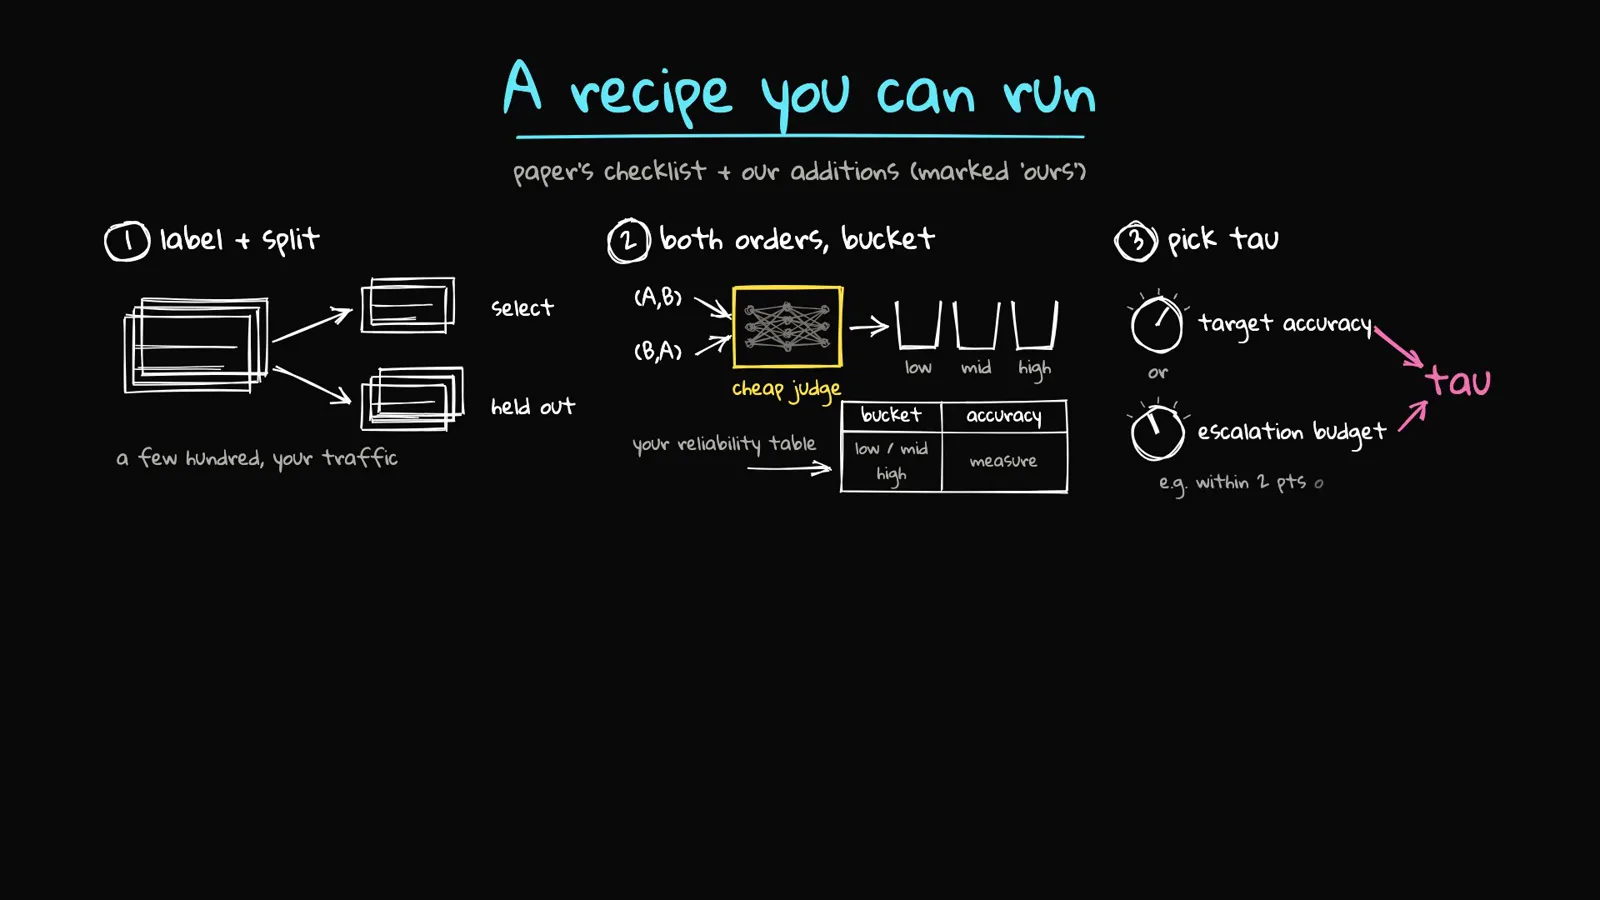
论文清单加两条实战补充:给升级设预算、已知困难类别预路由。跳转至 9:13 - 10
算账:每 1,000 次裁决的成本
混合成本 = 双序打分 × 便宜评审 + 升级率 × 强评审。按论文价格(Jev $0.044、GPT-6 $12.18/千次)、双序加冻结策略 46% 的升级率:2 × 0.044 + 0.463 × 12.18 = $5.73——论文自己实测约为 GPT-6 费用的 57–58%(接近 $6.90),因为单条真实成本有波动:升级段要用真实数字计价。每月 100 万次裁决,GPT-6 单干约 $12,180,级联只要一半左右。更低的阈值用 1 分精度换更多节省——旋钮在你手里,前提是你诚实地冻结过它。
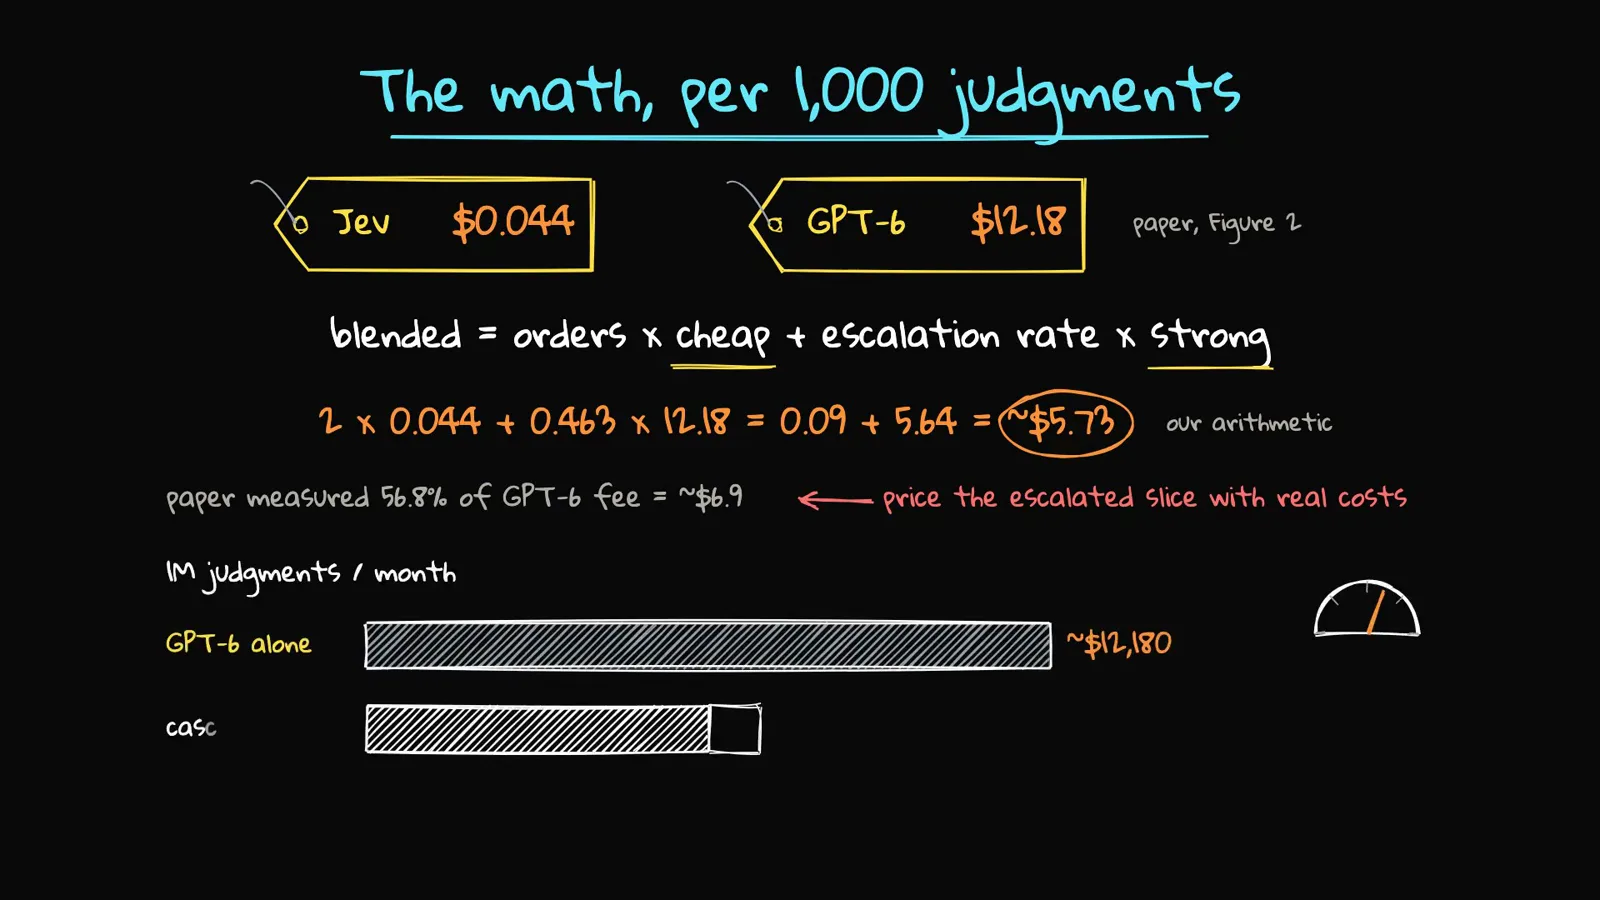
钱都花在升级段——用你自己的真实数字计价,别抄论文的。跳转至 10:05
常见问题(FAQ)
Jev 真能取代 GPT-6 当 LLM 评审吗?
不是所有场景——论文自己划了界。普通偏好(RewardBench 92.2 对 93.5)和证据溯源事实性(HaloEval 87.5 对 86.7)上它以 0.36% 的成本咬住 1 分以内;高难正确性(JudgeBench 78.6 对 93.1)、文风对抗对、无参考散文则明显落败——这些行就该进升级堆。
什么是置信度门控评审级联?
一种路由模式:便宜评审(Jev)给每条数据打分,置信度决定后续——高于冻结阈值就以近乎零成本接受裁决;低于则升级给强 LLM 评审终审。研究里级联保住了 GPT-6 99% 以上的精度、只花 57% 的费用。
Pairwise 评审的位置偏差怎么修?
双序都跑,对齐概率取平均——p(A) = ½[p(A|A,B) + 1 − p(B|B,A)]。Jev 约 48% 的概率选先手位,所以它 3%(RewardBench)和 11%(JudgeBench)的翻转率是难题上的不稳定、而非位置倾向,取平均基本消除。便宜评审每千次才 $0.044,打两遍等于免费。
Jev 评审的置信度阈值该设多少?
由你自己的校准表决定。论文在选择集上拟合阈值(与兜底评审精度差 2 分以内)、碰测试数据前冻结;研究里 GPT-6 兜底、tau 0.9 接受了 53.7% 的留出对。没有万能数字——换兜底模型后同一个 0.7 阈值掉了 2 分多——所以先给自己的几百条标注数据按置信度分桶,在你的流量上定 tau。
Jev 当评审到底便宜多少?
每千次裁决:$0.044 对 GPT-6 的 $12.18——0.36%,论文面板的中位延迟 0.15 秒对 1.89 秒。双序加 46% 升级率的级联混合成本在视频自算里约 $5.73/千次(论文实测约 GPT-6 费用的 57–58%),因为每条升级项要付两个评审的钱。
这项研究有哪些诚实的局限?
单一专有 Jev 版本、公开基准、训练重叠未知;基准题对不等于你的生产 trace;级联结果是离线模拟、没有实测线上延迟;人类校验只有一名标注员加一轮 LLM;校准不跨任务迁移——最优阈值随工作负载变化。先在自己的流量上测,再信任这道闸。
相关推荐
Jev 回归测试指南
评测纪律的另一半:给自己的 Jev schema 做精确决策断言和 CI 门禁。
阅读LLM 降级策略:置信度门控降级链
同一套「闸门-升级」模式用于生产流量——阈值、滞回与影子模式。
阅读Jev 基准测试
我们自己的可复现基准——真实工作负载上的校准与延迟数据。
阅读什么时候该用 Jev
判断 System One 评审到底适不适合进你技术栈的评估清单。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化