
Guides / 视频转图文攻略
Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
逐帧拆解 Alex Hitt 的 9 分钟 Laya 教程:state + questions 载荷怎么写、192 token 选项预算怎么守、概率校准到 ECE 0.081、0.85 置信度门槛怎么设、多语言路由与 preload=True 上卡实操。
速览结论
一段白板动画讲完 Laya 全套打法。Laya 是开源、非自回归的「System 1」决策引擎——不逐字生成文本,而是一次前向打分整个 state 文档加严格的问题方案。视频里的基准卡(单卡 Tesla T4)给出:单题 P50 延迟 38.4 ms,对 Jev 公开数字 236–276 ms;十题一批 156.0 ms;期望校准误差 0.081 对 0.246——号称 7 倍延迟优势。它教的工作规则:载荷拆成 state 文档加类型化问题(Choice 做分类路由、Score 做有序量表、Noul 判真假并返回校准到 0.0–1.0 的概率);选项提示词死守 192 token 的 head_max_len 固定预算(Banking77 的 77 个选项每项只摊到约 4 个 token,准确率封顶 0.425——改用分层路由、每题不超过 20 个选项);先跑 RLCD 校准加本地温度拟合再信那个数字;把置信度门槛写死进代码(高于 0.85 自动执行,低于就转人工);非英文载荷交给多语言 checkpoint(半个毫秒内路由完成——英文主干对高棉语准确率为零却报 0.952 的置信度);最后设 preload=True 把两份 checkpoint(共 1.5 GB 显存)常驻显存,否则冷加载一次超过 10 秒,40 毫秒的优势就全赔进去了。
分步图文攻略
- 1
先定载荷结构:一份 state 文档加一套问题方案
在敲 pip install 之前,先把输入契约刻进脑子——这是整个思维方式的转变。Laya 不收对话式聊天记录。你要发两样可分离的东西:数据 state(被分析的非结构化文档)和一套由严格决策原语构成的结构化问题方案。视频把 state 文档画成普通 JSON——{ "project": "AI Architecture", "components": [ { "type": "NeuralNet", "id": "NN01" }, { "type": "DataPipeline", "id": "DP01" } ], "status": "Active" }——正是你从工单、日志行或数据库行里能捞出来的那种对象。能挂的三种原语:Choice 处理分类决策,比如按你定义的判据把输入分到某个部门;Score 把 state 放到一条有序量表上打分(视频直言它在严格数学类任务上目前是这套架构里最弱的部件);Noul 判真假,但返回的不是文本字符串,而是严格界定了 0.0 到 1.0 之间、深度校准过的标量概率。clone 下 GitHub 仓库后,每个示例请求都是这个 state + questions 的形状。
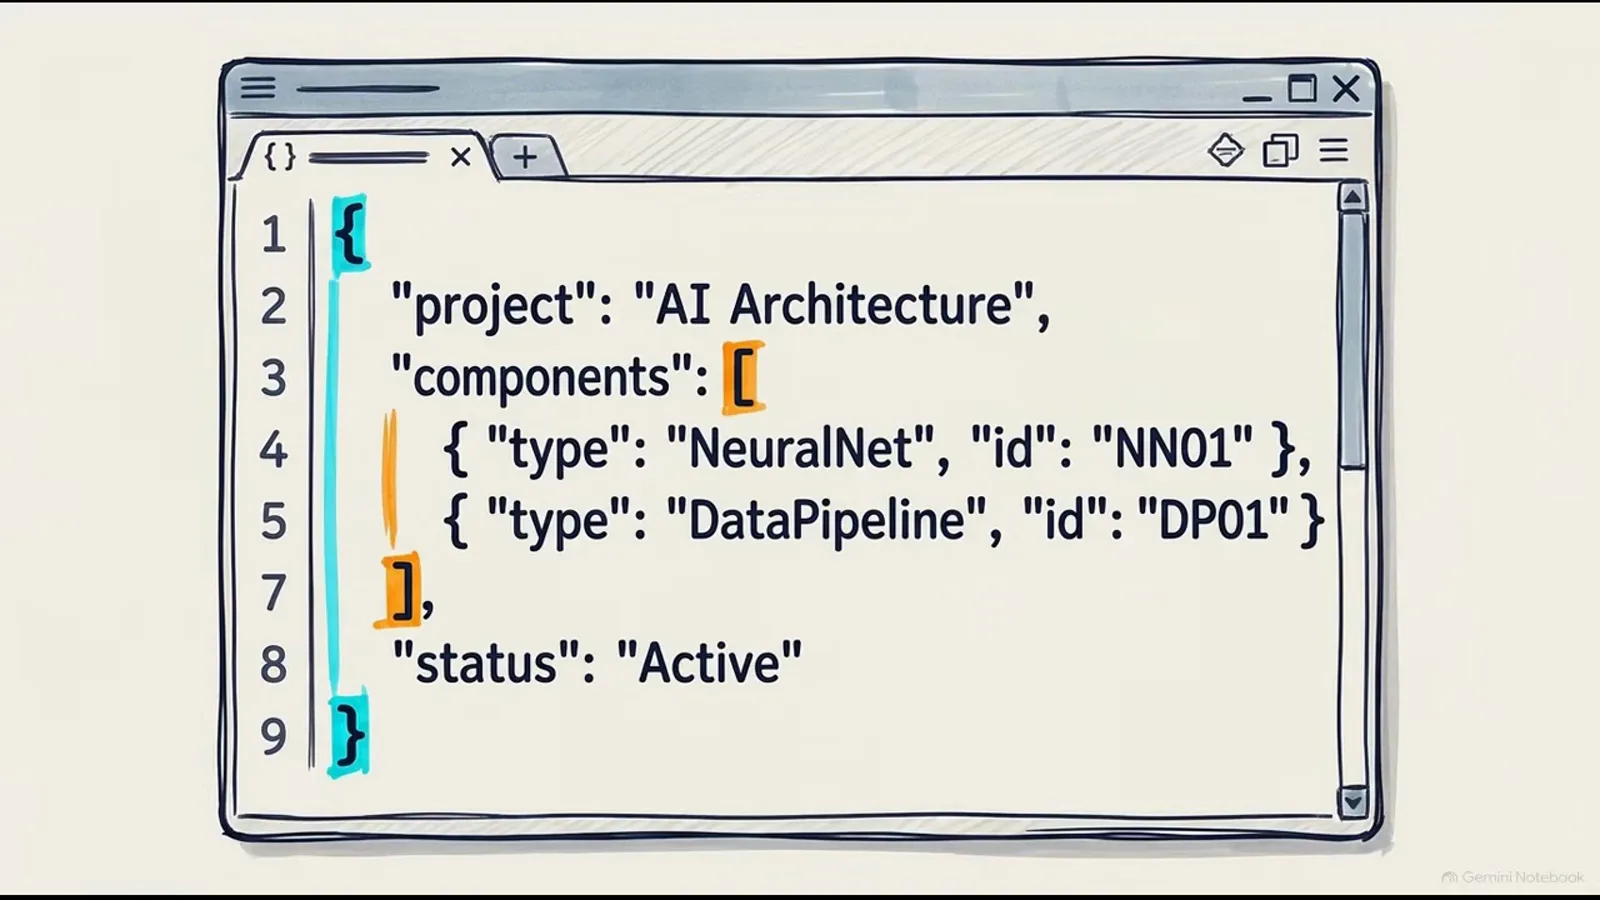
不聊天:一份 state 文档加类型化问题,就是请求的全部。跳转至 1:06 - 2
看清你买到的数字:7 倍延迟优势那张卡
视频的基准卡标题是「Laya Demonstrates a 7x Latency Advantage over Commercial Counterparts」,在单张 Tesla T4 GPU 上把 Laya 与 Jev 的公开数字对排。单题 P50 延迟:Laya 38.4 ms 对 236–276 ms。十题批量:Laya 156.0 ms——约每题 15 ms——对约 1,500 ms。期望校准误差:0.081 对 0.246,越低越好。卡片自己的小字注明数据来自 Laya README 与 Hugging Face,而不同版本 README 的数字会有出入(项目方对同一 T4 上的十题批量也报过低至每题 7.2 ms 的成绩)——把这里每个数字都当成一次测量,不是物理定律。但方向才是重点:因为 Laya 从不跑自回归的逐 token 循环,延迟不会随选项列表变长而恶化,这正是排队等路由决策的系统需要的性状。
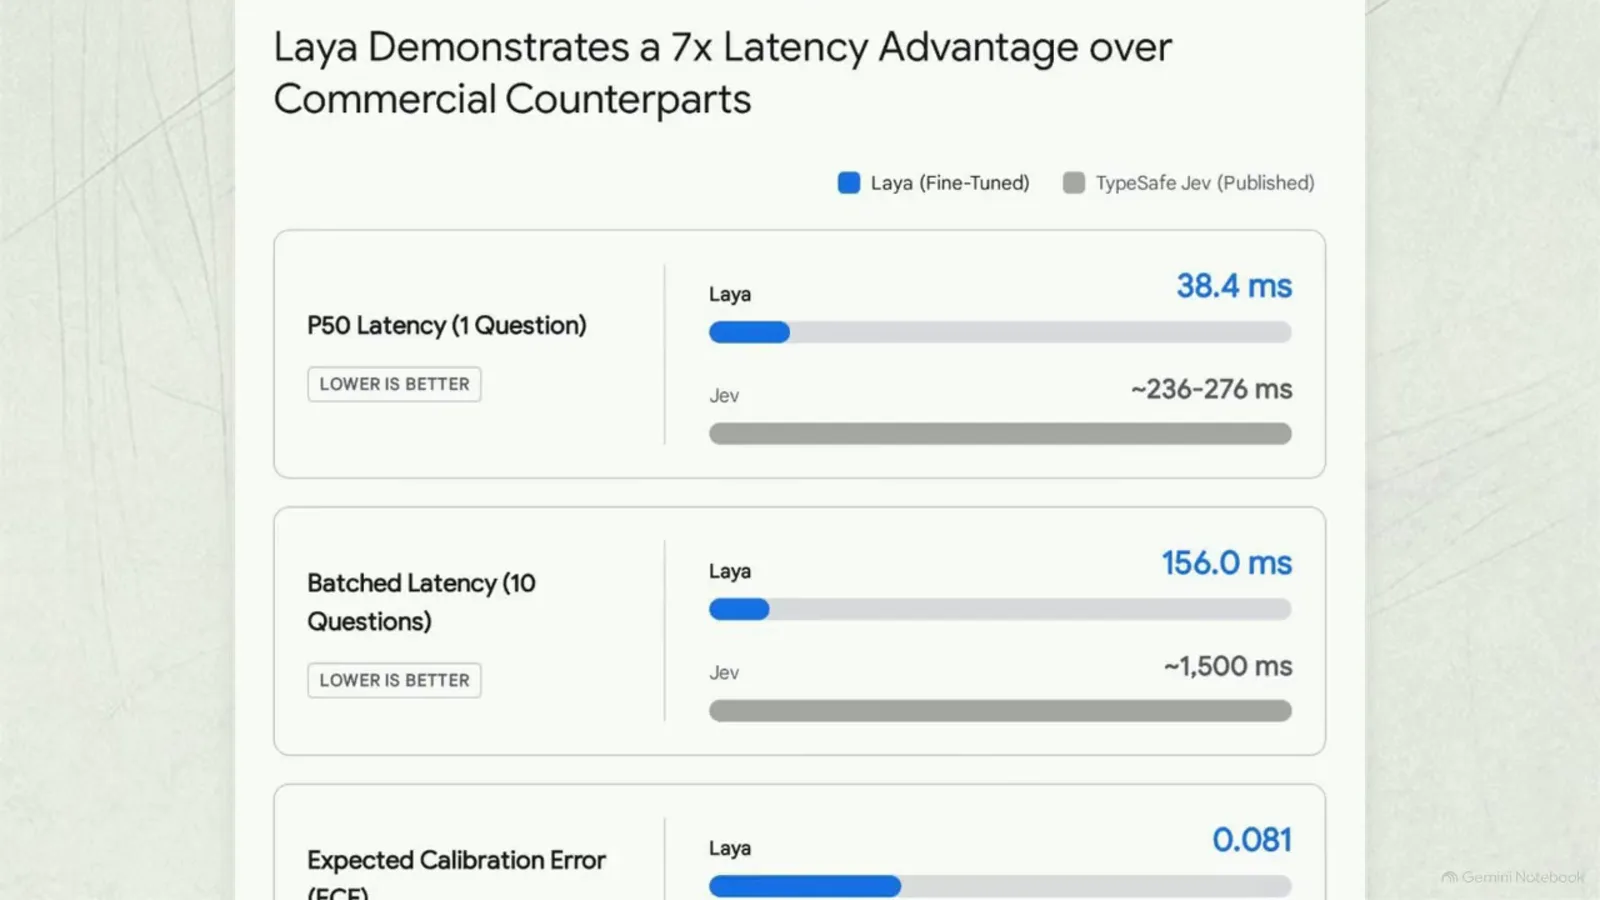
一张 T4、三行数字:单题延迟、批量延迟、校准误差。跳转至 1:12 - 3
读到的是决策,不是句子——然后直接接进代码
问题方案逼模型只评估你列出的选项,所以输出是类型化 JSON,不是散文。视频的输出面板画的就是这个形状:{ "Status": "Success", "Data": { "Result": true, "Value": 100 } },箭头把每个字段直接接进标准布尔逻辑——先 if (Status == "Success"),再 if (Result),否则 else。没有要解析的文本,也没有自由发挥 hallucinate 的空间;预测指令完全绕开逐 token 生成循环。底层机制:每个候选选项分到一个独有的 mask token,整份载荷由双向 transformer 主干在一个同步块里一次处理完,两层专用 transformer 组成的 MLP 决策头把每个 1,024 维的标记状态投影成单个标量 logit,再恰好在你列的选项上做 softmax。Choice 问题回来的是一个和为 1.0 的概率分布(视频示例:Billing 85%、Technical 15%,自回归循环被打上红叉),Noul 问题回来的是一个校准过的标量——视频的模拟预测跑出了 0.987、CONFIDENCE: HIGH。
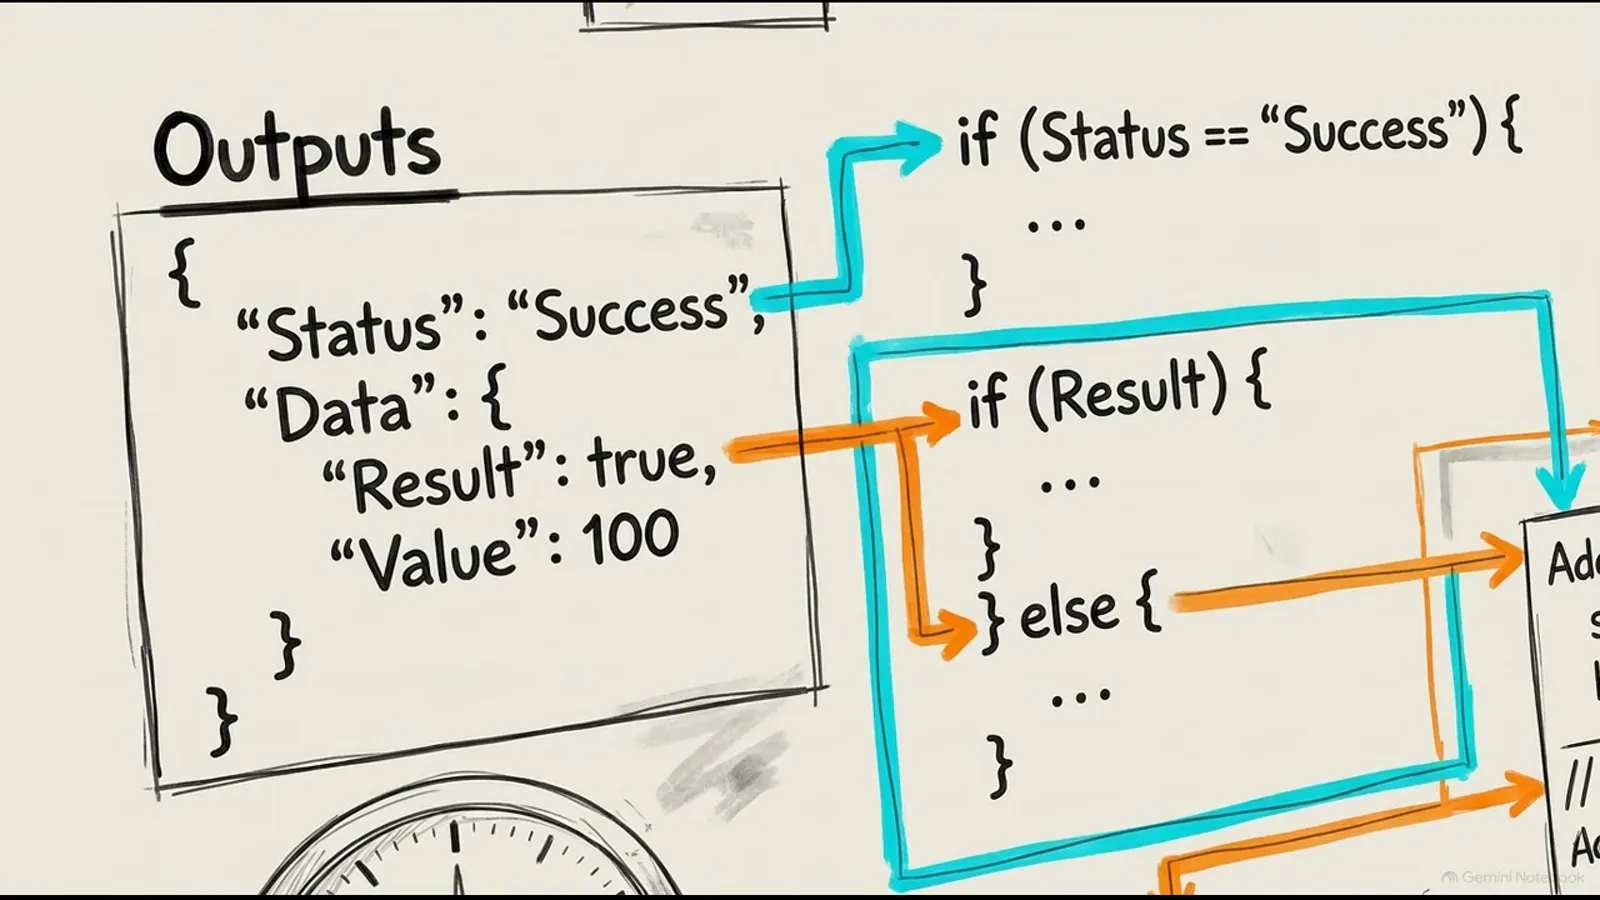
判定结果是一个 if 语句能直接消化的 JSON 对象。跳转至 2:56 - 4
守住选项预算:192 个 token,每题别超 20 个选项
这是最容易咬到新手的坑。视频把它叫「context forking」:总 token 上下文被严格切成两块——state 文档的专区(草图里是 320 个 token)和选项提示词的固定预算,也就是 head_max_len 参数,英文 checkpoint 上是 192 个 token。把庞大的分类体系硬塞进去,每个选项就会饿死:Banking77 的 77 个标签挤进固定预算后,每项只摊到约 4 个语义 token,选项失去辨识度,英文和多语言模型双双撞上 0.425 的精度天花板。视频给了两个解法。快的一个:手动改配置字典,执行前用 rope embeds 扩展 head_max_len。结构上更优的一个:分层路由——把大标签集拆成先粗后细的两步决策树,保证任何 Choice 方案都不超过 20 个选项。像工程师一样设计 schema,别把非结构化的分类体系一股脑倒给模型。
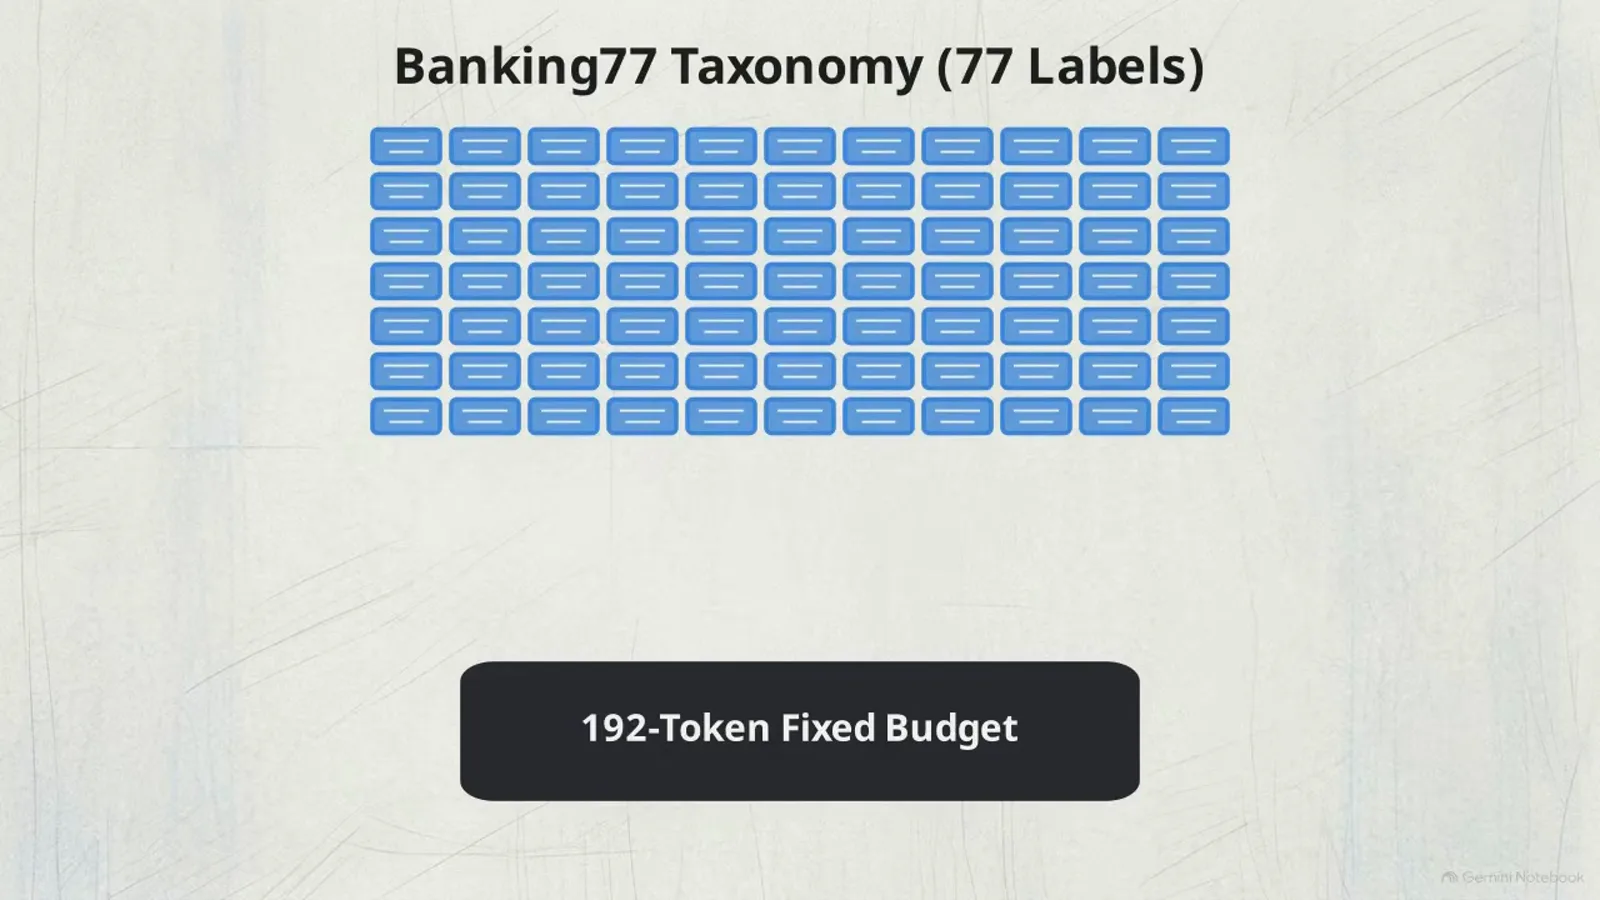
77 个选项 ÷ 192 token ≈ 每项 4 个 token——语义拥挤,精度封顶 0.425。跳转至 5:01 - 5
信数字之前先校准:RLCD 加本地温度拟合
快而不可信比慢更糟,所以视频花了整整一段讲校准。用标准二分类强化学习训出来的模型会把最大概率推向 1.0——奖励信号最大化了,校准却毁了,因为一个自信的错误答案会悄悄污染整条自动化流程。要盯的指标是期望校准误差(ECE),读数看可靠性图:横轴实际正确率、纵轴模型预测概率,「Calibrating AI Confidence To Reality」那张图里,调整完成后数据点紧贴完全校准对角线。起作用的是两层修正:checkpoint 用 RLCD(面向校准决策的强化学习)训练——探索期给 logits 加零均值高斯噪声,奖励来自严格适当评分规则,逼模型吐出诚实的概率分布;然后你再做一次本地温度调整,用自己公司的一小片数据拟合温度变量。视频引用的成绩:英文模型 ECE 降到 0.081,macro 精度稳定在 83.8%。实际收益:你可以对着「说什么就是什么」的概率硬编码业务阈值。
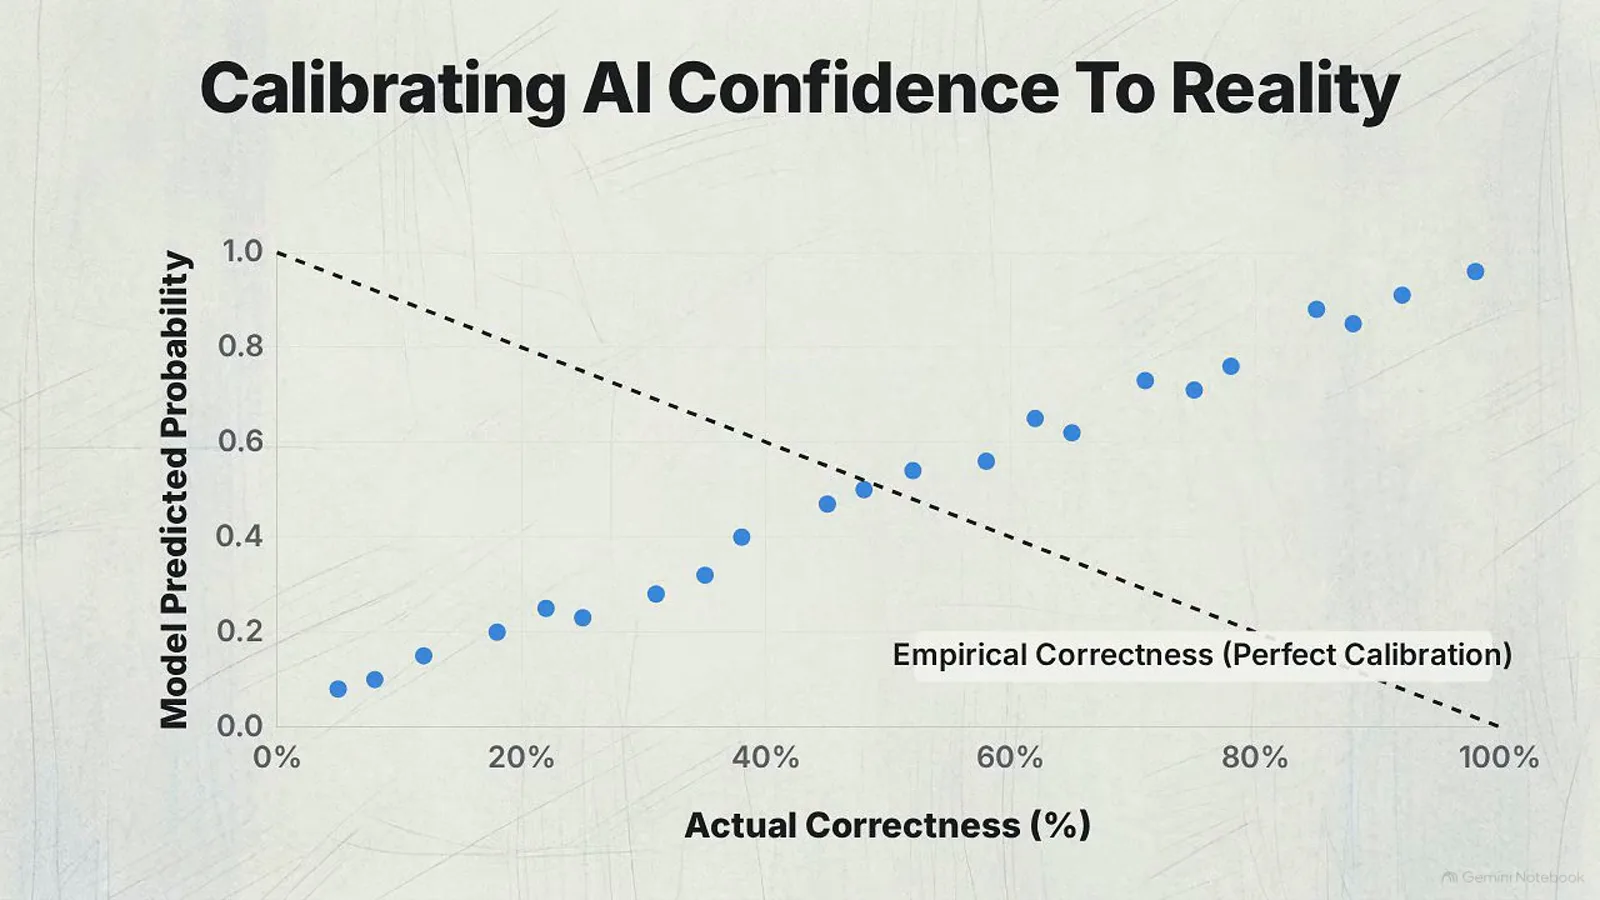
点贴着对角线,0.9 才真的意味着十次对九次。跳转至 6:50 - 6
把置信度门槛写进代码:高于 0.85 执行,低于 0.85 留存
ECE 低,只有在代码真的拿它做决策时才有价值。视频的 threshold check 流程图就是范本:进来的决策先过一个逻辑门,拿校准后的置信度对比一个写死的 cutoff——置信度高于 0.85 走自动执行,低于 0.85 进 hold 队列等人工复核。这一个分支就消灭了静默自动化事故:拿不准的情况升级给人,而不是自信地把错误答案发出去。它和模型内部的 act/escalate 头是配套的——二级头部读代表整份文档的池化 CLS token,套用一个严苛的代价矩阵:正确的自动决策奖 +1.0,错误的安全动作罚 −3.0。照这个模式搬进你自己的集成:一个阈值常量、两条代码路径,再加一行日志记下每次升级时的置信度,方便拿真实流量回调 cutoff。
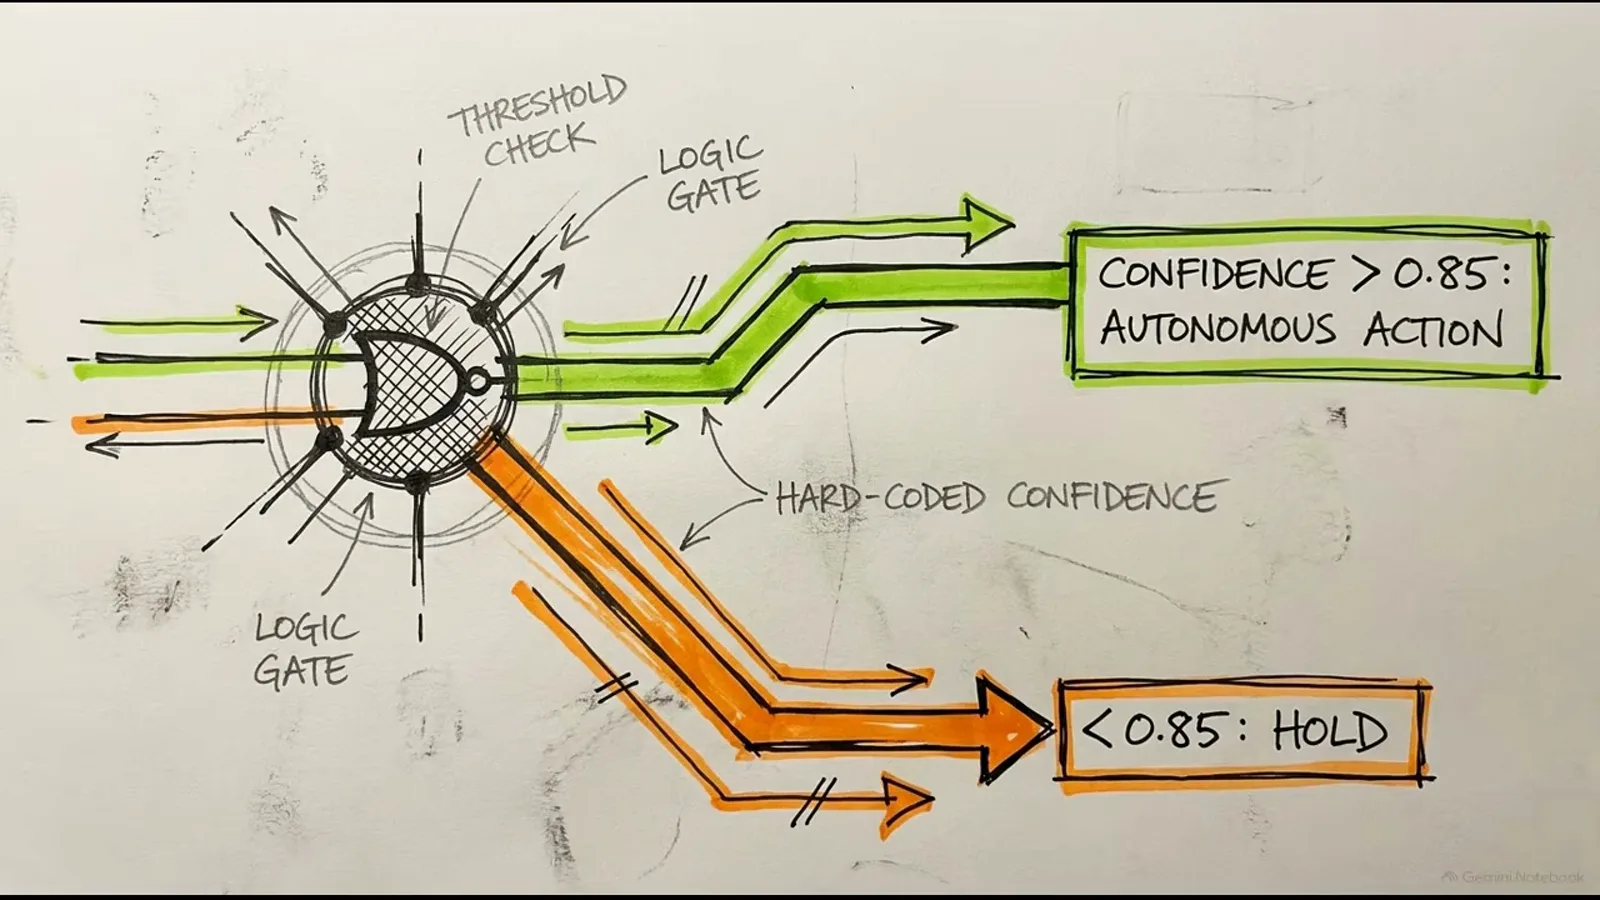
一个写死的 cutoff,把校准过的概率变成安全的自动化。跳转至 7:28 - 7
非英文载荷路由到多语言 checkpoint
英文主干有一个被视频重点演示的失效模式:遇到高棉语这类非拉丁文字,准确率掉到零——而模型照样报出 0.952 的虚假置信度,畅通无阻地越过一切推理后安全闸门。一个在总体上校准良好的数字,在训练分布之外仍然可能灾难性说谎,所以别让英文载荷意外蹭到多语言模型,反之亦然。解法是 route mode:一段内嵌 Python 脚本在半个毫秒内完成语言判定,自动把非英文文本送往多语言 checkpoint(宣称覆盖 100+ 种语言)。视频画的完整链路:进来一个 payload,Python 路由器分诊,然后分叉给英文模型或多语言 checkpoint。但它紧接着补了一句警告:默认的懒加载策略让 checkpoint 之间切换贵得离谱——这正是最后一步要修的问题。
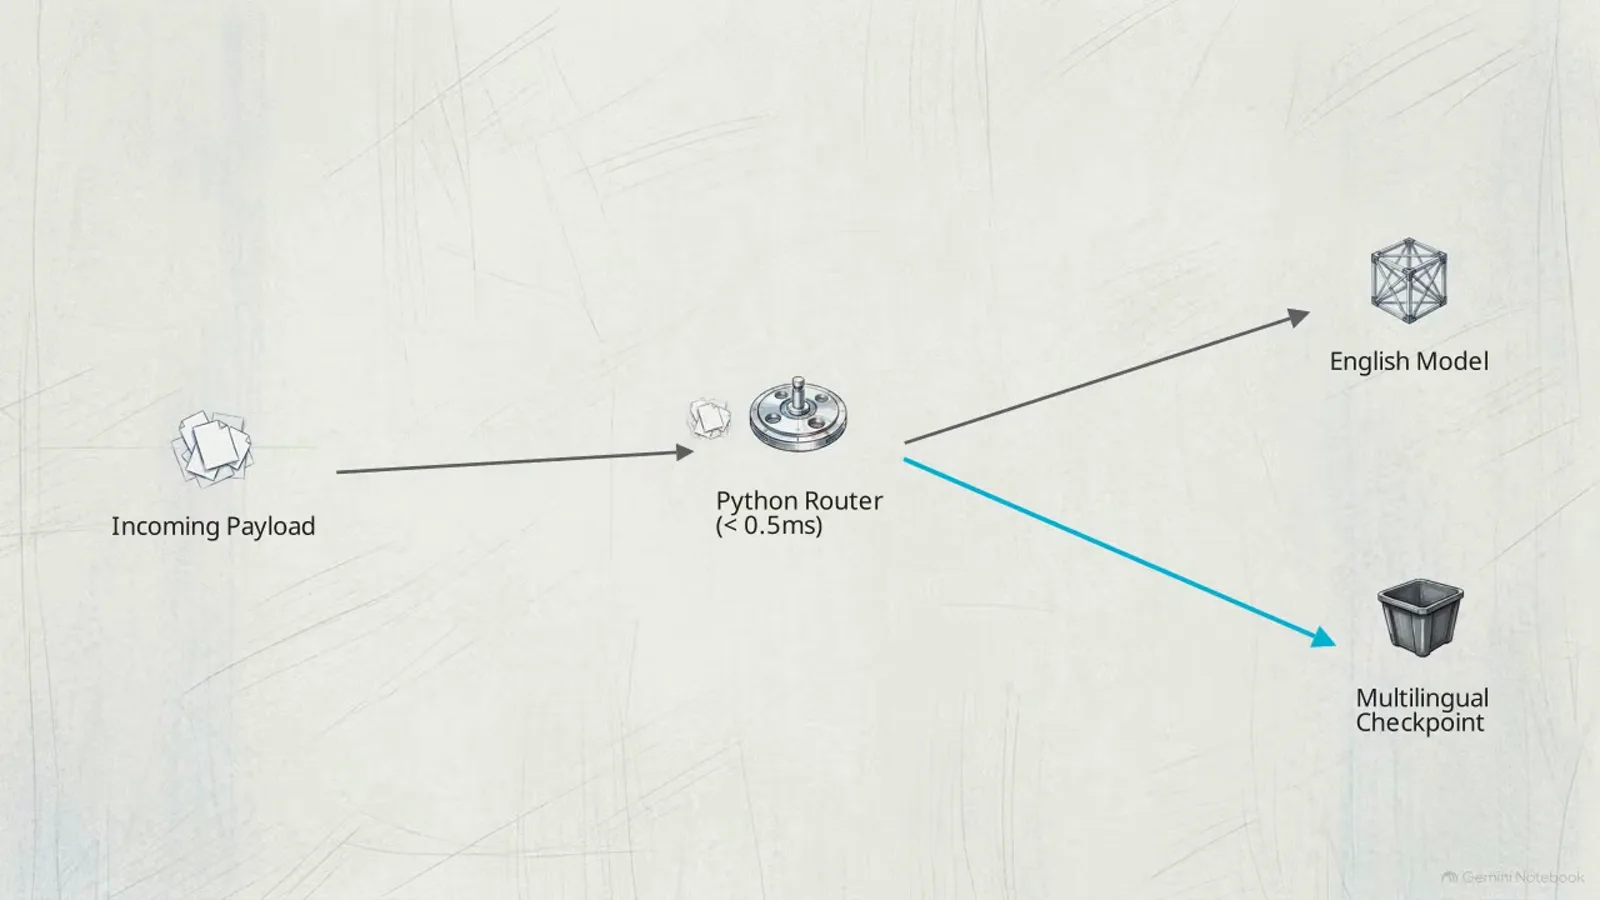
亚毫秒语言判定,然后自动选对 checkpoint。跳转至 8:01 - 8
设 preload=True,让两份 checkpoint 常驻显存
视频最后警告的配置错误:Laya 默认懒加载,checkpoint 直到第一次被用到才构建,而 GPU 上冷加载一份 checkpoint 要超过 10 秒——视频的 GPU 内存图标出了 cold boot 那根尖峰,任其在负载下发生,后果就是 system stall 和 structural failure。在生产环境里,这一次性代价足以赔光全部 40 毫秒以内的优势。修法是代码编辑器草图里的那一行:router = Router(preload=True, device="cuda")。把 preload 参数设为 true 会占用约 1.5 GB 显存,让英文和多语言两份 checkpoint 常驻、随叫随到,route mode 切换语言零开销。视频的结论:显存管到位,引擎就能兑现对商业方案六到八倍的延迟优势。整套安装就绪:载荷形状对了、选项 schema 守了纪律、概率校准加了门槛、语言路由接好了、两份 checkpoint 钉在显存里。
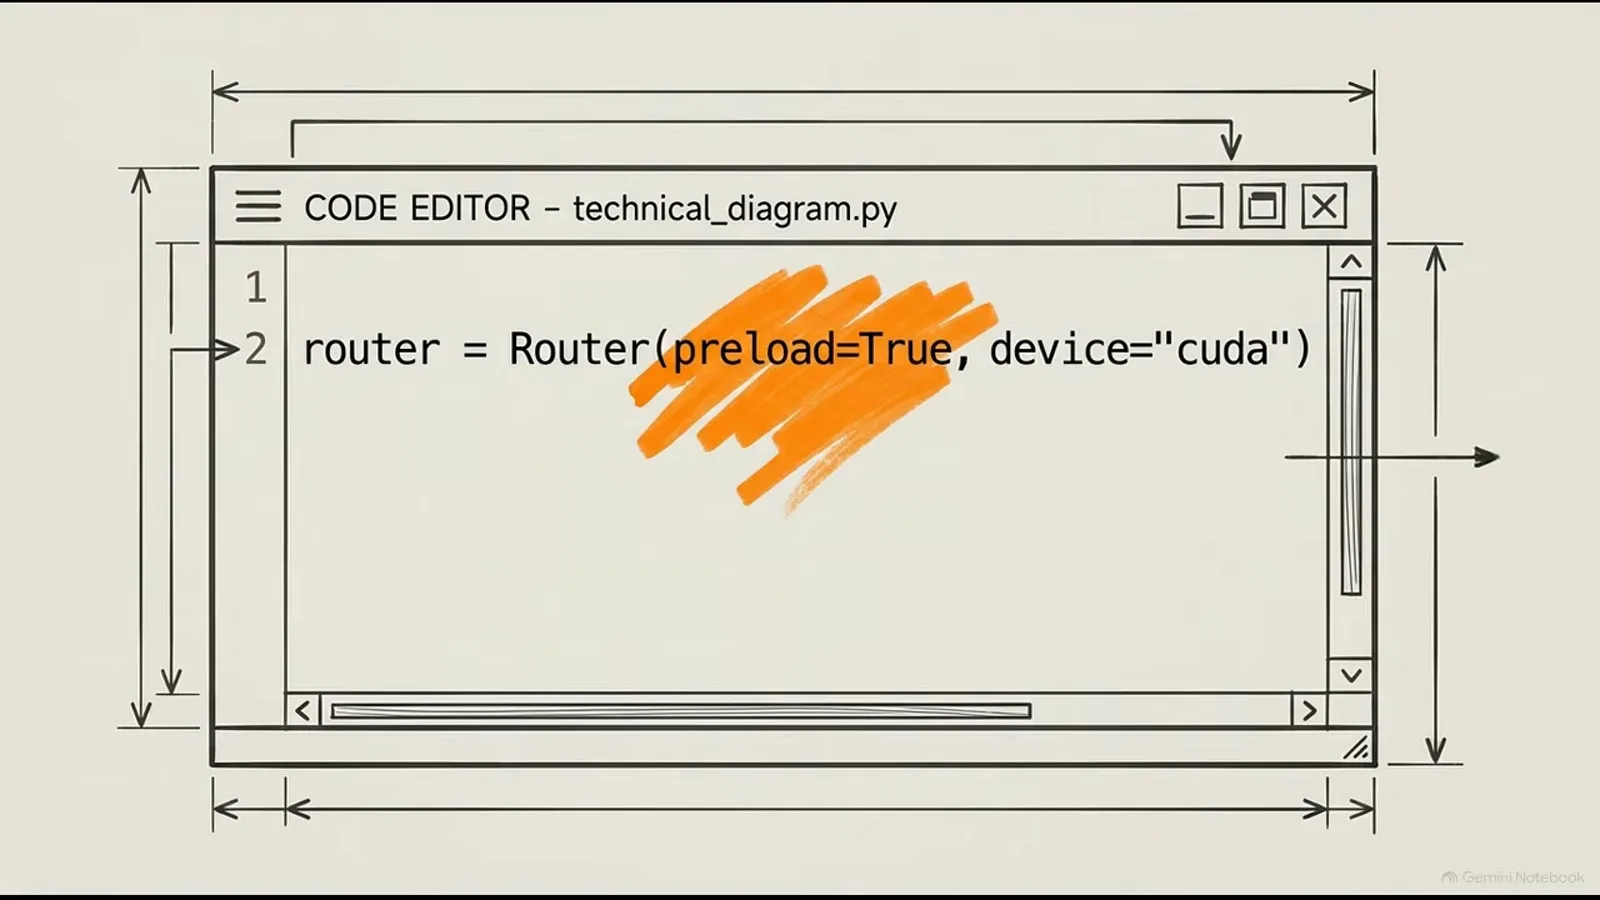
一行代码、1.5 GB 显存,生产环境再无 10 秒冷启动。跳转至 8:32
常见问题(FAQ)
Laya 是什么?
Laya 是 NandhaKishorM / Convai Innovations 开源的 non-autoregressive「System 1」决策引擎,Apache-2.0 协议。它不逐 token 生成文本,而是接收一份 state 文档加一套严格的问题方案,用 ModernBERT-large 主干(英文 checkpoint 共 421M 参数)一次前向给每个选项打分,返回类型化、校准过的概率。代码在 GitHub(github.com/NandhaKishorM/laya),权重在 Hugging Face(convaiinnovations/laya),PyPI 上的包名是 laya。
Laya 和 Jev 什么关系——它能替代 Jev API 吗?
Laya 把自己定位为 Jev 托管决策 API 的开源、自托管替代品,载荷协议兼容:同样的 state + questions 形状,同样的 Choice / Score / Noul 原语词汇。视频的基准卡拿 38.4 ms 单题延迟对比 Jev 公开数字 236–276 ms、ECE 0.081 对 0.246——但那些 Jev 数字是第三方公开成绩,不是受控的同台对跑。当自托管、单次决策成本和延迟是你的主要矛盾时选 Laya;当你要托管服务的参考级质量、尤其是选项很多 Laya 会变弱的场景时,用 Jev API。
Laya 怎么安装?
从 PyPI 装:pip install laya(Python 3.10+,核心依赖 torch 和 transformers),权重从 Hugging Face 拉——英文用 convaiinnovations/laya,另有 multilingual 和 typed-decisions 变体。要起服务就装 laya extra(FastAPI 加 Uvicorn),用 laya-serve 暴露一个 Jev 兼容的 POST /v1/systemone 端点。然后照本教程的载荷纪律来:一份 state 文档、类型化问题、选项不超预算,Router 配 preload=True。
跑 Laya 一定要有 GPU 吗?
招牌数字确实假设有一块。视频的基准卡测于单张 Tesla T4(单题 38.4 ms、十题 156.0 ms),它的生产建议——preload=True 占用约 1.5 GB 显存——也默认 CUDA 设备。Laya 在 CPU 上也能跑(Apple 芯片实测几道题在几十毫秒量级),而 GPU 上冷加载一份 checkpoint 要超过 10 秒,所以实用建议是:任何一块还行的 GPU 都能给你宣传中的 40 毫秒以内体验;CPU 适合低流量或批量任务——那种秒级延迟不心疼的场合。
Laya 的概率校准到底是怎么做的?
两层。训练层:checkpoint 用 RLCD(面向校准决策的强化学习)调优——探索期给 logits 加零均值高斯噪声,奖励函数用严格适当评分规则,逼模型吐出真实概率分布,而不是被推到 1.0 的最大值。部署层:用自己的数据样本拟合一个本地温度调整,视频把英文模型 ECE 降到 0.081(未校准基线 0.246)、macro 精度保持 83.8% 归功于此。最后把校准花出去:硬编码一个置信度阈值——视频的示例是高于 0.85 执行、低于留存。
什么时候选 Laya,什么时候用 Jev API?
当数据不能出内网、单次决策的 API 成本在你的量级下很可观、选项集小而规整时,选 Laya——单次前向打分让一块 T4 每天做几百万次 40 毫秒以内的决策几乎零成本。两种情况要三思:标签集很宽的问题——视频展示 77 个选项的分类体系在 192 token 预算内精度封顶 0.425;以及非英文流量——英文 checkpoint 对高棉语准确率为零还报 0.952 的置信度,必须路由到多语言 checkpoint。完整规格对比和基准数字的注意事项见本站的 Laya vs Jev 替代品档案。
相关推荐
Laya vs Jev:完整替代品档案
本教程的姊妹篇规格页:参数、协议、基准表格,以及每条 Laya 宣传背后的诚实注脚。
阅读Run Jev Locally:在自己的 GPU 上跑 Kev、SemIf 与 Von
另外三个开源路由的同一套自托管打法——本页把 Laya 补进这个系列。
阅读开源 Jev 替代品目录
开源决策引擎的全景图,逐一基准测试与分诊。
阅读自托管 Jev 指南
协议兼容决策引擎的托管模式——Laya 部署在其中的位置。
阅读开源模型指南
怎么用 JevBench 和决策指数在开源 checkpoint 之间挑选。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)