
Guides / 视频转图文攻略
Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
classifier.dev 把 Jev 决策引擎封装成零样本文本分类的 CLI 与 REST API。本图文攻略从一条 npm 安装命令开始:批量反馈文件经 stdin 重定向送进 classify,逗号分隔的标签定义类别,--review 0.7 做置信度门禁,再逐字段拆解 input + labels 的 POST 契约与类型化 JSON 响应。
速览结论
classifier.dev 是架在 Jev 决策引擎上的无状态零样本文本分类代理——不要 API key、不要注册、不要鉴权,因为你发去的文本被判断后立即丢弃。一条 npm 命令(npm i -g classifier.dev)装出 classify 命令:逗号分隔的标签体系加 stdin 重定向的文本文件,每一行原文都会带回家的类别。加上 --review 0.7(0 到 1 之间的浮点数)就能做确定性路由——低置信度样本隔离给人工审核,高置信度样本继续走自动化流水线。同一个引擎也是 REST API:向 classifier.dev 端点 POST { input, labels },标签体系每次请求最多 100 个离散类别,响应读回 { label, confidence, scores, model, ms }——视频里的演示返回 label "bug"、confidence 1,模型 jev-1.13.0,耗时 260 毫秒。因为全程不生成 token,幻觉类别和多秒级 LLM 延迟都进不了流水线;Agent 还能通过 MCP 把这能力挂进自己的技能集。
分步图文攻略
- 1
文本分类为什么该用决策引擎,而不是 LLM
视频开头先点破瓶颈:自回归 LLM 逐个 token 生成文本,拿它给成千上万条客服工单分类,每个 token 都在付延迟和算力——还要承担幻觉与格式错乱的风险。classifier.dev 走的是另一条路:一个由 Jev 驱动的 System One 专精决策引擎,把你的非结构化输入和预定义类别放在单次并行推理里一起评估,返回类型化判断——整个链路不生成任何文本。4 分 35 秒看完,你会拿到同一个引擎的两种形态:解析批量文件的本地 CLI 流水线,和给后端用的程序化 REST 调用。
决策引擎只做判断,不写一个 token。跳转至 0:20 - 2
全局安装 CLI——不要 key、不要账号、不要鉴权
前置条件只有三样:能用的终端、装好的 Node.js、一个普通文本文件。用 npm i -g classifier.dev 装好工具,再敲 classify 激活帮助菜单,确认二进制已在系统级可用——安装日志里每个依赖逐项打勾,打印 Setup complete,最后停在 Config verified。全程没有 API key 申请、没有账号注册、没有鉴权环节:classifier.dev 严格以无状态代理运行,把你的数据发给模型后立即丢弃。
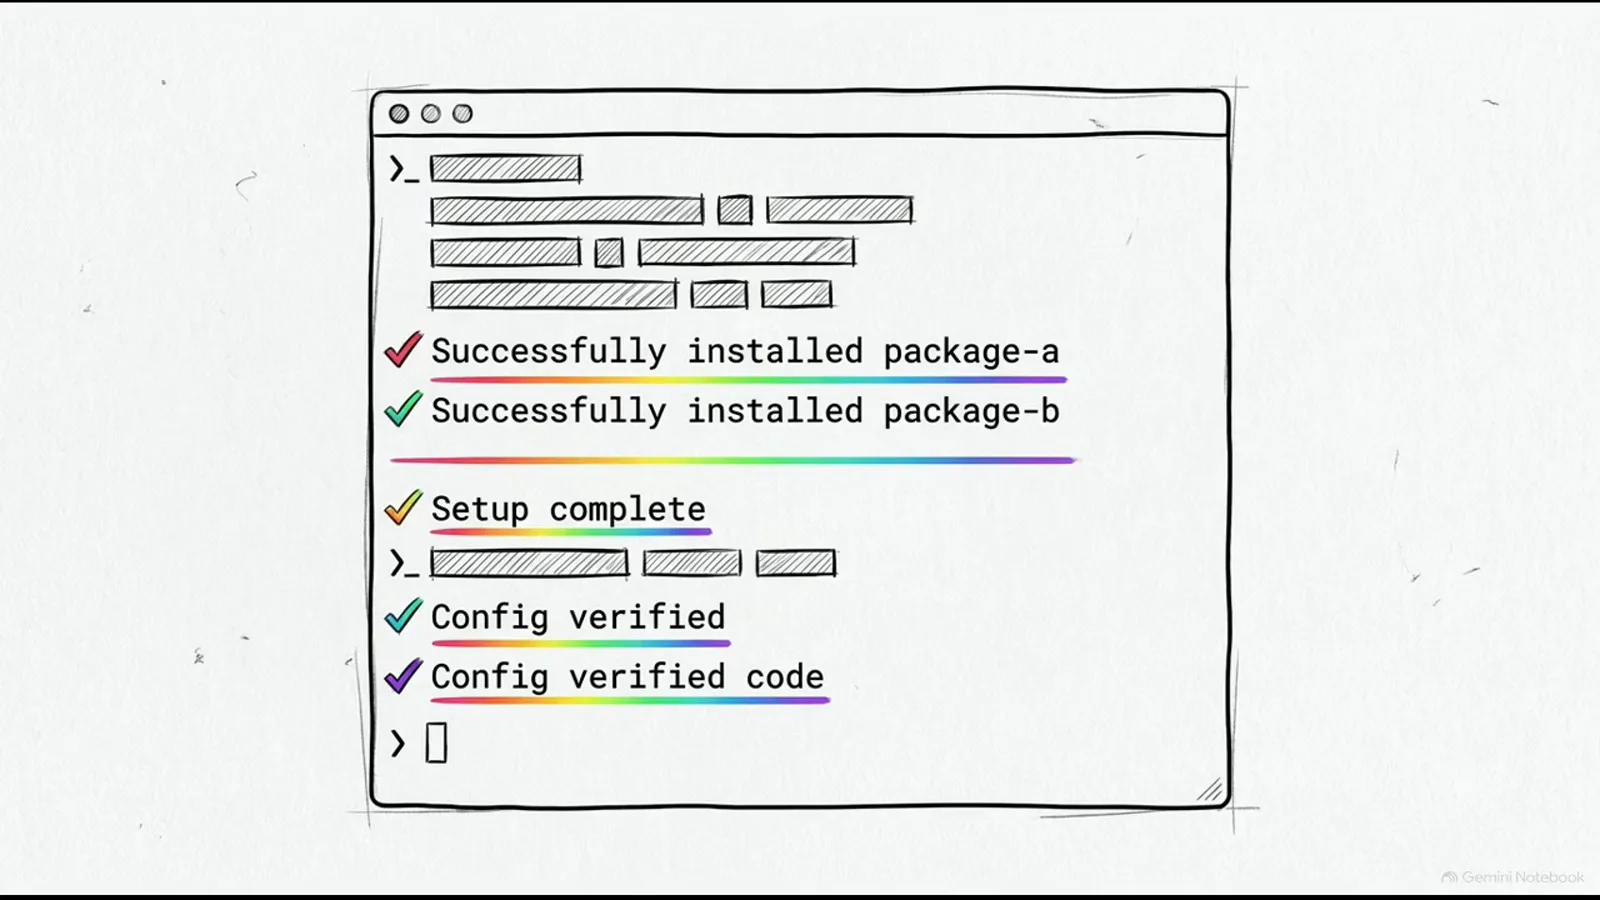
一条 npm 命令,帮助菜单确认二进制就位。跳转至 1:08 - 3
准备输入文件:一行一条记录
零样本意味着你不用训练、不用上传样本——语义全靠标签本身承载。建一个普通本地文本文件,装进几条意图截然不同的未结构化用户评论。视频里的 feedback.txt 就混了三种意图:一条 bug 报告("System is responsive but needs more features",系统响应快但缺功能)、一条功能诉求("Color scheme is vibrant and clear",要求调整配色)、一条好评("Integration with external tools is seamless",外部工具集成顺畅)。一行就是一次分类,故意把不同意图混进同一个文件,才让这批处理值得自动化。
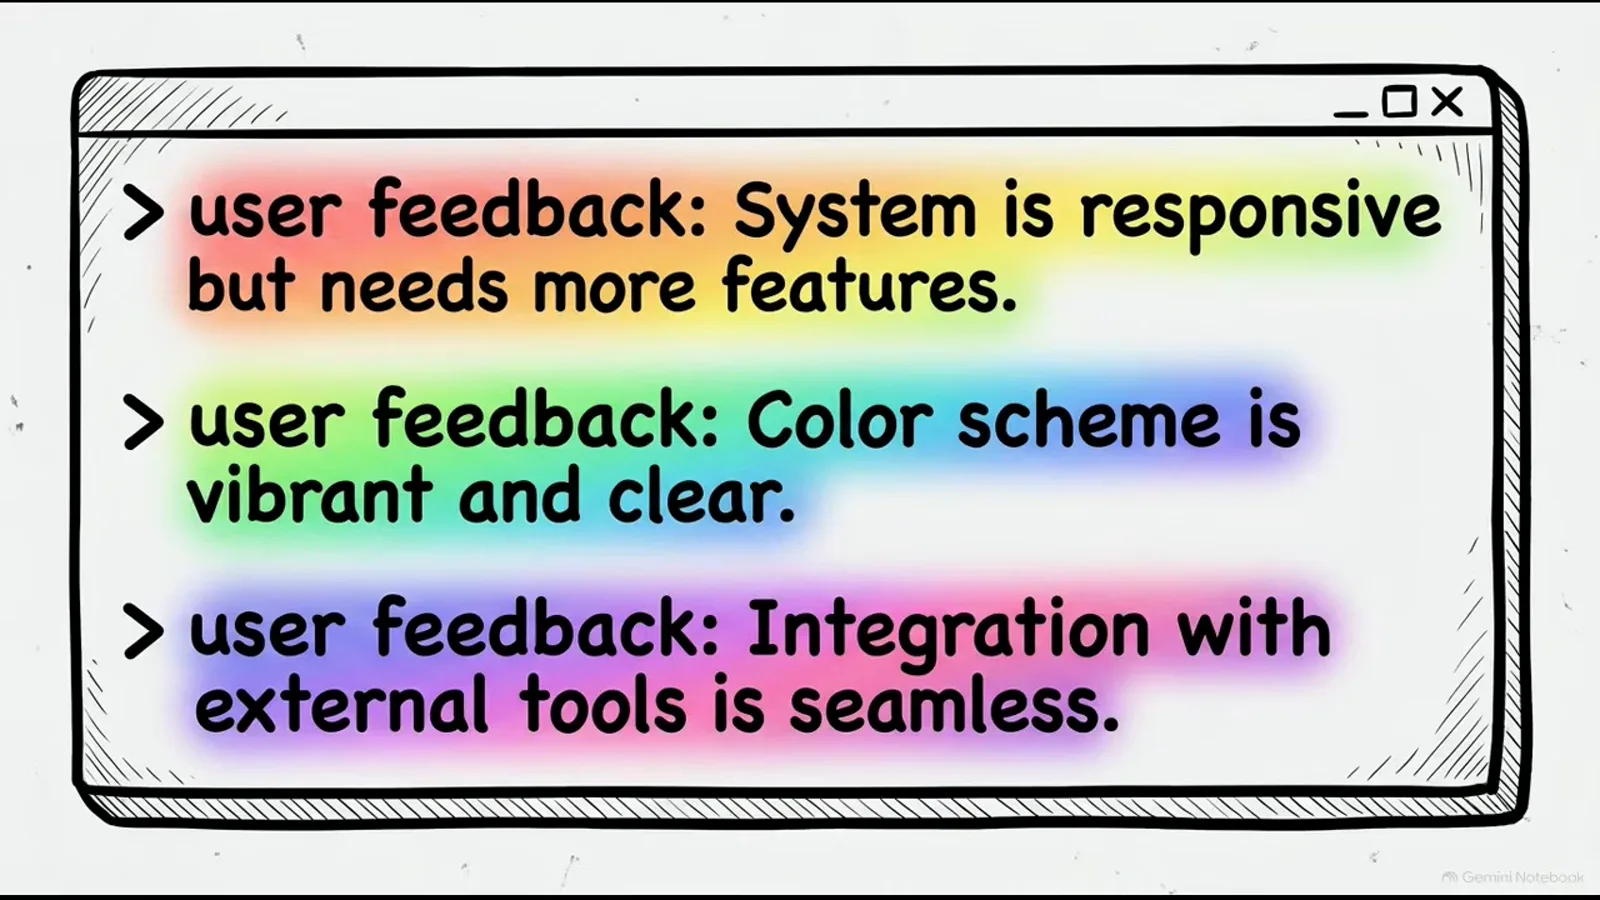
一行一判,故意混进不同意图。跳转至 1:32 - 4
跑 classify:逗号分隔标签 + stdin 重定向
调用形态是:classify 命令,后跟逗号分隔的分类标签参数——视频里是 error、function、praise——再用 Unix 标准输入重定向把文本文件直接送进命令流:classify error,function,praise < feedback.txt。终端立刻回显你的原始文本,每行末尾多出它被划入的类别。把 Unix 数据管道和零样本分类组合起来,就能随手结构化海量日志,借到 AI 模型的语义理解而不用写一行自定义 API 封装代码。
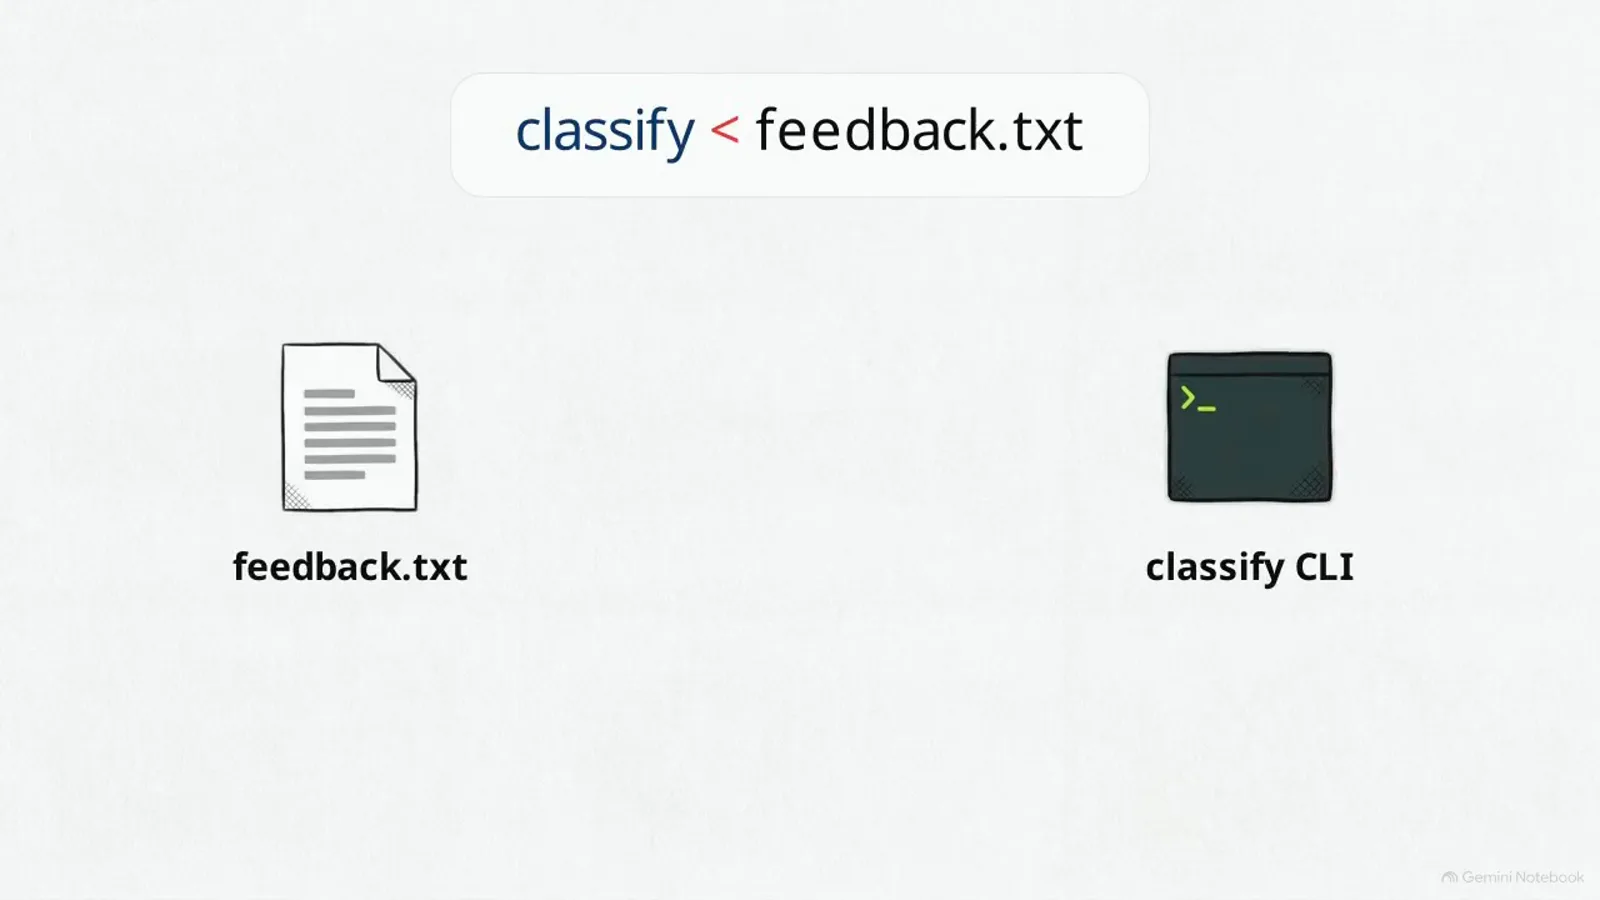
标签走参数,文件走 stdin。跳转至 1:44 - 5
读带标签的输出,信任校准过的置信度
每一行原文回来时都整齐地加上了数学判定出的类别:系统报错标上 [bug],两条算法诉求标上 [feature],那条好评标上 [praise]。底层是 Jev 模型产出的校准概率——视频特意对比了普通语言模型经常给错误结论打高置信度的毛病。校准的意义在于:置信度越高,统计准确率严格越高——正是这个性质让下一步的阈值自动化敢落地。
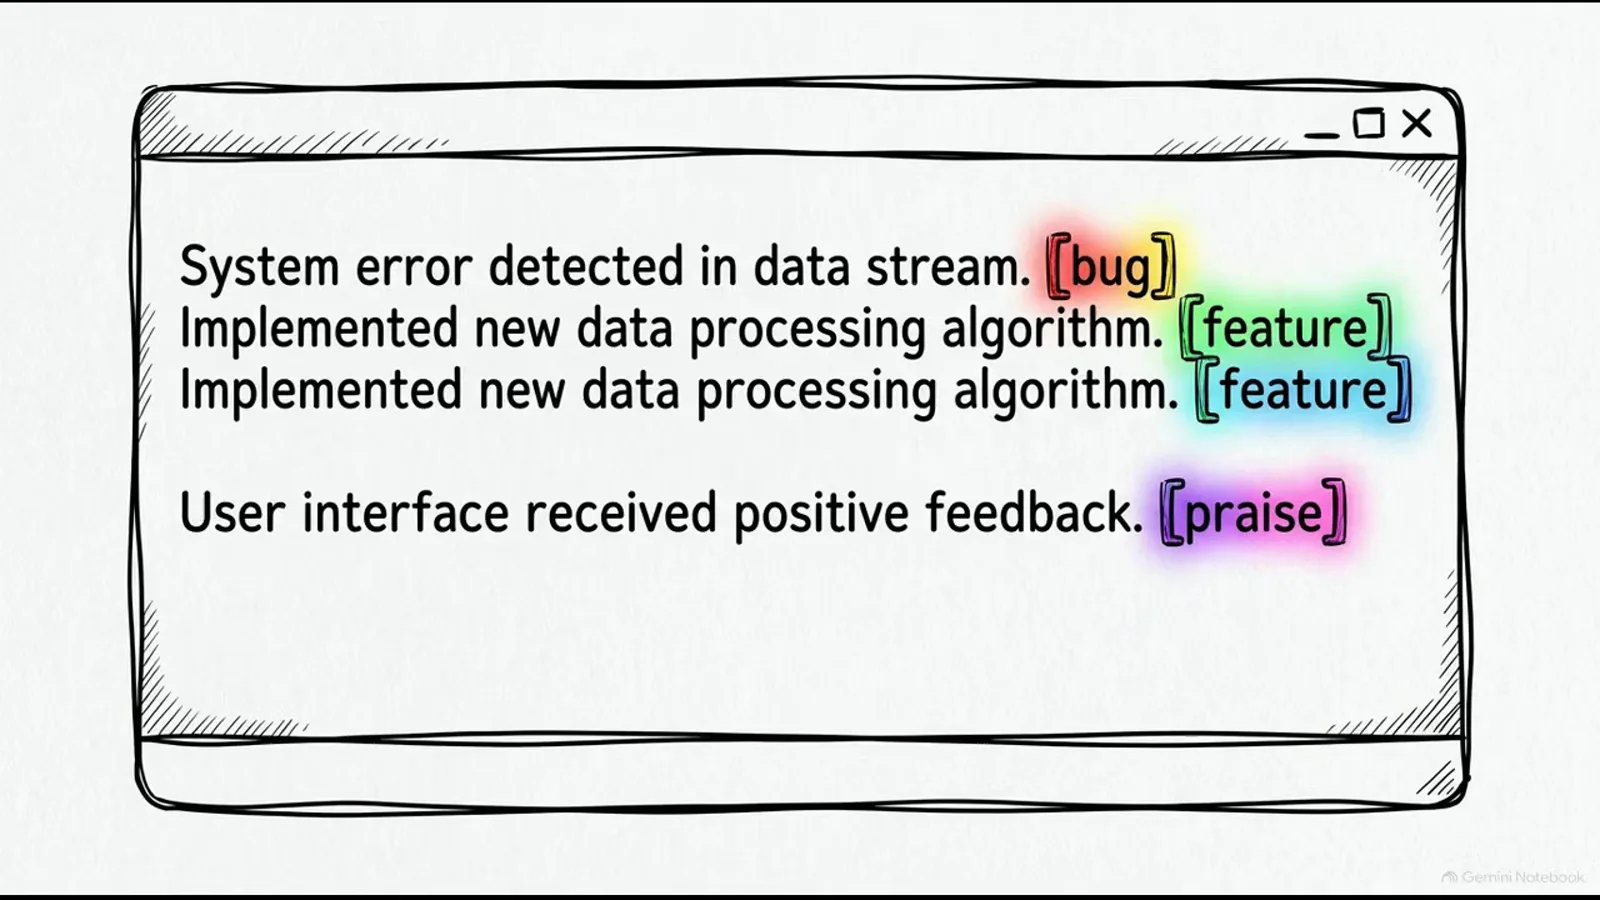
同样的行进去,出来时每行都带类别。跳转至 1:52 - 6
用 --review 0.7 给置信度设门禁
把刚才的 CLI 命令再跑一遍,追加 --review 0.7。传给 review 的值必须是严格介于 0 和 1 之间的浮点数。这一个参数就建立了确定性路由:低于阈值的模糊样本被隔离出来给人工审核,高置信度结果继续流向自动执行。视频里的校准图画出了这条分界线——统计准确率对模型置信度,理想校准的对角线穿过 0.7 决策边界,一侧是自动化流水线,另一侧是人工审核。
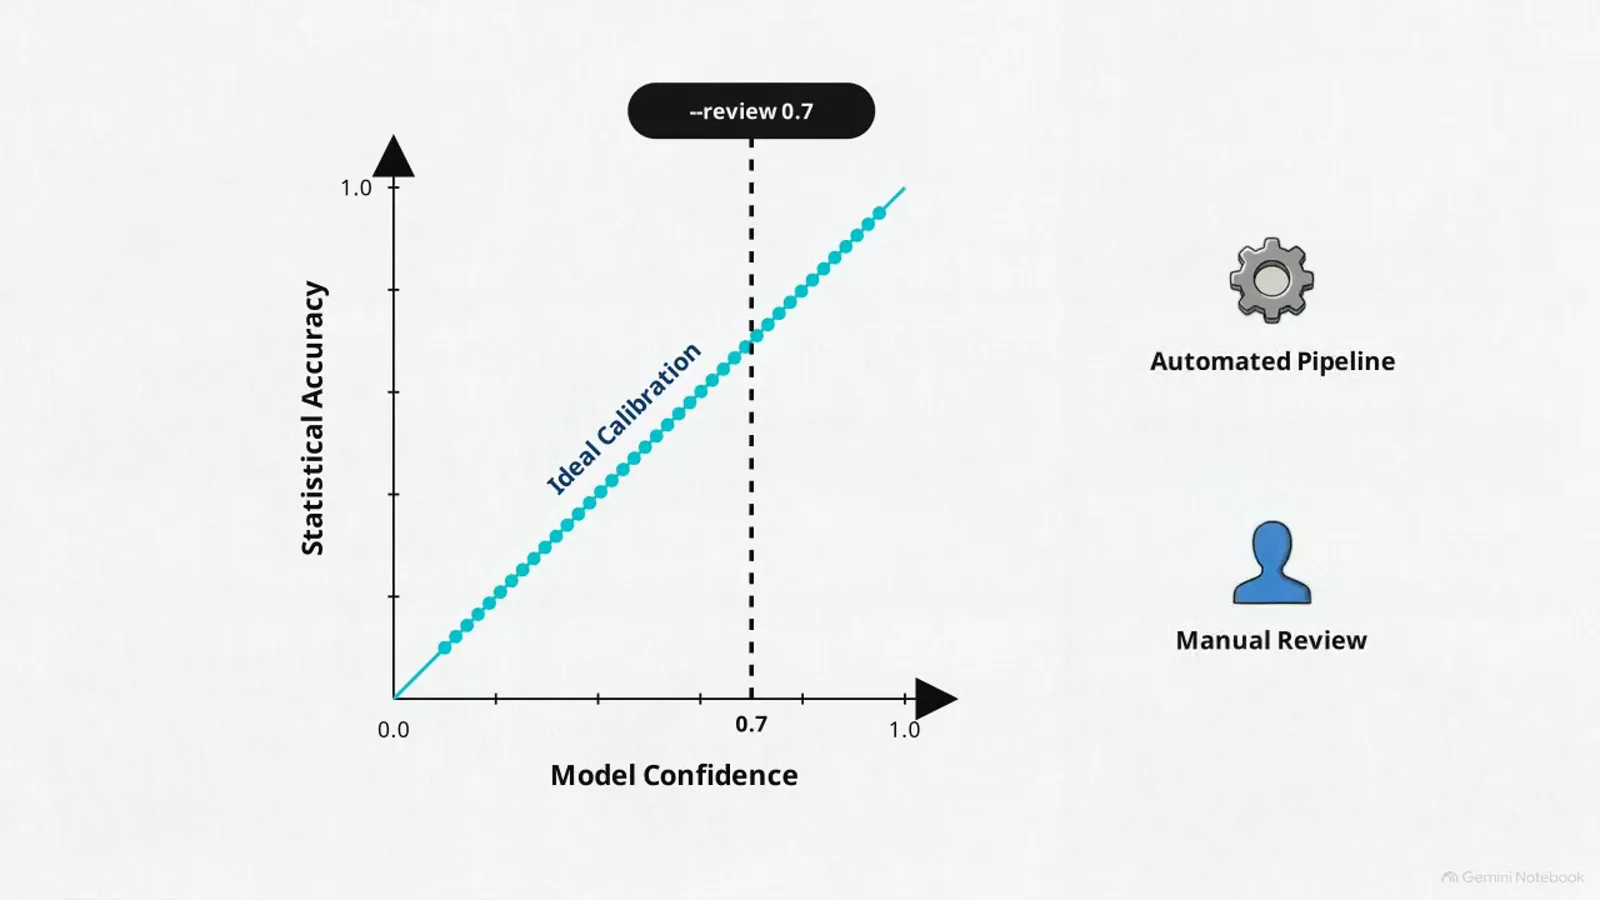
线以下是人工,线以上是流水线。跳转至 2:28 - 7
转程序化:从后端 POST { input, labels }
到了 Web 应用和微服务里,就从 shell 换成程序化 REST 调用:在后端脚本里用 curl 向 classifier.dev 端点发标准 JSON POST 请求。载荷只需要两个键——装文本的 input 字符串、定义类别的 labels 数组;视频的请求体把 input "the checkout button does nothing" 和 bug、feature、praise 三个标签配成对。为了保住单次推理的最优处理速度,标签体系每次请求最多 100 个离散类别。
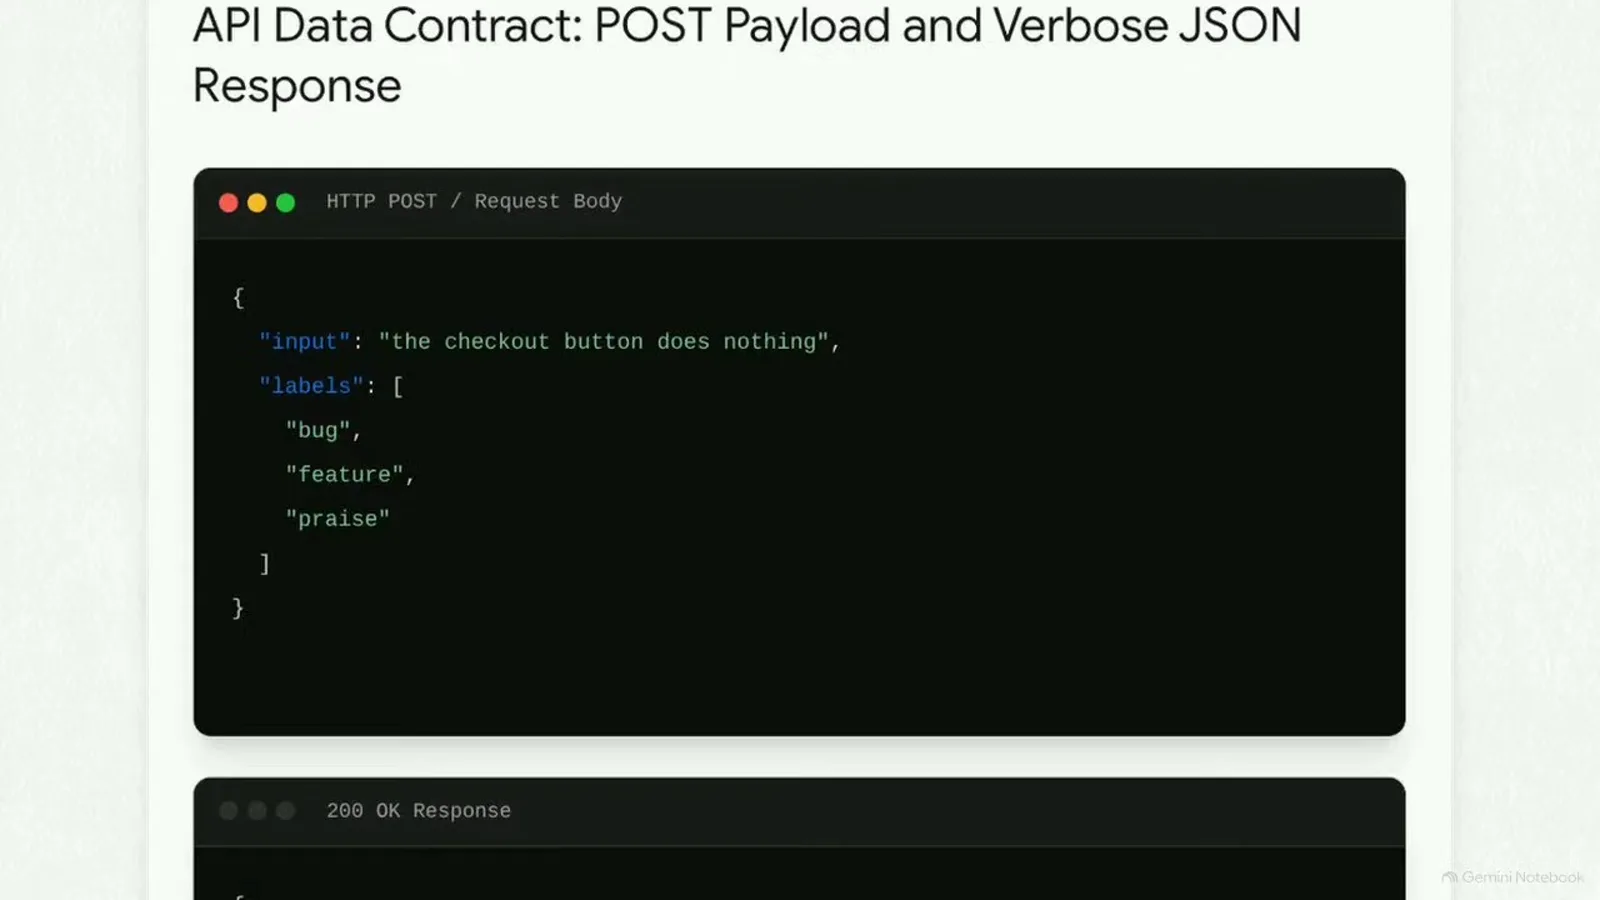
载荷就两个键:input 加 labels,上限 100 类。跳转至 3:12 - 8
解析类型化响应:label、confidence、scores、ms
视频里的 200 OK 响应把整个契约摆全了:选中的主导字符串标签("bug")带主置信度(1),嵌套的 scores 对象拆出每个请求标签各自的独立概率(bug 1、feature 0、praise 0),模型字符串(jev-1.13.0),以及记录服务端处理耗时的 ms 键——260 毫秒。受限于这个定界 JSON 数据契约,不存在的类别根本不可能被造出来——传统 LLM 集成里那些提示词工程和 JSON 解析防御代码都可以删掉。自主 Agent 还能经 MCP 把这能力直接挂进技能集,让 AI 分诊跑出标准软件基础设施的速度和可靠性。
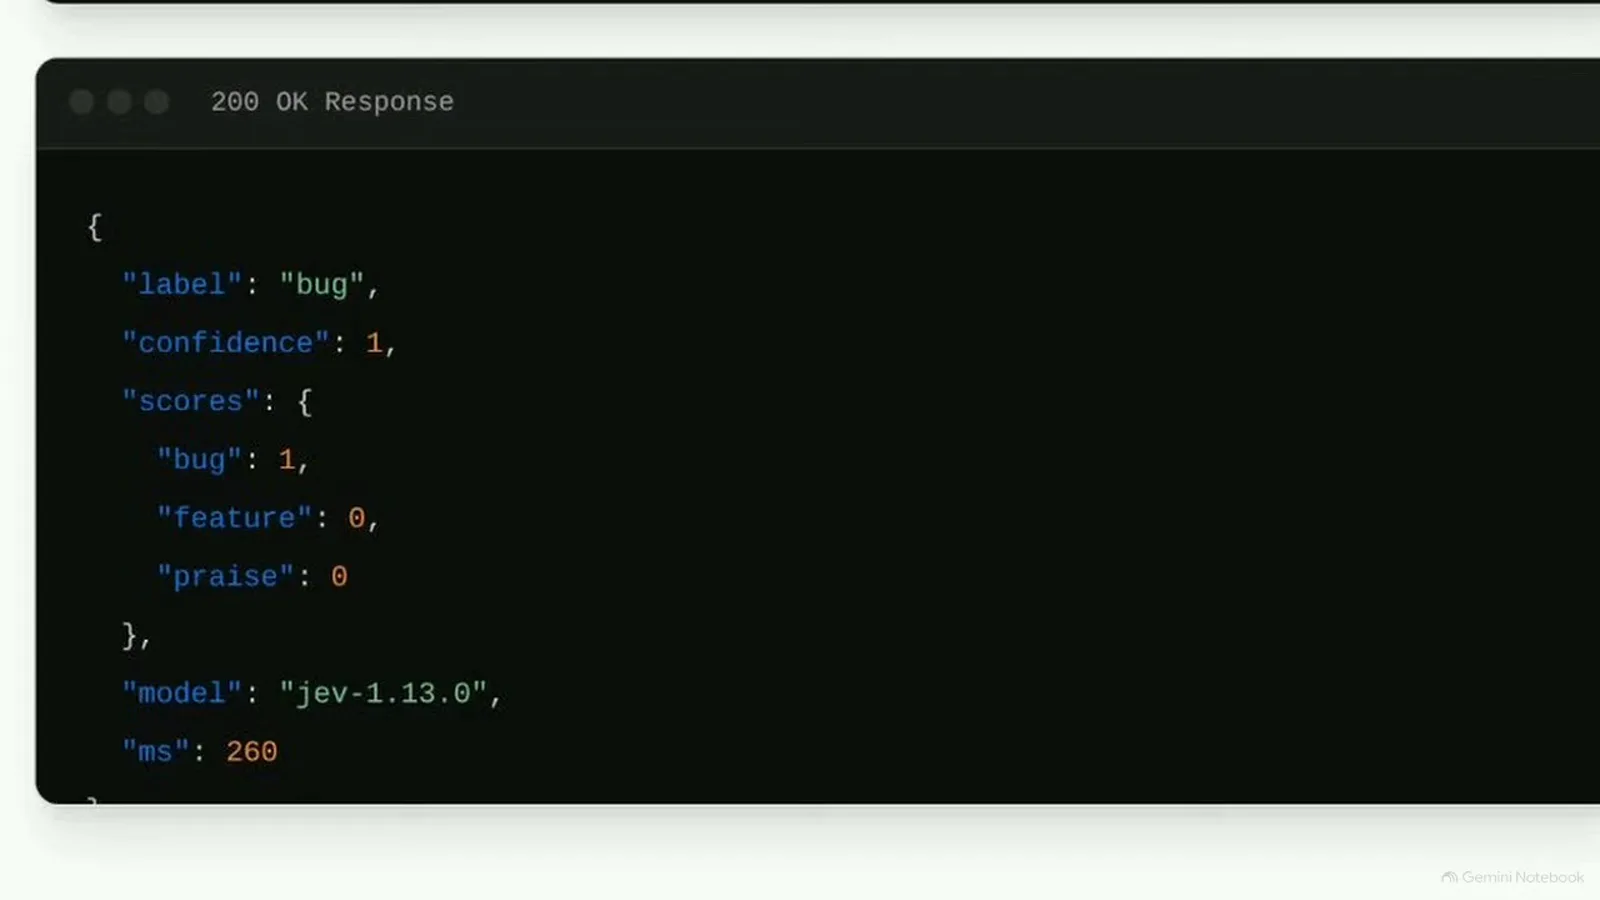
类型化答案、逐标签概率,260 毫秒交卷。跳转至 3:28
常见问题(FAQ)
Jev 文本分类 API 需要 API key 吗?
不需要。classifier.dev 严格以无状态代理运行:把文本发给 Jev 模型判断后立即丢弃,所以没有 API key 申请、没有账号注册、也没有鉴权环节。一条 npm 命令装好 CLI 就能开跑,后端调 REST 端点同样如此。
怎么用 Jev API 做情感分析?
情感只是又一套标签体系。把你的标签——比如 positive、negative、neutral——按逗号分隔传给 CLI,或放进 JSON POST 的 labels 数组,引擎就会返回主导标签和主置信度,scores 对象里还有每个标签各自的概率。分类是零样本的,随时可以改名或重划标签集而无需重新训练;只需守住每次请求最多 100 个离散类别的上限。
一次 Jev 分类请求能带多少个类别?
视频建议把标签体系限制在每次请求最多 100 个离散类别,以保住单次推理的最优处理速度。更紧凑的标签集实际效果也更好:你定义的每个标签都是并行评估的一个分支,响应的 scores 对象会给每个请求过的标签一个独立概率。
分类响应里有哪些字段?
视频的 200 OK 示例里一共五样:选中的主导字符串标签("bug")、主置信度分数(1)、嵌套 scores 对象给出的每个请求标签的独立概率(bug 1、feature 0、praise 0)、模型标识(jev-1.13.0),以及记录服务端处理延迟的 ms 键(260 毫秒)。定界 JSON 契约保证标签永远不会跑出你的体系之外。
为什么不直接让 LLM 按 JSON 输出分类结果?
LLM 逐 token 生成,可能幻觉出类别或吐出残缺 JSON,生产集成因此长满提示词工程和防御性解析。Jev 支持的端点返回的是有界 JSON 契约:选中标签必然来自你的标签体系,置信度经过校准——分数越高与统计准确率的相关性越强,演示调用 260 毫秒完成。在这个置信度上做确定性路由——低于阈值就转人工——才把分类变成基础设施。
相关推荐
Jev API 参考
这类分类调用背后的 evaluate 端点与类型化载荷。
阅读Jev 分类极速上手
Sam Witteveen 在 OpenRouter 上实战 Choice、Score、Noul 三大原语。
阅读客服工单路由 Recipe
按类型化标签与阈值路由工单——正是这条流水线服务的生产模式。
阅读何时该用 Jev
哪些场景分类决策胜过文本生成,哪些场景恰恰相反。
阅读Jev API 报错与限流排查
批量分类循环撞上 429 与超时怎么办——不丢批次的退避重试写法。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型