
Guides / 视频转图文攻略
Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
Caffeinated Software 用 9 分钟走完 TypeSafe 控制台 Playground:热狗三明治 Noul 课程从 61% 校准到 76%,按立方体食物规则搭出 Choice 问题并全量排序,再把同一份提示词分别丢给 GPT-5.6 Luna、Sonnet 5 与 Gemini 3.7 Flash,逐家对 token 账单。
速览结论
一段录屏跑通整个 Playground。TypeSafe 控制台的热狗三明治 Noul 课程首答 61% true;补上两句 true/false 判据后到 76%;推倒重做的 Choice 问题——一个热狗 State 加八条立方体规则——把 Taco 排到 94%(Sushi 5%,confidence 93%),全程约 95 毫秒、543 个输入 token 加 84 个分文不收的输出 token。同一份提示词丢进三家对手的 Playground:GPT-5.6 Luna 用了 4.1 秒、为 132 个输出 token 付费(445 进);Sonnet 5 判 taco、confidence 88,674 进 → 173 出约合 $0.0031 一跑;Gemini 3.7 Flash 烧掉 495 进 / 100 出,还给了个 confidence 100。对手全都要为输出 token 付费、置信度全靠自报——这个差距就是 Jev 的整个卖点。
分步图文攻略
- 1
进控制台:三种原语、三节入门课
先解决入场券。录制时 Jev 还是邀请制:在 Join Our Waitlist 表单留邮箱、做一份「我这辈子填过最长的问卷」,等几个小时邀请才到(等待期间可以去项目 Discord 蹲着)。视频引用的官方说法:ChatGPT 联合发明者造了个新模型,快 20–200 倍、便宜 40–400 倍——因为输出 token 免费。进了控制台,Playground 的「Select primitive type」面板就是全部词汇表:Noul 判断一件事有多真(0 到 1)、Score 设评分规则、Choice 出多选题,各自带 Docs 链接。Learn to TypeSafe 面板把同样的东西打包成入门课——Is hotdog a sandwich?(Noul)、What color is the sky?(Choice)、Can monkeys create art?(Score)——下面还有真实用例:简历筛选、客服对话审计、工单分诊。左下角的模型选择器写着 jev-latest。
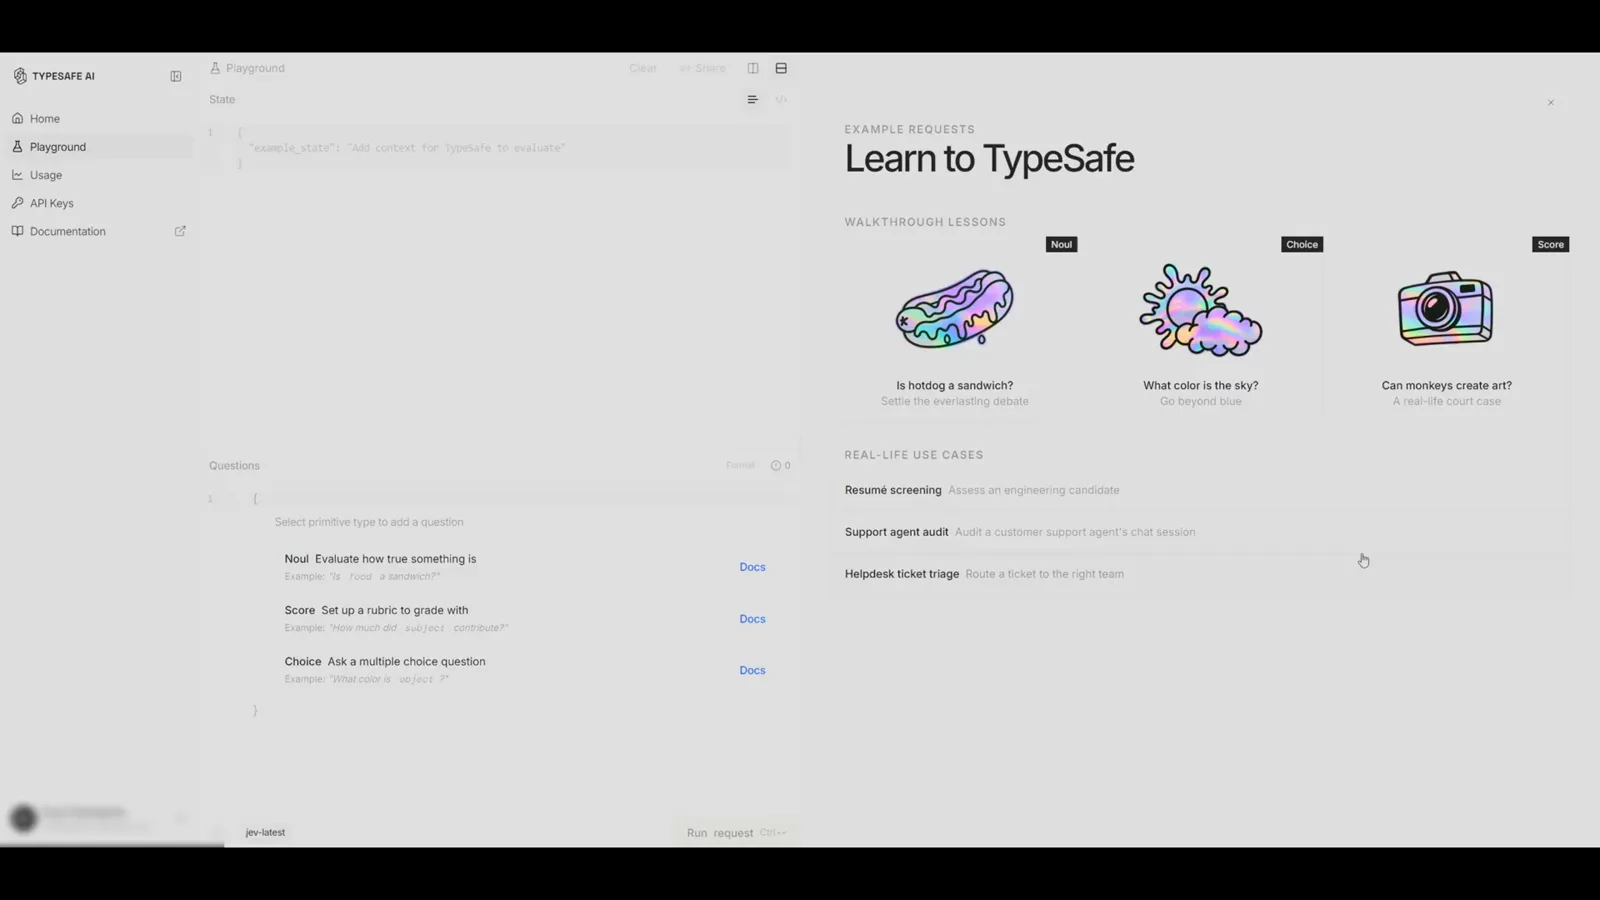
控制台即课堂:三种原语、三节入门课。跳转至 1:25 - 2
跑第一课:模型诚实地说 61%
热狗课打开一个双栏编辑器。State 里是占位符 { "example_state": "Add context for TypeSafe to evaluate" },Questions 里是一个 Noul 问题:{ "is_sandwich": { "type": "noul", "instructions": "Is hotdog a sandwich?" } }。按 Run request(Ctrl+Enter),Response 面板回答「61% true」,落款 jev-latest 100ms · 118ms。课程的引导气泡把教学点挑明:「Hmm, the model’s rather unsure. Let’s clarify what a sandwich is in our question.」光秃秃的问题只会换来一个耸肩——不确定性不是缺陷,是下一步的引子。
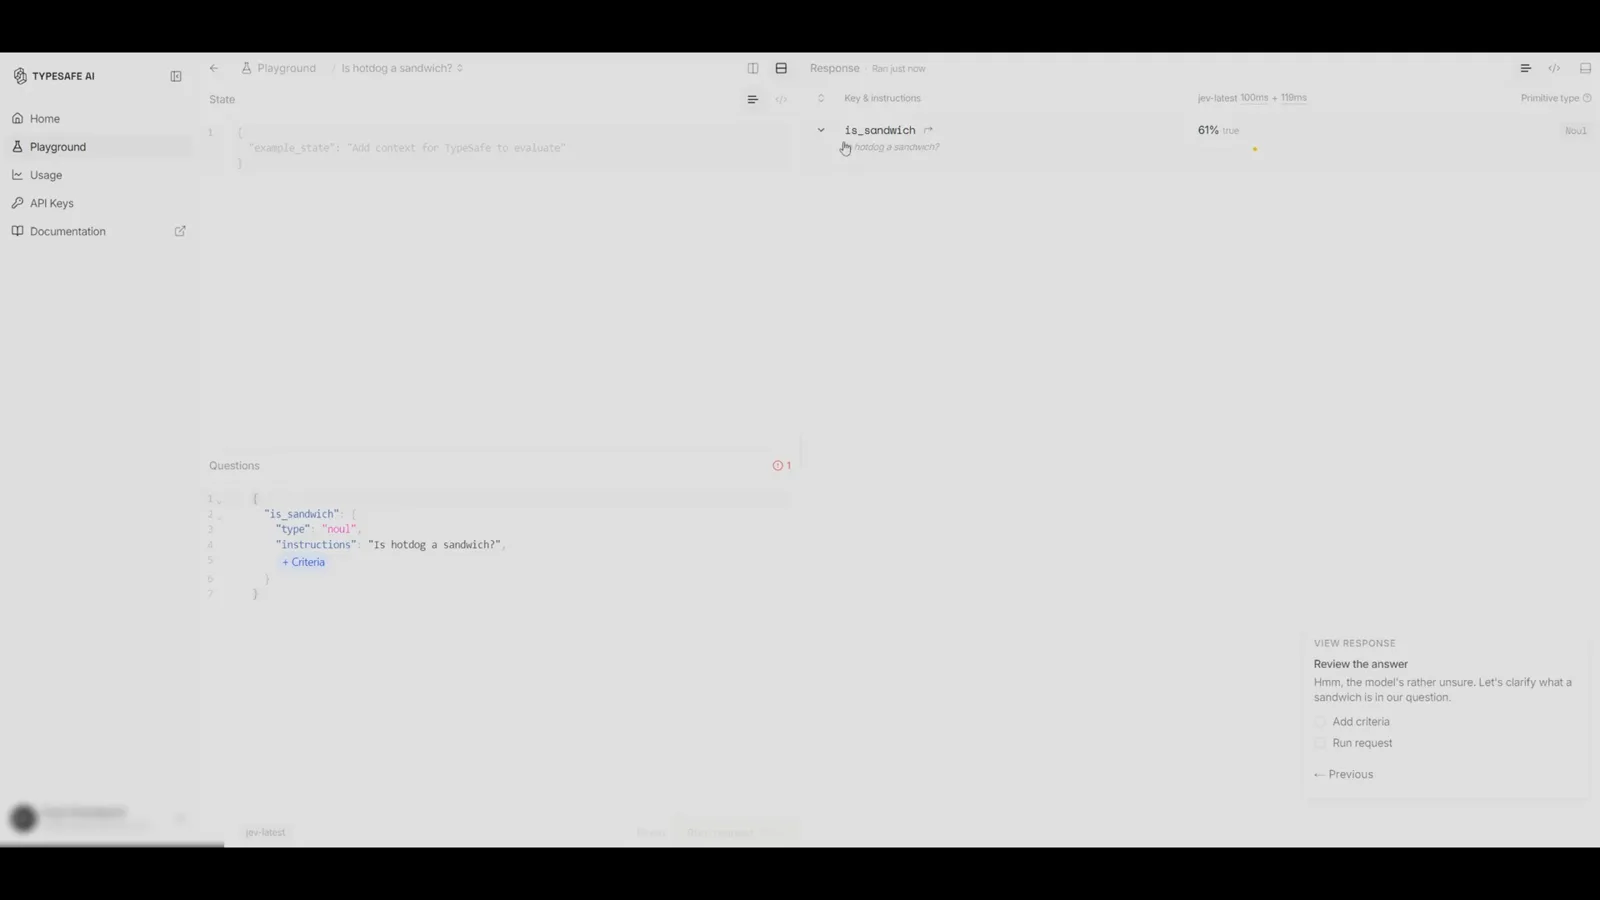
首跑 61% true——连课程自己都承认模型不确定。跳转至 2:12 - 3
加 criteria:61% 变 76%
criteria 就是挂在问题上的定义——主讲人的说法是「basically a definition」。课程加了两条:true = 「A sandwich is a food dish where a filling, such as meat, cheese, vegetables, or spread, is placed between structural starch」,false = 「The food has no bread enclosing a filling or uses only a single slice of bread, or uses a non-bread wrapper such as a tortilla, wafer, or cookie.」原样重跑,答案变成 76% true(jev-latest 135ms · 124ms)。State 没动、问题文本没动,只多了定义,判定就被重新校准。整个校准循环就一句话:Jev 不确定时,把边界描述给它。
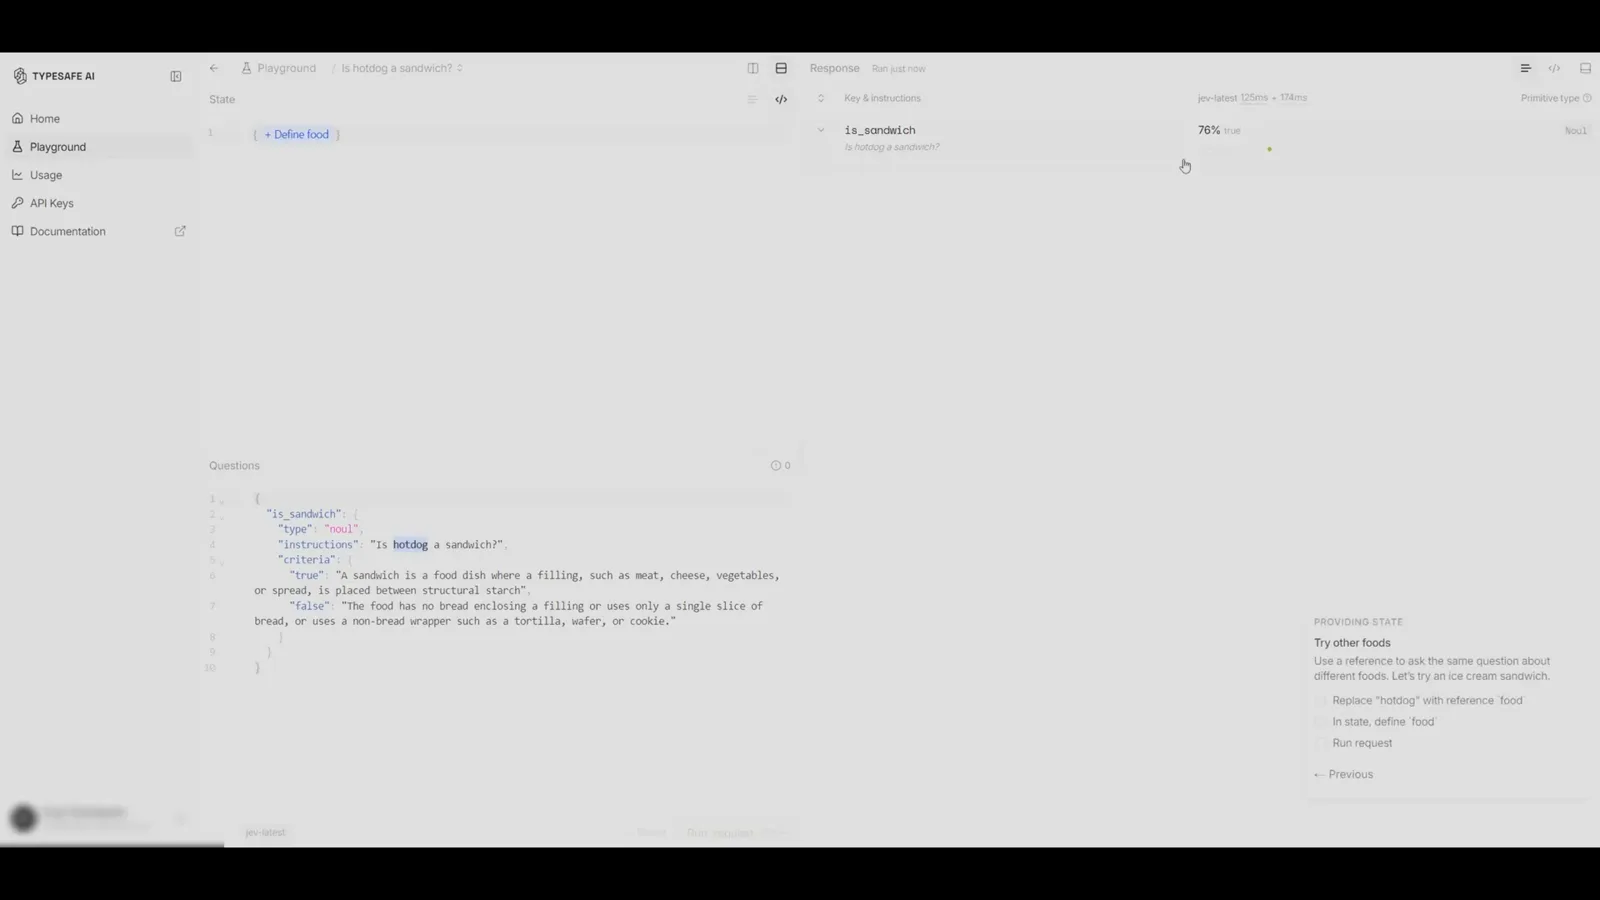
两句定义,把判定拉到 76%。跳转至 2:26 - 4
出正式题:一个 State、一道 Choice、八条立方体规则
主讲人把 76% 的三明治截图发给朋友,对方不服:「这是塔可。」于是他推倒重来。State 里先定义主体:{ "hotdog": "A food with a starch on 3 sides and a cylindrical meat filling." }(他还提醒这里也能塞随机场景)。问题换成 Choice,instructions 是「What is a hotdog?」,criteria 把立方体食物图里的八个选项全部写清:Cake(淀粉做结构、横向分层)、Calzone(六面全包)、Quiche(五面、开口容器)、Taco(三面——底部加两侧墙,顶部和两端开口)、Salad(零面)、Toast(一面、开放式)、Sandwhich(相对两面)、Sushi(四面卷成筒)。把每个选项描述清楚,答案才可核。
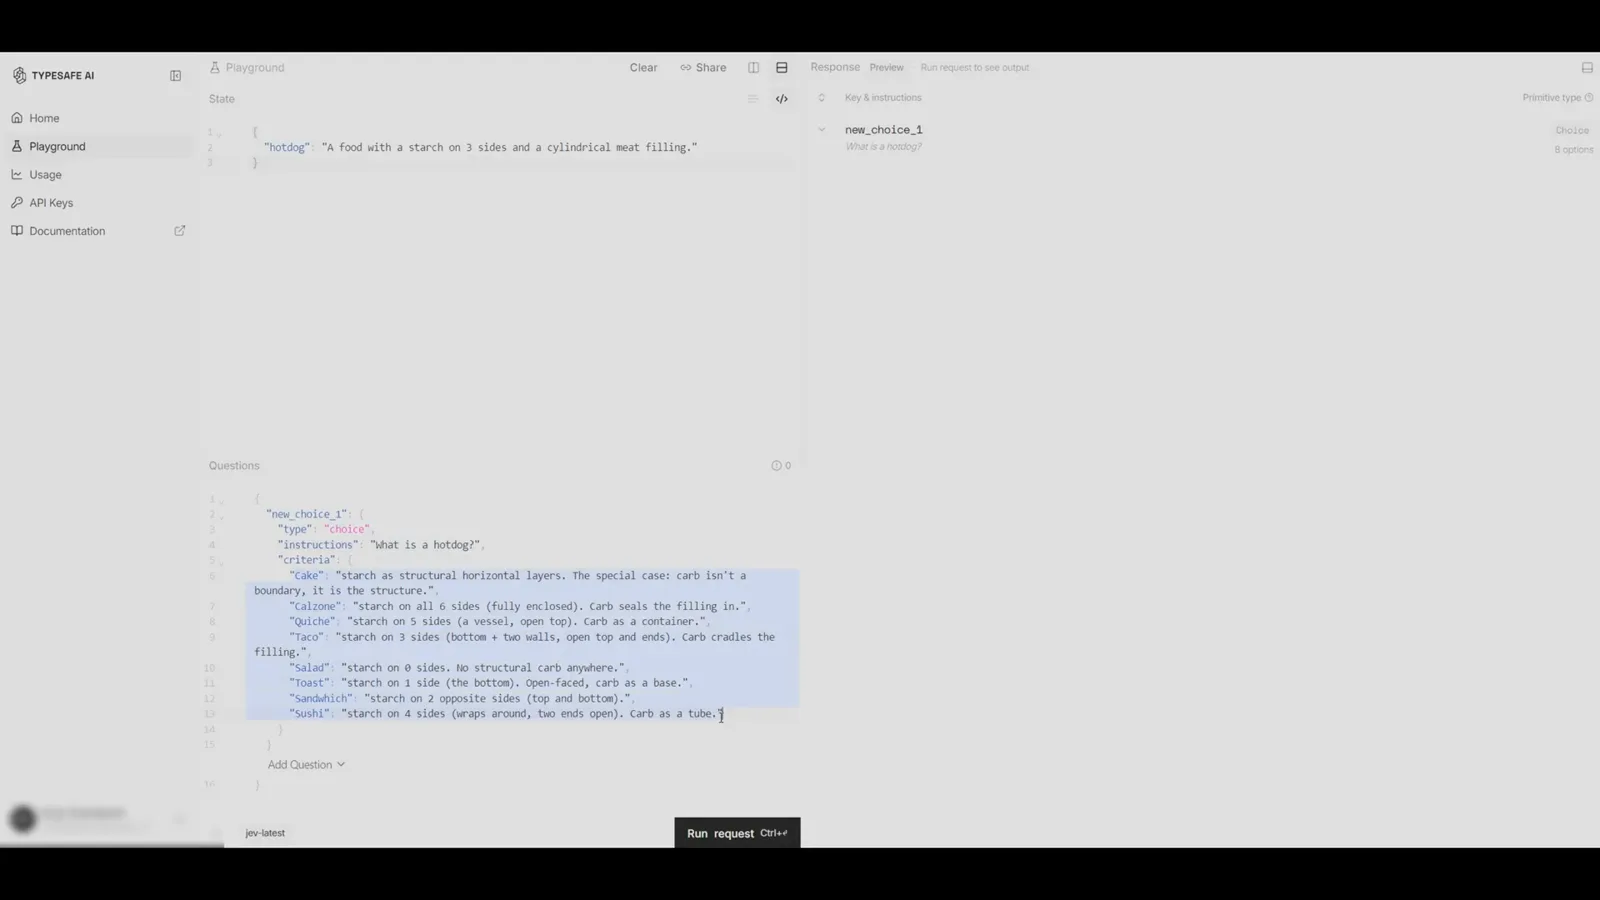
State 定义热狗,criteria 编码立方体规则。跳转至 3:24 - 5
出分:八个选项全排序,附整体置信度
响应面板把八个选项排成一列,而不是甩一段散文:Taco 94%、Sushi 5%、Sandwhich 1%,Cake、Toast、Salad、Calzone、Quiche 全是 0%,底部一行「Confidence: 93%」(这一跑落款 jev-latest 95ms + 186ms)。主讲人的原话:「这就是它和 LLM 不一样的地方——它给你一个扎实的格式。」重跑会有一两个点的抖动:他后面对比跑引的就是 96% taco。排序列表才是重点——你可以拿任何一条门槛做分支,不只看冠军。
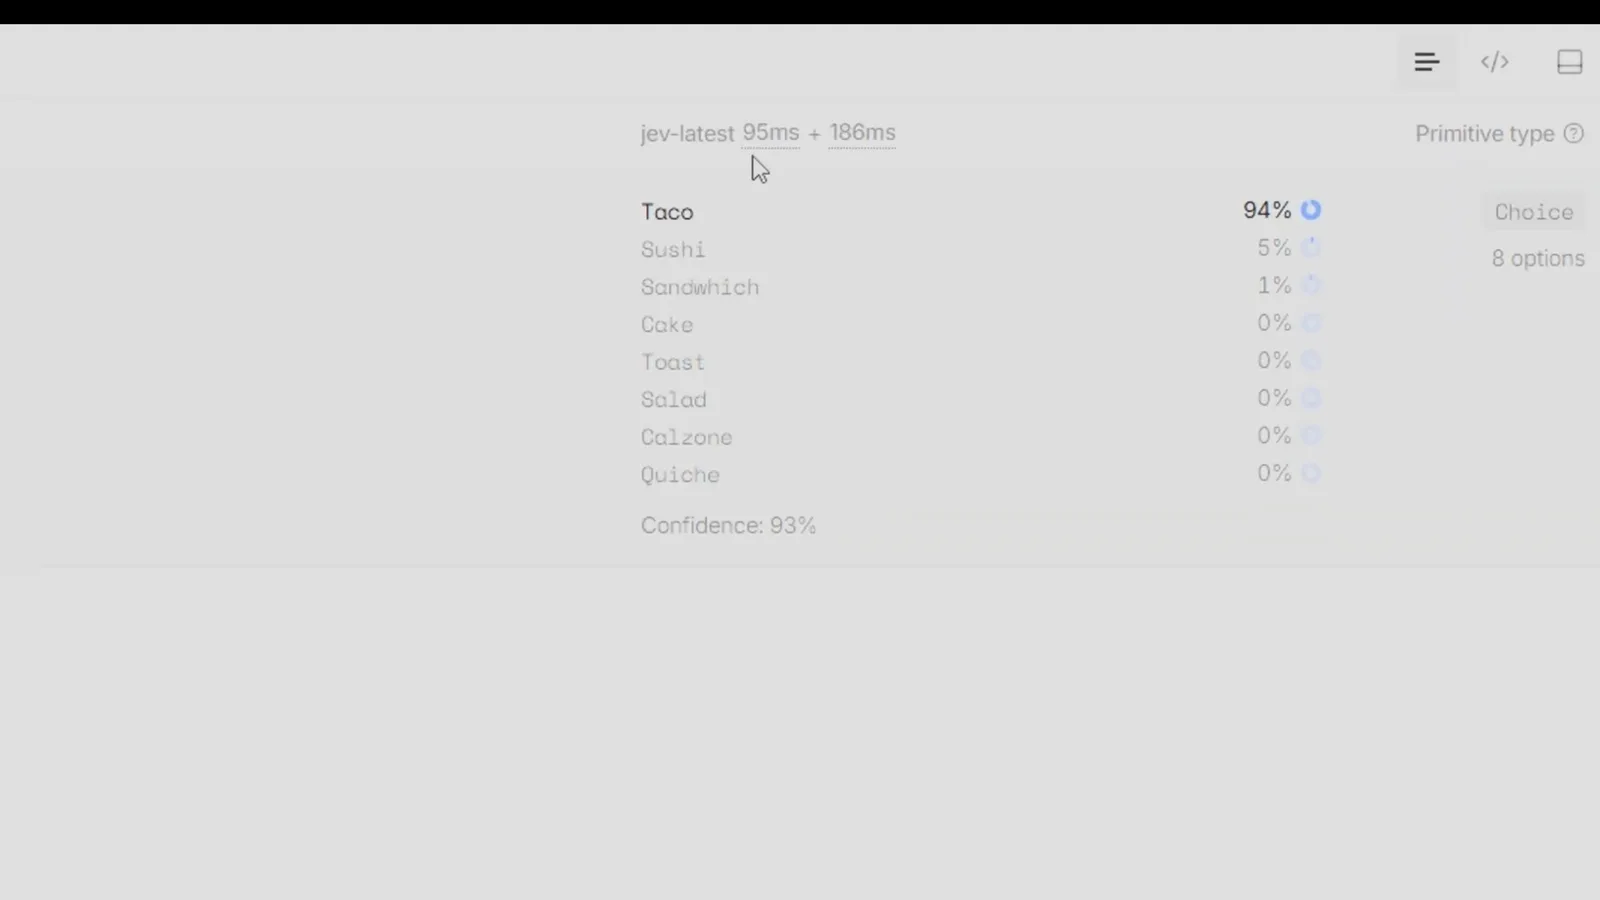
八个选项全排序,附一个整体置信度。跳转至 4:12 - 6
打开 JSON:输入 543、输出 84,输出免费
切到 JSON 视图,一次运行被拆得干干净净:"choice": "Taco"、"confidence": 0.93、八个选项的 "probabilities" 对象,然后是 "usage": { "input_tokens": 543, "output_tokens": 84 }、"request_id": "playground_…"、"evaluation_time_ms": 95.42。主讲人指出 token 数每次跑都一样——而账单结构才是卖点:「Jev 不收输出 token 的钱,这里也就是那 84 个。」整个判定约 95 毫秒。
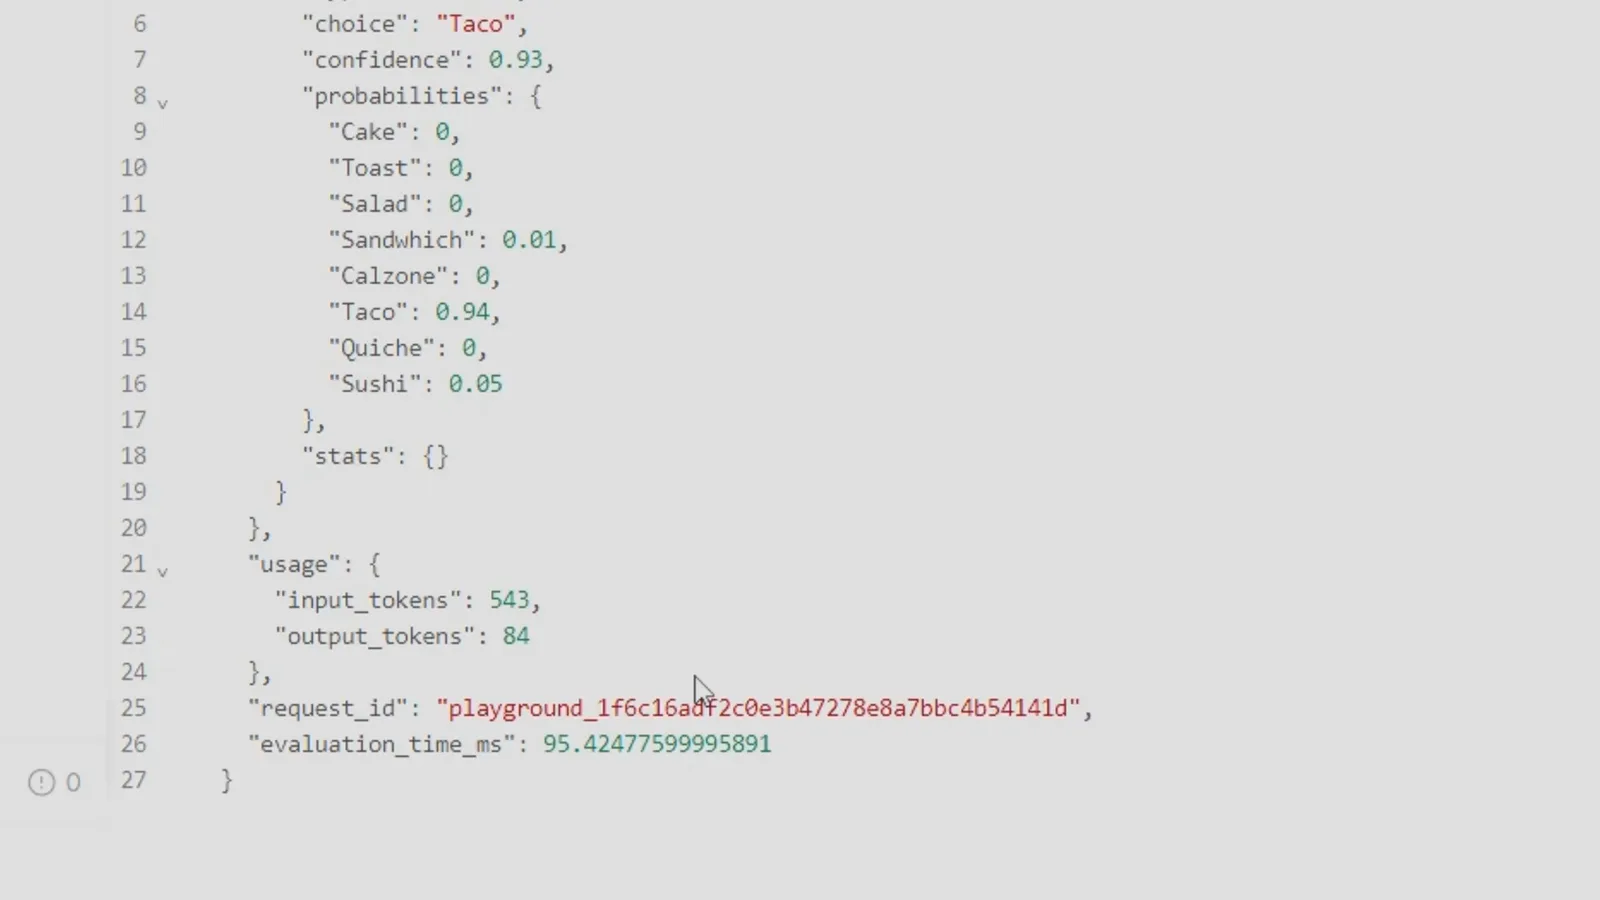
进 543 个 token,出 84 个——出的免费。跳转至 4:20 - 7
同一份提示词,抄进三家对手的 Playground
测速环节他把四个 Playground 铺在一屏——TypeSafe 左上、OpenAI 右上、Claude Console 左下、Google AI Studio 右下——把一模一样的提示词逐字粘进每家(他特别叮嘱「不能多一个空格」,还把提示词留在屏幕上供暂停抄写)。OpenAI 的 Configure 面板能看到提示词骨架:对每个选项的 criteria 逐一评估,所有选项概率之和必须等于 100,再报出最可能的单个选项和一个独立的 confidence(0–100)。模型选的是「默认、近乎免费」那档:GPT-5.6 Luna、Sonnet 5(claude-sonnet-5 下拉)、Gemini 3.7 Flash——后者还配了句 system instruction:「You are a classification engine, not a chatbot」。Jev 先跑:「我们都知道它多快——96% taco。」
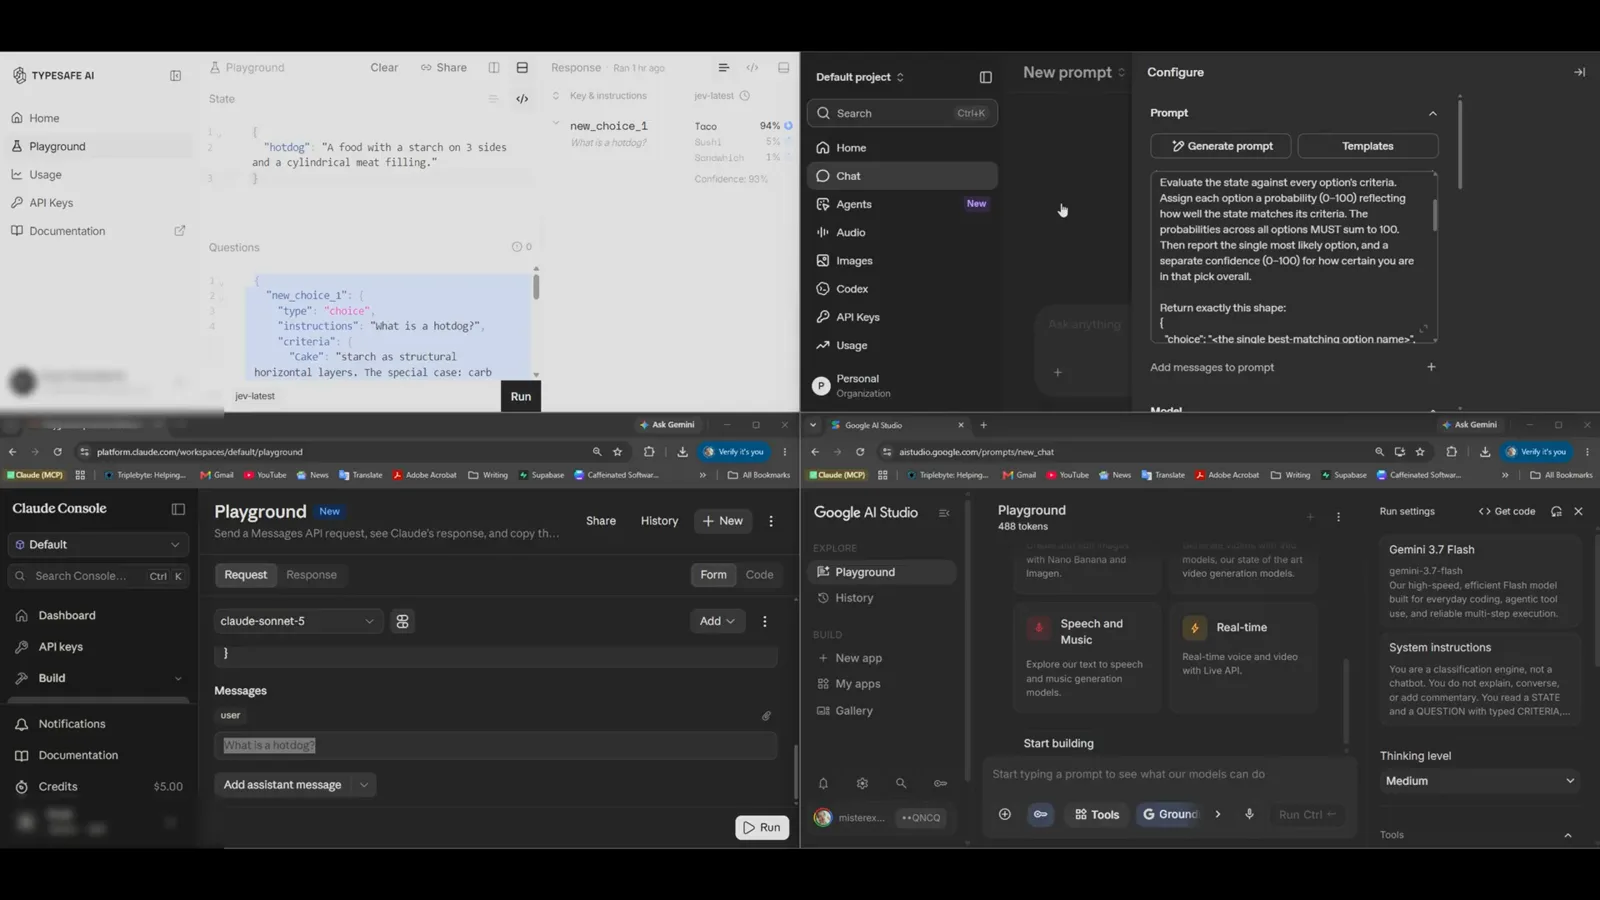
一份提示词、四个控制台、一个多余空格都不能有。跳转至 5:52 - 8
宣判:同一个决策在别家花多少钱
GPT-5.6 Luna 拉着思维链想了 4.1 秒,花掉约 577 个 token(445 进 + 132 出)——那 132 个输出 token 要收钱,而且照主讲人的说法,它给的概率是编的。Claude Console 里的 Sonnet 5 也判 Taco、confidence 88——工作台页脚写着 ≈ $0.0031,对应 674 进 → 173 出,约合三分之一美分,挂钟停在 6.1s。Gemini 3.7 Flash 是三家里最快的(按他的读数约 3 秒),烧了 495 进 + 100 出(共 595),还给出一个完美得可疑的 confidence 100。Jev 的同题成绩:543 进、84 出、输出分文不收,判定加全量排序约 95 毫秒。他的算盘:一天做几百万次这种决策的公司,每一个输出 token 都记在账上。
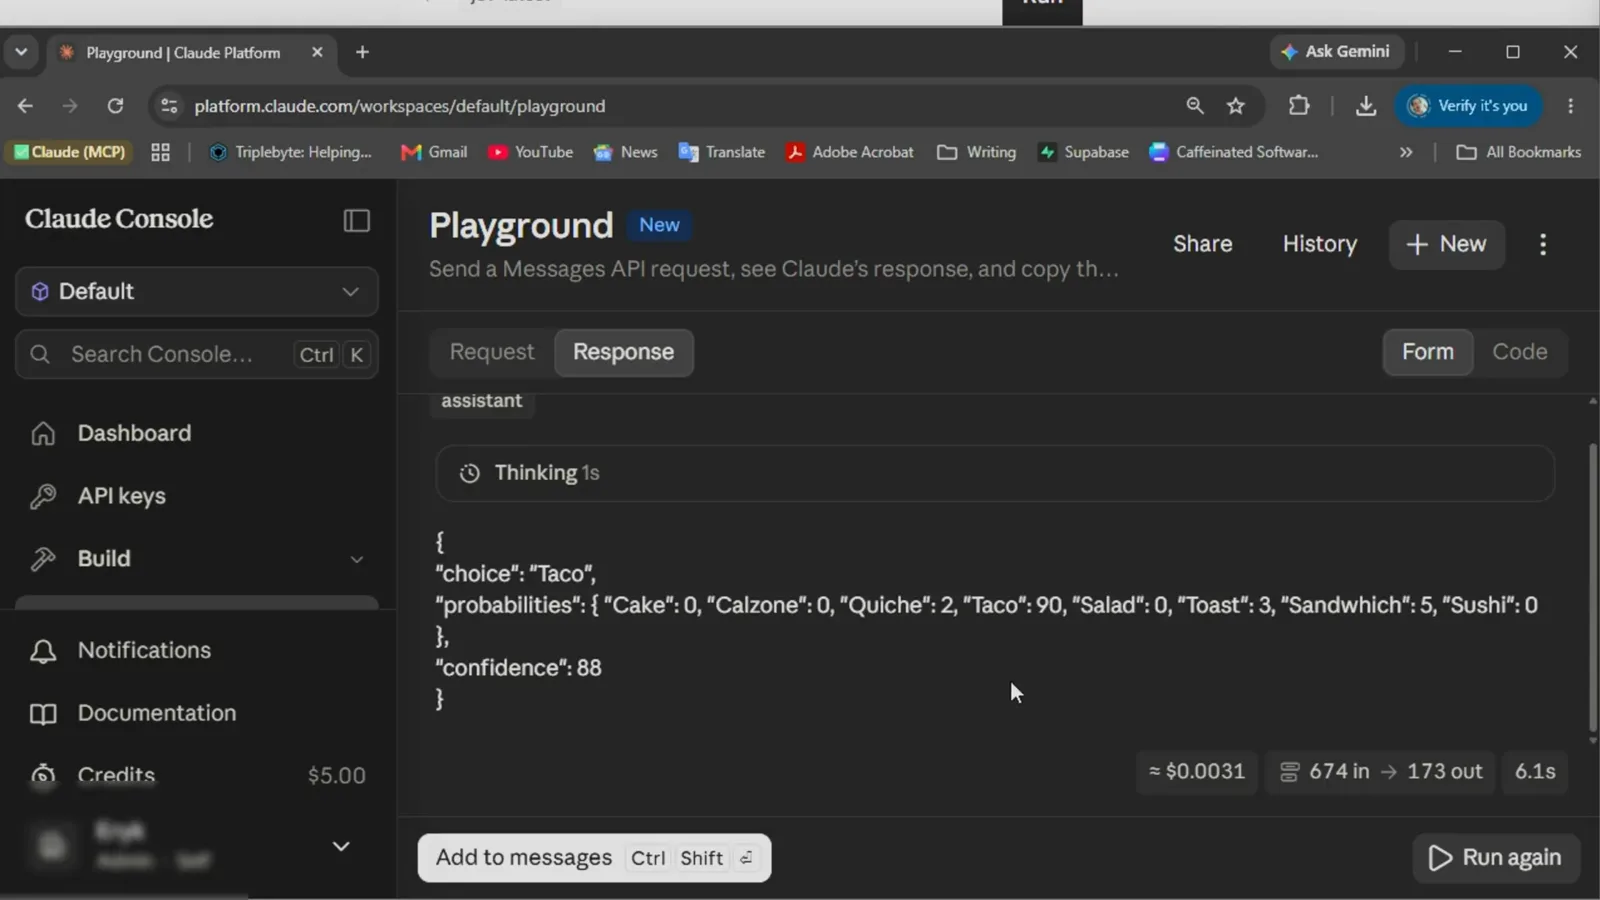
Sonnet 5 的塔可判决:约三分之一美分。跳转至 7:00
常见问题(FAQ)
不会写代码也能用 Jev Playground 吗?
可以——这正是这支视频的意义。TypeSafe 控制台的 Playground 全程靠面板操作:选一个原语(Noul、Score、Choice),改 State 和 Questions 的 JSON,点 Run request(Ctrl+Enter),读带置信度的排序答案。不用 SDK、不用 curl——主讲人不打开任何代码编辑器就跑完了整个热狗三明治练习,连 JSON 用量视图都看了。
怎么拿到 TypeSafe 控制台的访问权?
录制时 Jev 是邀请制:在 Join Our Waitlist 表单提交邮箱,做一份很长的问卷,然后等——主讲人的邀请几小时后就到了。他还推荐等待期间去项目 Discord 蹲着。进来之后,Playground 区就是本攻略用到的入门课程和自由编辑器所在地。
Noul、Choice、Score 有什么区别?
这是 Playground 暴露的三种问题原语。Noul 判断一件事有多真,0 到 1(热狗三明治课);Choice 从你定义的列表里挑(八选一的热狗分类);Score 按你给的评分规则打分(第三课 Can monkeys create art? 用的就是它)。选哪种类型,答案的形状就定成哪种。
做分类,Jev 真的比 ChatGPT 或 Claude 便宜吗?
就视频里这道题,账单是肯定的。Jev:543 输入 token、84 输出 token——输出免费。GPT-5.6 Luna:445 进 + 132 出(要付费),4.1 秒。Claude Console 里的 Sonnet 5:674 进 → 173 出,一跑约 $0.0031(三分之一美分)。Gemini 3.7 Flash:495 进 + 100 出。单次差距是几美分;按主讲人的算法,一天几百万次决策时它就是预算科目。
热狗答案为什么从 61% 变 76%,又从 94% 变 96%?
两回事。61% → 76% 是校准:补上 true/false 判据等于给了模型可对照的定义。94% 与 96% 的抖动是运行间方差——主讲人把同一问题重跑了几次,看着最高概率挪动一两个点才稳定,所以他的建议是看排序列表和 confidence,别只盯着冠军。
相关推荐
Jev Playground(在线实测)
在本站直接跑同一套 state + questions 工作流,无需注册控制台。
阅读Jev 新手入门攻略
SDK 路线:Playground 验证完决策,就该接进代码了。
阅读Jev Schema Builder
打开控制台前先设计 MECE 选项与行为化判据——本攻略的立方体 criteria 就是范本。
阅读Jev API 参考
每次 Playground 运行背后的 evaluate 端点与类型化载荷。
阅读什么时候该用 Jev
决策模型什么时候胜过 LLM,什么时候不值得用。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型