Guides / 视频转图文攻略
Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
最近更新: 2026-09-25
Prompt Engineering 频道演示 Jev 如何充当 RAG 管道中的可策略化重排器:criteria 写成可执行策略把 top-100 过滤成 top-5,策略一改排名就翻转,BM25 基线 21% 的 top-1 准确率提到 54%,成本随 chunk 增长几乎不变。
速览结论
RAG 管道到处是决策点——rerank、filter、cite——这期 11 分钟的视频让 Jev 接管 rerank 这一个。设定:候选片段由向量或全文检索返回,查询是「如何解决 API 的 401 unauthorized」,基于二元 Noul 原语的 Jev 重排器按写下来的 criteria 给片段打分——criteria 是可执行策略:true 是段落直接给出了问题所要的具体答案,false 是只共享词句或话题。因为标准是成文的,同一批语料在严格的 authoritative version two 和宽松的 fast workaround 两套策略下排出不同顺序——这是被时间冻结的 cross encoder 给不了的能力,也是 LLM 重排器付不起的价钱(Gemini Flash 账单随 chunk 尺寸近似线性上涨,Jev 几乎持平;顺序执行约 40 秒的一批决策用 64 个并发池 7.6 秒跑完)。基准上 BM25 的 21% top-1 准确率被重排拉到 54%——换成正常的 top-K(10–20 个片段)还会更高。
分步图文攻略
- 1
先找到 RAG 管道里需要策略的决策点
RAG 看起来是管道工程,视频开头却标出了三处真正的决策点:把检索结果从 top-100 收窄到 top-5 的 rerank、对片段通过或拦截的 filter,以及核查 LLM 最终答案引用的 cite。每个关卡本质上都是一次类型化决策,这正是 Jev 的用武之地。演示场景是一个文档系统,同时存在多个互相竞争的策略版本,系统必须在查询时做出取舍。失效方式很隐蔽:向量距离只能度量语义接近,不能度量业务逻辑下的正确性,所以官方 API 文档一更新——或者同一条查询其实需要深入架构讲解而不是一段可复制的代码片段——答案就在不知不觉里漂移。
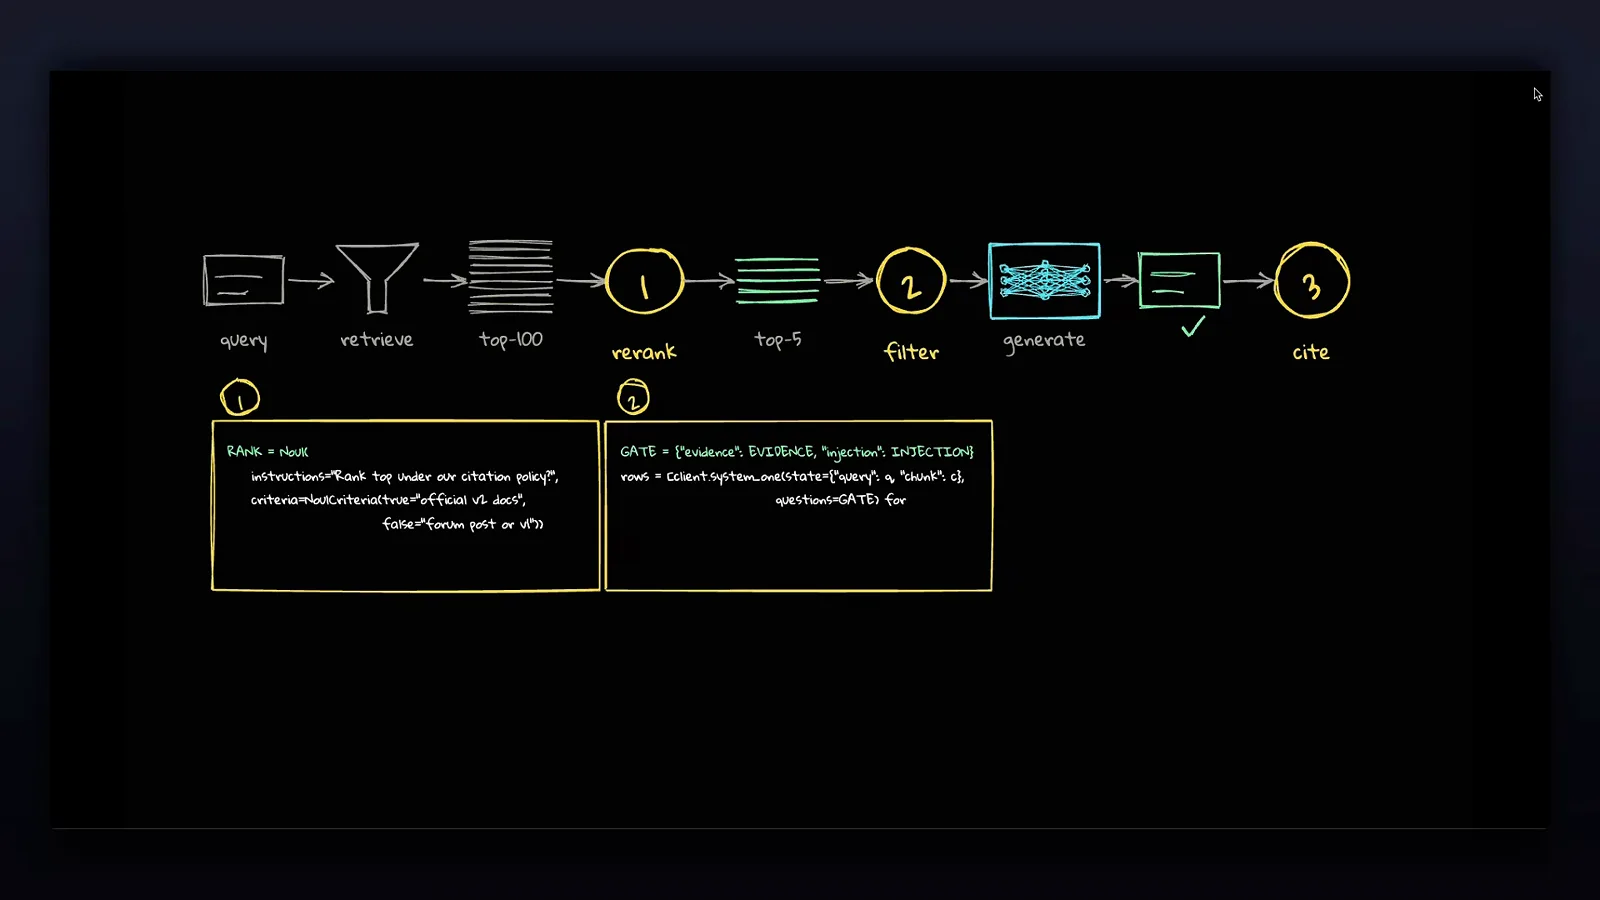
一条管道三个 Jev 决策点:rerank 打分、filter 把关、cite 核查。跳转至 0:48 - 2
三种重排器对比:冻结的、烧钱的、可策略化的
重排之前先认清 Jev 的三个原语:二元 true/false 分类器、按标准从多个选项里挑一个的 choice ranker、以及给不同选项打不同分数的 score ladder。重排会同时用到它们,而白板对比了三种可选工具。cross encoder 对「问题-片段」对打分,准确但听不懂指令——它被时间冻结,这正是组织策略变了、业务逻辑没变时它失效的原因。LLM 重排器能听指令,但贵得离谱且明显更慢。Jev 是第三条路:像 LLM 一样可策略化,成本却接近 cross encoder,策略变更因此从一次重新训练变成一次改配置。
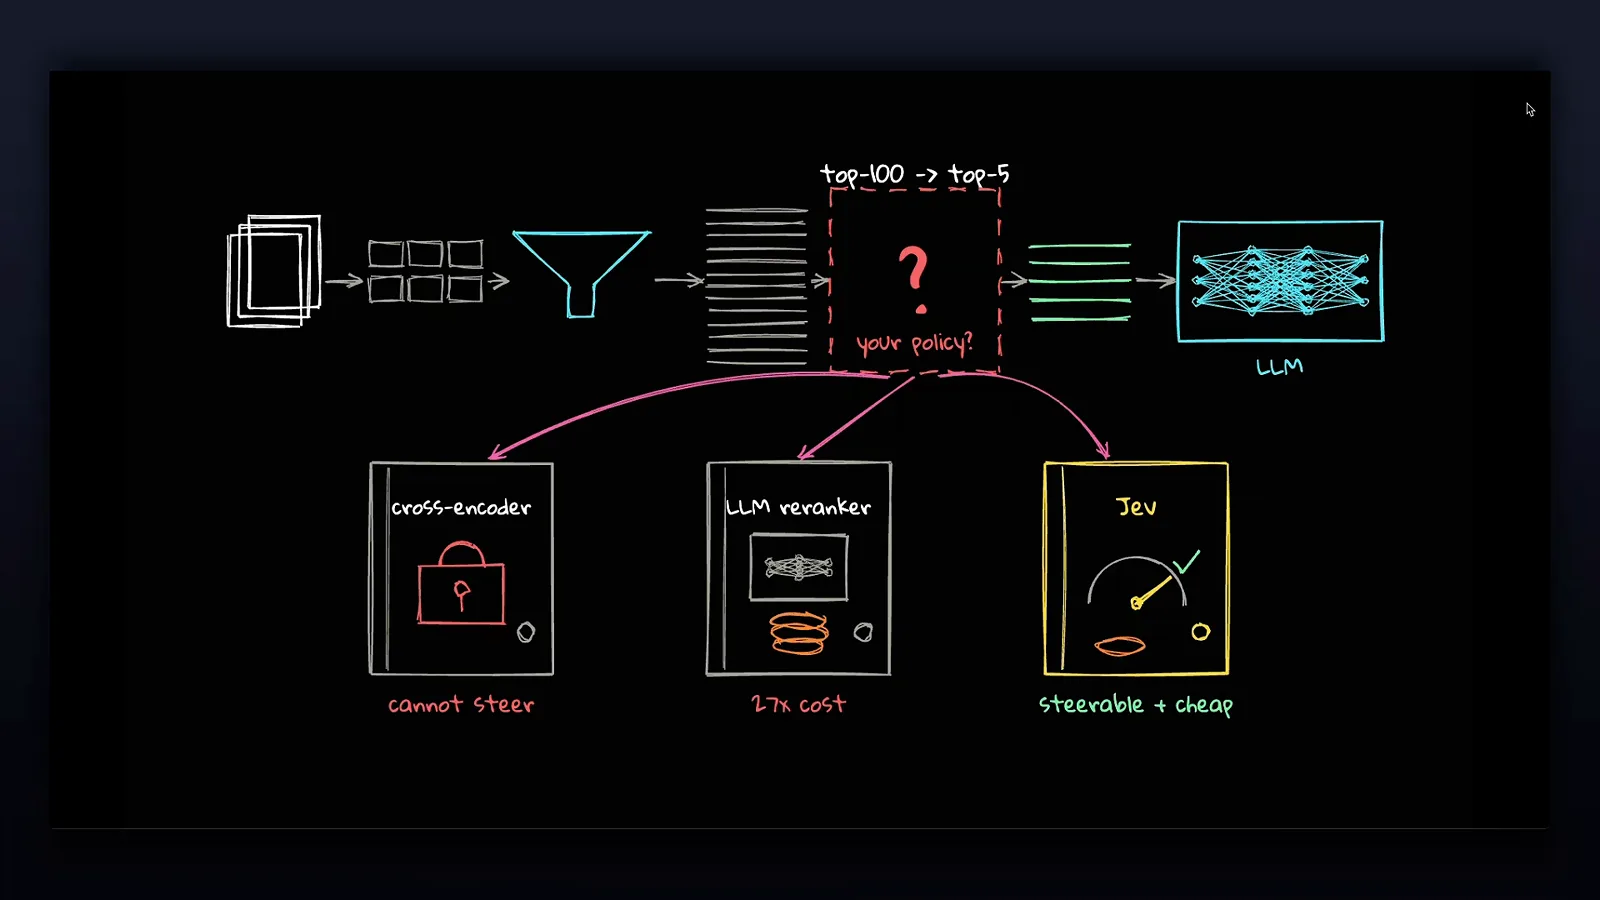
cross-encoder 不可策略化,LLM 重排烧钱——Jev 两条都占优。跳转至 2:11 - 3
把 criteria 写成可执行策略,而不是提示词建议
笔记本用官方 Python SDK(也可以走 REST API,注册送 5 美元额度)搭起重排器,核心是 Jev 的二元 Noul 原语——它返回校准过的概率,而不是自由文本。关键手法是把 criteria 当成可执行策略:不是软性的提示词指令,而是画出严格的决策边界——true 是段落直接给出了问题所要的那个具体答案,false 是只共享了词句或话题却没有回答。先跑四段文本做 sanity check——直接的退款答案、话题重叠、关键词命中、完全无关——直接答案拿到最高概率,其余分数很低,于是你得到了一个阈值分类器:高于阈值接受,低于阈值丢弃。吞吐也扛得住:同一批决策从顺序执行的约 40 秒缩短到用 64 个并发池的 7.6 秒。
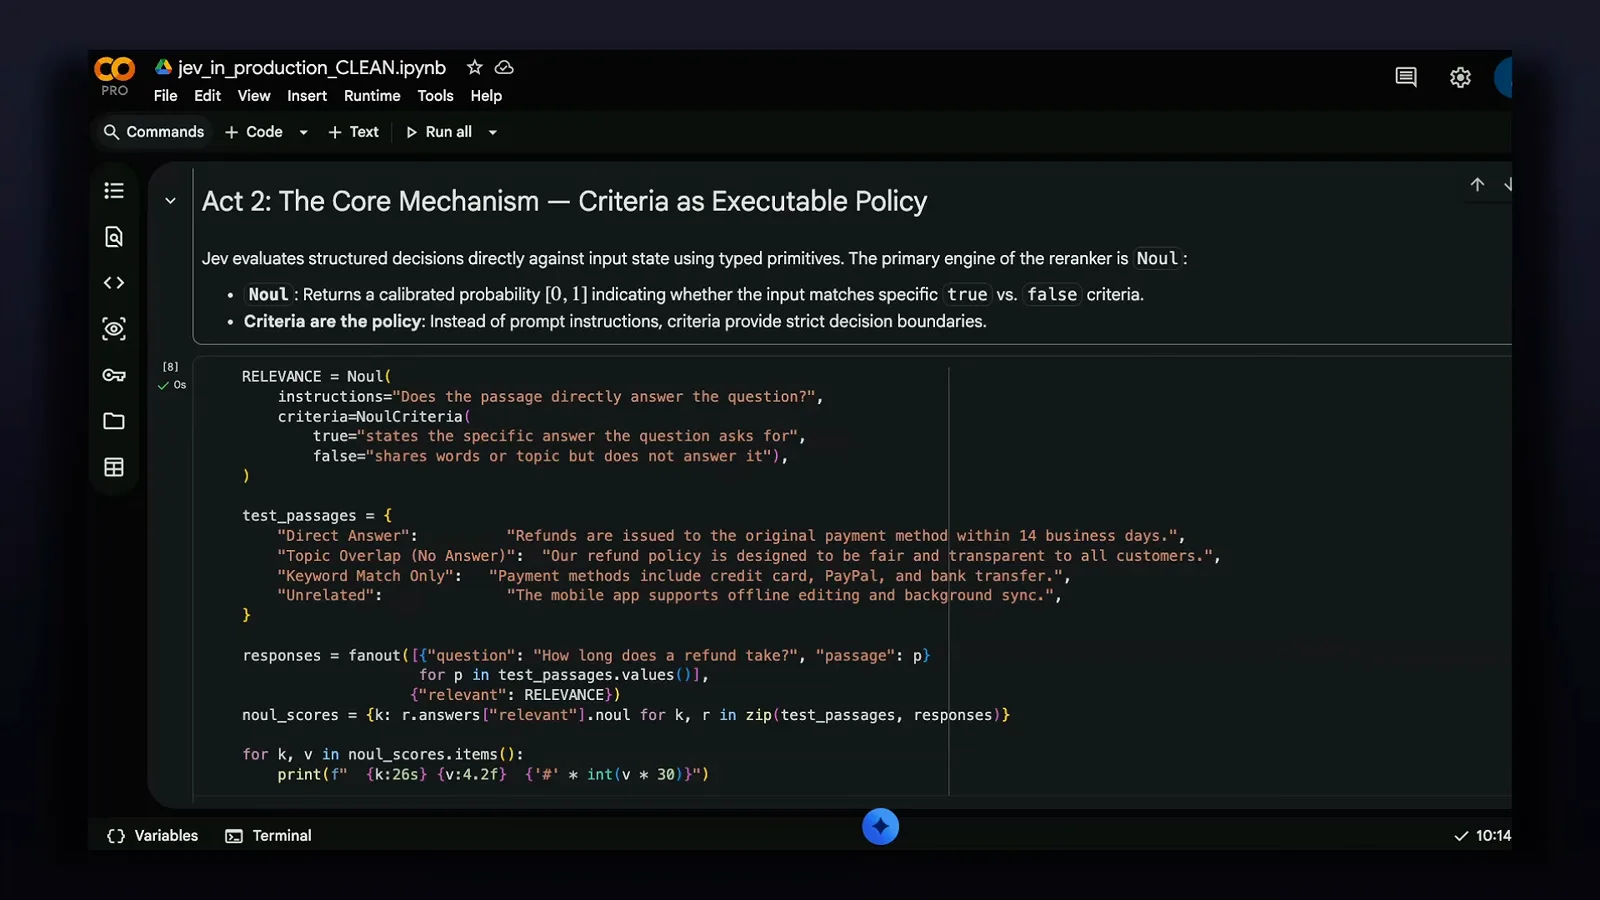
criteria 即可执行策略:严格的 true/false 边界,不是提示词建议。跳转至 5:52 - 4
两套策略,让同一批语料排出两种顺序
基准查询故意选得很日常——如何解决 API 返回的 401 unauthorized——候选片段来自向量检索或全文检索,带普通元数据。重排器随后在两套成文策略下运行:严格限定来源的 authoritative version two,以及刻意宽松的 fast workaround。条形图就是回报:同样八个候选——来自官方文档、Stack Overflow、博客和论坛的 v1/v2 页面——在两套策略下排出不同的顺序。这就是可策略化重排器的全部意义:排序跟着你写下的 criteria 走,切换组织对「最佳答案」的定义只是一行改动,而不是换一个模型。
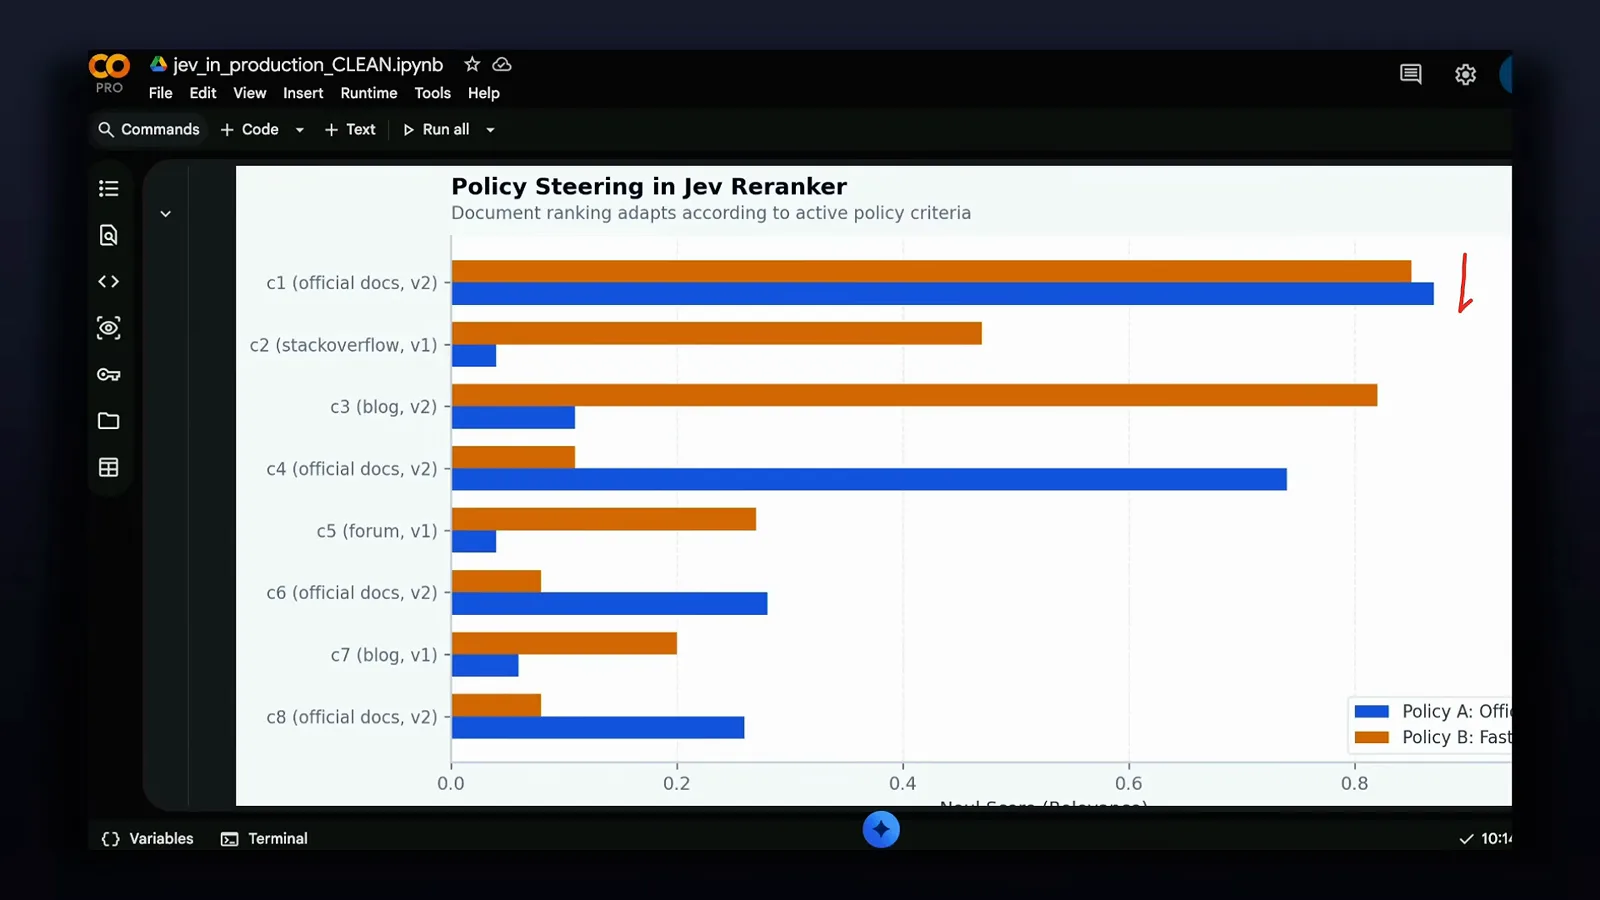
同样八个候选,两套策略,两种排序——可策略化的直接证据。跳转至 8:20 - 5
给重排算笔账:水平线对阵线性上涨的 LLM 账单
成本基准把 Jev 和充当 LLM 重排器的 Gemini Flash-Lite、Gemini Flash 放在一起,跑同样的提示词和查询。chunk 小的时候,Jev 的成本和延迟都贴近 Flash-Lite;但 chunk 一大两张图就分道扬镳:LLM 的成本曲线随 chunk 长度近似线性爬升,Jev 几乎保持水平——视频特意点明,大 chunk 正是这套方法真正发光的地方。吞吐和单价同样重要:并发测试里顺序执行就有每秒约 17 次决策。实际含义是:你付得起每一次请求都重新给整份候选列表打分的钱,而且账单不会因为检索出更长的段落而失控。
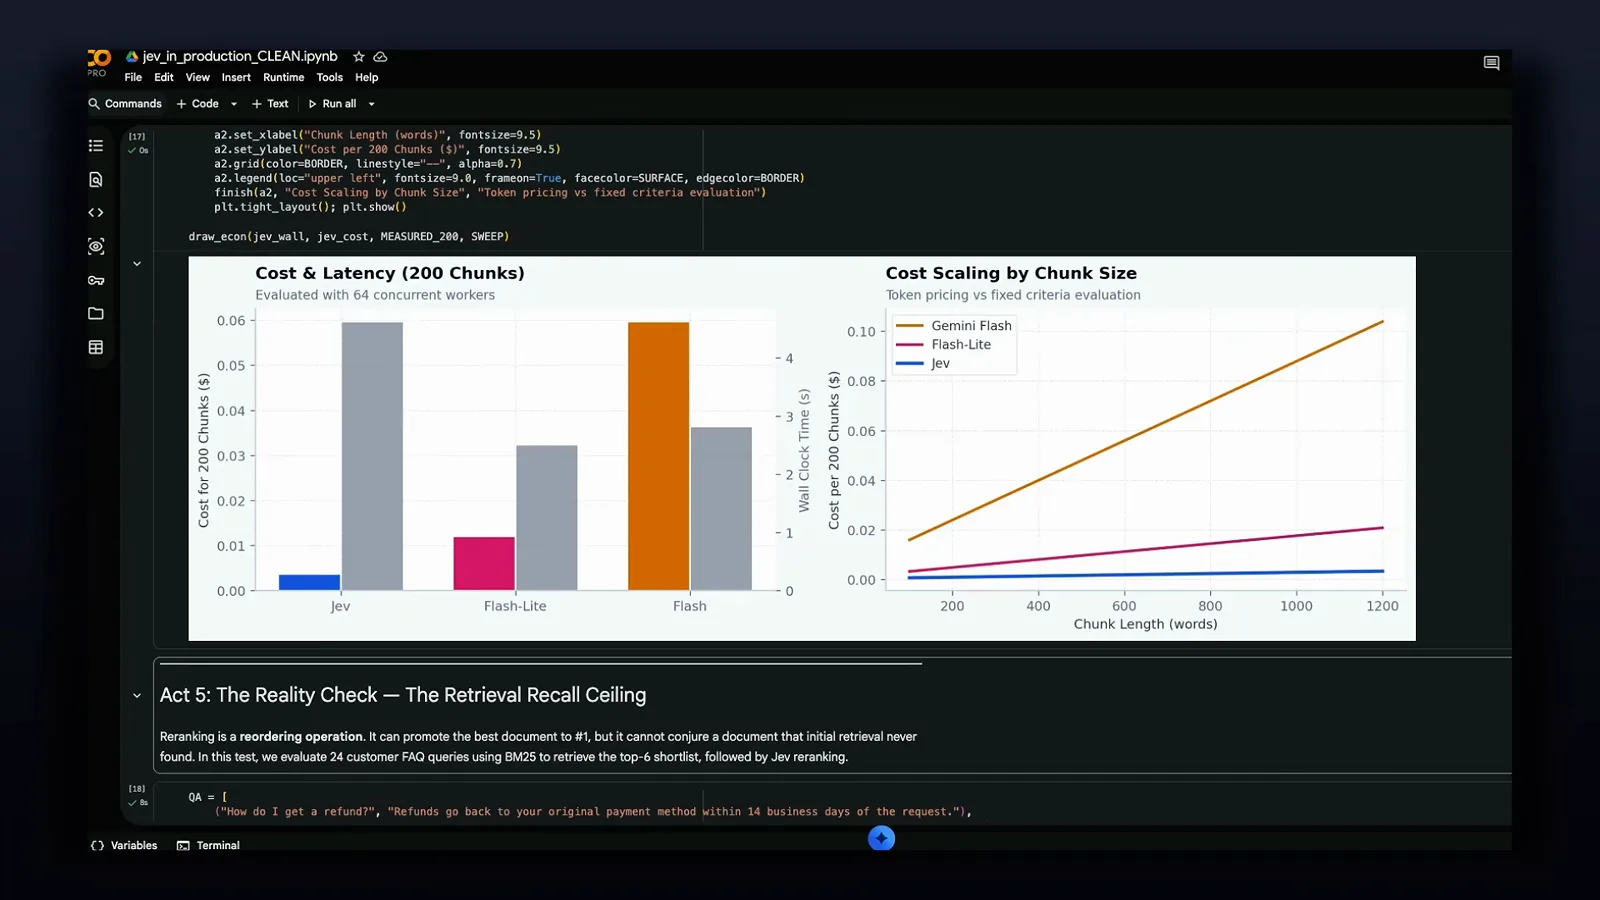
chunk 越大差距越大:Jev 几乎持平,Gemini 重排成本线性上涨。跳转至 9:20 - 6
看清天花板:top-1 准确率从 21% 到 54%
最后一张图是现实检验。BM25 全文检索基线只有 21% 的查询被 top-1 片段答对;加上 Jev 重排器后 top-1 准确率升到 54%——视频也提醒这是最苛刻的指标,正常的 top-K(10 到 20 个片段)场景下分数会高得多。图表副标题藏着第二个洞见:重排器保持了 100% 的候选召回,剩下的错误都由初始检索决定,而不是重排器。收尾论点跳出重排本身:现有工作流里任何需要做决策的位置——rerank、filter、cite、校验——都可以把 Jev 直接插进去,而且决策不限于二元。
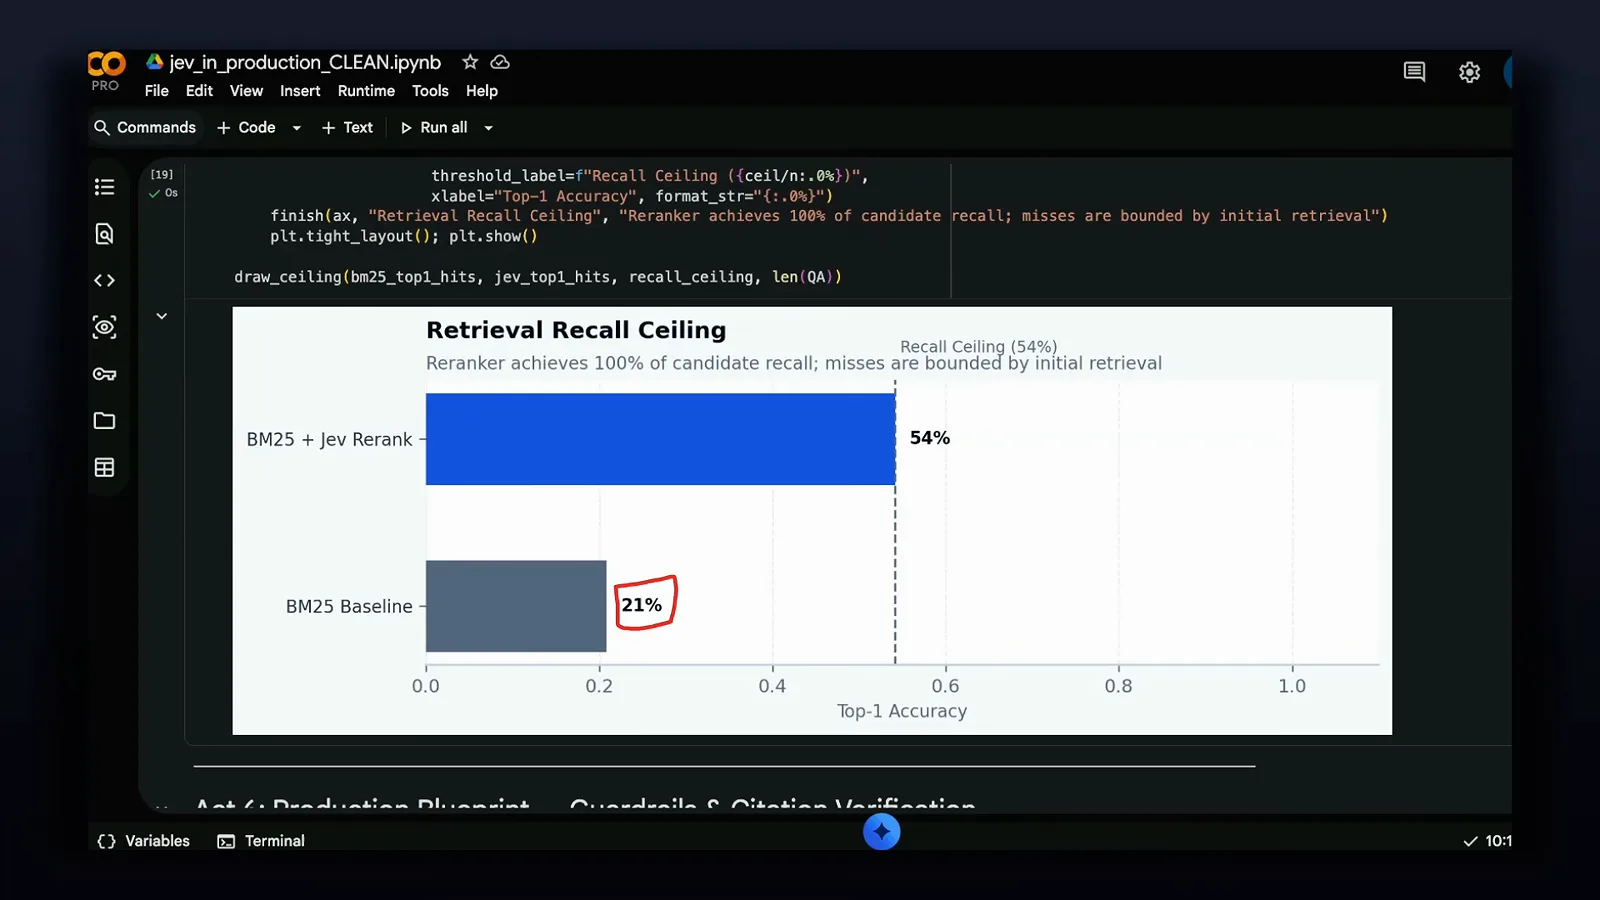
top-1 准确率:纯 BM25 只有 21%,加 Jev 重排到 54%。跳转至 10:17
常见问题(FAQ)
Jev RAG 重排器是什么?
指在重排环节用 Jev 的二元 Noul 原语给每个检索片段打分:它返回「该段落直接回答了查询」的校准概率,而不是自由文本。和 cross encoder 不同,它听得懂指令,排序执行的是你的业务策略;和 LLM 重排器不同,chunk 变大它的成本几乎不涨。
为什么不直接用 cross encoder 或 LLM 做重排?
cross encoder 只能度量问题与片段的语义接近,听不懂指令——所以当策略变了、业务逻辑没变时它恰好失效。LLM 重排器听得懂指令但贵得离谱也更慢,成本随 chunk 尺寸近似线性上涨。Jev 把「听指令」和「接近 cross encoder 的成本」放进了同一个方案。
策略化是怎么改变排序的?
你把 criteria 写成可执行策略——视频里是一套严格的 authoritative version two 和一套刻意宽松的 fast workaround。同一批候选片段在两套策略下排出不同顺序,切换组织对「最佳答案」的定义只需要改 criteria,不需要重新训练模型。
Jev 重排能带来多少准确率提升?
视频基准里,BM25 全文检索基线的 top-1 答对率只有 21%,加上 Jev 重排器后升到 54%。图表还注明重排器保持了 100% 的候选召回,剩余错误都由初始检索决定——换成正常的 top-K(10 到 20 个片段)准确率还会更高。
Jev 重排跟得上生产流量吗?
可以。并发测试里顺序执行就有每秒约 17 次决策——整批跑完约 40 秒;换用 64 个并发池后同一批 7.6 秒跑完,足以支撑每次查询都重新给 top-100 候选列表打分。
相关推荐
Jev Model Router 指南
同一套 Choice、Score、Noul 原语驱动的隐私门控模型路由器。
阅读LLM 降级策略
决策返回低置信度时的置信度降级模式。
阅读Jev API 参考
Noul 重排调用背后的 evaluate 端点与类型化问题。
阅读Jev 是什么
跳出 hype,看清二元、选择、打分三个原语。
阅读Jev Playground
亲手写一套 criteria,看排名当场翻转。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
- Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
- Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
- Jev 接入 Codex 实操:typesafe-ai/skills 安装与 Gmail 30 封邮件分诊
- Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
- 自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
- CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
- 用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门
- Ollama 决策模型实测:tev1 + nimble 跑在 8GB 显卡上
- Jev 生产环境护栏:五步接入实战手册
- Pi Agent 防跑偏插件实战:让 Jev 出概率,让代码做决定
- Tev1 用例实测:50 个任务看尽本地决策模型的能力边界
- Jev 实测:官方宣称与独立复测之间的距离
- Jev 工单分类实战:after-insert hook 与计算字段两种接法
- OpenJev RLCD 实操:开源校准决策模型本地部署全指南
- Clef-Flash vs Jev 实测:把 Cloudflare 决策模型装进 Ollama(Q4_K_M)
- Clef-Flash 实操教程:在 Ubuntu 上从零安装并本地运行 Cloudflare 9B 多模态决策模型
- CLM-8B 架构深潜:44 毫秒打分 1,024 个候选的对比决策模型(比 Jev 快 13 倍)
- Nox 4B 实测教程:本地跑通 Decision 2.0 决策模型,四道真实考题与一次诚实的失败
- Julia-1 实操教程:纯 Python 装上开源 Jev 替代品,10 条客服消息实测 9 比 2
- OpenJev 0.8B CPU 实战:用工单收件箱校准 NLI 路由阈值
- Jev n8n 集成实战:JevGate 社区节点分步攻略(附纯 HTTP 备选路线)
- NanoJev 实操教程:本地部署 0.6B 开源 Jev 复刻,亲眼看它以 47ms 跑迷宫、按概率做路由
- PPLX Decider 实操教程:Perplexity 开源 27B 决策模型、Decisions API 与 12 张工单的分诊实测
- AutoTrust JEV-27B 本地实测:四臂对照、72 道 held-out 题,和一个 0.969 高分的错误答案
- Clef 27B 本地实战:Cloudflare 多模态决策模型一次读懂图片、视频和乌兹别克语报纸
- Ollaya 实操指南:装好「决策模型界的 Ollama」,看清每一个厂商口径数字,再亲手补上它留白的 CPU 实测
- Strands Decider 2B 实测:8GB 笔记本本地安装 AWS Strands 系决策模型,把失败段也留在这页里
- Liquid AI Open d1 本地实测:d1-3B 与 d1-omni-600M 跑进 MacBook Air M5
- 图像决策模型实战 RPA:Imajev-4B 与 Jev-Omni 无 OCR 直读 W-8BEN 税表,90% 置信阈值以下转人工审核
- GLiNER2.5-Decide (340M) 对比 Jev (4B):决策模型到底谁赢?逐帧核对选型指南
- Jetson 边缘实测:Jev、Strands Decider 2B、Laya、d1-3B 四模型横评——Skill Master 记分卡、Thor 延迟账与 JevBench 逐帧核对
- 微软 Decision-1 实测:146 道独立测试、93% 均分、高置信时 124/125——每个数字逐帧核过
- Jev 接入 Azure AI Foundry 实战:OpenAPI 工具、分诊指令与首跑失败复盘