
Guides / 视频转图文攻略
自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
逐帧拆解 Micah 的 4:54 实操:把一个大 45 倍的教师模型蒸馏进 Qwen3 0.6B 学生模型,用 1000+ 个 Doom 局面做两分钟训练,看未见回合的采纳率从约 50/100 涨到 93/100,再用置信度门控自动化——单卡跑到每秒 12 次决策。
速览结论
Typesafe 的 Jev 之所以能打 Doom,是因为它接收「局面 + 三个选项」,瞬间返回概率——完全不生成文本。Jev 本体闭源还要排队等位,但这个形状在家就能复刻:Micah 开源的 openjev 管道把一个大 45 倍的教师模型蒸馏进 Qwen3 0.6B 学生模型,训练集是 1000+ 个录制的 Doom 局面,训练只要约两分钟、一张显卡。训练前学生自称 95% 置信却和教师一半时间不一致;蒸馏后,未见回合的答案采纳率从约 50/100 涨到 93/100——置信度从此可以当自动化闸门:有把握的直接执行,存疑的交给更大的模型或人。教师每题要想约 9 秒,学生约百分之一秒(快约 900 倍),局内每秒 12 次决策。诚实边界:它只认识训练过的那一个 Doom 房间;开源复刻在 TypeSafe 自己公布的测试集上仍比 Jev 低几分。
分步图文攻略
- 1
先看清形状:类型化答案一次全回来,不是聊天流
视频开场是分屏终端。TYPE 一侧,所有答案和概率在一次响应里全部到位——没有生成过程可等。LLM 一侧,客户端停在「waiting for first token」,一个字没吐出来之前什么都解析不了。这就是全部前提:决策模型接收局面和答案列表,给每个选项返回一个百分比——所以它能每秒做出 12 次决策,聊天循环做不到。
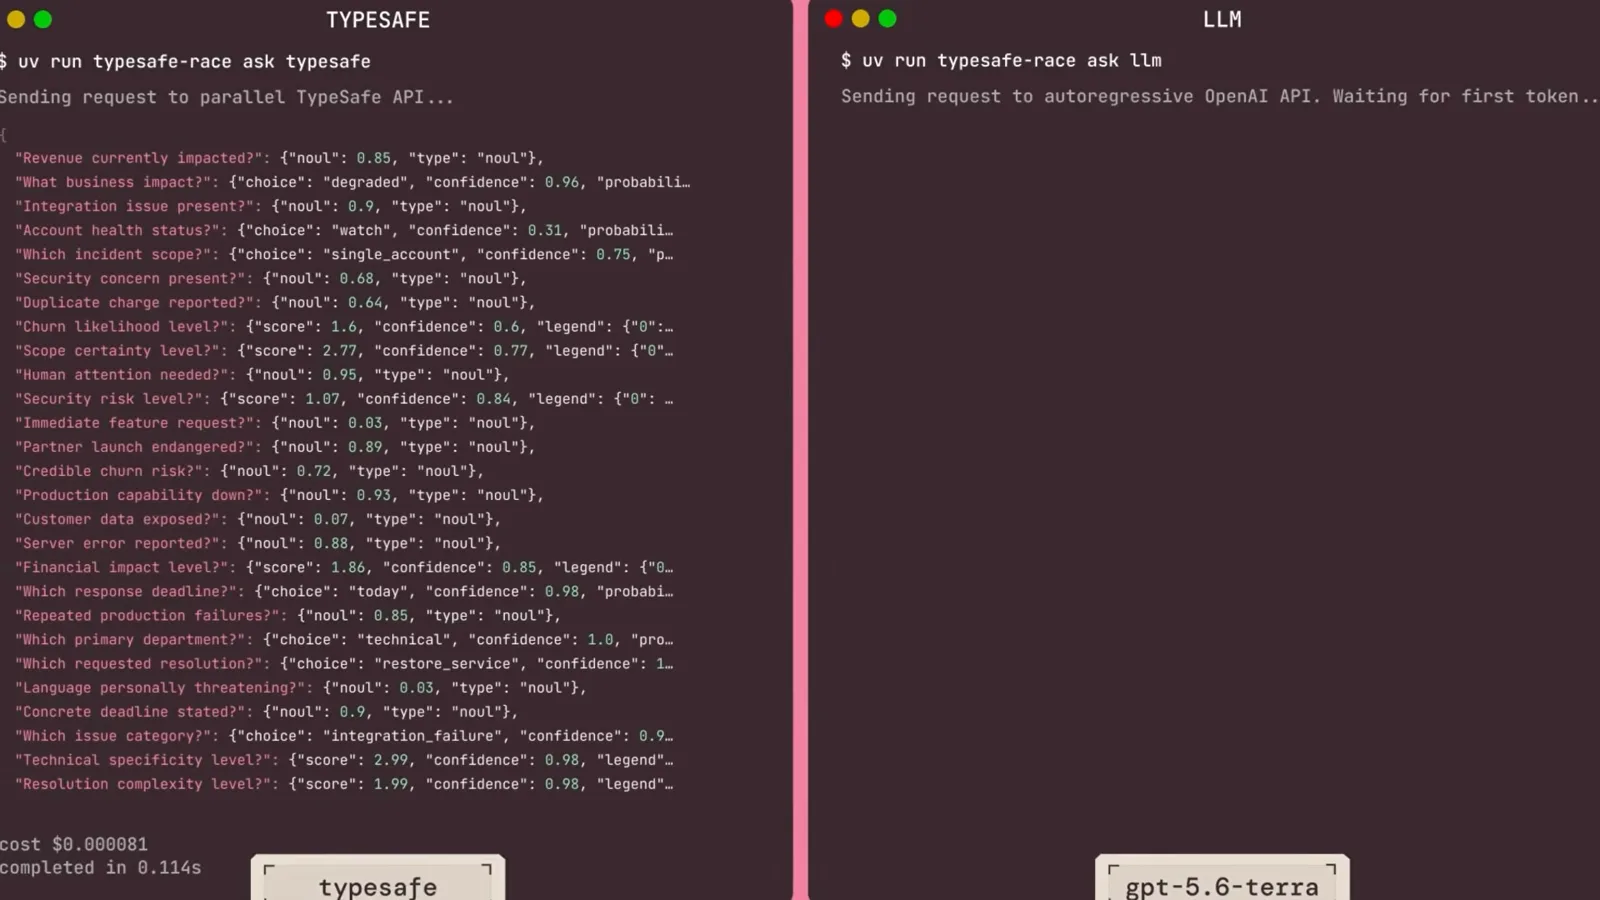
决策一次响应完整返回——没有 token,没有流。跳转至 0:10 - 2
喂给模型的是 state 加一句自然语言写的策略
模型读的不是 prompt,而是 state 数据块。绿色面板把 Doom 局面写成数据:敌人类型、武器有效射程、以地图单位计的玩家体积、移动上下文,还有一句自然语言策略("point blind ambushing, slow reload"——目标进视野前先瞄,够近才开火)。与 state 一起送进去的还有三个问题:瞄哪个敌人、该不该扣扳机、该不该闪避。模型一次前向给所有问题的所有选项打分。
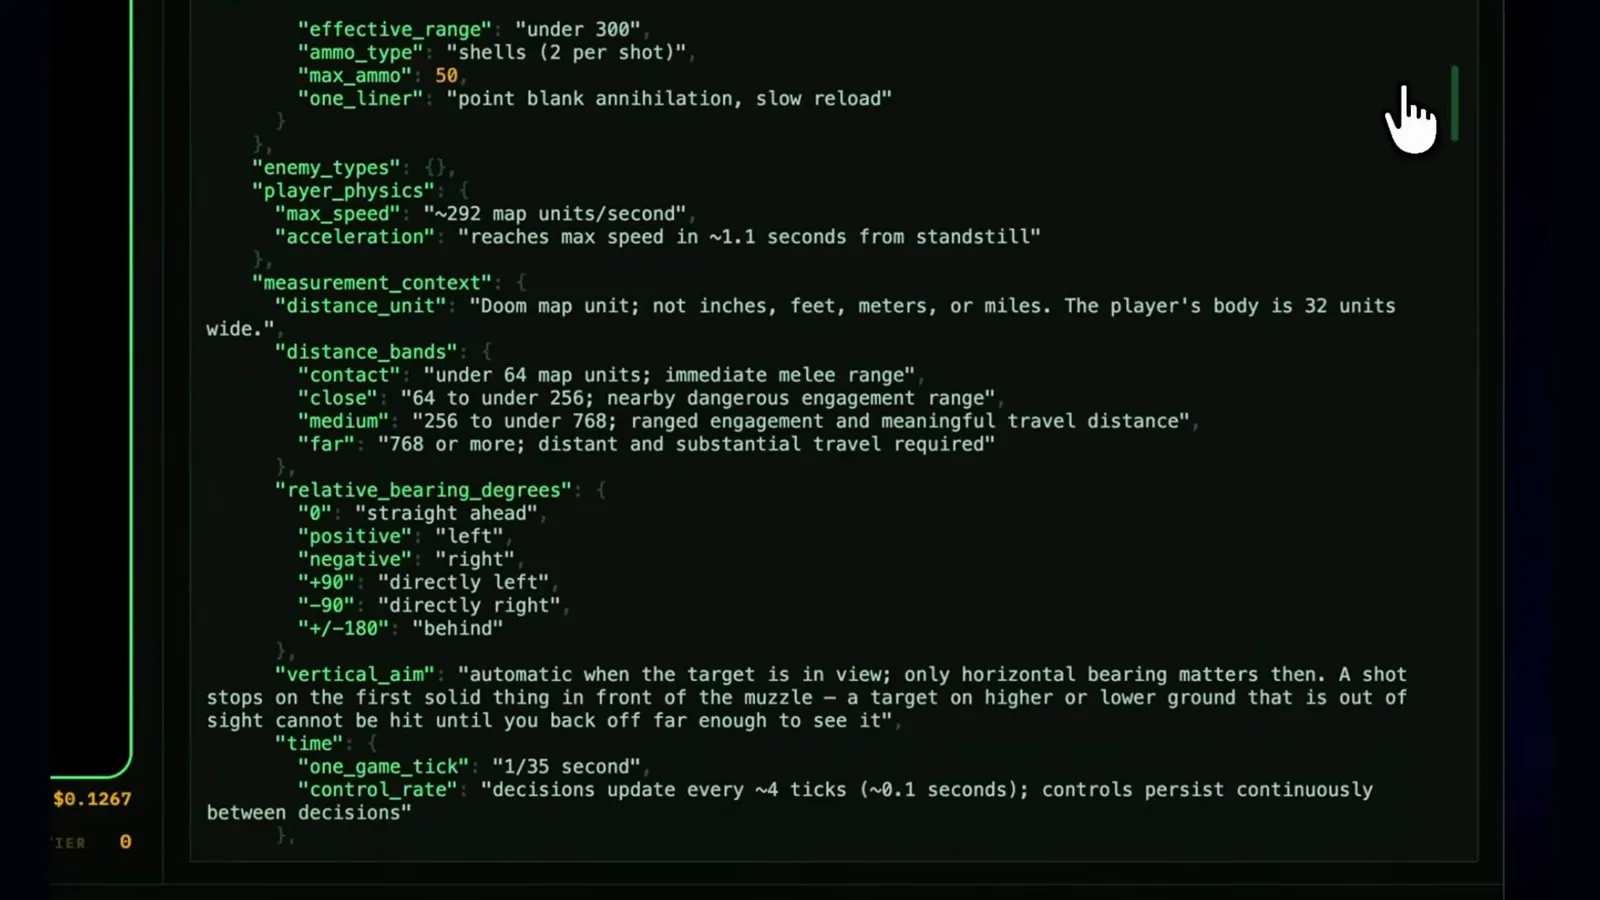
state 是数据,策略是一句话——和问题一起送入。跳转至 1:38 - 3
用带标注的百分比教学生,而不是靠 prompt
小模型答得快但答得烂——没训练过的版本从来不知道躲火球,半分钟就死。解法是蒸馏:一个大 45 倍的教师模型对 1000+ 个录制的 Doom 局面逐题作答,给每个选项标上置信度百分比;学生被训练去复现这些百分比。训练记录终端展示了一条标注样本的样子:问题、选中标签、教师的打分。整个训练在一张显卡上约两分钟,连同 Doom 本体全部可以免费下载。
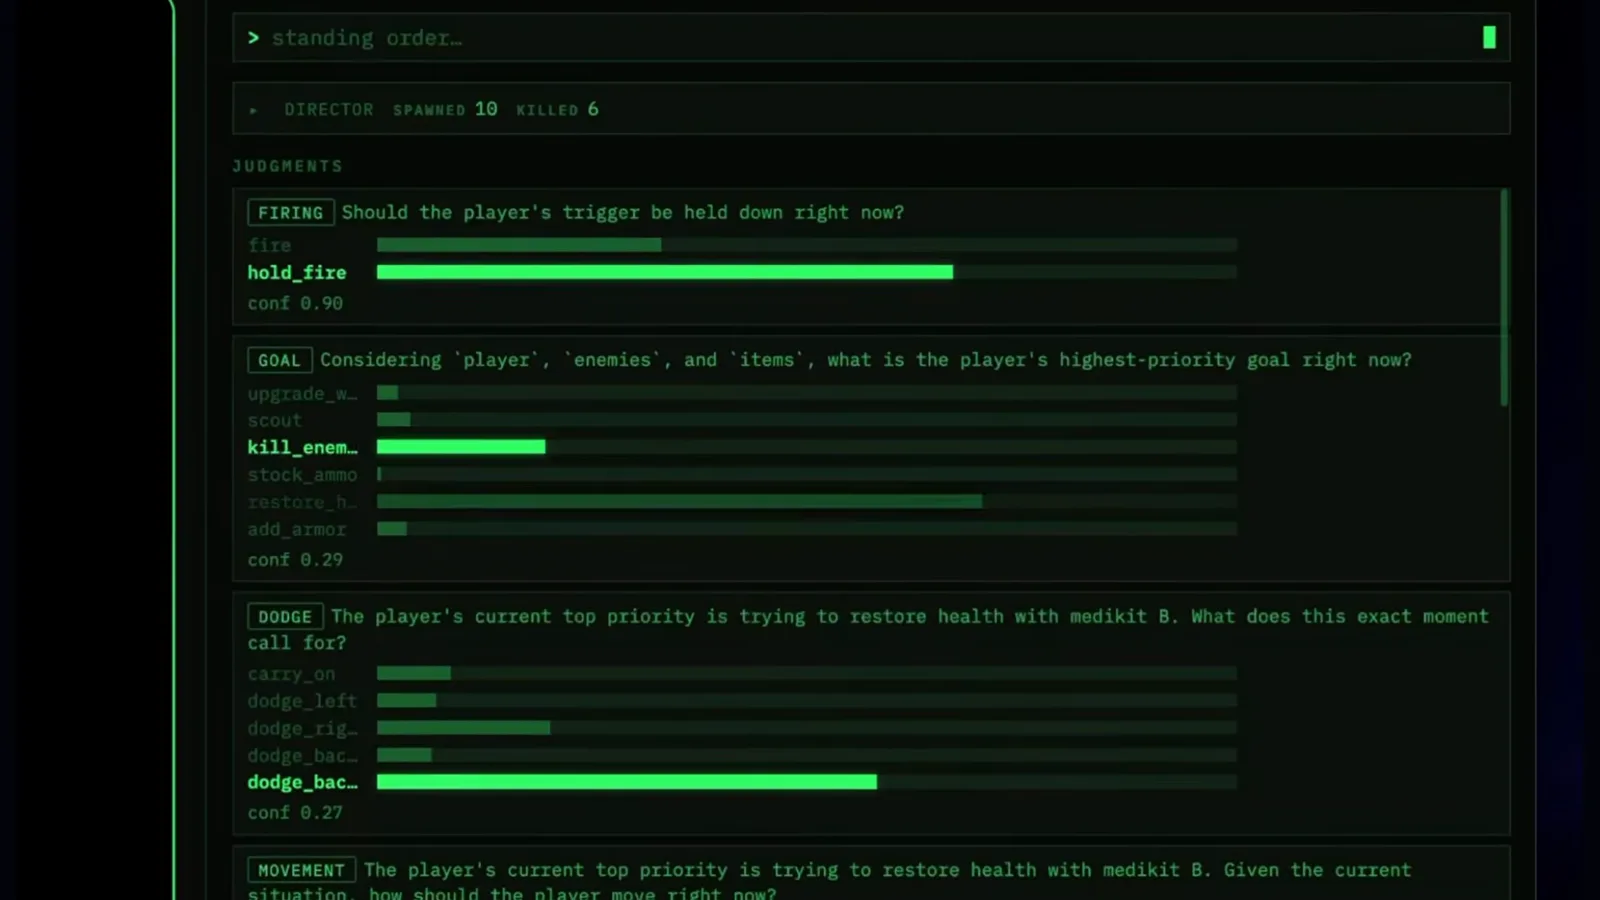
教师的概率就是标签——两分钟训练,全部免费下载。跳转至 1:43 - 4
从 GitHub 上的开源复刻起步
Jev 本体闭源——架构刻意保密,TypeSafe 的 CEO 只在网上确认过「叫它零样本分类器 absolutely true」。但这个形状可以复刻:Jev 发布后两天内,GitHub 上就出现了开源复刻。视频用的这版叫 TheoLeeCJ/openjev,仓库简介就是整个视频要回答的问题——「Can we run something like Jev on a 3060 at home?」,管道、基准和 demo 配置全都自带。
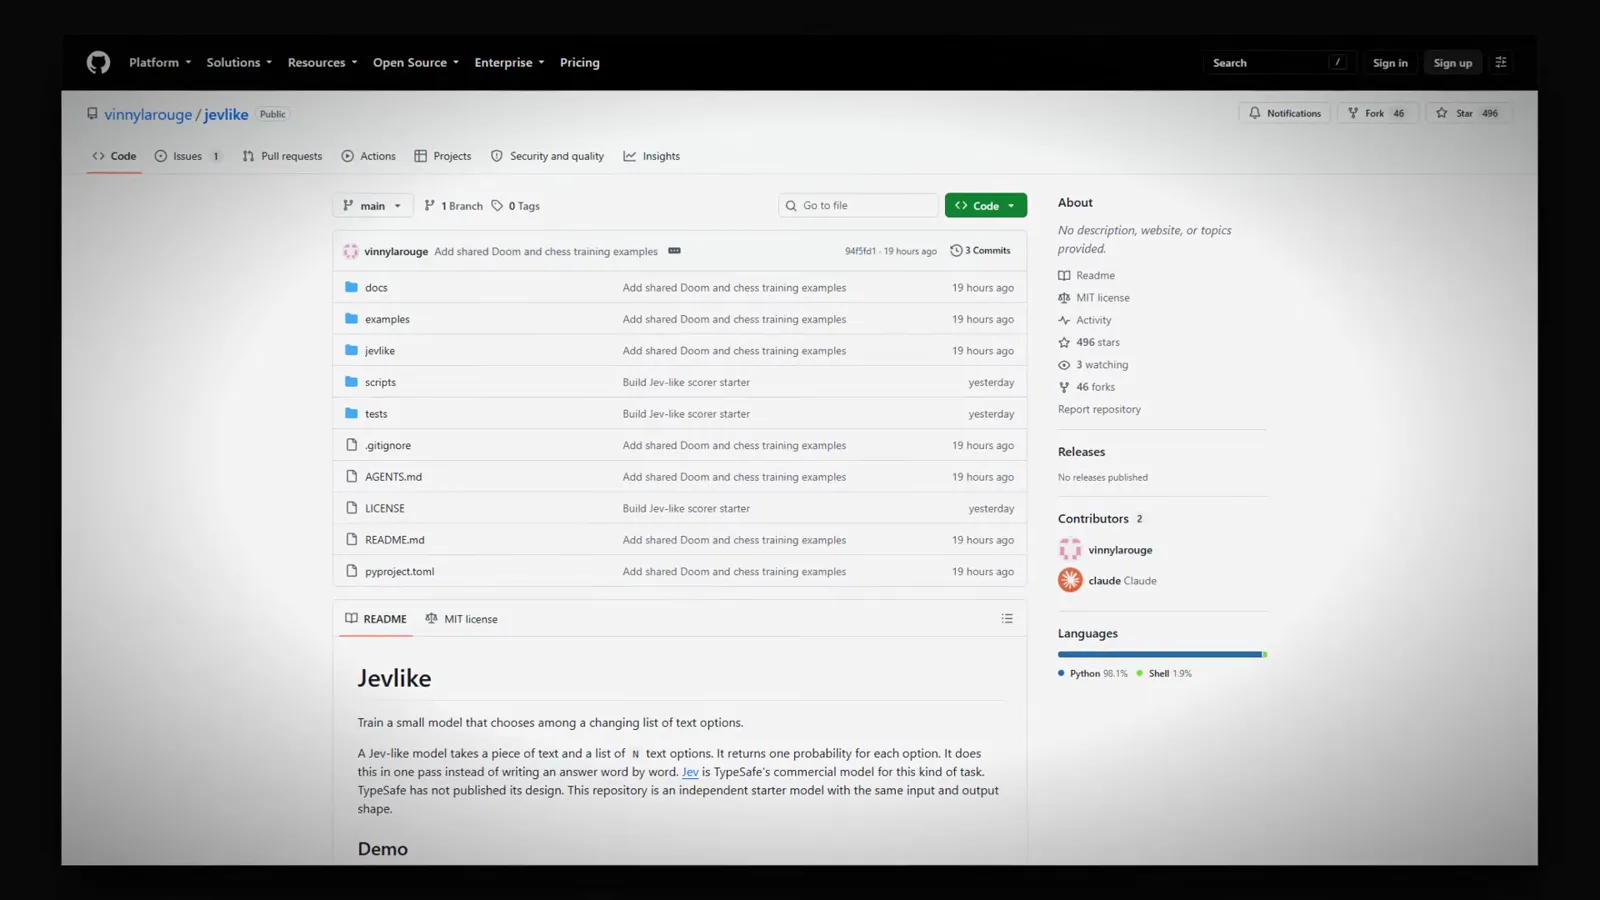
openjev 是第三方开源复刻,不是 TypeSafe 官方产品。跳转至 1:45 - 5
信任置信度之前,先做校准
全片最有价值的一分钟在讲分数的诚实性。训练前,学生自称 95% 置信,却和教师一半时间不一致——幻灯片把这个说法划掉,旁边画着飞镖盘。蒸馏之后,学生说有把握时,和教师的一致率是 99/100;在训练时没见过的回合里,选中和教师相同答案的比例是 93/100(之前约一半)。校准才是置信度能当自动化闸门的原因:有把握的直接执行,存疑的交给更大的模型或人。
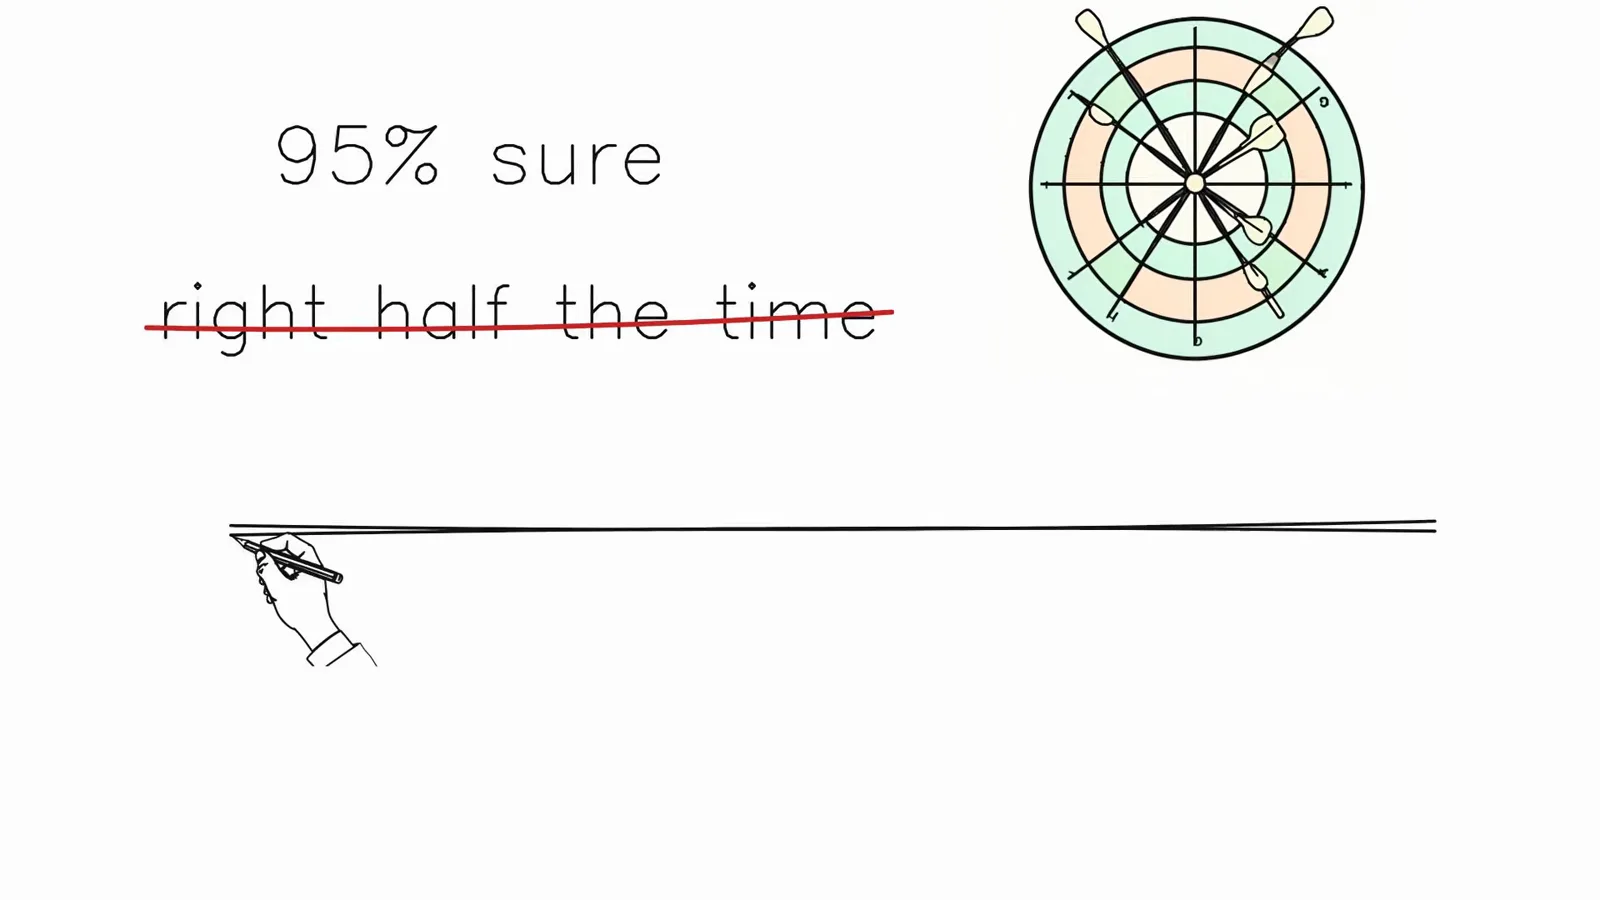
一致性没测过之前,置信度什么都不是——测过之后它就是闸门。跳转至 3:20 - 6
诚实地给教师定价:每题 9 秒
速度声明有值得细读的注脚。让大 45 倍的教师模型认真思考每个问题时,它一题要想约 9 秒;蒸馏出的学生在同一张地图上约百分之一秒作答——快约 900 倍,局内每秒 12 次决策。这就是整个模式的经济账:教师的成本只在线下付一次,用来给学生标好局面;学生在线上永远以毫秒级作答。
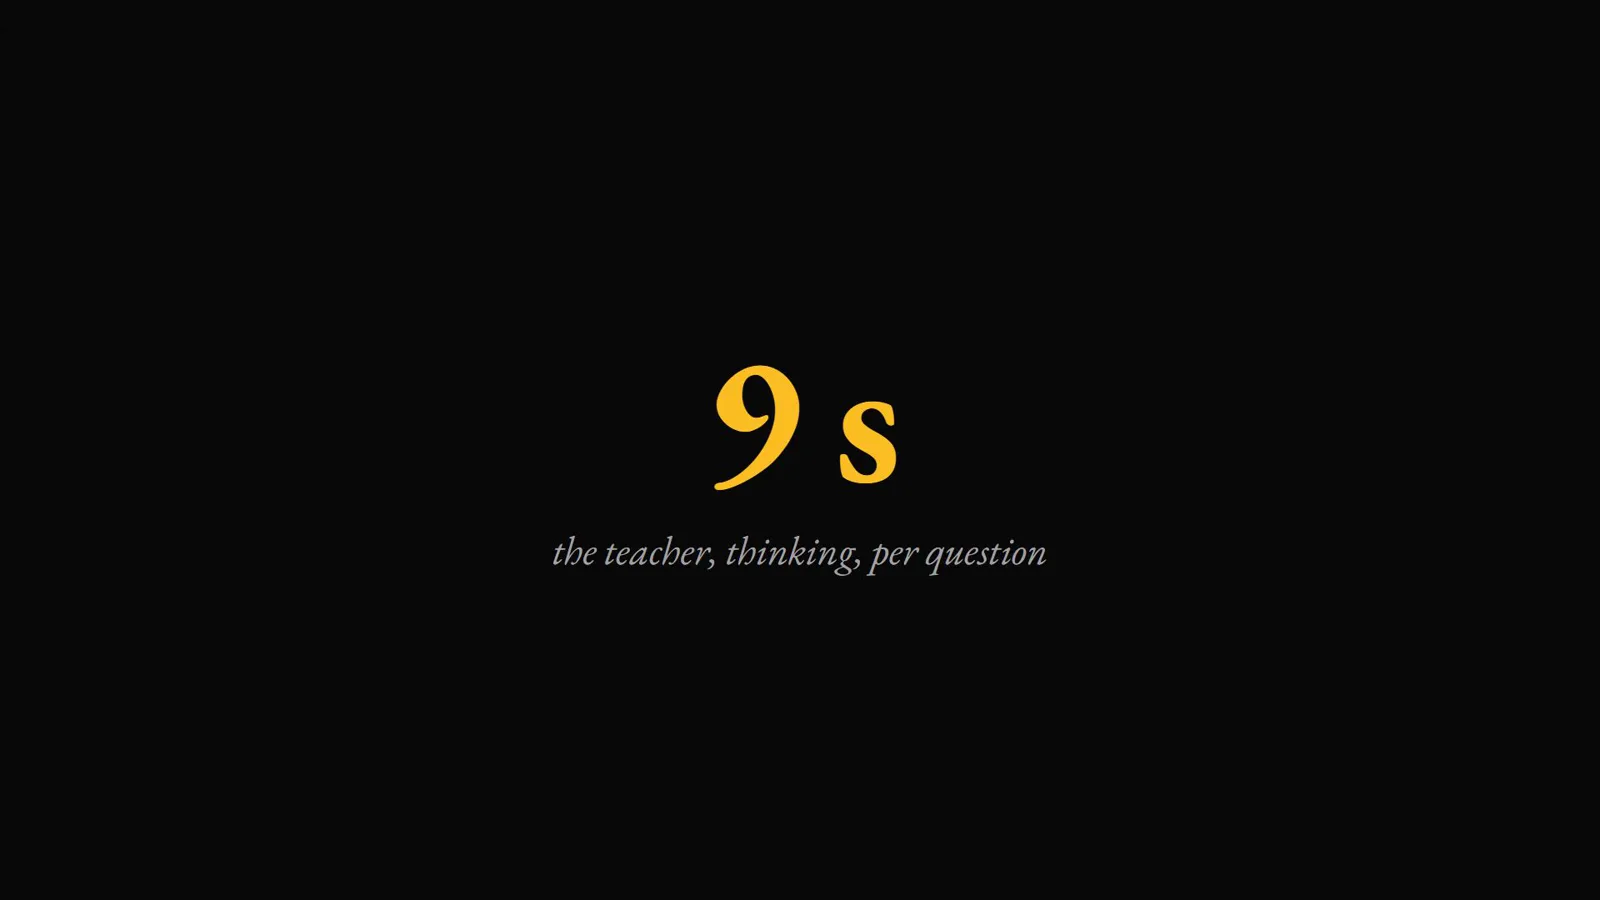
教师花 9 秒思考,学生就不用再想。跳转至 4:22 - 7
看它活下来:316 毫秒一次决策,30 个击杀
结尾的实跑把数字打在了玻璃上:在更大模型答案上训练的 Qwen3 0.6B,以每次决策 316 毫秒的速度打了 453 次决策、拿下 30 个击杀。输入新策略「don’t shoot, just dodge」后,它停火开始侧移,完全不用重新训练——因为策略是输入,不是权重。诚实边界:这个学生只认识它训练过的那一个房间;最好的开源复刻在 TypeSafe 自己公布的测试用例上仍比 Jev 低几分。
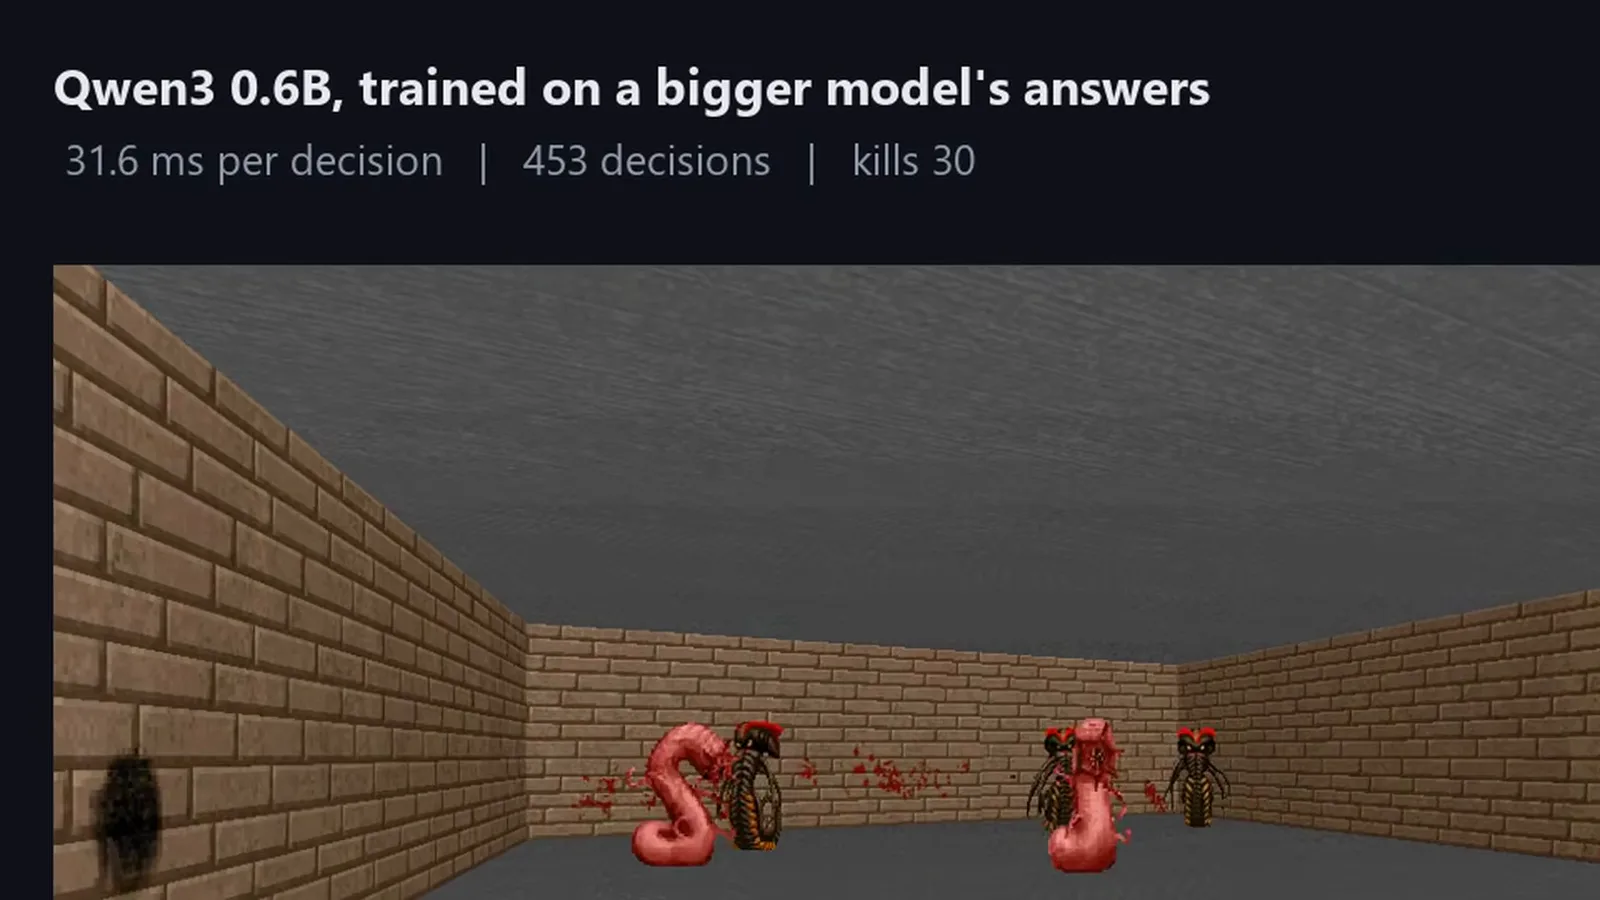
单卡每秒 12 次决策——在它训练过的房间里。跳转至 4:28
常见问题(FAQ)
openjev 和 Jev 是同一个东西吗?
不是——视频对这一点很谨慎。Jev 是 Typesafe AI 的闭源托管决策模型,架构刻意保密;openjev 是复刻「使用形状」的第三方开源项目:state 加类型化问题进,每个选项的校准概率出,单次前向完成。TypeSafe 的 CEO 公开确认过「零样本分类器」这个描述对 Jev 成立,而这正是 openjev 所处的品类。最好的开源复刻在 TypeSafe 自己公布的测试用例上仍低几分。
自己造一个 Jev 型模型要花多少钱?
视频里的答案:除了电费和你已有的显卡,几乎为零。教师是免费的大模型,训练集是 1000+ 个录制的 Doom 局面,训练约两分钟,连同 Doom 本体都能免费下载。视频标题说的「一晚上造出来」是真的。真正的成本在于给你的业务领域标注局面——这也是任何蒸馏分类器都绕不开的数据工作。
为什么要蒸馏教师,而不是直接 prompt 小模型?
因为没训练的小模型快但错——它从不躲火球,半分钟就死。prompt 装不进判断力,蒸馏装得进。教师对 1000+ 个局面各答一次,线下输出校准百分比;学生把复现这些百分比学到位之后,未见回合与教师的一致率是 93/100。教师「每题 9 秒」的成本只付一次,之后线上永远是百分之一秒的作答。
置信度分数到底在门控什么?
门控自动化。校准之后,学生「有把握」的答案几乎总是教师的答案,程序可以直接执行;存疑的升级给更大的模型或人。这和托管 Jev 上的置信度门控是同一个模式——阈值之所以可用,是因为分数对着真值校验过,这也是视频花整整一分钟讲「自称 95% 置信、正确率一半」这个坑的原因。
学生能处理没训练过的局面吗?
基本不能——视频说得很直白。学生只认识训练过的那一个 Doom 房间;零样本指的是「答案在提问时现写它也能打分」,不是「理解新环境」。改策略(「don’t shoot, just dodge」)不用重训练,因为策略是输入;换房间、换游戏、换领域,就要重新录局面重新蒸馏。Jev 被宣传为能应对没人准备过的局面,你家自建的这个,诚实地讲是个专才。
跟着做需要什么硬件?
一张消费级显卡就够——仓库标题的问题就是「Can we run something like Jev on a 3060 at home?」,视频的回答是 yes:开源复刻在一张六年前的卡上每秒能答 21 个问题,训练好的学生局内每秒 12 次决策。在同样的卡上,对 1000+ 个教师标注局面做蒸馏训练只要约两分钟。
相关推荐
训练你自己的 Jev:微调路线
同一个想法的云端微调轴——tev1 复刻、Modal/vLLM 训练与「标注到阈值」全流程。
阅读开源 Jev 模型全景
托管与开源的决策模型动物园:JevBench 天梯、Laya、DiffusionGemma。
阅读本地跑 Jev 系模型
在自己的硬件上跑 Kev、SemIf、Von——本地类型化决策的部署侧。
阅读Jev 使用诀窍:8 条最佳实践
对象化 state、代码里算事实、criteria 设计——同样适用于你自建的分类器。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
- Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
- Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
- Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
- CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
- 用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门