
Guides / 视频转图文攻略
Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
逐帧拆解 Codevolution 43 分钟 Jev 最佳实践 deep dive:state 怎么写成对象、哪些事实该让代码先算、无关上下文怎么裁、Noul/Choice/Score 怎么选、criteria 怎么定义每个答案、独立问题怎么合并成一次请求、confidence 阈值怎么跟着动作风险走。
速览结论
一段 43 分钟的纯录屏 deep dive,所有 demo 重跑并逐帧截图核对。视频用一个 TypeScript SDK 项目(1-state、2-questions、3-answers 三个目录)在同一个故事上跑了 13 个场景:客户 Maya 的 Aria 无线耳机充不进电。它教的工作规则:state 写成对象,字段有名、问题里能直接引用(精度上打平——字符串版 0.92/0.94 对对象版 0.9/0.9——但对象版可维护);事实让代码先算再调用(裸日期问保修得到 0.93/0.74/0.38,代码算出「13 个月前」再问就是 0.08);state 只发问题需要的部分(带全部工单历史问「客户 frustrated 吗」得 0.77、811 input token,只发最新一条得 0.19、440 token——而且无关细节是官方承认的弱点,input token 按 4.2 美分/百万计费、输出免费);代码要一个唯一答案就用 Choice(外加一个 other 兜底选项——没有它「去阿姆斯特丹门店试戴」被硬塞给 orders、置信只有 0.46,加了 other 就是 0.99),多个标签可能同时为真就用彼此独立的 Noul;永远别把 Noul 概率当强度读(「她 frustrated 吗」的 0.19/0.93/0.99 只说明是不是,不说明多生气——那是 Score 的活,且每个档位都要写清楚);criteria 要定义 true、false、每个选项、每一档(「Great, the second pair broke too. Love that for me.」这种讽刺在粗糙档位上落在 1.30、置信 0.54,给每档配上 summary 加 signals 后稳稳落在 1.00、置信 1.00);彼此独立的问题合并成一次请求(7 次调用、2008 ms、2829 token 变成 1 次、368 ms、639 token);每个动作配自己的 confidence 门槛(建议回复 0.5 就够,自动退款要 0.95——同一个 0.93 的答案过得了前者、过不了后者)。
分步图文攻略
- 1
state 写成对象,别写成一句话
第一个场景拿同一张客服工单——Maya 的 Aria 无线耳机买了三周就充不进电——编码两遍:001-plain-string.ts 把所有信息揉进一句话,002-ticket-object.ts 拆成 ticket、customer、order、message 四个字段。精度上几乎打平(字符串版 defective product 0.92、covered by plan 0.94;对象版两项都是 0.9),所以推荐理由不在精度。TypeSafe 建议大多数查询用对象,因为:好维护——增删字段不用重写整句话;字段名自带语义(plan benefits 属于 customer,购买细节属于 order);数据库和 API 返回的本来就是对象,选字段就行;而且问题里能直接引用字段,比如 `order.item` 和 `customer.plan_benefits`。只有校验单段文本时,纯字符串才够用。
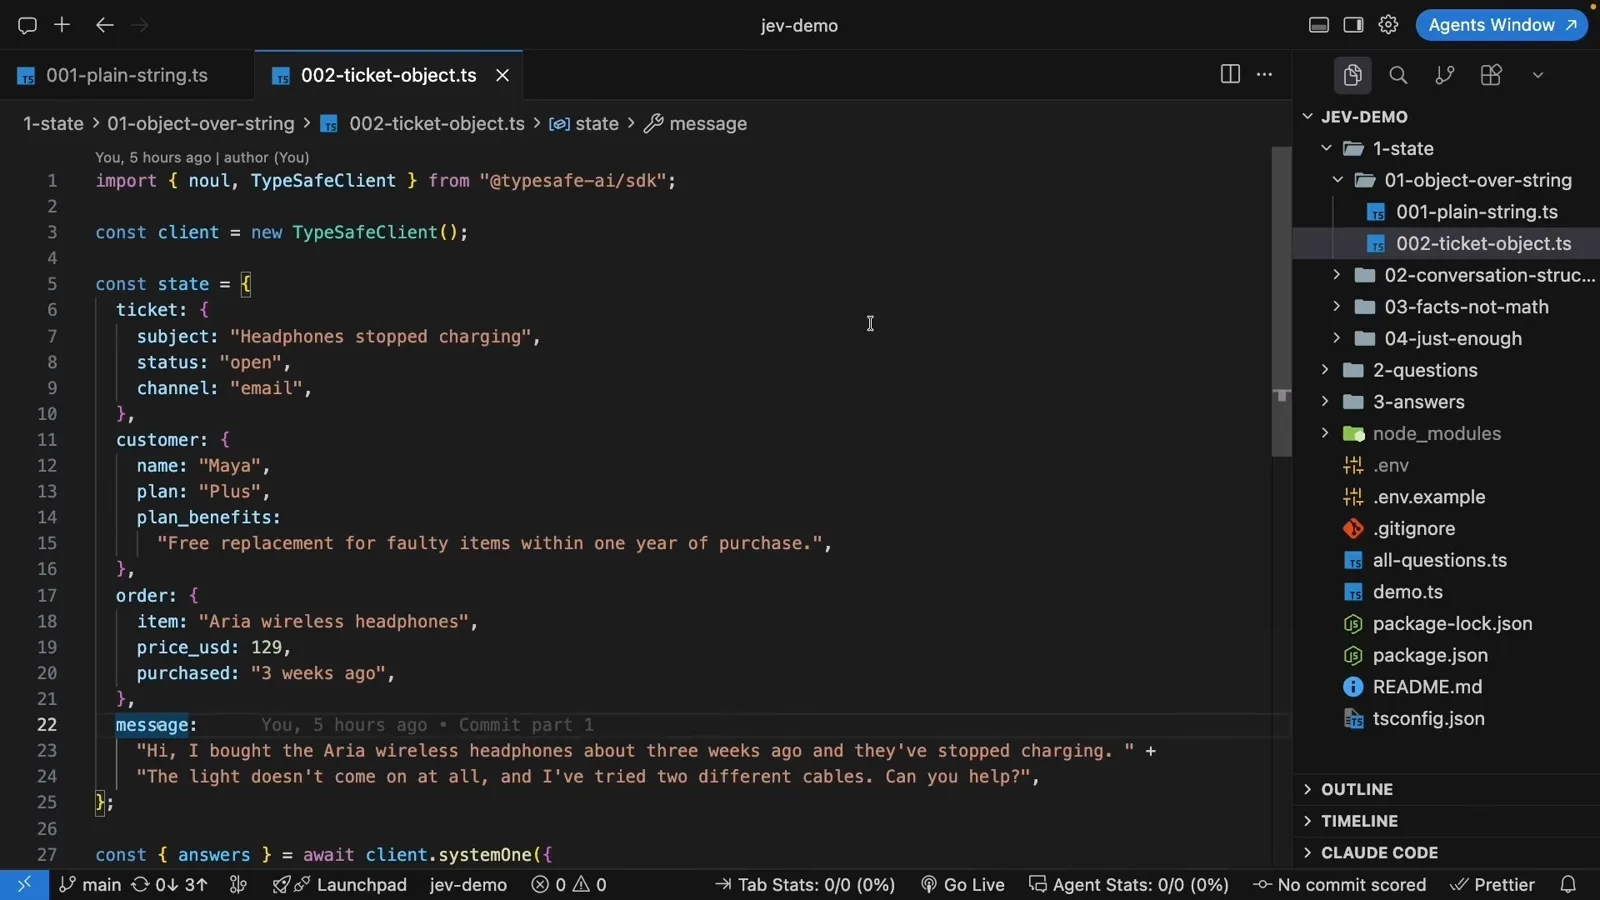
事实和字符串版一模一样——但现在每个字段都有名字,问题里可以直接点名。跳转至 2:50 - 2
调用之前,先让代码把事实算好
Maya 的 Plus 计划自购买起一年内保修故障品。第一版 001-raw-dates.ts 把原始购买日期直接塞进 state 问「还在保修期内吗」,Jev 开始和稀泥:2 个月前得 0.93,10 个月前 0.74,13 个月前只有 0.38——明明已过一年保修线,模型却不敢强烈说不。日期运算本来就不是判断语义的活,所以 002-computed-in-code.ts 加了一个小小的 monthsBetween() 函数,请求前先把日期换算成「N months ago」。同样的疑问,代码算完后返回 0.96、0.94、0.08——过保那一单终于塌向 no。通用规则:代码能算的(日期差、金额、计划查询)、能查的(用户 ID 先解析成 customer 还是 agent),都别留给模型。Jev 判断语义,代码核对事实。
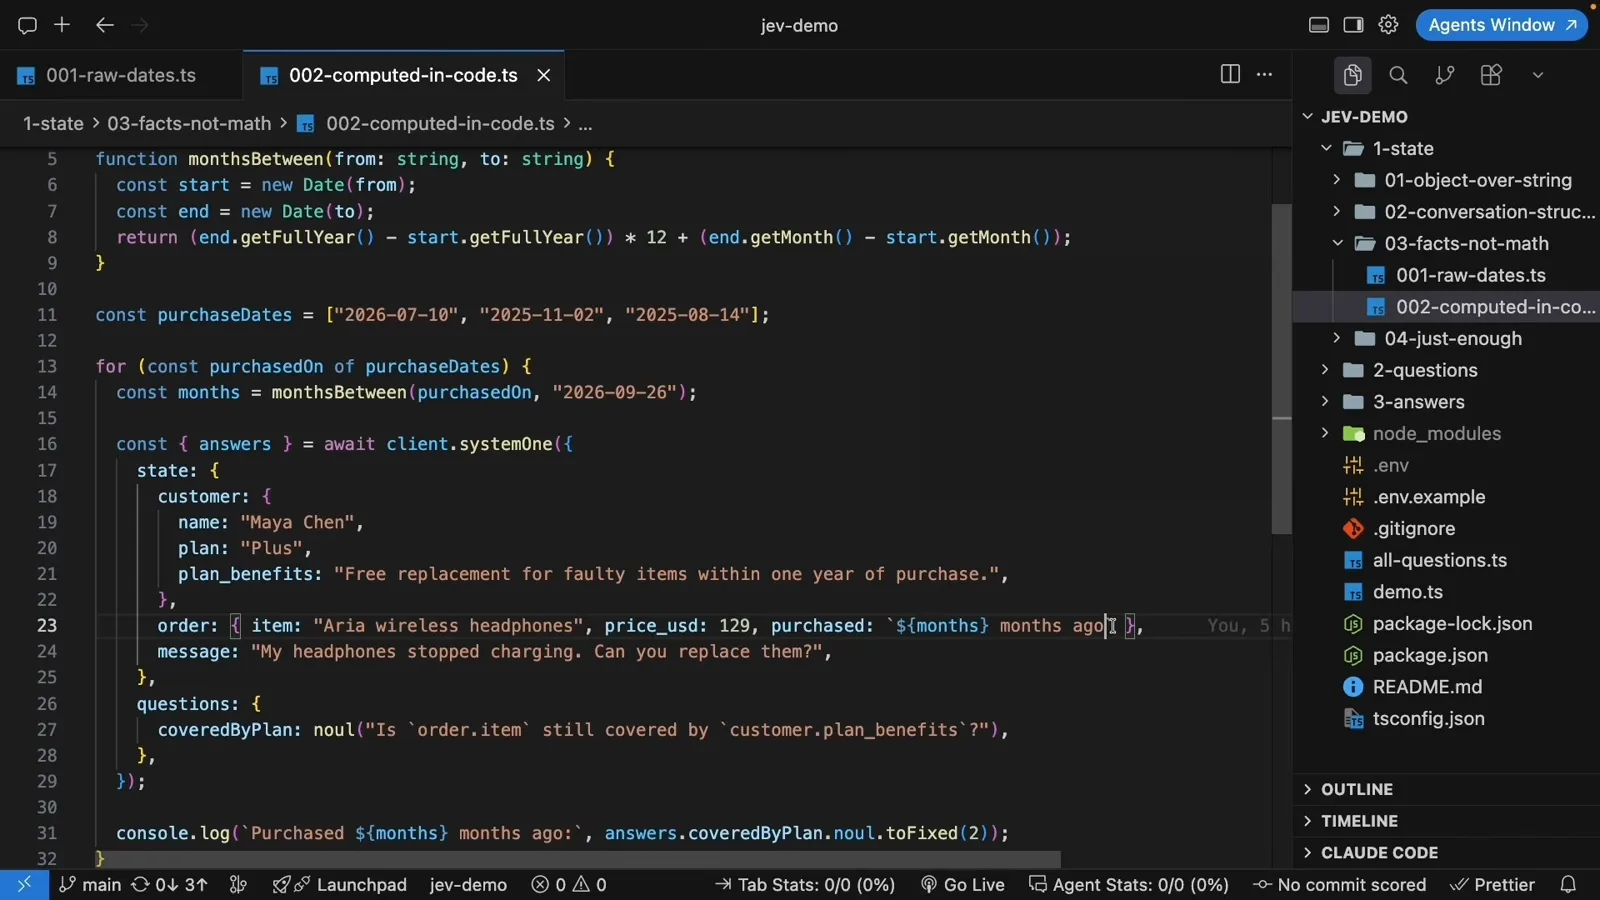
保修运算搬进 for 循环——模型只回答「这些字面还算不算在保」。跳转至 10:10 - 3
state 只发问题需要的那部分
要判断的是「客户现在 frustrated 吗」。带上 Maya 的全部工单历史——换货延误、重复扣款、真实的怒气——答案回来 0.77、811 input token,因为旧怨把分数拖高了,尽管她最新一条说的是换机到了、用着很好。只发最新一条工单,同一个问题降到 0.19、440 input token——答案对了,输入成本还省了一半。视频给了两个裁剪理由:TypeSafe 把无关细节列为已知弱点,state 里塞满与问题无关的上下文会分散模型注意力、拉低精度;而且你按 input token 付费——4.2 美分/百万,输出 token 免费——省下的钱会在每一张工单上累积。把问题问得更准(「现在 frustrated 吗」)也有帮助,但可持续的习惯是:只发有助于回答这个问题的信息,其余全砍;只有问题本身关于客户的一段时间经历时,才附历史。
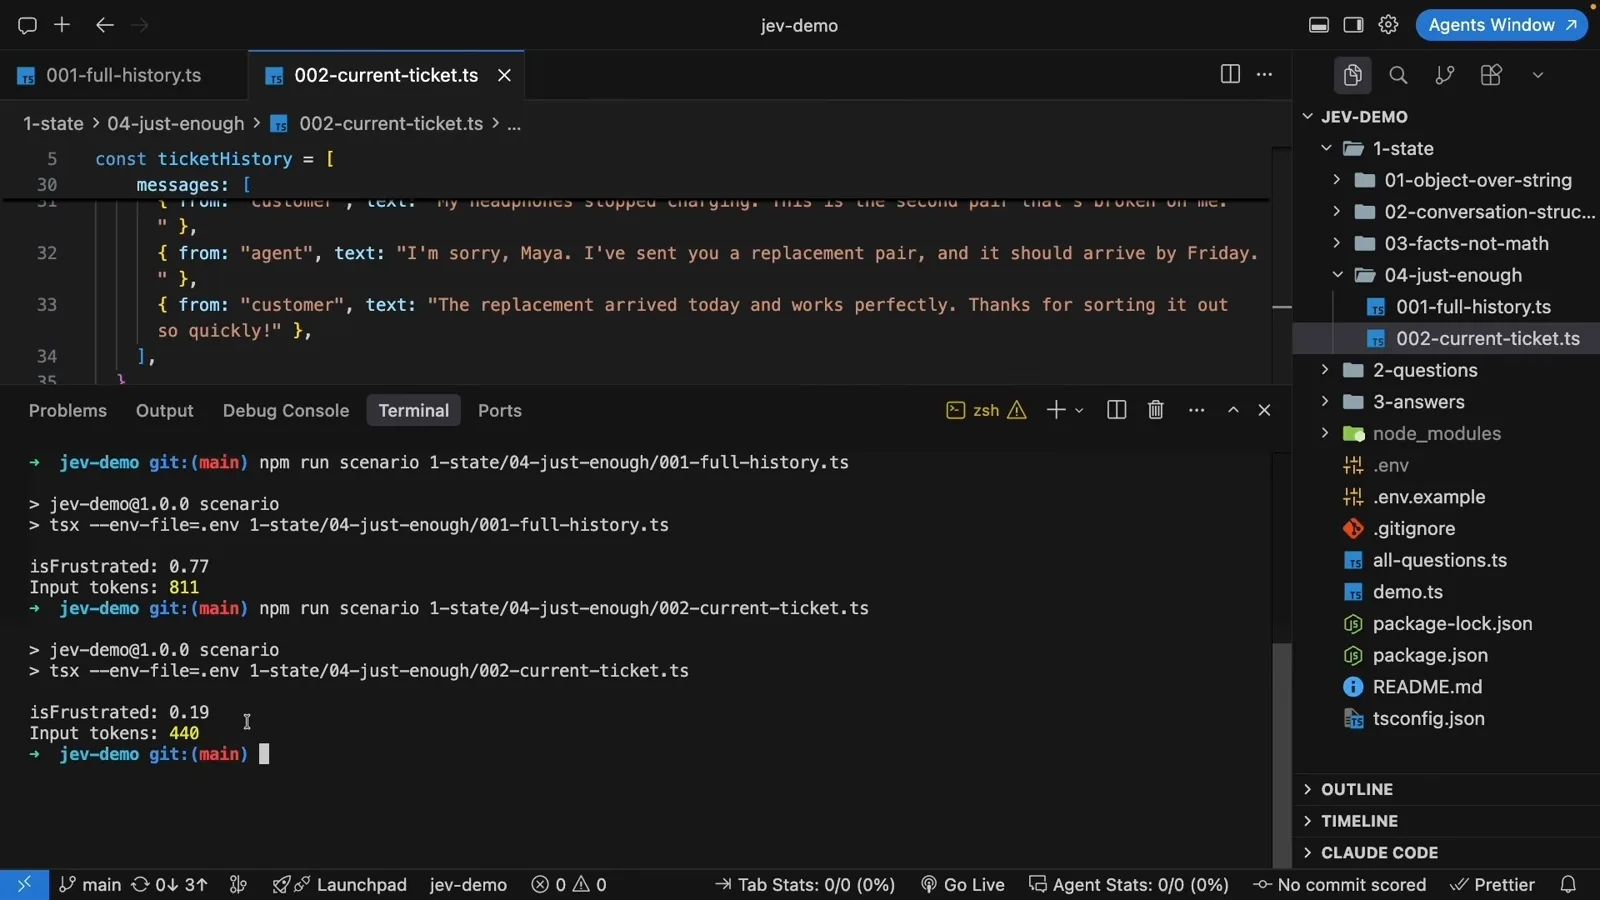
完整历史让模型偏向「frustrated」的 0.77——只发最新一条是 0.19,token 省一半。跳转至 12:50 - 4
Choice 选一个队伍;每个标签单独一个 Noul
路由 demo:客户要下载开发票报账,但登不上账号,密码重置邮件也收不到。四个 Noul 问题(「与 billing/orders/account/product 相关吗」)双双命中——billing 0.97、account 0.99——这描述了消息内容,但没有做出决定。一个 Choice 问题(「该由哪个队处理」)返回 account 0.91,正确地让登录阻塞优先。同一目录里还有三条推论。Choice 只返回一个选项,所以一条消息包含多个话题时,每个话题要单独一个 Noul,保留所有超过保留阈值(demo 里是 0.5)的标签——这样才把发票和物流催单两个标签都捞回来,单个 Choice 只会漏。而选项都不合适时 Jev 也必须选:被问「去阿姆斯特丹门店试戴耳机」发到哪,它硬选 orders、置信只有 0.46;加一个显式的 other 选项,同一条消息变 0.99。所以:唯一答案 → Choice 加 other 兜底;多个可能为真的标签 → 各一个 Noul。
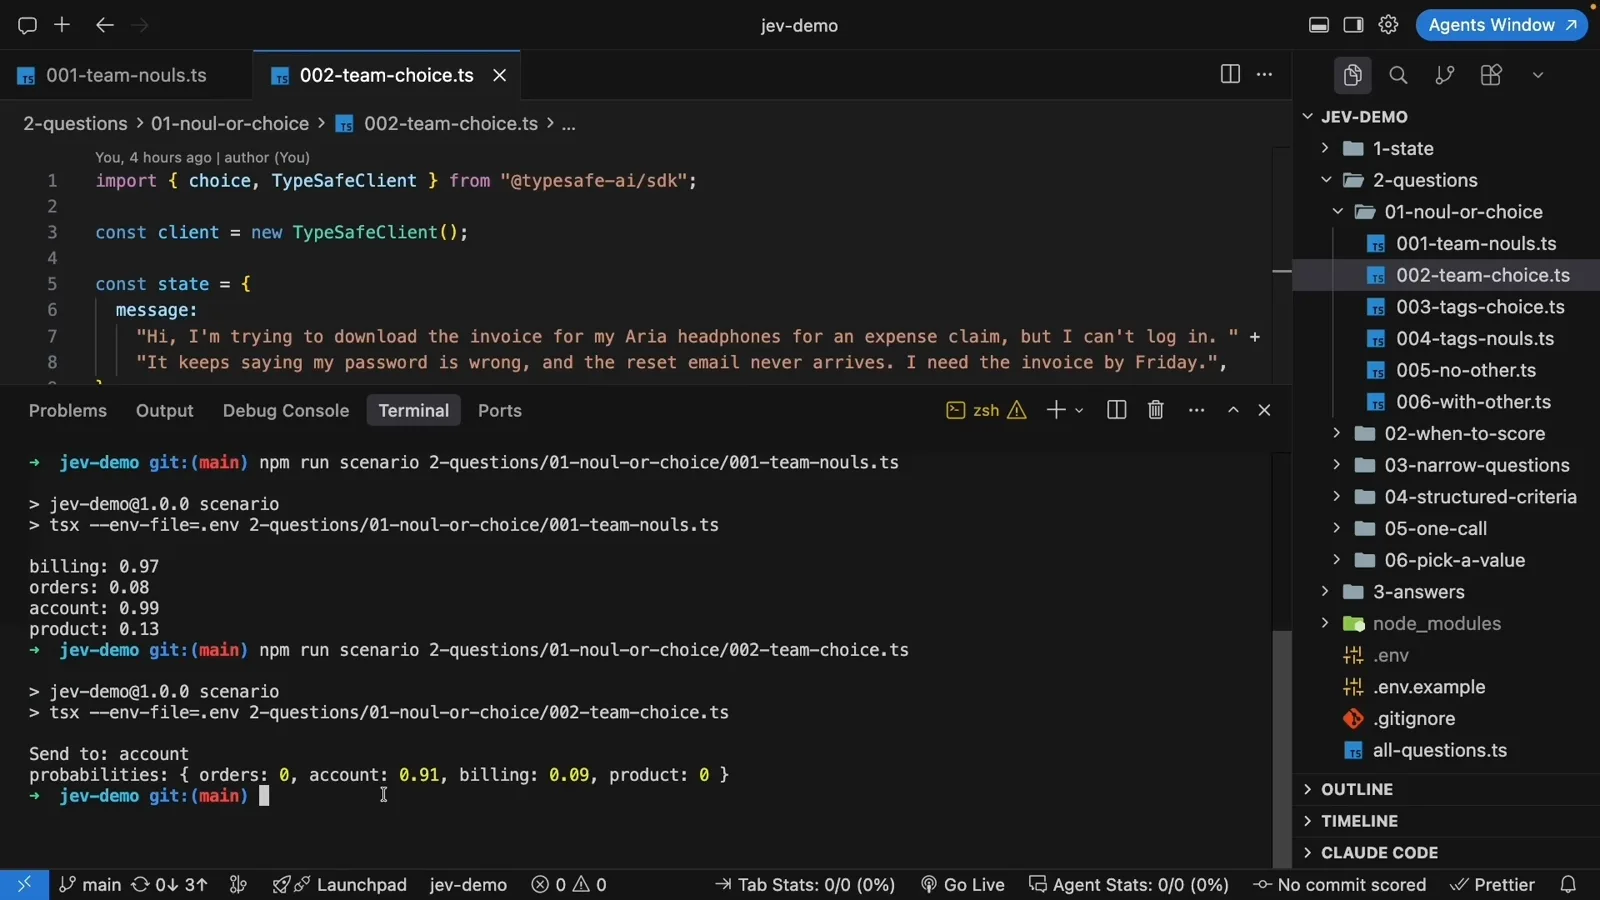
四个 Noul 负责描述,一个 Choice 负责拍板——account 以 0.91 胜出。跳转至 16:40 - 5
Noul 回答「是不是」,Score 回答「有多严重」
三条消息、一个 Noul 问题——「客户恼火吗」——回来 0.19、0.93、0.99。很容易把 0.99 读成「比 0.5 生气一倍」,但 Noul 的概率是「答案为真的可能性」:0.5 意味着是否各半,不是中等恼火。当目标是优先处理最愤怒的客户时,正确的原语是带档位描述的 Score——不恼火、失望沮丧、愤怒抱怨——返回 0、1、2:代码可以直接排序的可比整数。视频还补了一刀:把描述性档位换成敷衍的 low/medium/high,数值相近,但中间那条消息的置信明显更低——模型只能猜「medium」是什么意思。先想清楚问的是「是不是」还是「有多」,再把梯子的每一级都写明白。
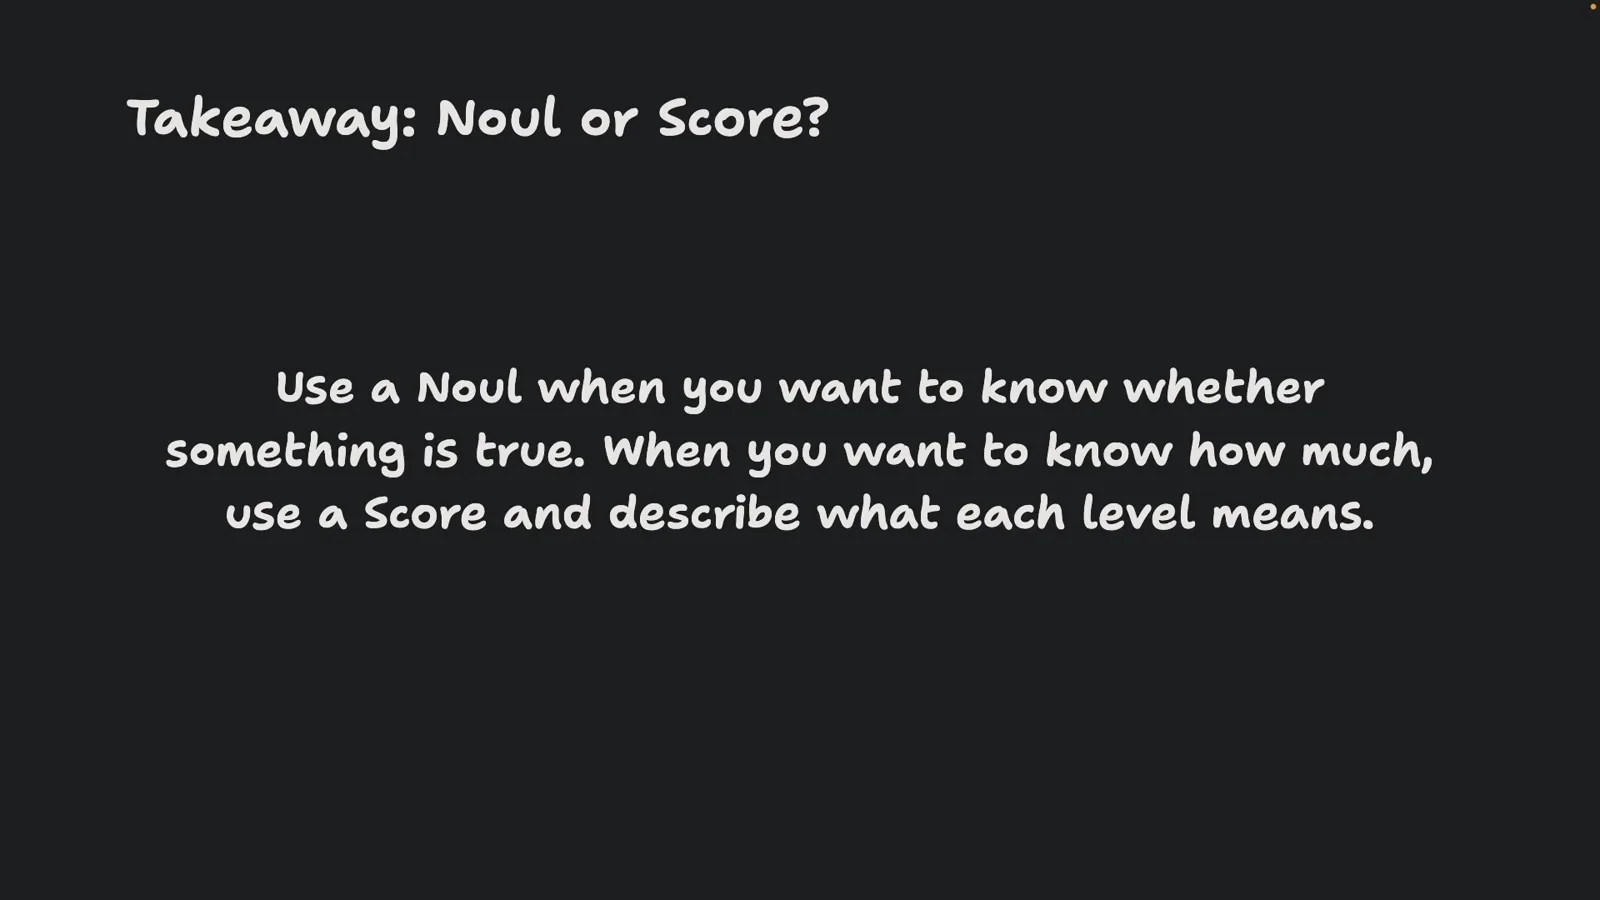
视频自己的一句话规则:在这两个原语之间怎么选。跳转至 21:50 - 6
criteria 要把每个答案都定义清楚
每个辅助函数都接收 instruction 加 criteria,而 criteria 就是定义所在。光秃秃的「客户想退款吗」Noul 会给「部分退款」打 0.8、「能退货吗」打 0.66;定义了 true(退回卡里,含部分退款)与 false(换货、换新、store credit、只是咨询)之后,退货那条掉到 0.29。Choice 的选项可以写成对象,说明覆盖什么、不覆盖什么、举一个例子——靠这个才厘清了「退货归 orders、退款查询归 billing」的边界,让两条退款进度消息不再分家。Score 的档位同样要写:粗糙的 low/medium/high 档位上,「Great, the second pair broke too. Love that for me.」这种讽刺落在档位之间、置信只有 0.54;等每一档变成带 summary 加 signals 的对象——与相关问题相关、无威胁的讽刺留在第 1 档——两条讽刺都稳稳落在 1.00、置信 1.00,而威胁「If this breaks again I’m done with you guys」守住第 2 档、置信 0.99。Noul 只有 true 和 false 是保留键;Choice 和 Score 档位上的 summary、signals 都由你自己设计。
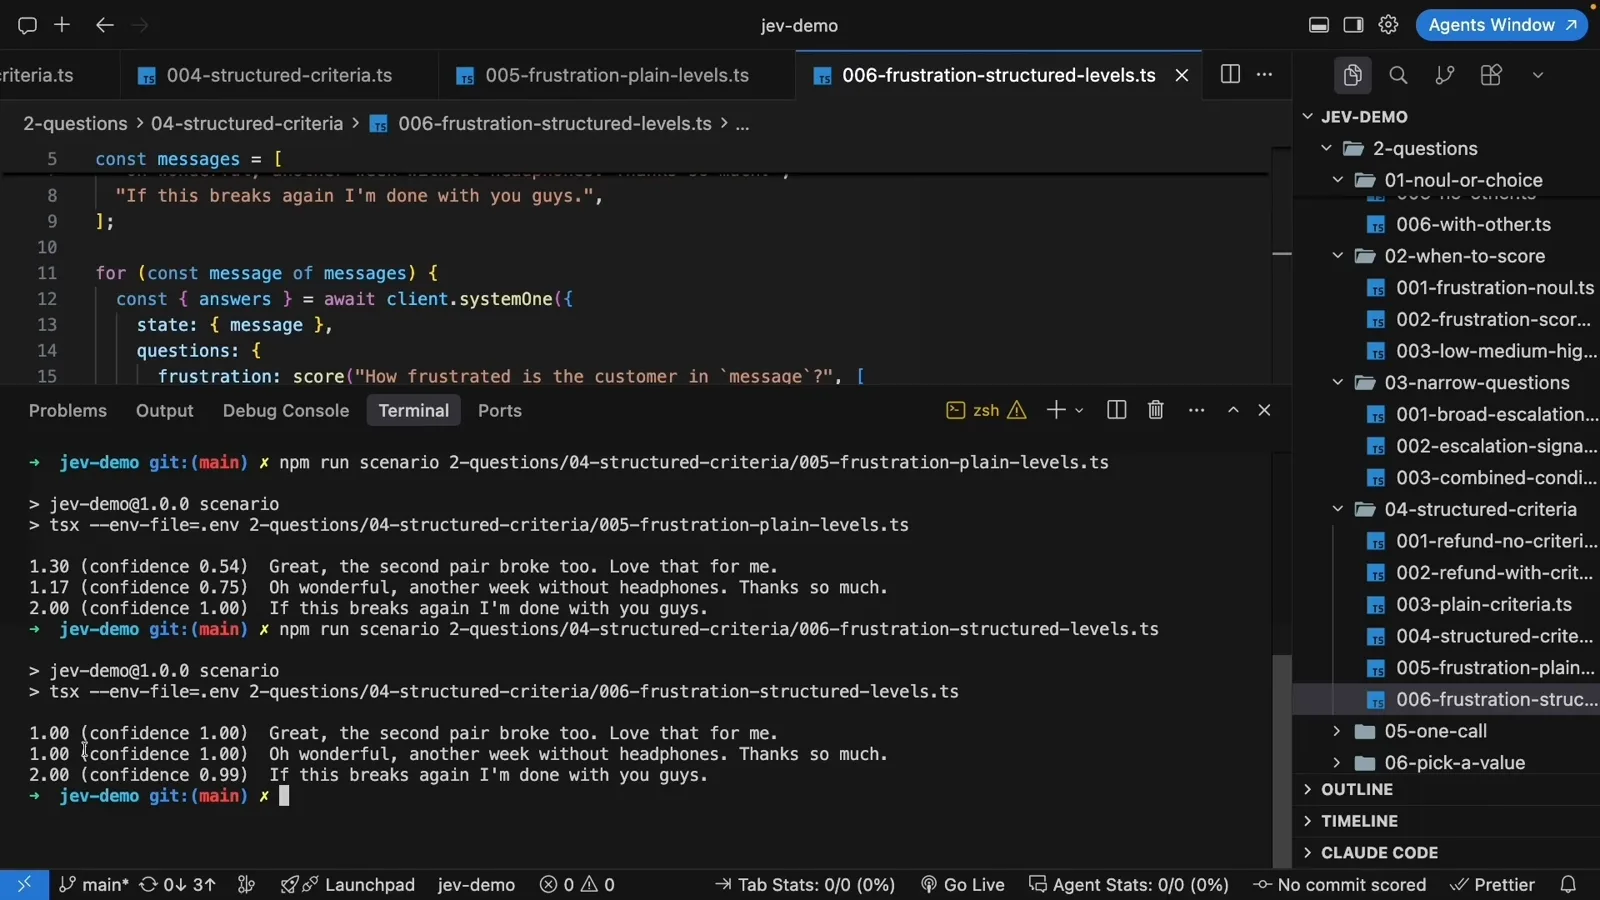
粗糙档位让讽刺卡在两级之间——summary 加 signals 一钉到位。跳转至 30:30 - 7
独立问题合并成一次请求
同一张工单的七个问题——队伍、恼火、紧急度、产品故障、她试过什么、是否想退款、是否报告错扣款——一次一问要 7 次请求、2008 ms、2829 input token。同样的七个问题合并进一次 systemOne 调用:1 次请求、368 ms、639 input token。state 只发一次而不是七次,而每个问题依然独立打分——问题可以用 state,但读不到彼此的答案——这也是拆分请求的唯一正当理由:答案 A 要用来准备问题 B 的时候,比如先识别订单、再针对订单追问。demo 里还顺手演示了一个模式:可以只把「某些情况下才相关」的问题也放进请求,让代码忽略没命中的答案——运行结果在 team: product 下面直接打印「Not about a charge, so chargedIncorrectly is ignored」。
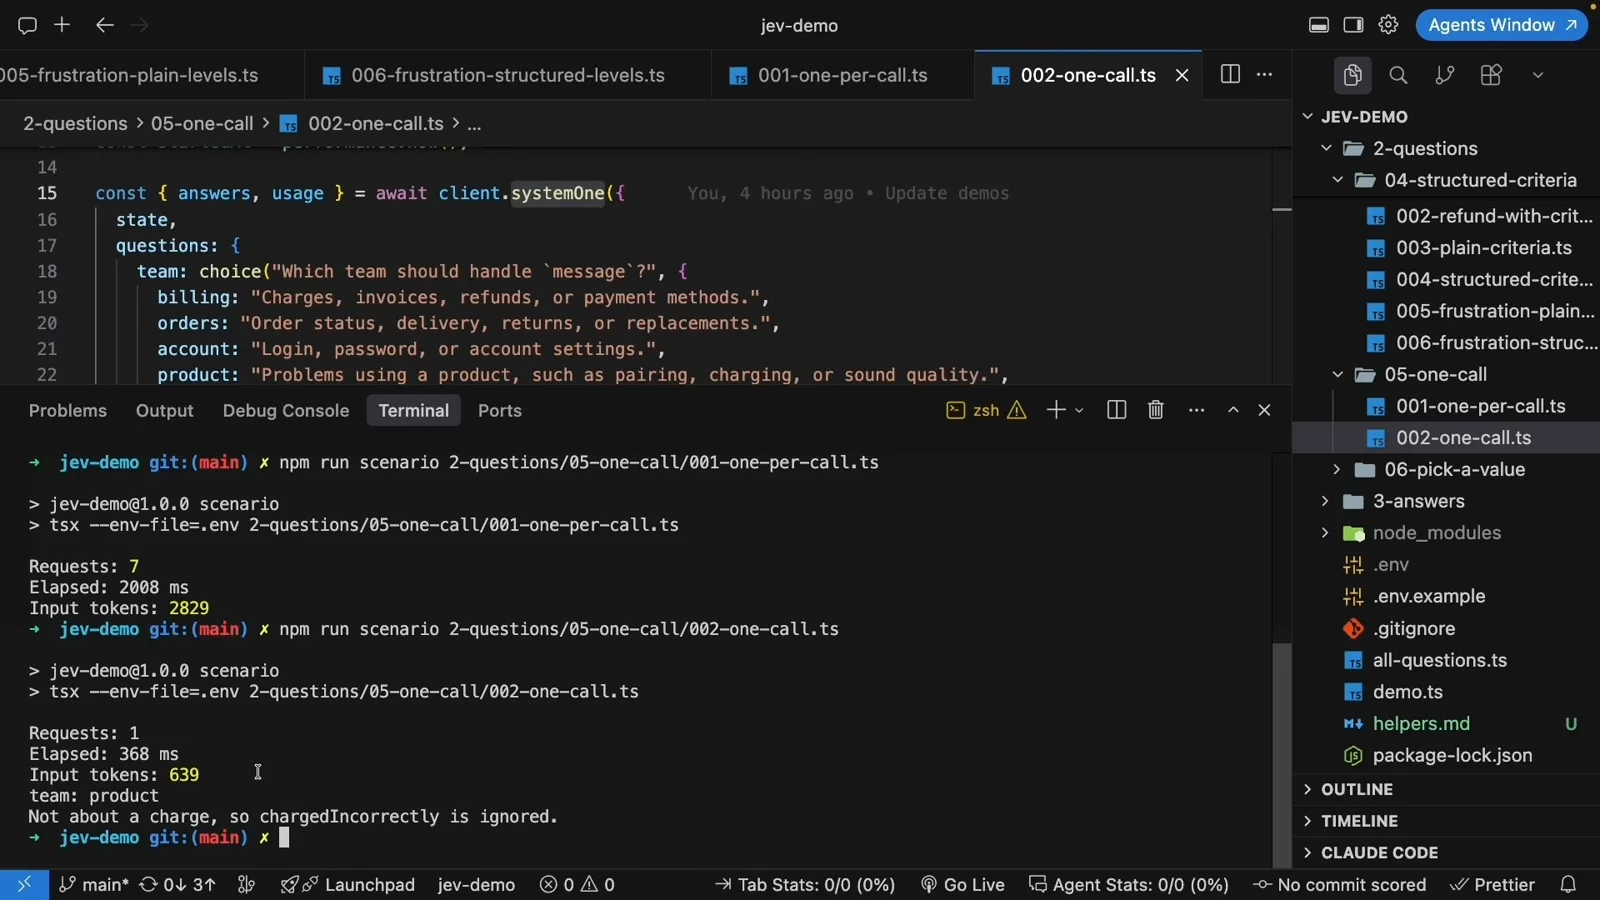
同样的七个答案,一次调用,token 不到四分之一——用不上的答案由代码忽略。跳转至 32:15 - 8
confidence 阈值跟着动作风险走
Choice 和 Score 的答案带 confidence;Noul 的答案本身就是概率——无论哪种,代码里都要有一道门槛,而门槛该随错误动作的代价升降。视频里 reply-or-refund 脚本把它写进了注释:「The riskier the action, the higher the bar.」给客服建议一条回复只需 confidence 0.5;自动执行退款要 0.95。「I’d like my money back, please」置信 1.00,两道门都过。「I’d like my money back, unless a replacement can ship quickly」置信 0.93——建议触发,自动退款不触发,由人工先确认客户偏好。前面一个场景把同一思想分了档:confidence 0.9 以上直接执行,0.6 到 0.9 之间请客户确认,0.6 以下转人工;Noul 则是 0.8 以上执行、0.2 以下放弃、中间区间交给人。给所有动作共用一个全局阈值正是常见的错误——廉价动作容得下怀疑,不可逆的动作容不下。
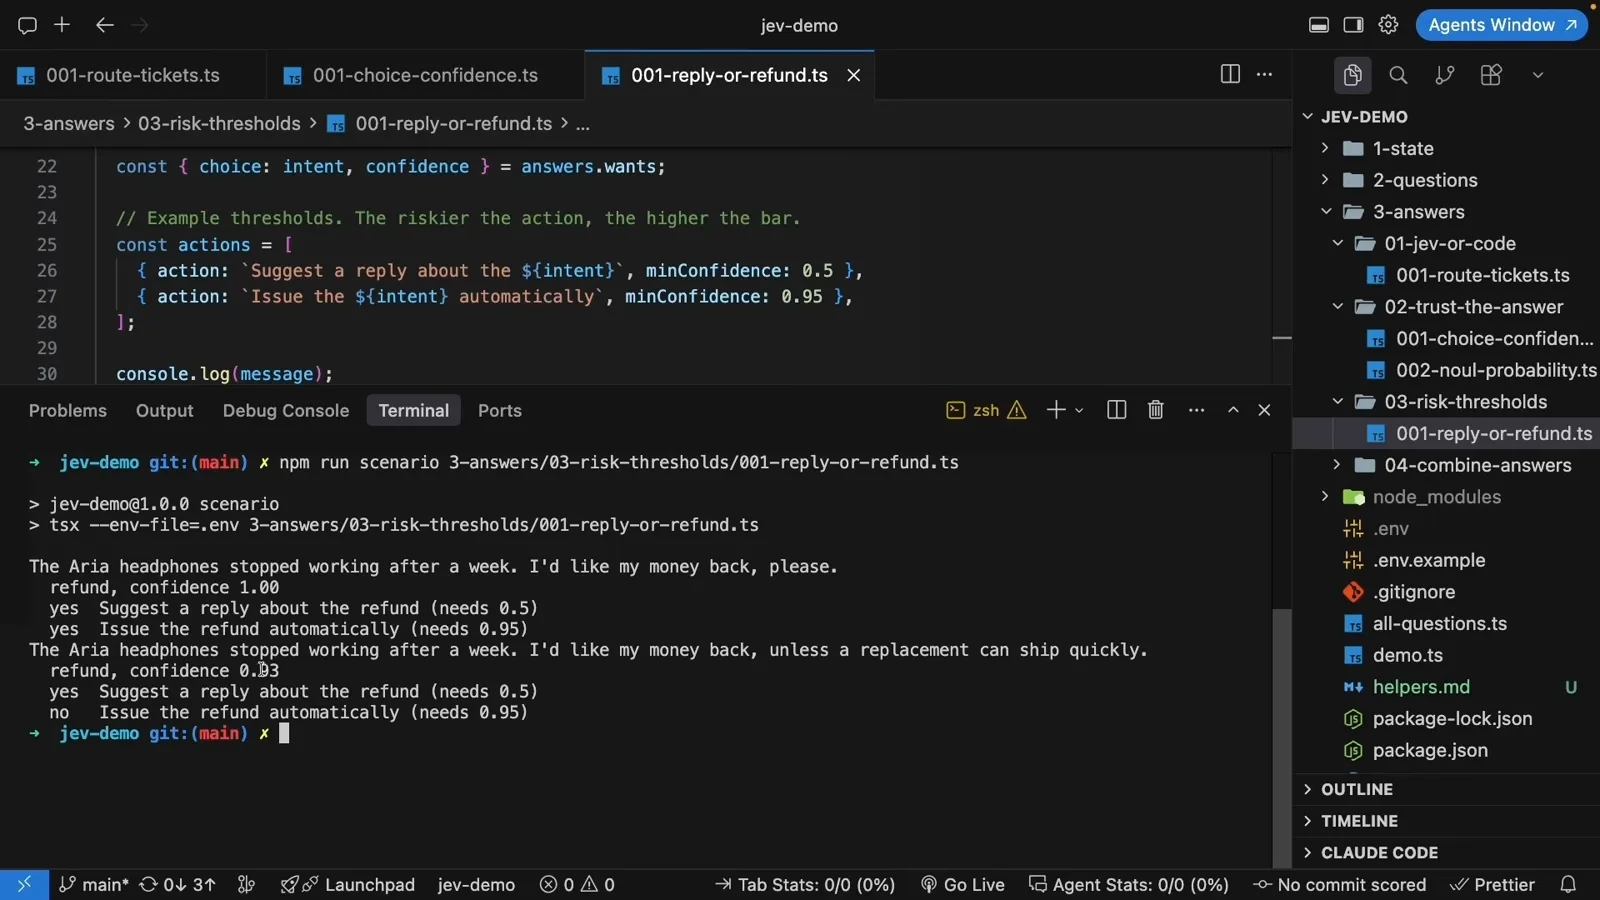
置信 1.00 两道门全过;0.93 只够拿一个建议——剩下的交给人。跳转至 40:05
常见问题(FAQ)
怎么让 Jev API 返回更好的结果?有哪些最佳实践?
视频把它们归成三个决策。摆好 state:用带名字字段的对象,日期运算这类事实先在自己的代码里算好,只发问题需要的上下文。问对问题:代码要唯一答案用 Choice(配一个 other 兜底),多个标签可能同时为真用彼此独立的 Noul,需要强度排序用带档位描述的 Score,并用 criteria 定义每一个选项和档位。用好答案:彼此独立的问题合并成一次请求,并按「错误动作的代价」给每个动作配自己的 confidence 阈值。
Jev 里什么时候用 Noul、什么时候用 Choice、什么时候用 Score?
Noul 回答「是不是」:返回一个是/非陈述为真的概率,0.5 表示是否各半——不是中等程度。Choice 回答「选哪个」:从你的列表里挑恰好一个选项并带 confidence,适合路由到唯一队伍——但不适合给一条消息里的多个话题打标签。Score 回答「有多」:把输入放到你描述的有序量表上,返回可排序的档位。视频的试金石:三条消息的 Noul 概率(0.19/0.93/0.99)告诉你谁在生气;Score(0/1/2)告诉你先回谁。
怎么降低 Jev 的调用成本?
两个杠杆最有效,因为计费按 input token 收——挂牌价是 4.2 美分/百万 input token,输出 token 免费。第一,裁 state:去掉 Maya 的旧工单历史后,一次 frustration 检查从 811 降到 440 input token,答案还更准了(0.77 降到 0.19)。第二,批量:同一张工单的七个独立问题,拆成七次调用要 2829 token、2008 ms,合并成一次 systemOne 请求只要 639 token、368 ms。只有「前一个答案要用来准备后一个问题」时才值得拆开请求。
Jev 决策的 confidence 阈值该设多少?
每个动作一个,不要全局一个——视频的注释原话是「The riskier the action, the higher the bar.」它的示例:confidence 0.5 以上就可以给客服建议一条回复,但自动退款要 0.95——于是 0.93 的答案触发了建议、没触发打款。路由决策的分档:0.9 以上直接执行,0.6–0.9 请客户确认,0.6 以下转人工;Noul 概率 0.8 以上执行、0.2 以下放弃、中间区间升级人工。具体 cutoff 要拿自己的真实流量回调——高置信也不保证答案正确。
criteria 和档位描述真的会改变 Jev 的答案吗?
视频里实测会,而且是两位数的百分点变化。给退款 Noul 定义 true 和 false 之后,「能退货吗」从 0.66 掉到 0.29。给每个队伍的 Choice 选项写清覆盖范围(和不覆盖什么)之后,原本在 orders 和 billing 之间分裂的两条退款进度消息一起归入 billing。恼火度 Score 上,「Oh wonderful, another week without headphones」这类讽刺在粗糙的 low/medium/high 档位间骑墙、置信 0.54;等每一档带上 summary 加 signals(比如「与相关问题相关、无威胁的讽刺」)后,干净落在第 1 档、置信 1.00。规律就一条:别让模型猜你的答案是什么意思。
相关推荐
Jev 零基础入门指南
同一频道的从零到第一次调用教程:什么是 System One 决策、state 加 questions 的载荷怎么写——本页技巧的前提。
阅读Jev Playground 图文导览
控制台逐步导览,你可以在里面亲手重跑本页的 Noul、Choice、Score 实验。
阅读什么时候该用 Jev(什么时候不该)
工程选型视角:哪些工作适合交给决策模型,哪些仍然属于 LLM。
阅读客服工单路由 Recipe
本视频场景背后的客服路由模式,做成了可直接复制的 recipe,含 state 与问题模板。
阅读去 Playground 试试三大原语
对着真实端点发 Noul、Choice、Score 问题,改 criteria 时看着概率和 confidence 实时变化。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)