
Guides / 视频转图文攻略
训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
逐帧拆解「训练你自己的 Jev」:托管 Jev 为何完全不能微调、你真正能动的三个杠杆、38,000 道训练题从哪来、$4.17 与 $17 两笔真实训练账单、Laya 微调从 0.362 涨到 0.766、怎么把校准做得经得起审计,以及这条流水线什么时候才回本。
速览结论
托管版 Jev 完全不能微调——TypeSafe 给每个账户发的都是同一份权重,也没有微调端点,所以「训练你自己的 Jev」只有两条诚实的路:把一个小型开源 LLM 微调成 Jev 式分类器,或者直接微调 Laya 这类开源决策引擎。TerraNet 把你能改变的一切归为三个杠杆:问题设计(Jev 和 Laya 都适用)、重新校准(让 80% 的分数在你的数据上真等于 80% 准确率)、微调(改权重,仅 Laya 开放)。两个公开复刻证明了经济性:Hassan(Nutlope)用约 38,000 道来自八个公开数据集的题在 Together AI 上微调 Qwen3.5 4B,约 25 分钟,训练费 $17;CoderOne 把同一个 tev1 仓库移植到 Modal,用 Unsloth + LoRA 在 L40S 上训练 Qwen3.5 4B,约两小时、$4.17——约 38,000 条训练样本(约 17M token)、5,000 条 dev、4,000 条原封不动的 staging,数据来自 MultiNLI、BoolQ、Banking77 加合成的 policy、routing、research taxonomy 数据集,在 held-out staging 上拿到约 88% 准确率,vLLM 服务下热请求端到端约 600–900 ms(模型实际计算约 160 ms)。开源引擎那边,TerraNet 的基准卡显示 Laya 421M 英文 checkpoint 微调后从 0.362 涨到 0.766(跨 2,000 次独立测试判定)——而基准的 ground truth 来自一个自我一致率仅 73.5% 的 teacher 模型;它同时警告校准温度必须只用留出数据拟合(Laya 旧 notebook 在训练数据上拟合的做法,温度与「什么都不做」相差 6% 以内)。硬规则:开工前先把数据三等分、每题选项不超过 20 个、按题目数清点测试样本(80% 准确率下 300 个样本带 ±4.5 个百分点的误差),日量不大就先用 LLM、同时从今天开始用结构化格式记录决策。
分步图文攻略
- 1
先分清「训练你自己的 Jev」能训什么、不能训什么
托管版 Jev 没得谈:TypeSafe 给每个账户发的是同一份权重,也不提供微调端点——TerraNet 的开场幻灯片直接写着「Jev: Zero fine-tuning」,而另一侧的 Laya 标着「免费 GPU 上即可重训」。这条边界决定了「训练你自己的 Jev」永远指两件事之一。路线一:微调一个小型开源 LLM 去模仿 Jev 的行为——Hassan 的 $17 Together AI 教程和 CoderOne 的 $5 Qwen3.5 4B 复刻走的就是这条路。路线二:直接微调 Laya 这类开源决策引擎,TerraNet 指出它在 Kaggle 的一对免费 T4 上几分钟就能训完。幻灯片的第三条才是真正的重点:瓶颈不是算力,而是收集有效标签、拟合你真正信得过的概率。本页剩下的内容全是在解决这两个问题。
托管 Jev 不能微调——复刻与开源引擎是仅有的两条诚实路线。跳转至 0:20 - 2
选好你的杠杆:问题设计、重新校准,还是动权重
TerraNet 把你能改变的一切归为三个杠杆。问题设计对 Jev 和 Laya 都有效:正因为 TypeSafe 给所有账户同一份权重,你只能通过请求本身塑形答案——把一个宽泛判断拆成几道窄问题,把策略写进代码里。重新校准调整置信度,让 80% 的分数在你自己的数据分布上真的对应 80% 的准确率;两家厂商都用 RLCD 训练,但校准只在「与校准数据相似的数据」上成立。微调改动内部权重,仅 Laya 开放。如果你的目标是 Jev 式分类器,微调这根杠杆指向一个小型开源基座:两个复刻都选了 Qwen3.5 4B——权重开放、协议可用——而且 CoderOne 的移植从第一天起就保持了 Jev 形状的训练格式:输入 state、问题、选项列表,输出一个字母。
三根杠杆里有两根在托管 Jev 上就能用;只有微调需要你自己的模型。跳转至 0:50 - 3
先打标签、三等分切分,然后谁也不许碰
TerraNet 的流水线图把全部纪律画成一条带:打标签、三等分、微调、拟合置信度、设阈值——升级案例再回流成新的训练数据。标签来自过去的运营决策、teacher LLM 或人工复核。切分必须发生在任何训练之前:训练集、校准集,以及你在前期绝不偷看的测试集。两个复刻展示了真实切分的规模:Hassan 的 tev1 方案用约 38,000 道取自八个公开数据集的题做训练;CoderOne 的移植是约 38,000 条训练样本(约 17M token)、近 5,000 条 dev(约 2M token),外加约 4,000 条留到模型发布之后才动用的 staging。数字背后的公开数据集,按 CoderOne 视频里点名的清单:MultiNLI 做蕴含判断、BoolQ 做是非题、Banking77 的 77 类银行客服意图,再加合成决策数据集——pop 对应政策、policy V2、routing V2,以及按「主要贡献」而非主题给论文分类的 research taxonomy。
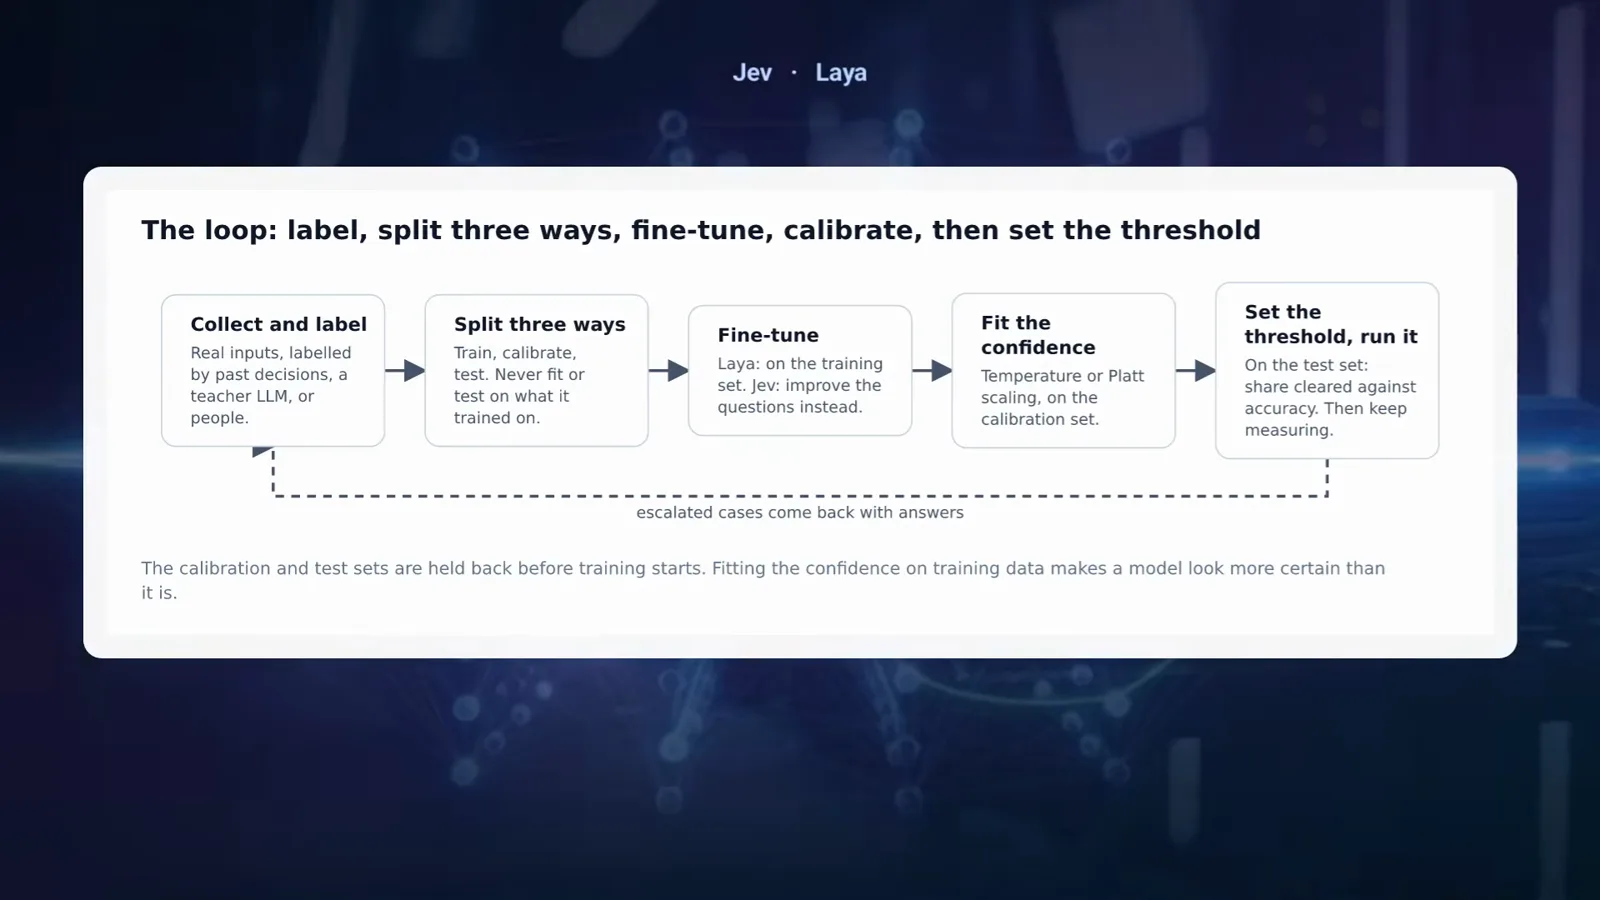
打标签、三等分、微调、校准、设阈值——然后升级案例变成明天的标签。跳转至 2:25 - 4
跑微调——然后把基准数字读明白
训练本身如今是最容易的一环。CoderOne 在 CUDA 容器里用 Unsloth 加 LoRA 微调官方 Qwen3.5 4B,先拿数据子集跑了一分钟的 smoke test,再让完整训练在 Modal 的 L40S 上跑了约两小时——训练账单 $4.17(他估计换 H100 更贵,但约 30 分钟能跑完)。Hassan 的 Together AI 版本约 25 分钟跑完,训练费 $17。开源引擎一侧,TerraNet 的基准卡给出:Laya 421M 英文 checkpoint 从 0.362 的基础准确率微调到 0.766,跨 2,000 次独立测试判定,训练数据是横跨四个工作流的 1,200 个案例。同一张幻灯片上就有警告:基准的 ground truth 由一个自我一致率仅 73.5% 的 teacher 模型生成,而 Laya 命中这个含噪 teacher 的频率比 teacher 命中自己还高——说明它学到的是任务模式而非噪声。CoderOne 的复刻在从未见过的 staging 数据上拿了约 88%。视频里的另一条边界:复刻最擅长的是从选项列表里挑一个(demo 里也把一道布尔真假题在约 600 ms 内跑通了),但 Jev 更丰富的类型化原语,得先补相应标注数据集才能正经训练。
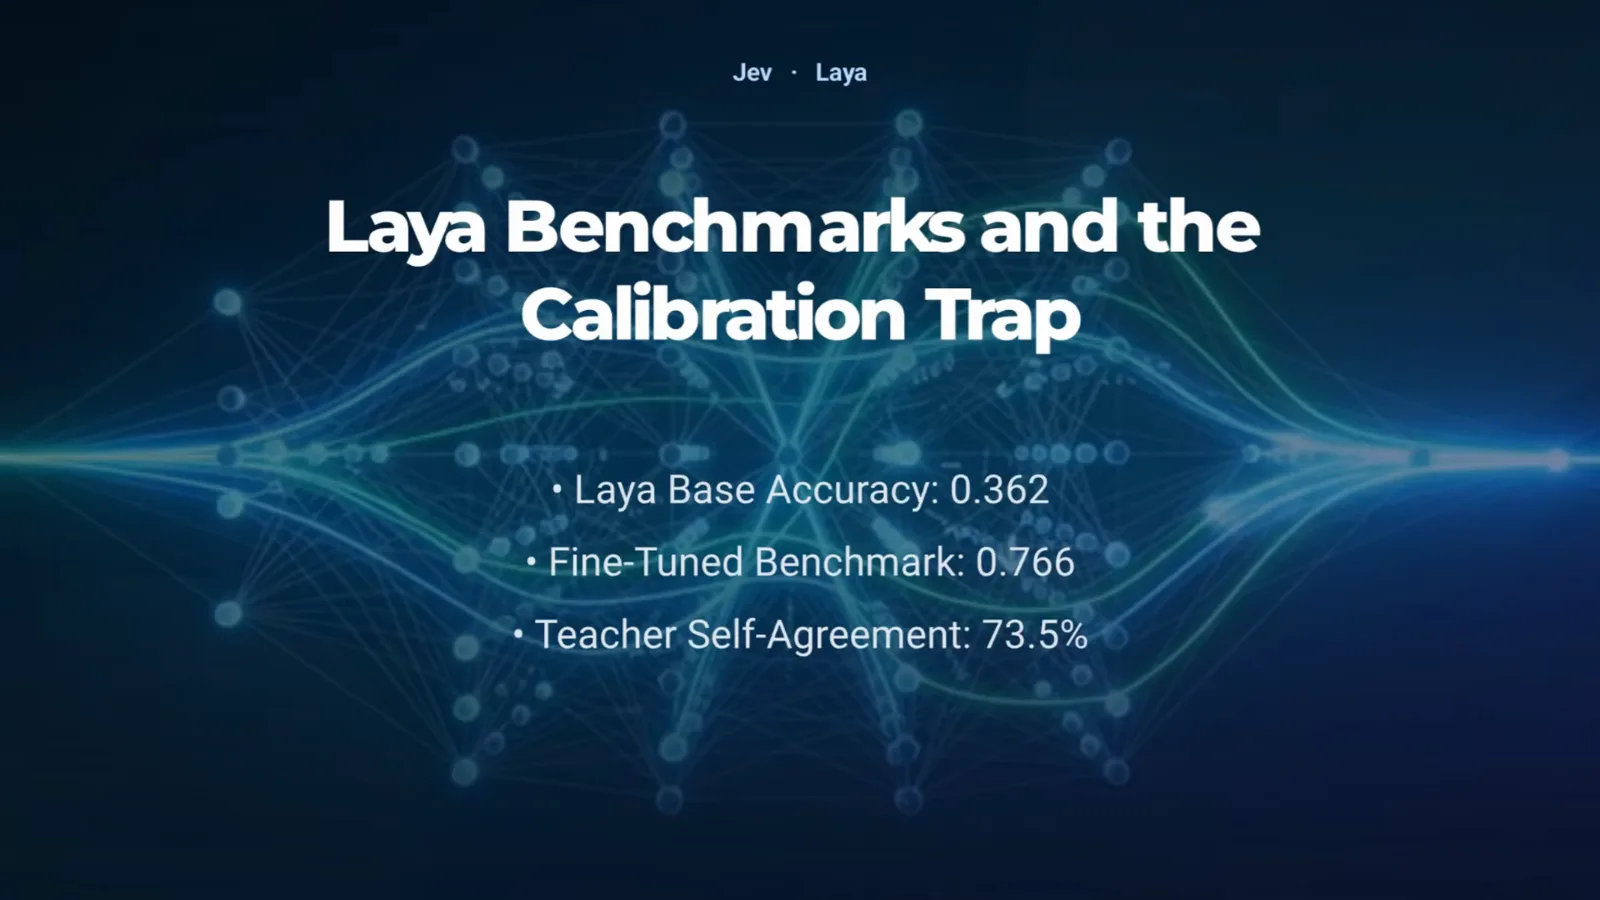
0.362 涨到 0.766 很好看——直到你注意到 teacher 的自我一致率只有 73.5%。跳转至 1:50 - 5
只在留出集上做校准,然后审计你的评估
微调出来的原始分数不是能拿来写 if 语句的概率。TerraNet 的重新校准杠杆,指的是用留出的校准集去拟合 temperature scaling 或 Platt scaling——绝不在训练数据上拟合。视频里的反面教材:Laya 自己的 notebook 曾直接在一片训练数据上拟合校准温度,结果温度几乎没动——与「什么都不做」相差 6% 以内——制造出虚假的校准安全感。然后审计评估本身。最常见的翻车方式:拿训练时用过的基准来测,或者测试集小到没有统计功效——80% 准确率下 300 个测试样本带约 ±4.5 个百分点的误差,粗到分不出两个候选微调孰优孰劣——所以按题目数清点测试样本,而不是按案例数。最后守住选项预算:单条提示超过 20 个选项时准确率会劣化,宽分类体系应该在代码里拆成层级决策,而不是硬塞进一次微调。
三个评估陷阱:拿训练集评估、测试集功效不足、选项列表过大。跳转至 3:10 - 6
部署在延迟值钱的地方——不管怎样都开始记录数据
这套工作是前置投入,只有上量才回本:TerraNet 把盈亏平衡点放在每天数千次查询——那个量级下 LLM 调用的延迟和算力成本开始扎眼。CoderOne 的服务数字给出了部署后的真实样本:vLLM 跑在 Modal 的 L40S 和 H100 两张卡上,而这个 4B 小模型反而在更便宜的 L40S 上表现更好——每次决策模型实际计算约 160 ms(14 ms 构造输入加 145 ms 执行),热请求端到端 600–900 ms,待机 GPU 冷启动一次约 90 秒。整个实验——训练加 smoke test 加大量推理——只花掉 Modal $30 注册赠金里的约 $10。他片尾的对比表是最顺手的决策法则:预训练 LLM(Qwen3.5)灵活、能解释答案、带约 256K token 上下文,但服务成本更高、做结构化决策不够准;决策模型(Jev 或 Laya)一次前向返回类型化决策和概率;要每次都输出同一套固定标签,固定 BERT 式分类器完胜。如果今天量还不大,TerraNet 的收尾建议零成本:现在就把决策连同输入一起用结构化格式记下来,等你决定训练的那天,数据已经备好了。
回本点在每天数千次查询——低于它,先记录决策、按兵不动。跳转至 3:50
常见问题(FAQ)
能微调 Jev 模型本体吗?
不能。TypeSafe 给每个账户发的是同一份权重,托管 Jev 也没有微调端点——TerraNet 的说法是「Jev: zero fine-tuning」。在托管产品上你唯一的杠杆是问题设计和重新校准。所以「训练你自己的 Jev」指的是训练一个你自己的 Jev 式分类器(微调 Qwen3.5 4B 这类小型 LLM),或者微调 Laya 这类开源决策引擎。本页没有任何内容能把自训复刻变成官方 Jev,来源项目也没有谁宣称达到官方水平。
自己训练一个 Jev 式模型要花多少钱?
两个公开数据点:Hassan 在 Together AI 上微调 Qwen3.5 4B,训练费 $17(约 25 分钟、约 38,000 道题);CoderOne 在 Modal 的 L40S 上训练同类模型,约两小时 $4.17——算上 smoke test、验证和大量推理查询总共约 $10,全部装在 Modal $30 注册赠金里。TerraNet 补了下限:Laya 在 Kaggle 的一对免费 T4 上几分钟就能微调。真正持续花钱的是推理——要么 GPU 常开,要么用待机模式拿缓慢的冷启动换便宜的空闲时间。
训练数据从哪来?
按 TerraNet 的流水线有三个来源:过去的运营决策、teacher LLM、人工复核。两个复刻都从开源 tev1 仓库起步,它那约 38,000 道训练题取自八个公开数据集——MultiNLI(蕴含)、BoolQ(是非题)、Banking77(77 类银行客服意图),再加覆盖政策、路由、研究分类的合成决策数据集。每条样本都是 Jev 形状:一个 state、一个问题、一组选项,模型学着输出一个字母。关键在于:校准集和测试集在任何训练开始之前就已切出留好。
自己训的模型能比肩官方 Jev API 吗?
把它们当成两个档次。CoderOne 的 Qwen3.5 4B 复刻在从未见过的 staging 数据上拿了约 88%,热请求一秒内出答案——能用,但它覆盖的是多选核心,不是 Jev 完整的类型化词汇表,也没有人证明它达到托管参考质量。基准数字自带噪声:TerraNet 的 Laya 微调拿到 0.766 准确率,可 ground truth 的 teacher 自我一致率只有 73.5%。要保证质量就用托管 Jev API,把自训模型当廉价兜底或数据不出内网的部署选项。
校准是什么?为什么要有单独的校准集?
校准调整模型的置信度,让 80% 的分数在你的真实流量上确实约等于八成正确率。实操手段是在留出的校准集上拟合 temperature scaling 或 Platt scaling——在训练数据上拟合这些参数几乎等于没调:TerraNet 指出 Laya 旧 notebook 的做法让温度与「什么都不做」相差 6% 以内,却制造出虚假的校准确定感。两家厂商都用 RLCD 训练校准决策,但校准只在相似于校准分布的数据上成立——流量漂移时要重新拟合,然后设一个运行阈值,把低置信度的升级案例路由给 LLM 或人工。
到底该微调,还是直接用 LLM 加提示词?
TerraNet 的回本法则:前置投入只在每天数千次查询的量级下才划算——低于它,LLM 调用的延迟和成本还能忍。CoderOne 片尾的对比表进一步收窄:要灵活、要解释、要约 256K 上下文,选预训练 LLM(Qwen3.5);要实时的类型化决策和低延迟,选决策模型(Jev 或 Laya);要每次固定同一套标签,选固定 BERT 式分类器。今天量不大,就继续用 LLM,但同时把决策连同输入用结构化格式记录下来——等你决定训练的那天,数据集已经就位。
相关推荐
什么时候该用 Jev:决策模型对比普通 LLM
最后一步背后的决策框架——类型化决策什么时候胜过直接提示 LLM。
阅读Run Jev Locally:在自己的 GPU 上跑 Kev、SemIf 与 Von
开源决策路由的自托管实操——本页流水线的部署半场。
阅读Jev API 示例
你的 Jev 式复刻所模仿的托管参考行为,逐请求拆解。
阅读开源 Jev 替代品目录
Laya 和其他可微调引擎在整个开源决策引擎版图中的位置。
阅读Jev 基准测试
决策模型怎么打分——0.362 涨到 0.766 这类数字背后的来龙去脉。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)