Guides / 视频转图文攻略
Jev 入门教程:State、三类问题与 TypeScript SDK 实操
最近更新: 2026-11-12
Codevolution 的 22 分钟 Jev 零基础课转成分步图文:什么是 System One 决策模型、state 加 Noul/Choice/Score 三类问题怎么写、只按输入计费意味着什么,以及跑通 TypeScript SDK 的完整调用。
速览结论
Jev 是 TypeSafe 推出的 System One 决策模型:你发送 state(纯文本、JSON 对象或数组)加类型化问题,它返回带校准概率的结构化答案——不生成文本、无需解析 JSON。三种问题类型:Noul(是非概率,0.94 代表 94% 是,0.03 是笃定的「否」)、Choice(从你定义的选项中挑一个,并给出每个选项的概率)、Score(在你用文字描述的量表上定位,可以落在两级之间,比如 1.02)。所有问题挂同一次调用:演示里对同一条客服消息的三个问题 834ms 全部返回,只花 458 个输入 token;输出 token 免费,按每条约 500 输入 token 估算,1 美元够查约 4.7 万条消息。API key 在 TypeSafe 控制台申请(早期访问,也可走 Vercel AI 网关),装 @typesafe-ai/sdk(需 Node.js 22 以上),对着 POST https://api.typesafe.ai/v1/systemone 调用 client.systemOne(),再用置信度做自动化闸门——视频用 0.8 阈值把「愤怒客户」标记给人工作复核。
复制即用的第一个请求
视频里用的是 TypeScript。下面是同一件事的最短版本:装官方 SDK、设置 TYPESAFE_API_KEY,然后对着 POST https://api.typesafe.ai/v1/systemone 调用一次。模型名用 jev-latest(2026-11-12 指向 jev-1.14.0);需要可复现的数字时,把版本号钉成 jev-1.14.0 或 jev-1.13.0。更完整的说明见 Jev + TypeScript 与 Jev + Python 两页。
npm install @typesafe-ai/sdk
export TYPESAFE_API_KEY="..."   # console.typesafe.ai/keys

import { choice, noul, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient({ defaultModel: "jev-latest" });

const { answers } = await client.systemOne({
  state: "I've contacted you three times, and I'm still waiting.",
  questions: {
    isFrustrated: noul("Does the message express frustration?"),
    requestType: choice("What is the main request?", {
      update: "Asking for a status update",
      refund: "Asking for money back",
      replacement: "Asking for a replacement",
      other: "Anything else",
    }),
  },
});

console.log(answers.isFrustrated.noul);       // 0-1 probability
console.log(answers.requestType.choice);      // "update" | "refund" | ...
console.log(answers.requestType.confidence); // calibrate before you gatepip install typesafe-sdk
export TYPESAFE_API_KEY="..." # console.typesafe.ai/keys
from typesafe_sdk import Choice, Noul, TypeSafeClient
with TypeSafeClient(model="jev-latest") as client:
response = client.system_one(
state="I've contacted you three times, and I'm still waiting.",
questions={
"isFrustrated": Noul(
instructions="Does the message express frustration?",
),
"requestType": Choice(
instructions="What is the main request?",
criteria={
"update": "Asking for a status update",
"refund": "Asking for money back",
"replacement": "Asking for a replacement",
"other": "Anything else",
},
),
},
)
print(response.nouls["isFrustrated"].noul) # 0-1 probability
print(response.choices["requestType"].choice) # "update" | "refund" | ...
print(response.choices["requestType"].confidence) # calibrate before you gate完整说明: Jev + TypeScript · Jev + Python · 在 Playground 里先试 schema · 客服工单路由配方
分步图文攻略
- 1
从一句代码写不出的判断开始
满三件免运费是普通的 if 语句;「这位客户听起来不耐烦了」就不是了——"I've contacted you three times, and I'm still waiting" 全句没有一个「愤怒」,但每个读的人都懂。这段「能硬编码的规则」与「藏在语言里的判断」之间的空白,正是 Jev 所在的位置:把消息交给模型,问它客户是否听起来不耐烦,拿回一个带概率的直接答案。TypeSafe 借卡尼曼「快思考」的概念叫它 System One 模型;名字则致敬杰文斯悖论——当决策便宜到这个地步,你会把从前只能留给人的判断全部自动化。
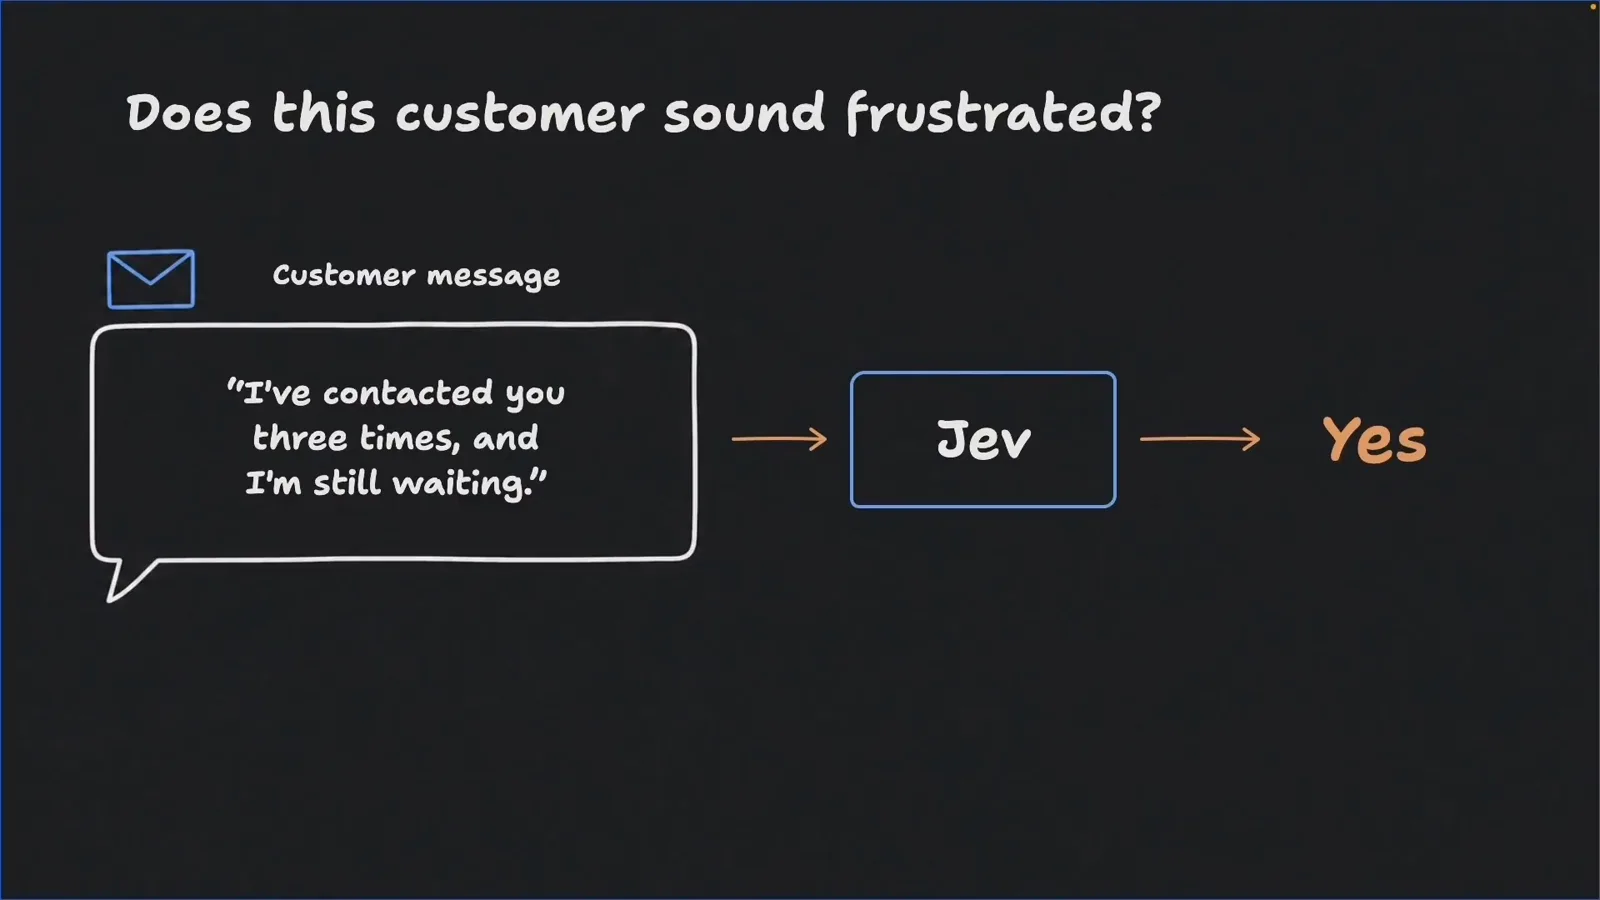
关键词表抓不住这句话——听得懂语言的判断可以。跳转至 1:35 - 2
发 state 加问题,而不是聊天 prompt
一次 Jev 请求分两半。state 是要判断的信息——纯文本、JSON 对象或数组都行,这里就是客户消息。questions 说明你想从这条信息里知道什么,每个问题都带类型:Noul 问是非,Choice 从你定义的选项里挑,Score 在你描述的量表上定位。TypeSafe 给出的响应时间是 70-500ms,答案以结构化数据直接返回给你的代码——不是需要解析的句子。视频里的对比很直白:GPT 花了约 8.6 秒的事,Jev 114 毫秒出结果,成本约为其 1/170。
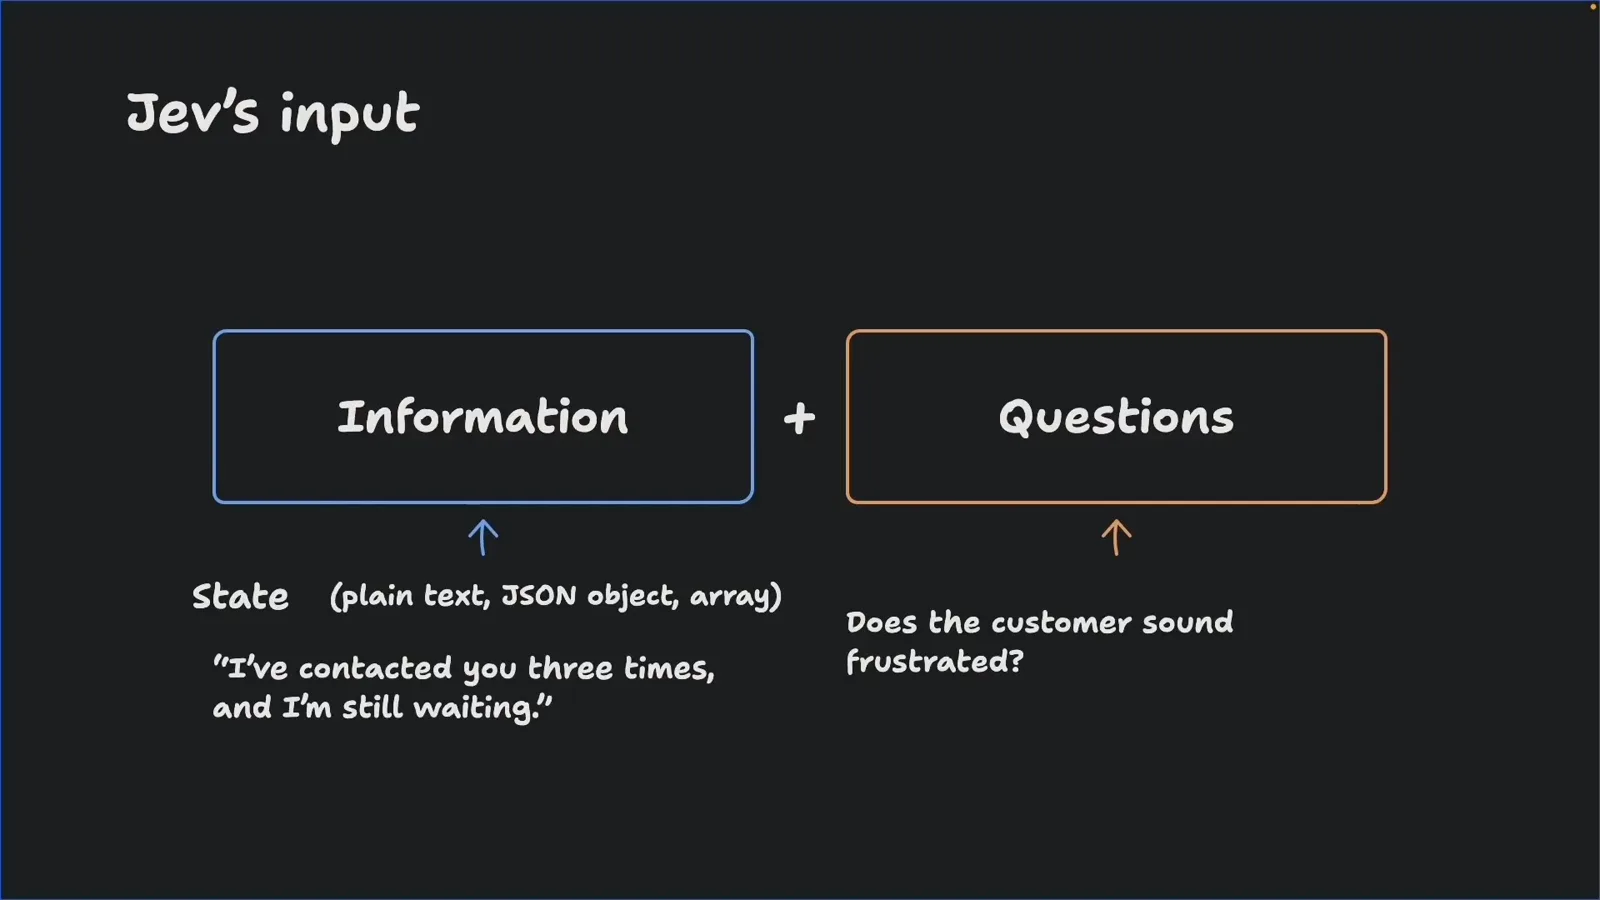
state 是判断对象,问题是类型化的——Noul、Choice 或 Score。跳转至 6:52 - 3
让 Choice 从你的菜单里挑——永远留一个「其他」出口
当你已经知道分类桶时,用 Choice。问「这条消息的主要诉求是什么?」并定义选项:要求跟进进度、要求退款、要求换货——再加一个 something else,接住分类体系之外的所有消息,模型永远不会被迫贴一个错误标签。Jev 返回被选中的选项、每个选项各自的概率,外加一个置信度,让你的代码可以自动处理高置信案例、其余进人工队列。Score 同理,只是换成你逐级用文字描述的量表(0:没有不满;1:不满但没有愤怒;2:强烈愤怒),而且因为是加权平均,结果可以落在两级之间——1.5 就是真卡在「不满」和「愤怒」中间。
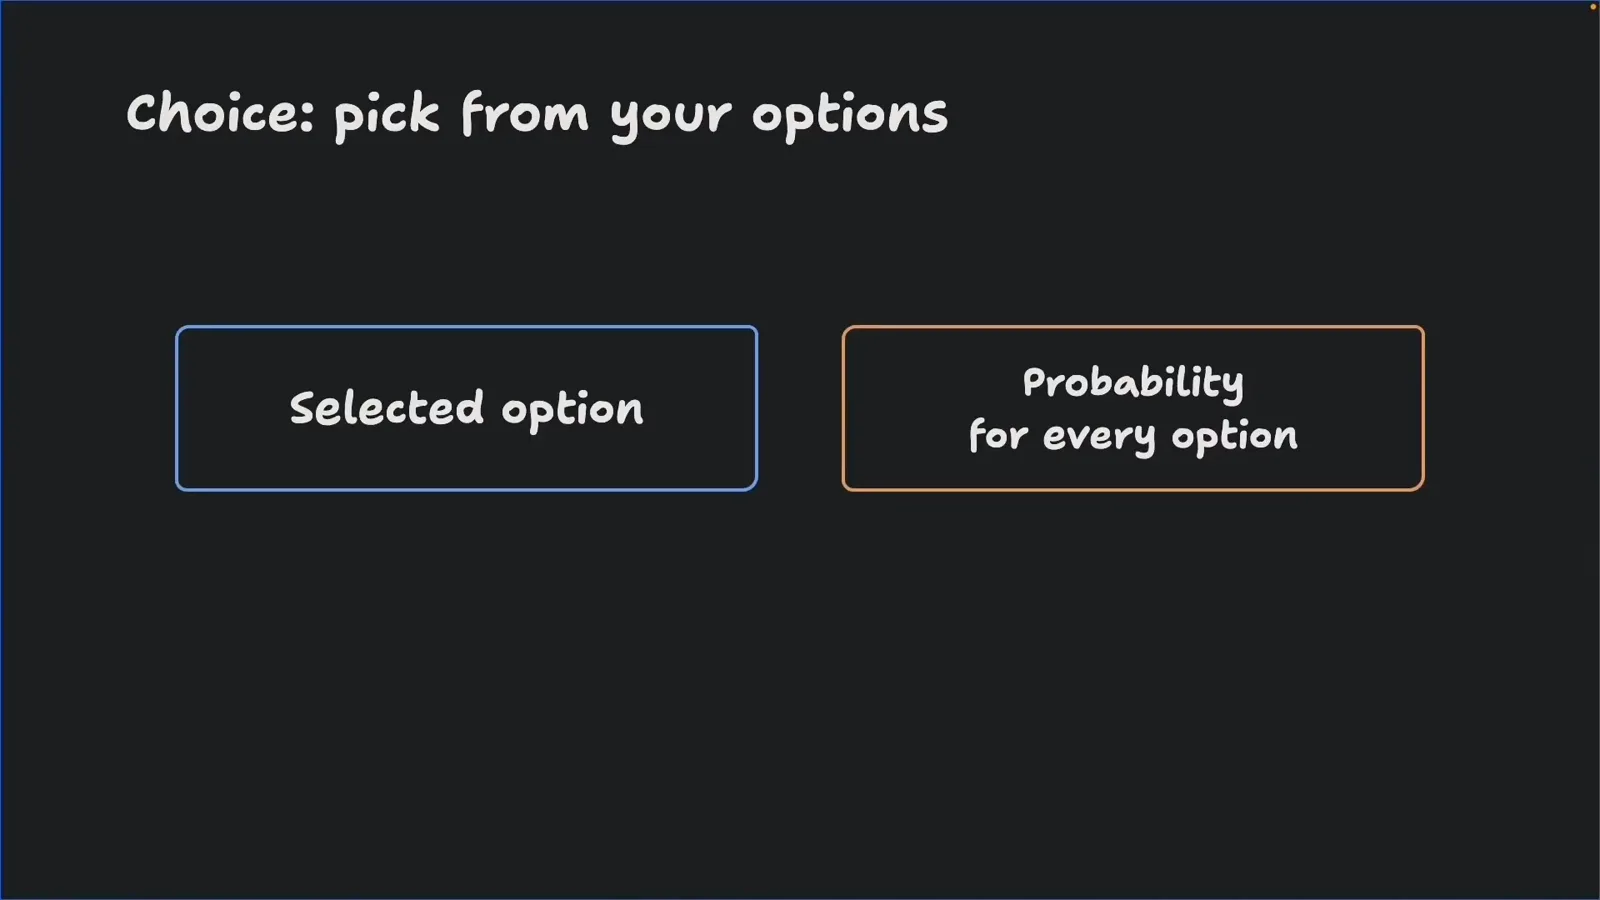
菜单你来定;Jev 负责挑,并把每个选项的概率都亮出来。跳转至 8:20 - 4
全面自动化之前,先算清一次判断的价格
Jev 只按输入计费:每百万输入 token $0.042(约 42 美元十亿),输出 token 全免——因为模型根本不生成文本。视频用「愤怒检测」算了一笔账:一条消息加问题约 500 输入 token,1 美元大约够查 4.7 万条客户消息。这笔账让「全量检查每一张工单、每条评论、每次表单提交」从预算会议议题变成无聊的常规操作。早期访问期间,Jev 在 9 月 23 日前免费,可通过 TypeSafe 官网 waitlist 或 Vercel AI 网关体验,API key 从 TypeSafe 控制台签发。
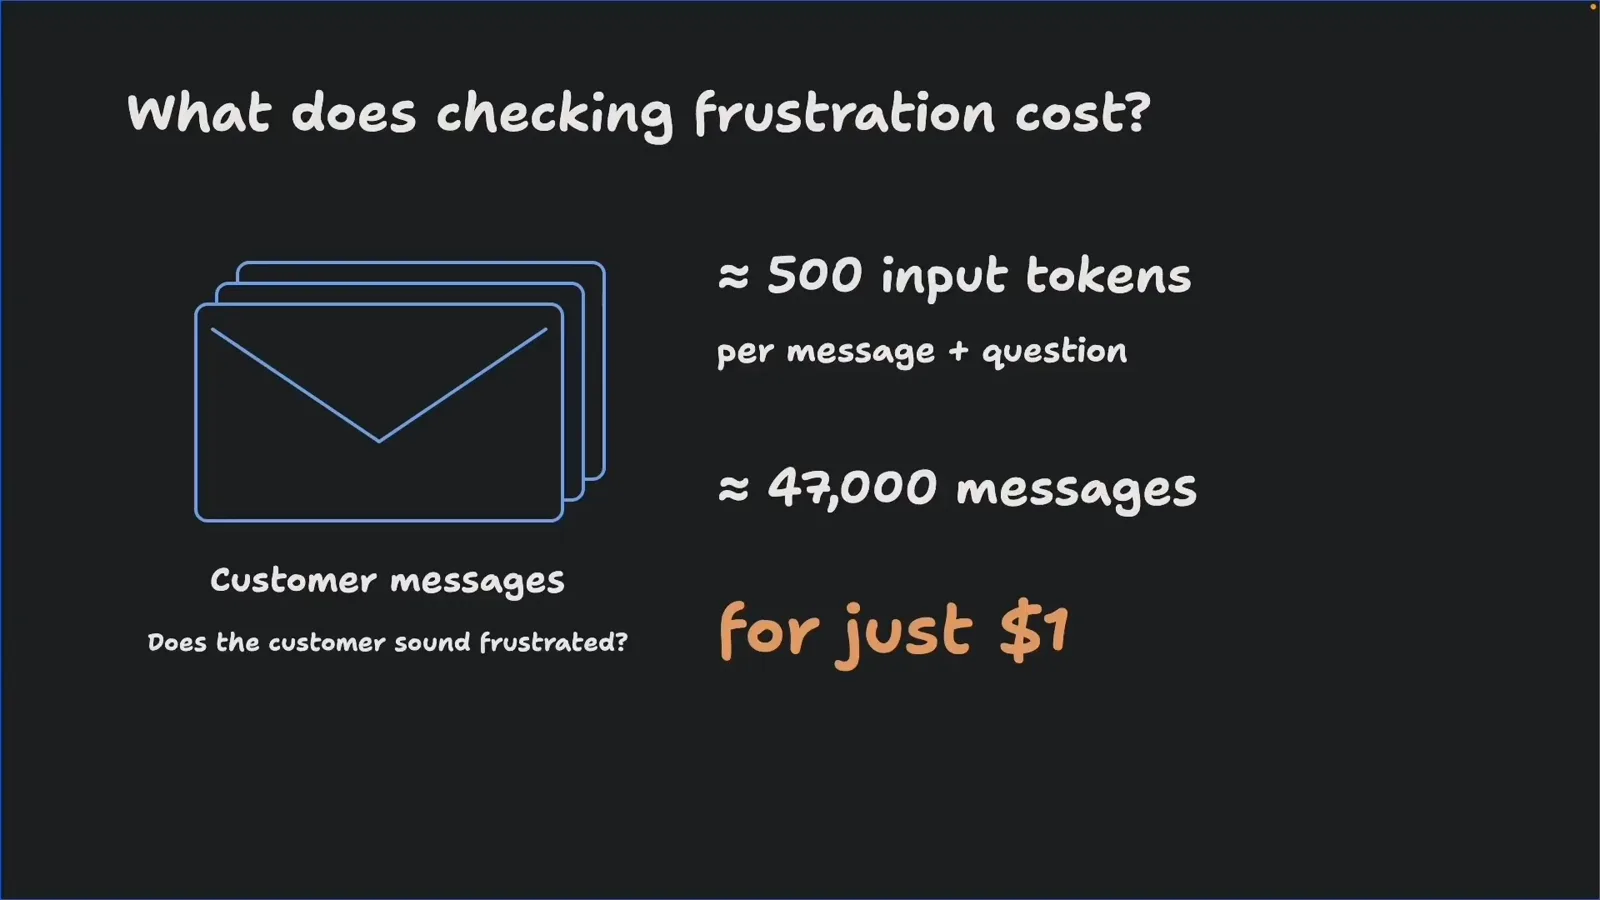
单次检查约 500 输入 token——1 美元约查 4.7 万条。跳转至 5:52 - 5
用 TypeScript 发出同一个请求
TypeSafe SDK 把沙盒实验变成三行应用代码。安装 @typesafe-ai/sdk,把 API key 放进 .env,然后导入客户端和问题助手:import { choice, noul, score, TypeSafeClient } from "@typesafe-ai/sdk"。先写好 state——message: "I've contacted you three times, and I'm still waiting."——再调用 client.systemOne(),传入 state 和 questions 对象:isFrustrated: noul("Does `message` express frustration?")、requestType: choice("What is the main request in `message`?", { update: "...", refund: "...", replacement: "...", other: "..." })、frustrationLevel: score("How much frustration does `message` express?", [各级描述])。npm run demo 跑完返回 model jev-1.13.0,isFrustrated 0.94(这是录制时的当前版本;今天同样的调用用 model jev-latest 会解析到 jev-1.14.0,需要可复现的数字时请钉版本号);把消息换成 "Thanks for the update, everything works now." 再跑,数值掉到 0.03——一次笃定的「否」。
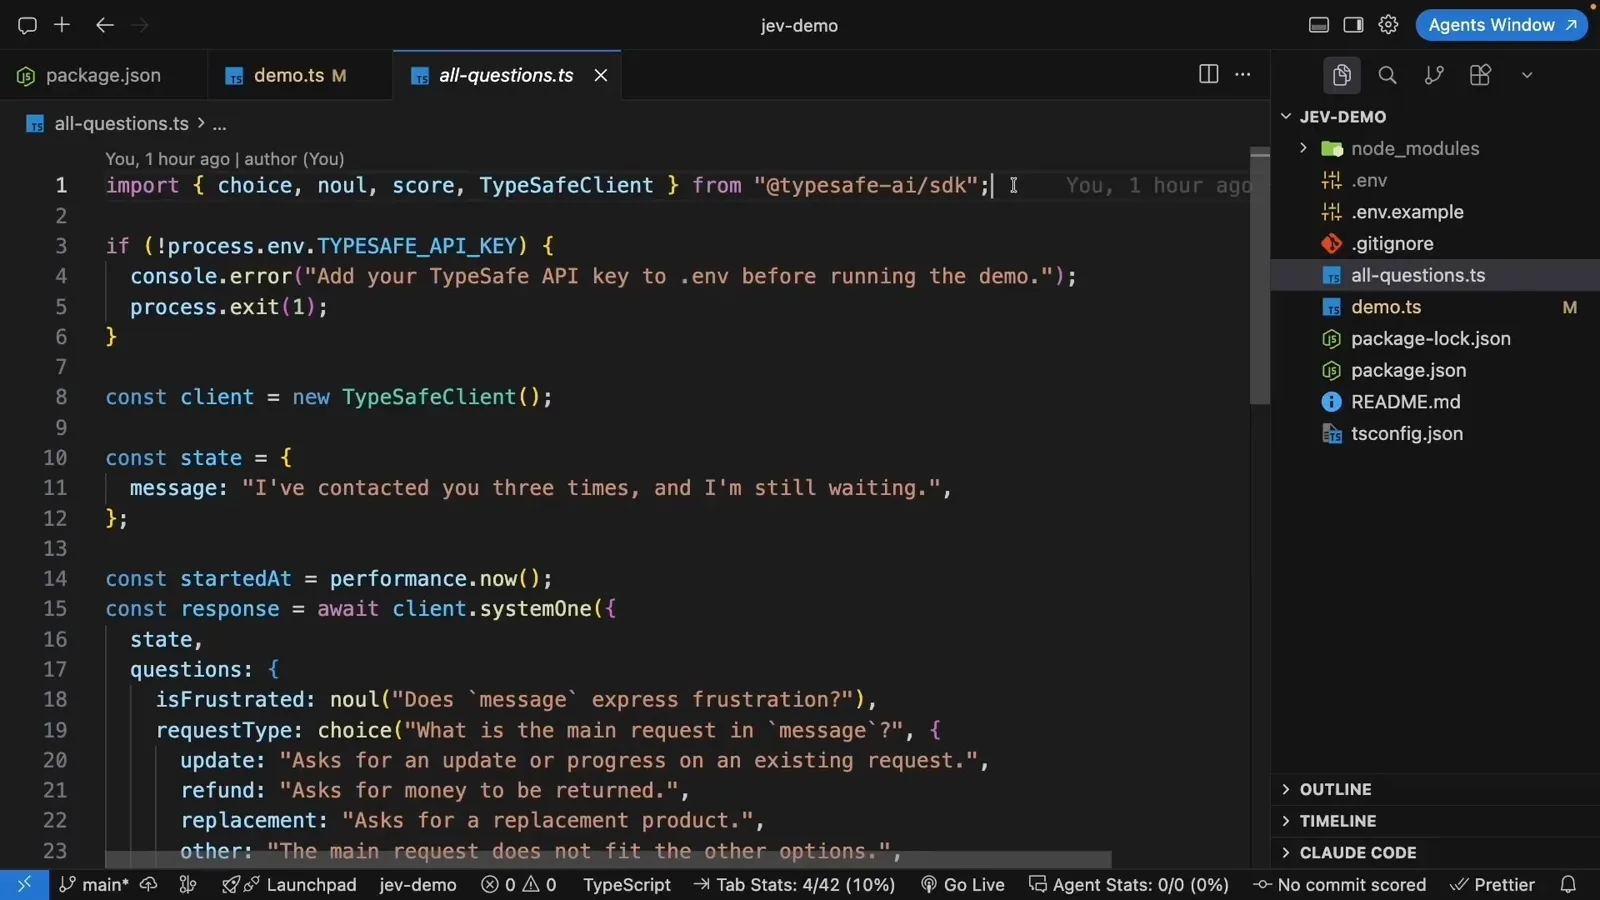
一个客户端加类型化助手——整个请求就是普通 TypeScript。跳转至 16:40 - 6
一次调用读回三个答案,再用置信度做闸门
三个问题共享同一个 state,所以一次调用全部返回:终端里 isFrustrated { type: "noul", noul: 0.94 },requestType { type: "choice", choice: "update", confidence: 0.99, probabilities: { replacement: 0, update: 0.99, refund: 0, other: 0.01 } },frustrationLevel { type: "score", score: 1.02, confidence: 0.97, probabilities: { "1": 0.98, "2": 0.02 } }——458 输入 token、84 输出 token、耗时 834ms。答案有效不代表正确,所以置信度是旋钮不是保证:演示代码只在数值越过 0.8 阈值时把客户标记给客服复核,否则留在普通队列。拿自己的样本调这个阈值——这份校准功夫才是自动化的可信度来源。
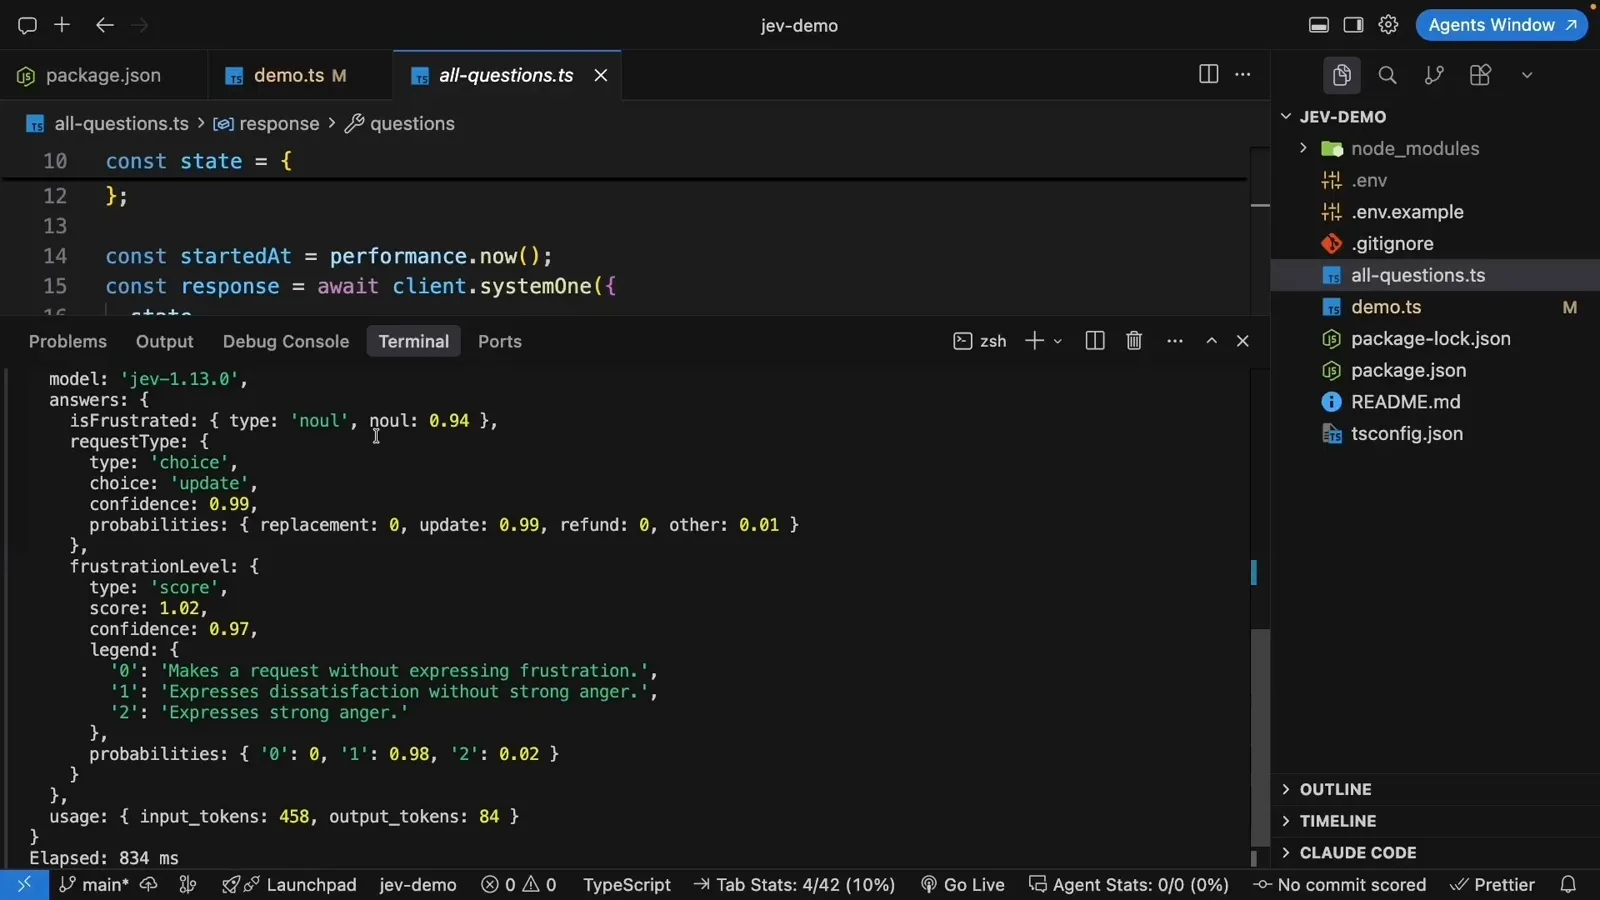
三问一趟,834ms——自动化与否,交给置信度闸门。跳转至 17:46
常见问题(FAQ)
一句话说清 Jev 是什么?
Jev 是 TypeSafe 推出的 System One 决策模型:发送 state 加类型化问题,拿回带校准概率的结构化答案——不生成文本、不用解析 JSON,通常 70-500ms 返回。名字来自杰文斯悖论:决策一旦足够便宜,应用对它的用量会成倍增长。
Jev 和直接问 GPT、Claude 有什么区别?
通用模型当然也能做判断,但它们逐 token 生成答案,而且还要负责写作、解释和写代码。Jev 只做判断,单次前向并行算出答案概率——视频例子里 GPT 用了约 8.6 秒,Jev 114 毫秒,成本约 1/170,而且输出保证符合你定义的结构。
Noul、Choice、Score 分别是什么?
Noul 回答是非题,返回「是」的概率——0.94 代表 94% 是,而 0.03 这样的低值代表笃定的「否」,不是犹豫。Choice 让模型从你定义的选项里挑一个,返回每个选项的概率和总体置信度。Score 把输入定位到你逐级描述的量表上,结果是加权平均,可以落在两级之间——1.02 就是刚过 1 级。
跑 Jev 要花多少钱?
输入 token 每百万 $0.042,输出免费,按单条约 500 token 计算,1 美元约能查 4.7 万条消息。模型不生成文本,所以没有输出侧账单。早期访问阶段 9 月 23 日前免费,入口是 TypeSafe waitlist 或 Vercel AI 网关。
相关推荐
Jev 是什么?
概念页:System One 与 System Two,类型化决策的位置。
阅读Jev 分类极速上手
下一步实操:对着 OpenRouter API 跑 Choice、Score、Noul。
阅读Jev TypeScript 实战
把 SDK 接进 Node 路由,补上错误处理与阈值。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
- Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
- Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
- Jev 接入 Codex 实操:typesafe-ai/skills 安装与 Gmail 30 封邮件分诊
- Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
- 自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
- CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
- 用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门
- Ollama 决策模型实测:tev1 + nimble 跑在 8GB 显卡上
- Jev 生产环境护栏:五步接入实战手册
- Pi Agent 防跑偏插件实战:让 Jev 出概率,让代码做决定
- Tev1 用例实测:50 个任务看尽本地决策模型的能力边界
- Jev 实测:官方宣称与独立复测之间的距离
- Jev 工单分类实战:after-insert hook 与计算字段两种接法
- OpenJev RLCD 实操:开源校准决策模型本地部署全指南
- Clef-Flash vs Jev 实测:把 Cloudflare 决策模型装进 Ollama(Q4_K_M)
- Clef-Flash 实操教程:在 Ubuntu 上从零安装并本地运行 Cloudflare 9B 多模态决策模型
- CLM-8B 架构深潜:44 毫秒打分 1,024 个候选的对比决策模型(比 Jev 快 13 倍)
- Nox 4B 实测教程:本地跑通 Decision 2.0 决策模型,四道真实考题与一次诚实的失败
- Julia-1 实操教程:纯 Python 装上开源 Jev 替代品,10 条客服消息实测 9 比 2
- OpenJev 0.8B CPU 实战:用工单收件箱校准 NLI 路由阈值
- Jev n8n 集成实战:JevGate 社区节点分步攻略(附纯 HTTP 备选路线)
- NanoJev 实操教程:本地部署 0.6B 开源 Jev 复刻,亲眼看它以 47ms 跑迷宫、按概率做路由
- PPLX Decider 实操教程:Perplexity 开源 27B 决策模型、Decisions API 与 12 张工单的分诊实测
- AutoTrust JEV-27B 本地实测:四臂对照、72 道 held-out 题,和一个 0.969 高分的错误答案
- Clef 27B 本地实战:Cloudflare 多模态决策模型一次读懂图片、视频和乌兹别克语报纸
- Ollaya 实操指南:装好「决策模型界的 Ollama」,看清每一个厂商口径数字,再亲手补上它留白的 CPU 实测
- Strands Decider 2B 实测:8GB 笔记本本地安装 AWS Strands 系决策模型,把失败段也留在这页里
- Liquid AI Open d1 本地实测:d1-3B 与 d1-omni-600M 跑进 MacBook Air M5
- 图像决策模型实战 RPA:Imajev-4B 与 Jev-Omni 无 OCR 直读 W-8BEN 税表,90% 置信阈值以下转人工审核
- GLiNER2.5-Decide (340M) 对比 Jev (4B):决策模型到底谁赢?逐帧核对选型指南
- Jetson 边缘实测:Jev、Strands Decider 2B、Laya、d1-3B 四模型横评——Skill Master 记分卡、Thor 延迟账与 JevBench 逐帧核对
- 微软 Decision-1 实测:146 道独立测试、93% 均分、高置信时 124/125——每个数字逐帧核过
- Jev 接入 Azure AI Foundry 实战:OpenAPI 工具、分诊指令与首跑失败复盘