
Guides / 视频转图文攻略
微软 Decision-1 实测:146 道独立测试、93% 均分、高置信时 124/125——每个数字逐帧核过
把 AI WITH Rithesh 的微软 Decision-1 独立评测整理成分步图文:普通大模型与决策模型的对照卡、从 Jev 到微软的五周时间线、贴着「厂商口径」标签的官方宣称、全程走 OpenRouter 的 146 题 17 组实测、93% 均分与十个满分题组、判断题组的失分、校准双卡(置信超 90% 时 124/125、低于 70% 时 2/7)、180 次改写零翻转、32,768 token 上下文硬上限,以及一美分的总账单——每个卡面数字都逐帧放大核对过。
速览结论
一次前向看完这支视频:微软 Decision-1 是一个永不写句子的决策模型——state 读一遍、每个允许答案返回一个校准概率、单次前向、零生成 token——2026 年 10 月 9 日发布,输入 0.042 美元/百万 token、输出免费(OpenRouter:microsoft/microsoft-decision-1;也在 Azure Foundry 上,本实测刻意绕开了它)。品类对照卡出自微软自家文档:普通大模型 = 输入 → 逐 token 写 → 「我觉得这大概是计费问题,因为……」;决策模型 = 输入+允许答案 → 一次前向 → billing 0.997 · technical 0.001 · account 0.001。身份(按视频口径):底座是阿里巴巴开源 Qwen3.5(90 亿参数),被改造为单次前向评估;只有一个尺寸、只读文本;微软称后续会把这套做法迁移到自家与 OpenAI 模型上,且自评用的就是 Jev 基准。时间线卡:Jev/TypeSafe(9 月)→ Laya/开源(9 月)→ Clef/Cloudflare(10 月 1 日)→ Decider v1.1/Perplexity(10 月 6 日)→ Decisions API/OpenAI(10 月 6 日)→ d1/Liquid AI(10 月 7 日)→ Decision-1/微软(10 月 9 日)。厂商口径宣称(保持距离看):36 个基准、约 15 万 held-out 题准确率最高;中位延迟比 GPT-6 Sol 快 35 倍;一万多条 Xbox 反馈上质量与 GPT-6 Sol 相当、便宜约 200 倍;改写或乱序仅 1.3% 翻转。独立实测:146 题横跨 17 组、每道带标准答案,外加 36 次长文档调用与 180 个扰动请求,全程 OpenRouter、班加罗尔出发(2026 年 10 月 12 日)。记分卡:均分 93%;十组满分 100%(工单路由、玩家反馈主题、钓鱼邮件、提示注入、内容审核、JSON 校验、覆盖 10 种语言加混语 Hinglish「Bro, OTP is not coming at all」的多语言组、代码漏洞、CSV 行欺诈、HTML 页面类型);模型路由 90%、缺陷严重度 88%、多问题调用 88%、LLM 裁判 81%、日志分诊 81%、智能体护栏 80%、搜索相关性 75%。失败模式:失分全是判断题,引用的错例都偏谨慎——无害代码修复前先要批准、把真实附加事实判成幻觉。校准(全视频最重要的一段):置信超 90% 时 124/125 对、低于 70% 时 2/7 对、校准误差 0.025——一道可用的闸门:有信心就行动,其余升级给人或更大的模型。鲁棒性:180 次改写/乱序/改名/加空格/包 JSON,零翻转——微软的 1.3% 在这份数据上偏保守。上下文:约 19K token 以内条款每次都找到;约 33K 直接拒绝;硬上限 32,768 token 含决策 token(HTTP 422)——长输入先切分。速度:经 OpenRouter 到 Azure 中位约 620 毫秒,对 OpenRouter 页面标的约 230 毫秒——大头是网络。成本:整个实验约一美分。收尾论点:别当聊天机器人——把它当 agent 的管理层,负责指挥、打标签、评估、拦截;「知道自己什么时候不确定」这个属性,正是放手让 agent 自主行动前最需要的东西。
分步图文攻略
- 1
Decision-1 是什么:一个永不写句子的模型
视频开头用一张卡讲完整个品类,卡面来源是微软自家文档。普通大模型拿到输入后逐 token 写答案:「我觉得这大概是计费问题,因为……」——写出来的是要再去解析的自然语言。决策模型拿到输入加一组允许答案,一次前向,给每个答案返回一个概率:billing 0.997、technical 0.001、account 0.001。你可以问是否题、给选项列表、或要一个刻度分——代码拿到数字就直接行动:模型有信心就继续,没信心就把任务转给人。价格是另一个头条:输入 0.042 美元/百万 token、输出免费。还有一个值得一句话说清的名字问题:Decision-1 是带连字符的模型名——不是「第一个决策模型」的宣言,下一步的时间线会把这话说得更清楚。
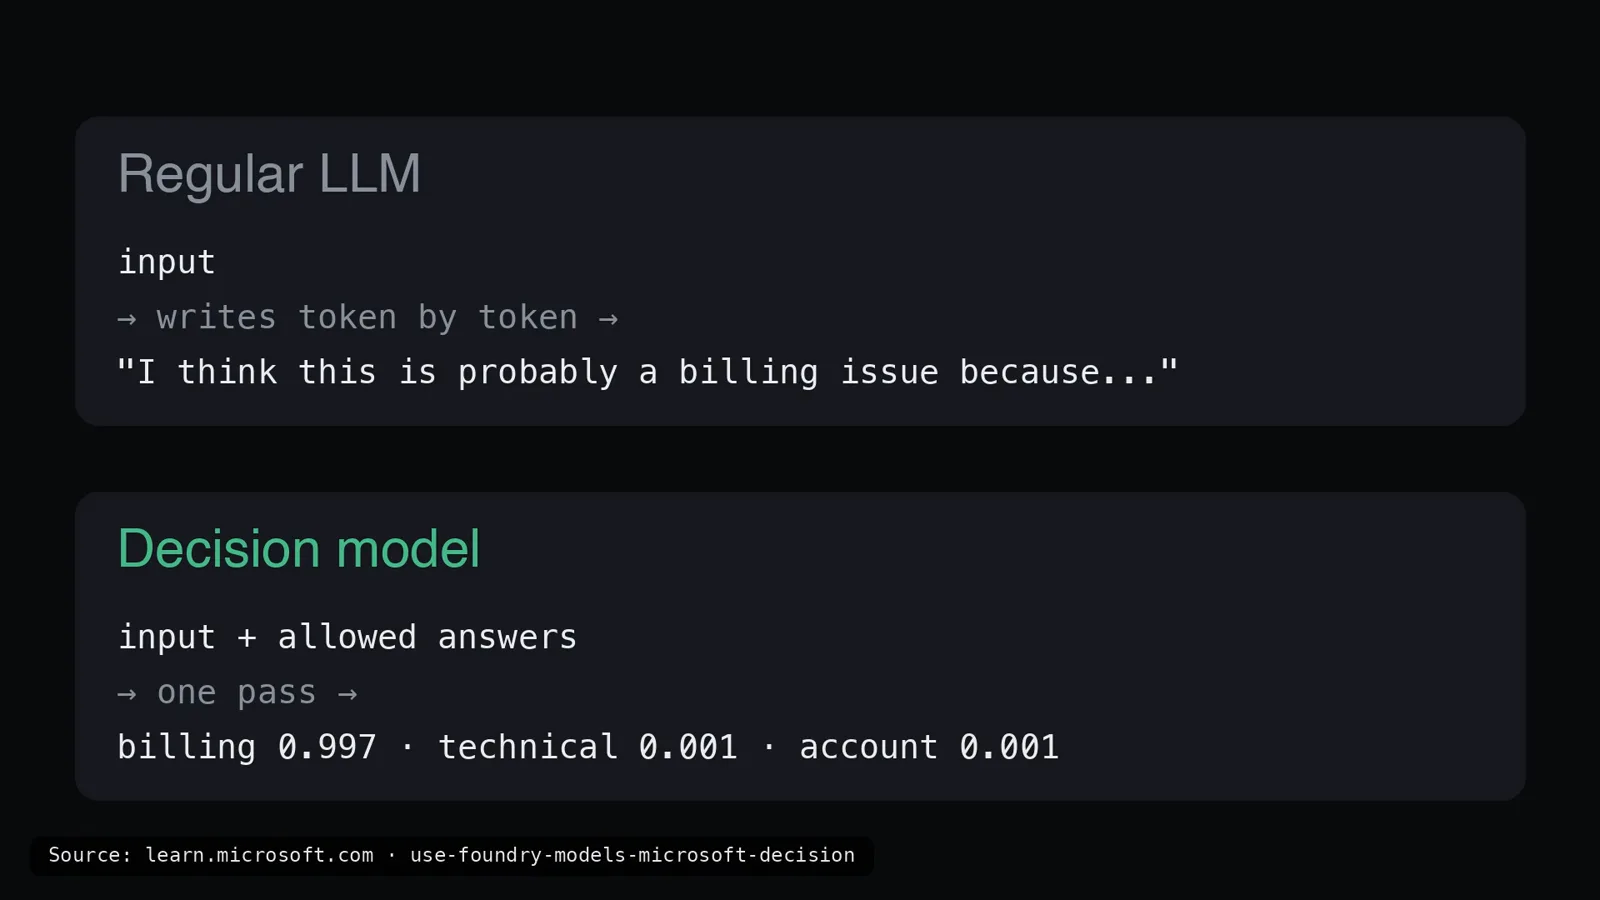
一次前向、三个概率、零句子——品类定义就印在微软自家文档卡上。跳转至 0:45 - 2
从 TypeSafe 到微软:五周走完的浪潮
这个点子由小初创 TypeSafe 的 Jev 提出,时间线卡把后来的节奏摆得一目了然:9 月有开源的 Laya,10 月 1 日 Cloudflare 的 Clef,10 月 6 日 Perplexity 的 Decider v1.1 和 OpenAI 的 Decisions API,10 月 7 日 Liquid AI 的 d1,10 月 9 日微软的 Decision-1。卡上还点了一句:微软连自评用的都是 Jev 基准。按视频说法,底座是阿里巴巴开源的 Qwen3.5——一个 90 亿参数模型,被微软改造成单次前向做评估;官方称后续会把这套做法迁移到微软自家与 OpenAI 模型上。两个影响规划的边界事实:目前只有一个尺寸,而且只读文本。
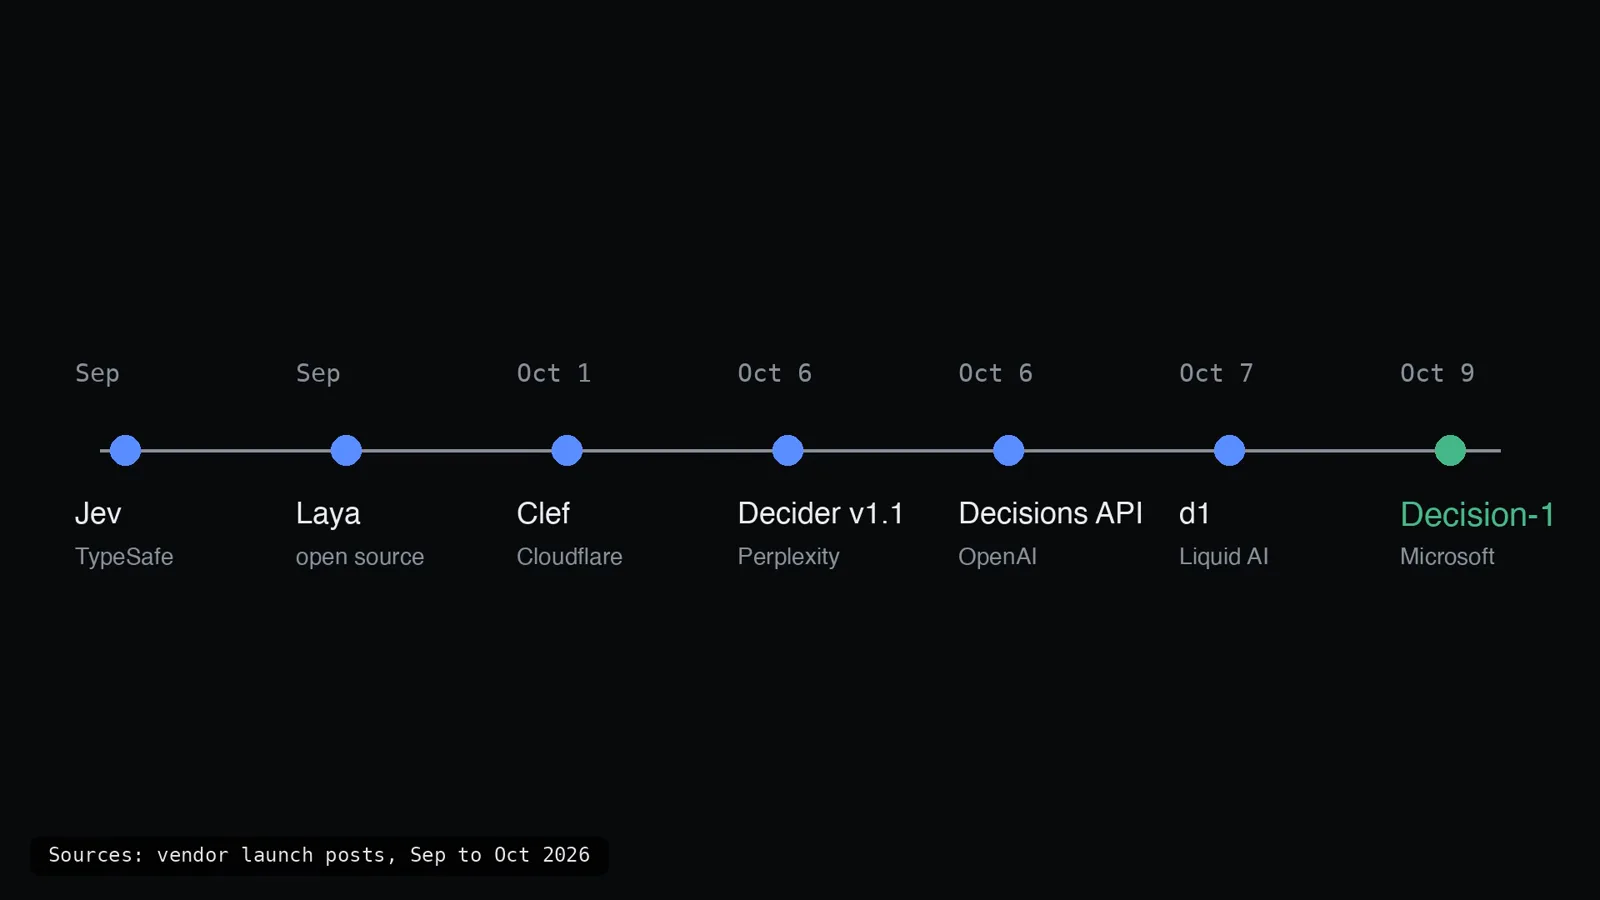
从一家初创的点子到微软发布,五周走完——每一站卡面都点了名。跳转至 1:06 - 3
厂商宣称:贴着标签看
跑任何东西之前,视频先把微软的数字摆上屏——标签也贴得恰如其分:「Microsoft says / vendor-reported(厂商口径)」。宣称内容:在 36 个基准、约 15 万道它从没学过的 held-out 题上准确率最高;中位响应速度比 GPT-6 Sol 快 35 倍;Xbox 团队用它分拣一万多条玩家反馈,质量与 GPT-6 Sol 相当而成本只有约 1/200;请求措辞或顺序改变时,只有 1.3% 的答案翻转。这些是微软的数字、微软口径的测法——视频剩下的部分,就是评测者拿自己的题组验证这些数字的真身,而这也才是你该抄进自己决策流程的那一步。
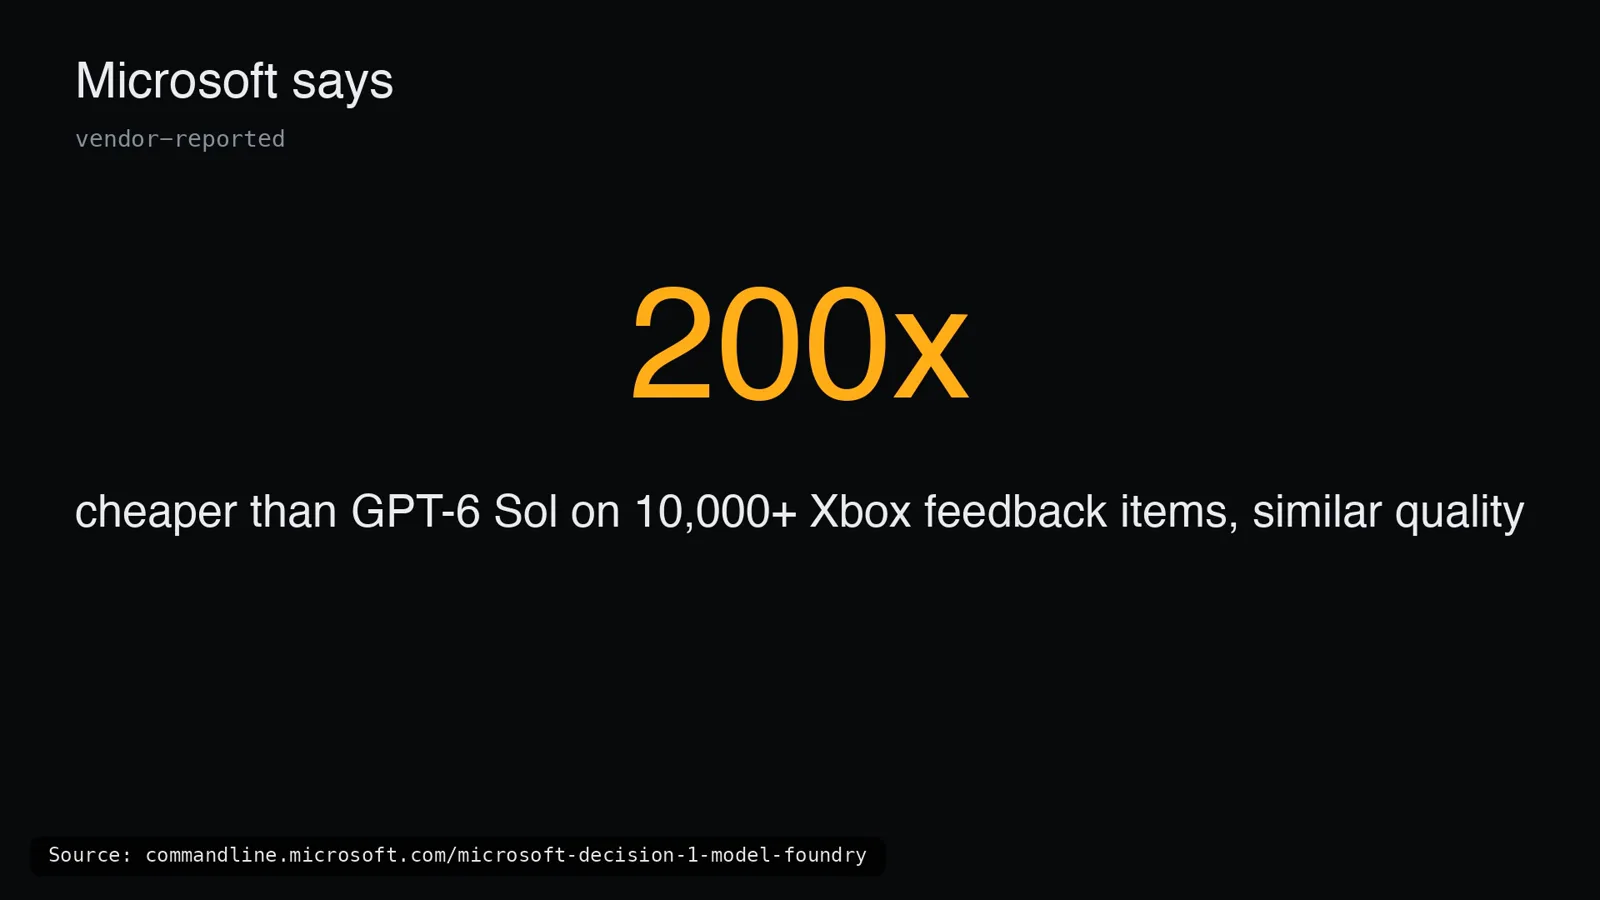
「Microsoft says, vendor-reported」——本页剩下的内容就是在压测这个标签。跳转至 1:53 - 4
实测台:146 道题 17 组,完全不配 Azure
评测者的实测台三张卡讲完。146 道测试题横跨 17 组,每道都预先写好标准答案——工单式路由、钓鱼邮件、日志、代码、CSV 行、网页、十种语言。36 次长文档调用,把一条条款轮流藏在开头、中段、结尾。再加 180 个改写乱序请求做鲁棒性检查。两个让任何人都能复现的选择:全部请求走 OpenRouter(模型 id microsoft/microsoft-decision-1),所以 Azure 一步都没配;全部实验在班加罗尔的笔记本上跑完——每张卡的 source 行都记着日期:2026 年 10 月 12 日。看下面的分数时记住规模:146 道计分题是一场扎实的实地测试,不是一个基准套件。
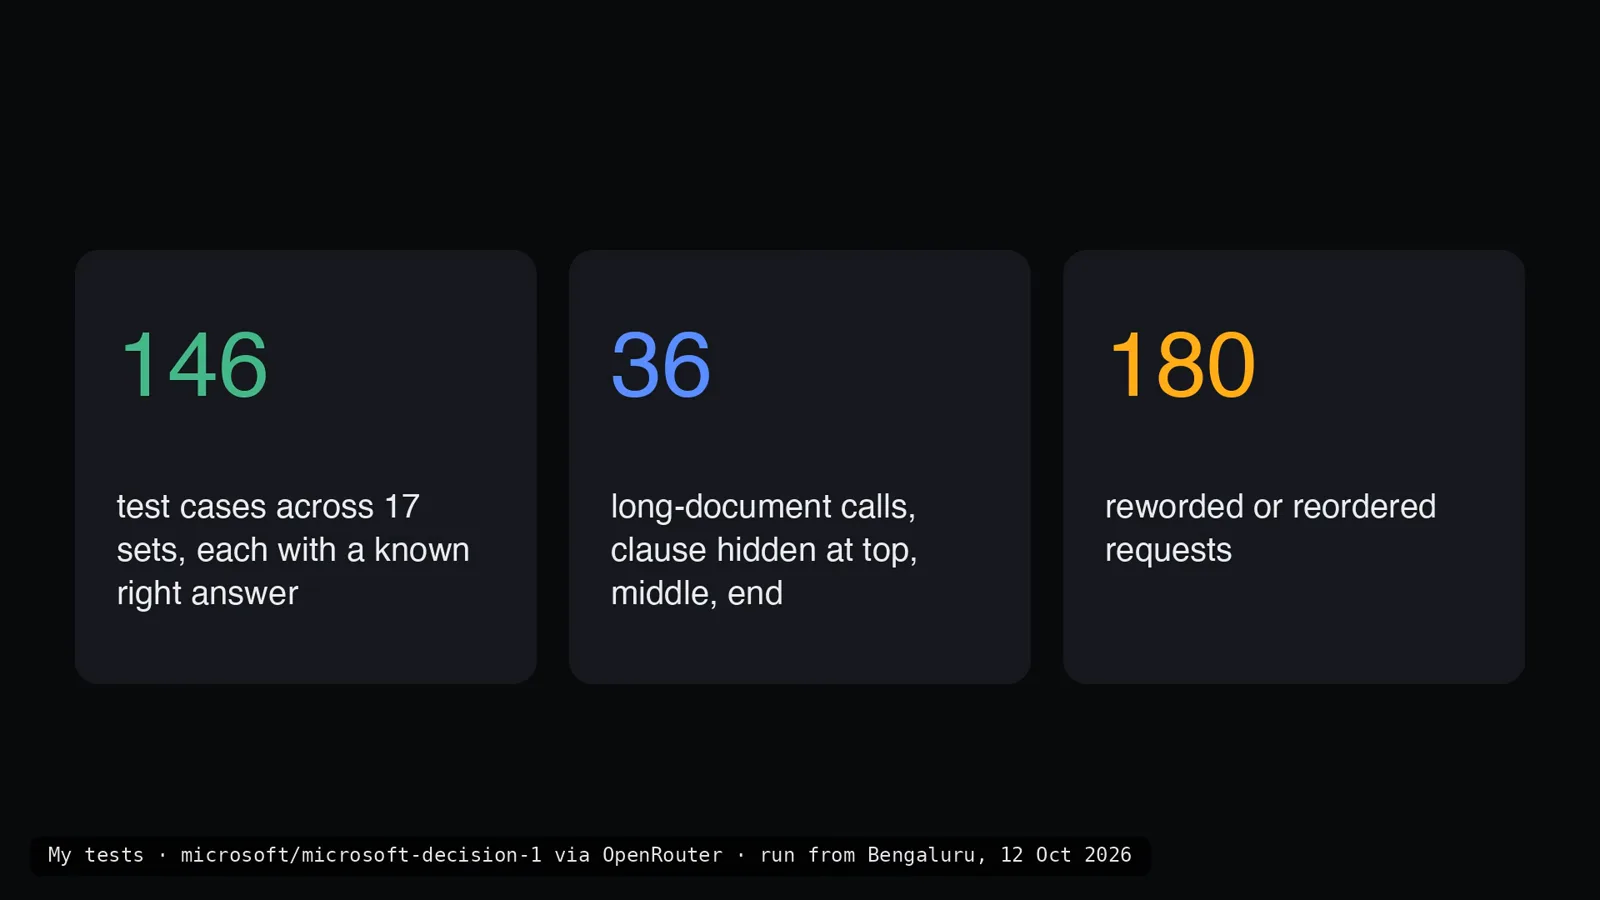
整个实验三张卡讲完:146 道计分题、36 次长文档探针、180 个扰动。跳转至 2:28 - 5
记分卡:均分 93%,17 组里 10 组满分
头条图表不用眯眼看:均分 93%,十七组里十组 100%——工单路由、玩家反馈主题、钓鱼邮件、提示注入、内容审核、JSON 校验、多语言、代码漏洞、CSV 行欺诈检测、HTML 页面类型。多语言那组值得单独一句:10 种语言加混语输入——印地语、卡纳达语、泰米尔语、日语、阿拉伯语,还有「Bro, OTP is not coming at all」这种 Hinglish——全对。镜头里,法语「我想要上个月付款的发票」以 99.9% 路由到 billing,德语「包裹标记已送达但从没到货」以 99.9% 路由到 shipping。绿杠以下:模型路由 90%、缺陷严重度 88%、多问题调用 88%,以及下一步要细看的四个判断题组。
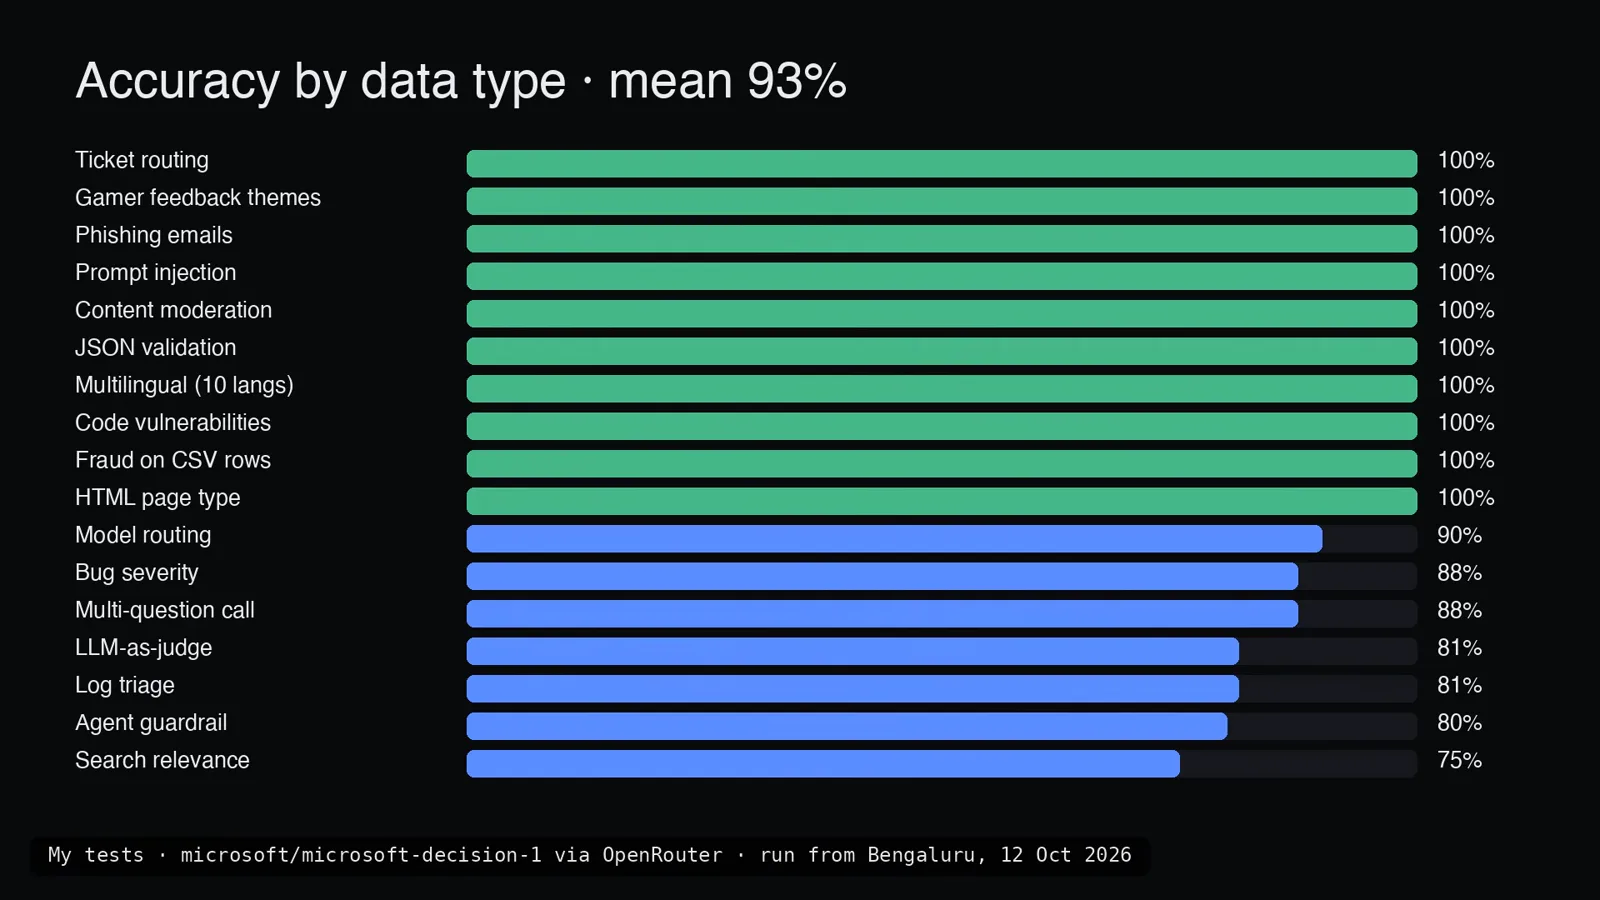
十条 100% 的绿杠——而多语言那一行,恰恰是微软发布稿没强调的。跳转至 2:33 - 6
失分的地方:全是判断题
所有失分都出在「判断」而非「事实」:搜索相关性 75%、智能体护栏 80%、LLM 裁判 81%、日志分诊 81%。比百分比更有教学价值的是两处引用的错例。第一,模型在做无害代码修复前先要求批准——不需要人工签字的地方它不敢动手。第二,它把一条真实的附加事实判成了幻觉——把正确的新信息当成了编造。评测者的解读是对的:不确定时它偏谨慎,而对一道防护护栏来说,这正是你想要的偏差。偶尔拦下本可放行操作的护栏,代价是几分钟;放行破坏性操作的护栏,代价是一次事故。
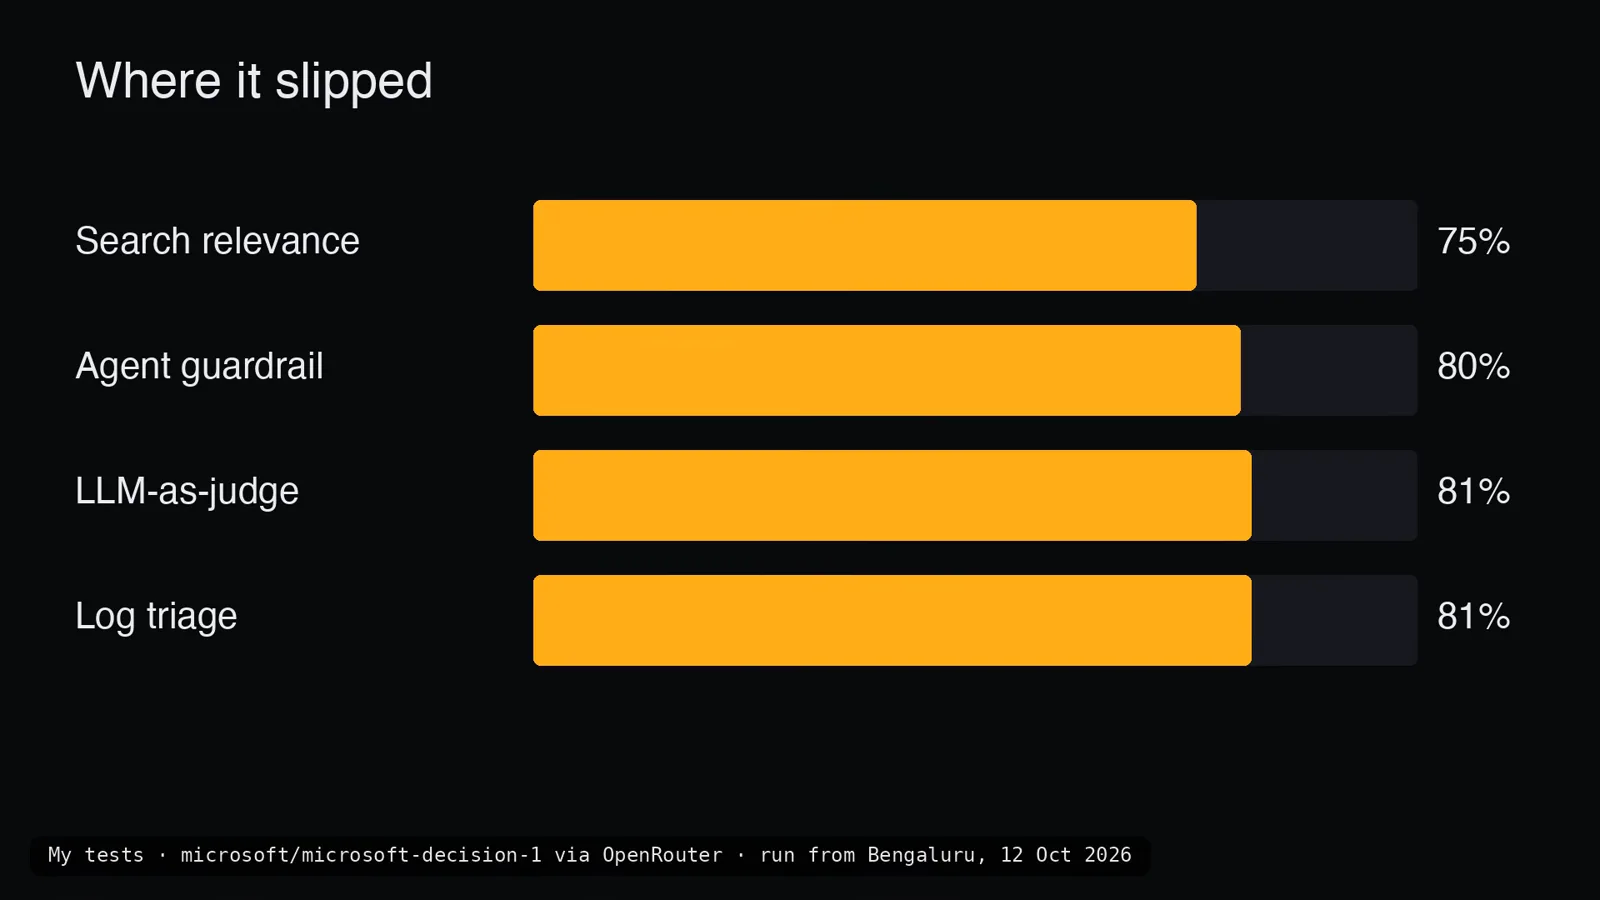
失分全是判断题——两处错例也都错在偏谨慎这边。跳转至 3:09 - 7
校准:最重要的部分
这是评测者亲口说「对我最重要」的一段,也是最值得在工程上复用的一段。凡模型自称置信度超 90% 时,125 次里对 124 次;凡低于 70% 时,7 次里只对 2 次。全程校准误差 0.025(越低越好)。翻译成操作语言:这个置信度指标真的能用——模型有信心就让它行动,其余转给人或更大的模型。正是这个属性把决策模型从一个分类器变成了基础设施:它返回的数字,能告诉你该怎么对待它返回的数字。老规矩的诚实声明也要带上:132 道带标签的题是小样本单次运行,这道闸门上生产前,先在你自己的标签上验一遍。
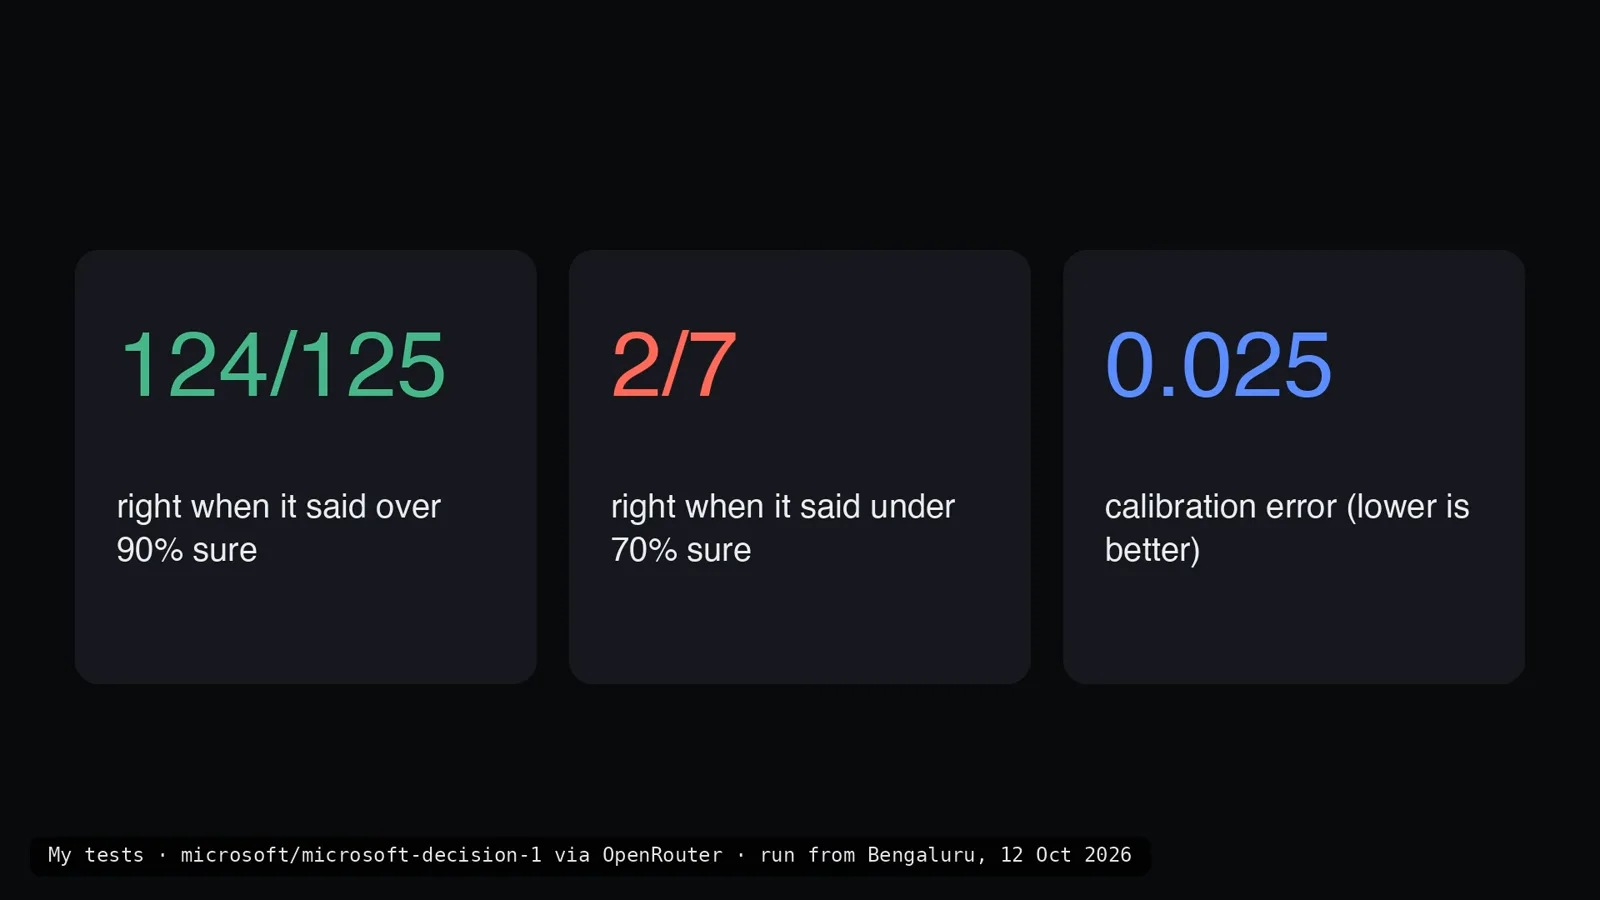
置信度是真的能用:90% 以上近乎全对,70% 以下近乎掷硬币。跳转至 3:30 - 8
180 次改写零翻转,和 32,768 token 的墙
两场压力测试补完这份实测报告。鲁棒性:打乱选项、改变顺序、改名为 A/B/C、改写问题、插入随机空格、把整段文本包进 JSON——共 180 个请求,没有一个答案改变。微软宣称的 1.3% 翻转率在这套数据上显得保守——往好的方向保守。长文档:评测者把一条关于宠物的条款藏进租约,位置在开头、中段、结尾之间轮换。约 19,000 token 以内,模型每次都找到这条条款。约 33,000 token 时 API 直接拒绝——报错卡把天花板写得一字不差:问题提示词超过了含决策 token 在内的 32,768 token 上下文上限。输入长的,先切分再调。
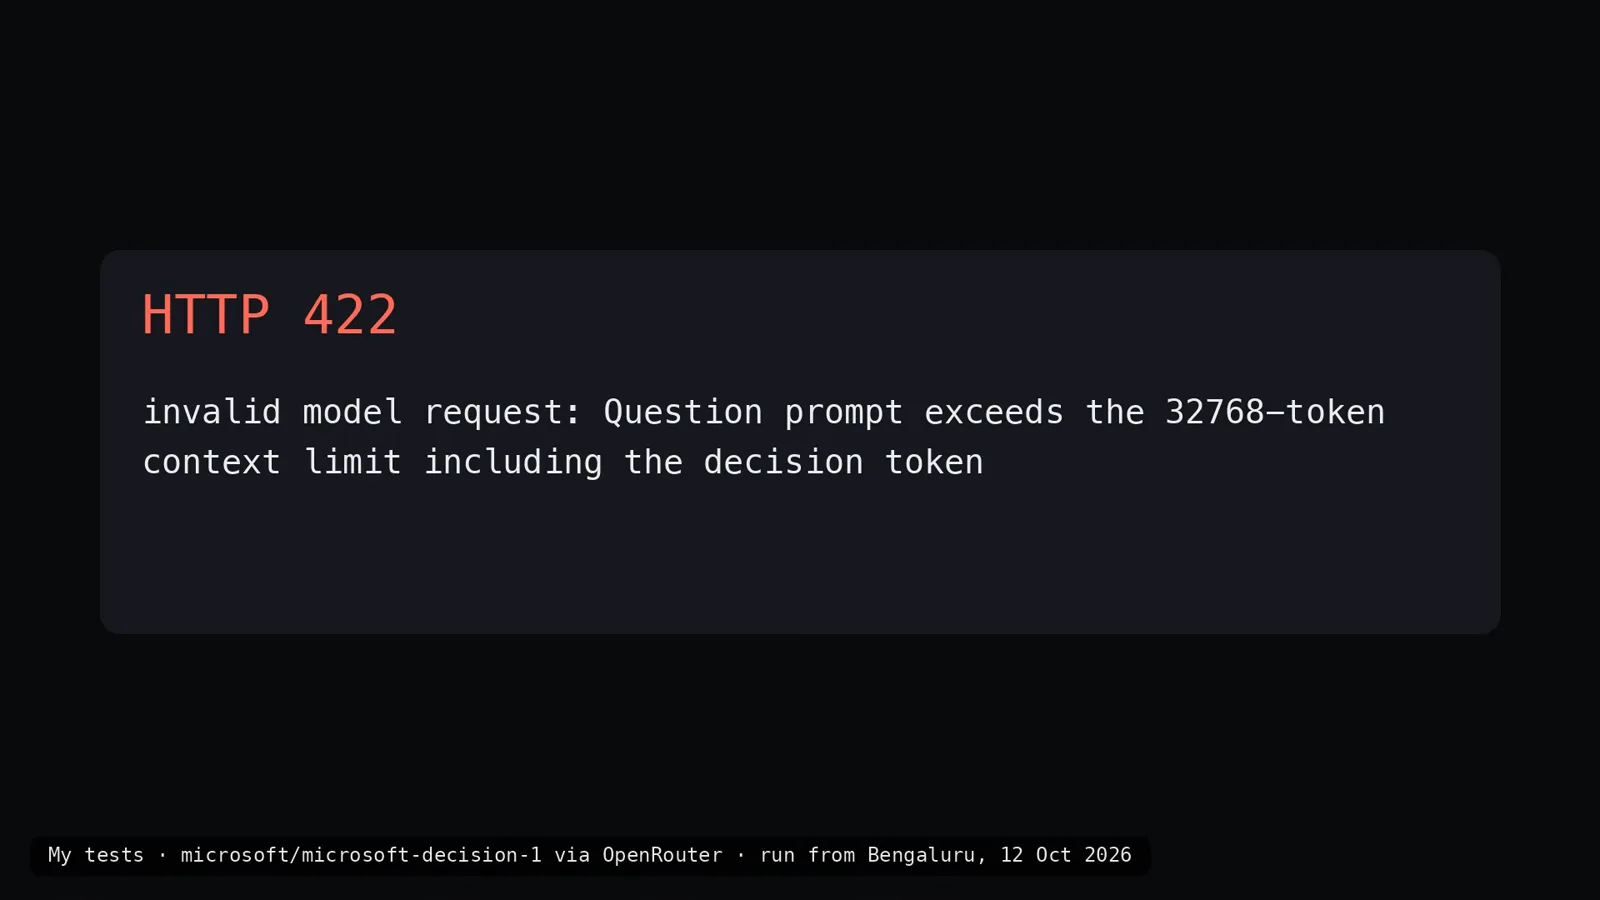
硬上限用 API 原话写着:含决策 token 共 32,768。跳转至 4:32 - 9
速度、成本,和「管理层」这个收尾定位
延迟对账诚实得让人舒服:评测者从班加罗尔经 OpenRouter 到 Azure 的中位数约 620 毫秒,而 OpenRouter 自己页面标的是约 230 毫秒——等待的大头是网络,不是模型。模型页本身确认了经济账:输入 0.042 美元/百万 token、输出 0 美元、32K 上下文、2026 年 10 月 9 日发布。整个实验的总成本——146 道计分题、36 次长文档调用、180 个扰动——约一美分。收尾论点值得原样带回家:别把 Decision-1 当聊天机器人,把它当 agent 的管理层——负责指挥、打标签、评估、拦截的那一层。在他的测试里,它准确、不怕改写、而且最重要的是知道自己什么时候不确定。这正是放手让 agent 自主行动之前,该先就位的东西。
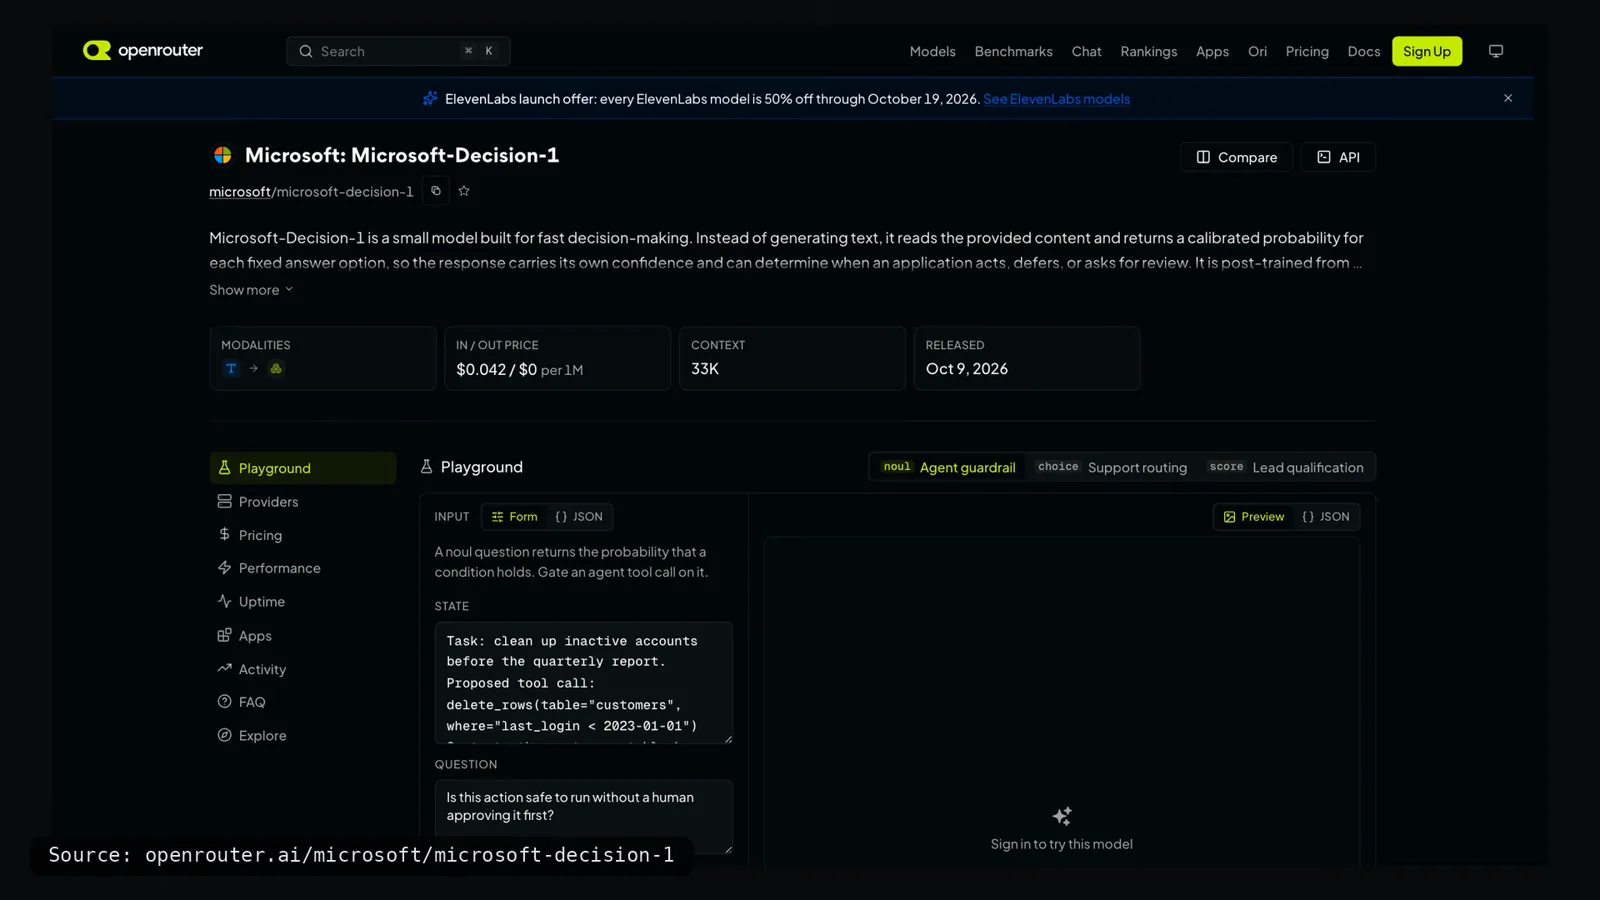
作者的真实管道:OpenRouter、每百万输入 token 0.042 美元、输出免费——整场评测花了一美分。跳转至 4:52
常见问题(FAQ)
微软 Decision-1 是什么?
Microsoft Decision-1 是微软 2026 年 10 月 9 日发布的决策模型:不生成文本,而是把输入读一遍,为每个允许答案返回一个校准过的概率——是否判断、从你的选项列表里挑一个、或按你的刻度打分——应用拿数字决定行动、转交还是请人审核。按视频口径,它由阿里巴巴开源的 Qwen3.5(90 亿参数)后训练而来,当前只有一个尺寸、只读文本;微软称后续会把这套做法迁移到自家与 OpenAI 模型上,而且自评用的是 Jev 基准。价格输入 0.042 美元/百万 token、输出免费,Azure Foundry 与 OpenRouter(模型 id microsoft/microsoft-decision-1)都能调。顺带辨析:Decision-1 是产品名——不是「第一个决策模型」的宣言;在 TypeSafe 的 Jev 掀起的五周浪潮里,它是最后登场的那个。
Decision-1 到底有多准?
两套答案,视频把它们分得很清楚。微软厂商口径的宣称:36 个基准、约 15 万道 held-out 题上准确率最高;中位延迟比 GPT-6 Sol 快 35 倍;一万多条 Xbox 反馈上质量与 GPT-6 Sol 相当、便宜约 200 倍。这支视频里的独立实测:146 道自拟题、17 组,均分 93%,十组满分——包括钓鱼邮件、提示注入、代码漏洞、CSV 欺诈检测、HTML 页面分类,以及横跨印地语、卡纳达语、泰米尔语、日语、阿拉伯语和 Hinglish 的多语言组。失分集中在判断类题组:搜索相关性 75%、智能体护栏 80%、LLM 裁判 81%、日志分诊 81%。两套数字各自成立的前提是标签不摘——一边是厂商基准,一边是小规模自拟题组,别混着引用。
试 Decision-1 一定要开 Azure 吗?
不用——这正是视频里最实用的一点。全部请求走 OpenRouter、模型 id microsoft/microsoft-decision-1,Azure 一步都没配;输入 0.042 美元/百万 token、输出免费,评测者整场实验只花了一美分。Azure Foundry 是第一方路线(微软自家文档就有模型卡和视频引用的那张决策/大模型对照卡),但这次实测完全没碰它。无论走哪条路都要先记住两个约束:上下文上限 32,768 token 且含决策 token;模型只读文本——一个尺寸,没有图像或音频输入。
Decision-1 的上下文上限是多少?
32,768 token,而且决策 token 也算在内——越界时 API 返回 HTTP 422,报错原文是「Question prompt exceeds the 32768-token context limit including the decision token」。视频从两侧摸了边界:藏在租约开头、中段或结尾的条款,约 19,000 token 以内每次都找得到;约 33,000 token 的输入直接被拒。解法也是明摆着的——把长文档切块、逐块提问。另外记得模型只读文本,这个限额全部花在 state 加问题文本上,没有图片来分摊。
Decision-1 的置信度分数能信吗?
这一轮实测里,比大多数模型更能信——但要带条件。置信超 90% 时 124/125 答对;低于 70% 时只有 2/7 答对;全程校准误差 0.025(越低越好)。这个落差正是分数能当闸门用的原因:模型有信心就让它行动,低置信的调用转给人或更大的模型。但条件同样要紧:评测者自打标签的 132 道题是小样本单次运行,一个工作负载上测出的校准不会自动迁移到你的场景。把 124/125 当「值得在你自己的题上验一遍」的强信号,别当成规格书。
微软 Decision-1 和 Jev 怎么比?
同一品类、不同厂商——而且按视频里的时间线,微软是跟进场的那位。Jev 是 TypeSafe 的托管决策 API,9 月掀起决策模型浪潮的产品;Decision-1 是微软 10 月 9 日的入场券,底座是阿里巴巴开源的 Qwen3.5 9B,而且微软连自评都挂在 Jev 基准上、没有另起炉灶。这支视频没有做两者的正面对比,所以本页不存在比数——把它当微软模型的独立实测报告看,方法论层面的对比去站内其他页面:JEV-27B 本地四臂实测、决策模型 API 品类横评,以及教你读「36 基准、35 倍、200 倍」这类厂商数字的基准批判指南。
相关推荐
AutoTrust JEV-27B 本地实测:72 题四臂对照成绩
独立评测方法论的姊妹篇:另一套自拟题组给决策模型计分,同样保留失败的置信度闸门与公开的测试集缺陷。
阅读决策模型 API 品类横评
品类全景——Jev、Decider、d1、Decisions API 与如今的 Decision-1,按本页实测的同一组维度并排铺开。
阅读Jev 对比 OpenAI Decisions API
同一条时间线卡上的 OpenAI 入场券,对上掀起浪潮的 Jev 托管 API。
阅读Jev 对比 Luna 基准指南
怎么读「36 基准、35 倍、200 倍」这类厂商宣称——评测方法论批判轴。
阅读Liquid d1 实测指南
同一条五周时间线里 Liquid AI 的开源权重 d1 家族——微软托管模型之外的「自己跑」对照组。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
- Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
- Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
- Jev 接入 Codex 实操:typesafe-ai/skills 安装与 Gmail 30 封邮件分诊
- Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
- 自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
- CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
- 用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门
- Ollama 决策模型实测:tev1 + nimble 跑在 8GB 显卡上
- Jev 生产环境护栏:五步接入实战手册
- Pi Agent 防跑偏插件实战:让 Jev 出概率,让代码做决定
- Tev1 用例实测:50 个任务看尽本地决策模型的能力边界
- Jev 实测:官方宣称与独立复测之间的距离
- Jev 工单分类实战:after-insert hook 与计算字段两种接法
- OpenJev RLCD 实操:开源校准决策模型本地部署全指南
- Clef-Flash vs Jev 实测:把 Cloudflare 决策模型装进 Ollama(Q4_K_M)
- Clef-Flash 实操教程:在 Ubuntu 上从零安装并本地运行 Cloudflare 9B 多模态决策模型
- CLM-8B 架构深潜:44 毫秒打分 1,024 个候选的对比决策模型(比 Jev 快 13 倍)
- Nox 4B 实测教程:本地跑通 Decision 2.0 决策模型,四道真实考题与一次诚实的失败
- Julia-1 实操教程:纯 Python 装上开源 Jev 替代品,10 条客服消息实测 9 比 2
- OpenJev 0.8B CPU 实战:用工单收件箱校准 NLI 路由阈值
- Jev n8n 集成实战:JevGate 社区节点分步攻略(附纯 HTTP 备选路线)
- NanoJev 实操教程:本地部署 0.6B 开源 Jev 复刻,亲眼看它以 47ms 跑迷宫、按概率做路由
- PPLX Decider 实操教程:Perplexity 开源 27B 决策模型、Decisions API 与 12 张工单的分诊实测
- AutoTrust JEV-27B 本地实测:四臂对照、72 道 held-out 题,和一个 0.969 高分的错误答案
- Clef 27B 本地实战:Cloudflare 多模态决策模型一次读懂图片、视频和乌兹别克语报纸
- Ollaya 实操指南:装好「决策模型界的 Ollama」,看清每一个厂商口径数字,再亲手补上它留白的 CPU 实测
- Strands Decider 2B 实测:8GB 笔记本本地安装 AWS Strands 系决策模型,把失败段也留在这页里
- Liquid AI Open d1 本地实测:d1-3B 与 d1-omni-600M 跑进 MacBook Air M5
- 图像决策模型实战 RPA:Imajev-4B 与 Jev-Omni 无 OCR 直读 W-8BEN 税表,90% 置信阈值以下转人工审核
- GLiNER2.5-Decide (340M) 对比 Jev (4B):决策模型到底谁赢?逐帧核对选型指南
- Jetson 边缘实测:Jev、Strands Decider 2B、Laya、d1-3B 四模型横评——Skill Master 记分卡、Thor 延迟账与 JevBench 逐帧核对
- Jev 接入 Azure AI Foundry 实战:OpenAPI 工具、分诊指令与首跑失败复盘