Guides / 视频转图文攻略
Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
最近更新: 2026-09-23
Krish Naik 图解 TypeSafe AI 的 Jev:System One 模型如何跳过 Token 生成、直接给出概率决策,为什么它不会取代 LLM,以及 Jev + LLM 混合式 Agentic AI 架构——附客服路由、Agent 工具选择与多智能体三个实战案例。
速览结论
Jev 是 TypeSafe AI 的 System One 模型:不生成 Token 和字符串,而是像分类器对猫、狗、猴子、马输出各类概率那样做决策——分类、路由、打分、判断。对于「Jev 会不会取代 LLM」,Krish Naik 的答案斩钉截铁:不会。LLM 仍是负责文本、代码与推理生成的大脑,Jev 则接管前后的快速判断。视频里的例子:EdTech 客服查询被路由为 support 0.3、finance 0.1、sales 0.6;五工具 Agent 以 0.96 概率直选 SQL——这些决策若交给 LLM,都要先推理并烧掉大量 Token。参考架构:用户 → Jev → RAG/工具/Agent → LLM → Jev 校验门禁(接受或重新生成)。TypeSafe 官方演示的对比数据:0.114 秒 vs 8.5 秒完成、$0.00081 vs $0.013 成本,端到端 70–500ms。
分步图文攻略
- 1
先看懂 LLM ReAct 循环为什么烧 Token
Krish 先画出当下 Agentic AI 应用的工作方式:输入交给 LLM,LLM 充当大脑,内部思考、决定是否调用外部工具,循环往复——这就是 ReAct loop。整条链路上大部分工作是生成:文本、代码、摘要,而且推理本身就产生大量 Token。他的核心判断是:未来属于能高效优化 Token 的人。
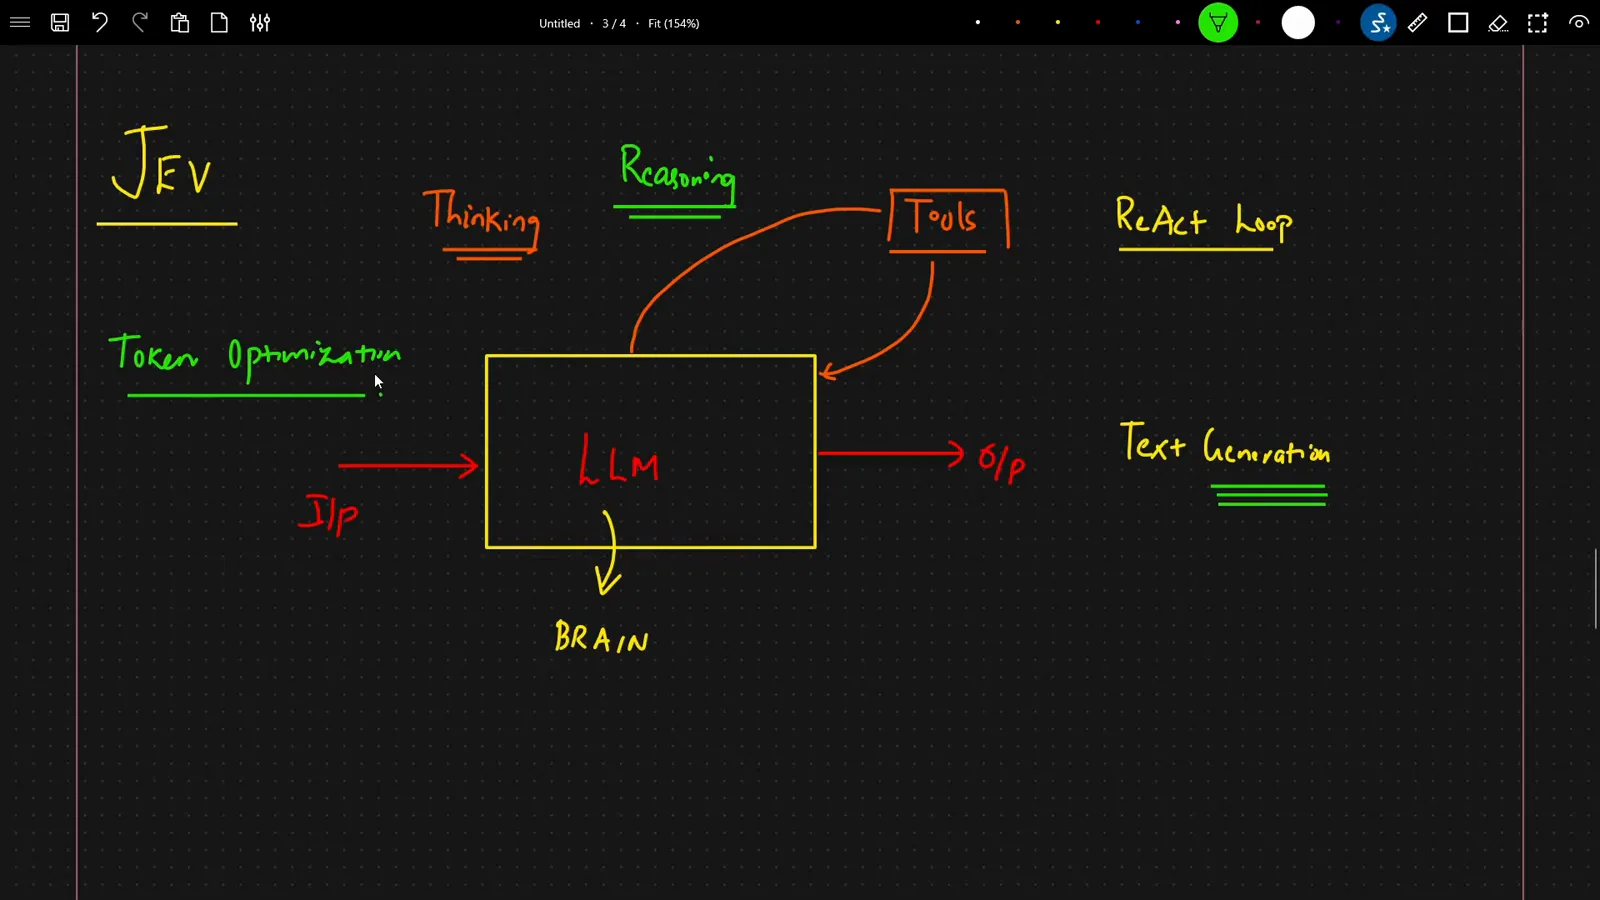
ReAct 循环:LLM 当大脑,工具挂旁边,每轮推理都在生成 Token。跳转至 4:25 - 2
理解 Jev:只做判断、不做生成的 System One 模型
Jev 由 TypeSafe AI 开发,官方称之为 System One 模型。它不生成 Token 和字符串,而是做概率决策——就像分类器判断猫、狗、猴子还是马,或者「你饿不饿」这样的 yes/no 快速判断。判断结果再交给 LLM:文本、代码、邮件、摘要、推理、对话,这些生成类工作仍然是 LLM 的强项。至于取代问题,Krish 说得毫不含糊:认为 Jev 会取代 LLM,答案是明确的不会——它是互补,不是替代。
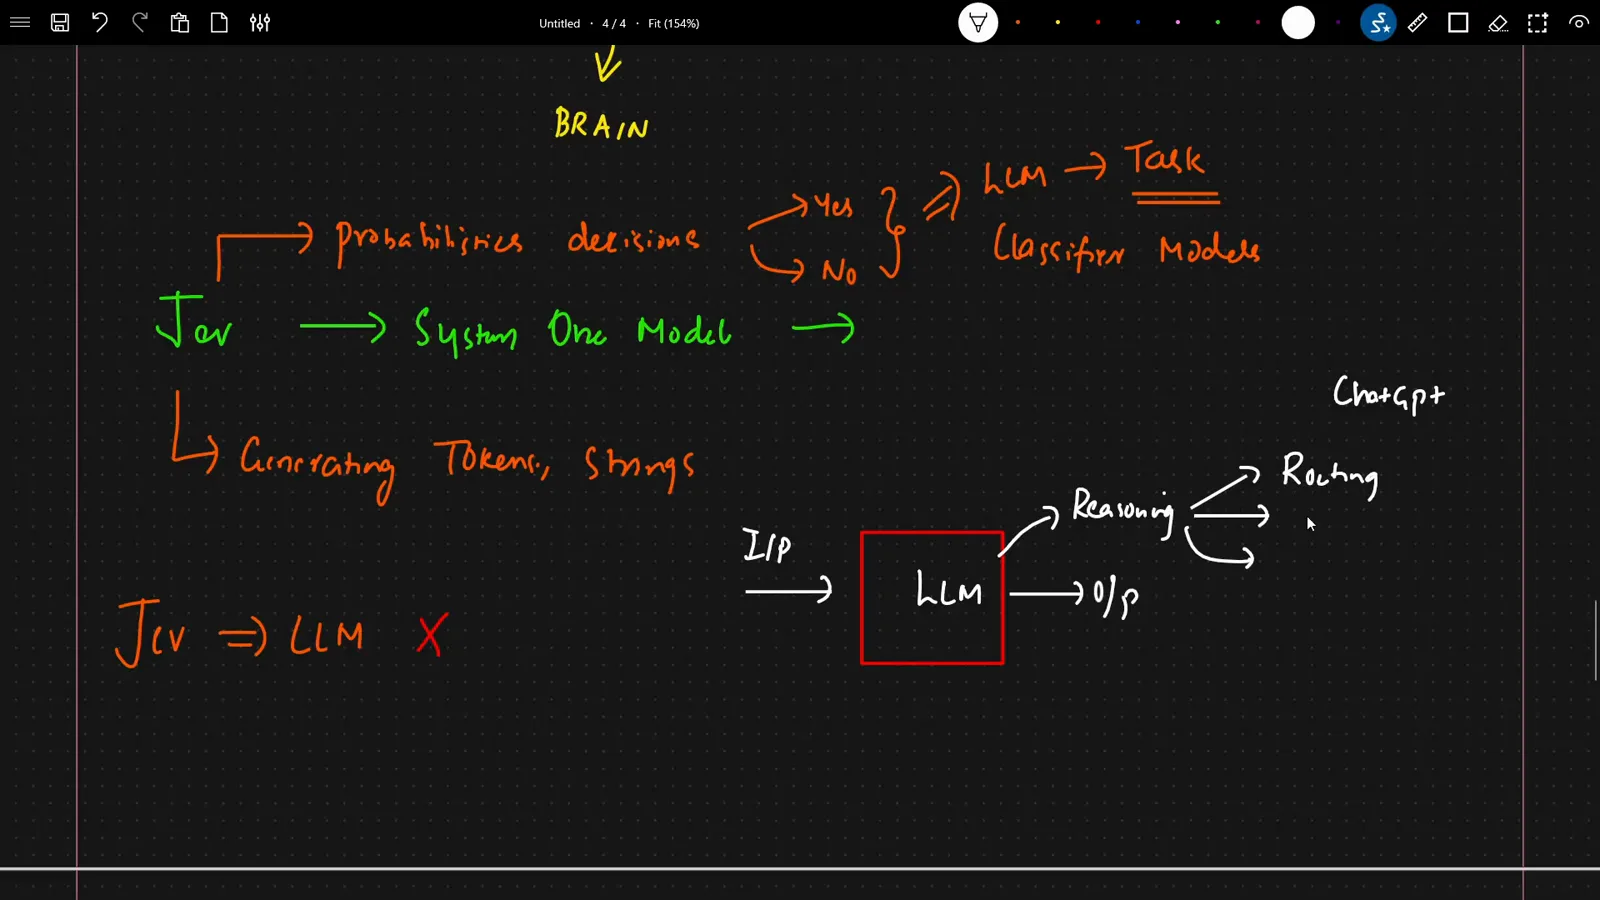
Jev 负责判断,LLM 负责生成——被划掉的「Jev ⇒ LLM」给替代论画上句号。跳转至 7:00 - 3
用概率路由客服工单:0.3 / 0.1 / 0.6
以他的 EdTech 公司为例:聊天机器人收到「我想咨询一个课程、打算购买」——这是一条 NLP 非结构化查询,需要分给 support、finance 或 sales 团队。同样的查询进 Jev,出来就是一个概率分布:support 0.3(30%)、finance 0.1(10%)、sales 0.6(60%),直接路由给销售团队。若走 LLM,模型要先内部推理「这个人想买课」,花更多时间、生成更多 Token,最后才得到同样的结论。拿到 Jev 的输出后,自定义代码可以把它发给 LLM、转人工、转其他部门,或直接处理。
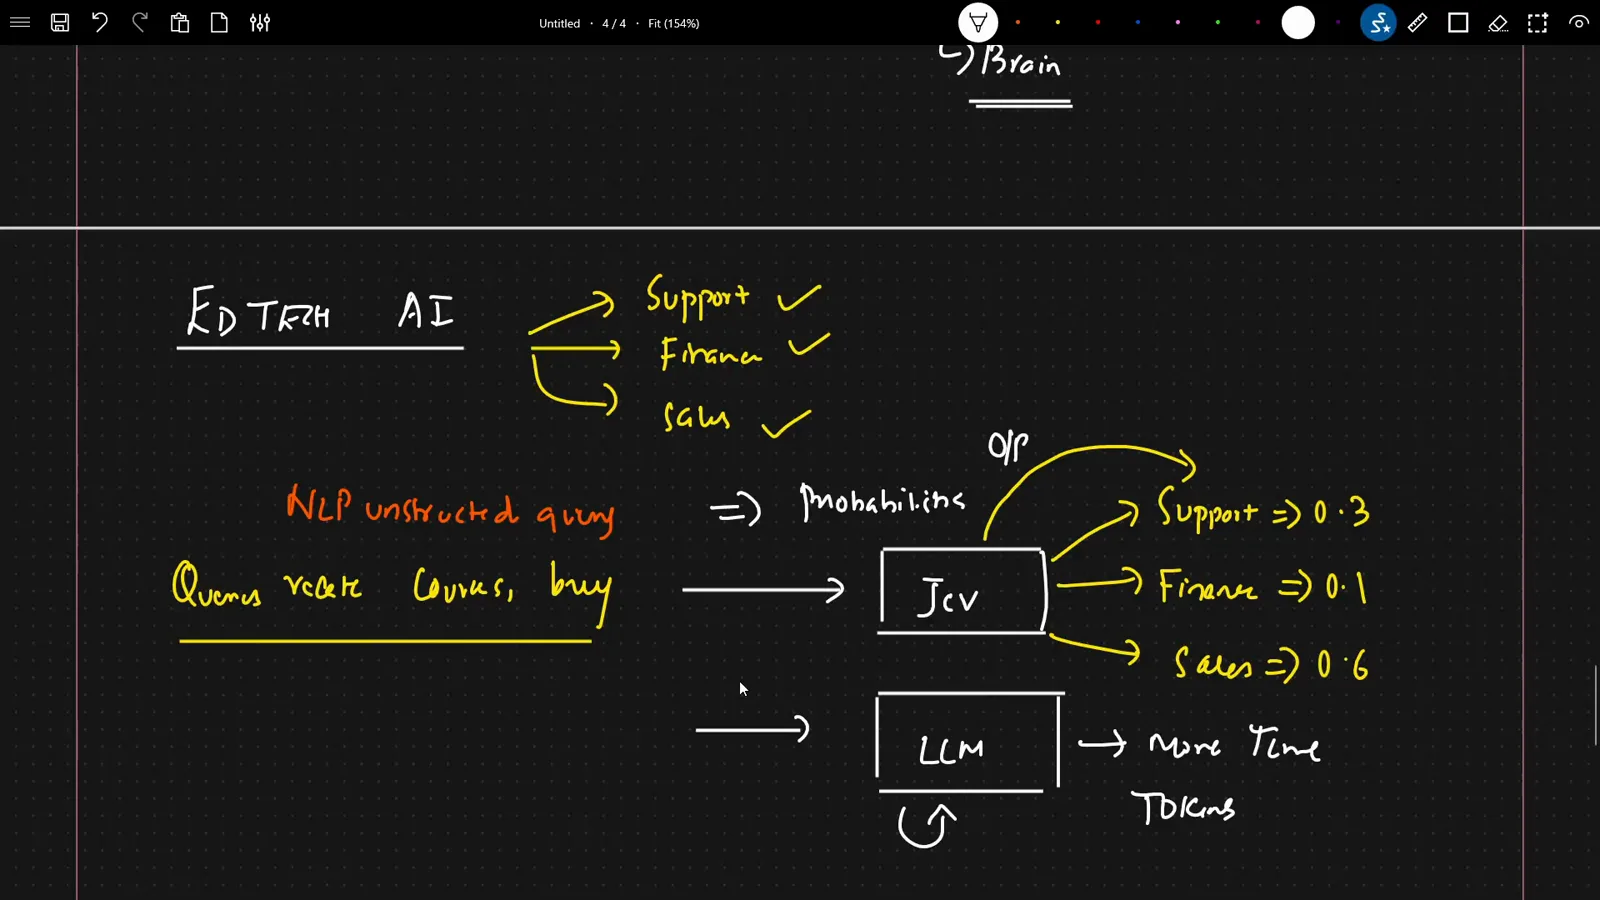
一条非结构化查询,三个概率:sales 0.6 胜出,LLM 路径则用时间和 Token 买单。跳转至 11:10 - 4
一次前向选中 Agent 工具:SQL 0.96
第二个例子:一个带五个工具(SQL、网页搜索、Python、计算器、邮件)的 AI Agent,被问到「查一下公司上个月/最近六个月的营收」。现有 LLM 路径要逐步推理、生成 Token,最后才想明白该查 SQL 数据库。Jev 路径直接给出 SQL 0.96、Python 0.02、web search 0.01、calculator 0.005,查询直奔 SQL 工具。Krish 认为,这类路由与分类正是 Jev 最擅长的——LLM 完全不必亲自思考。
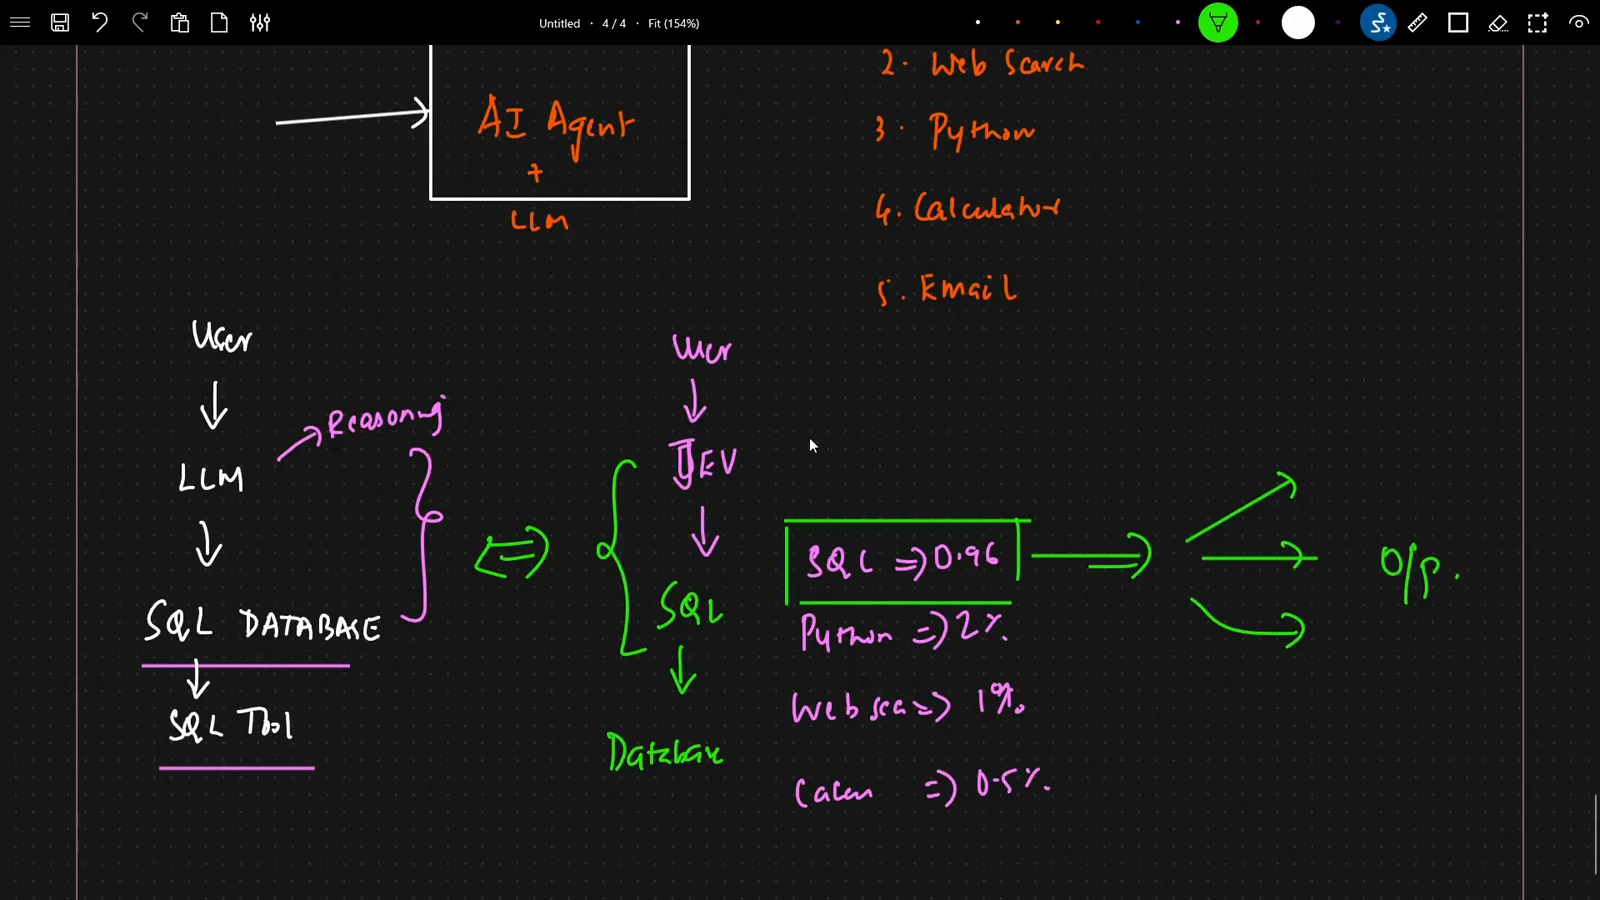
SQL 拿到 0.96——Jev 一次前向选中工具,LLM 不用再推理一遍。跳转至 16:45 - 5
扩展到多智能体平台:Jev 是互补而非替代
白板上用绿字再次强调:Jev ≠ LLM,两者是互补关系。在企业级多智能体平台场景里,用户要求分析 AWS 账单、找出 GPU 支出增长 30% 的原因。这条查询交给 LLM,会触发「该找哪个 Agent」的内部思考;有了 Jev,自然语言非结构化查询直接映射到 coding、finance、research 三个 Agent 中的正确专家——这里就是 finance agent。Krish 说,有了 Jev 打头,Agent 和模型的路由会变得非常简单。
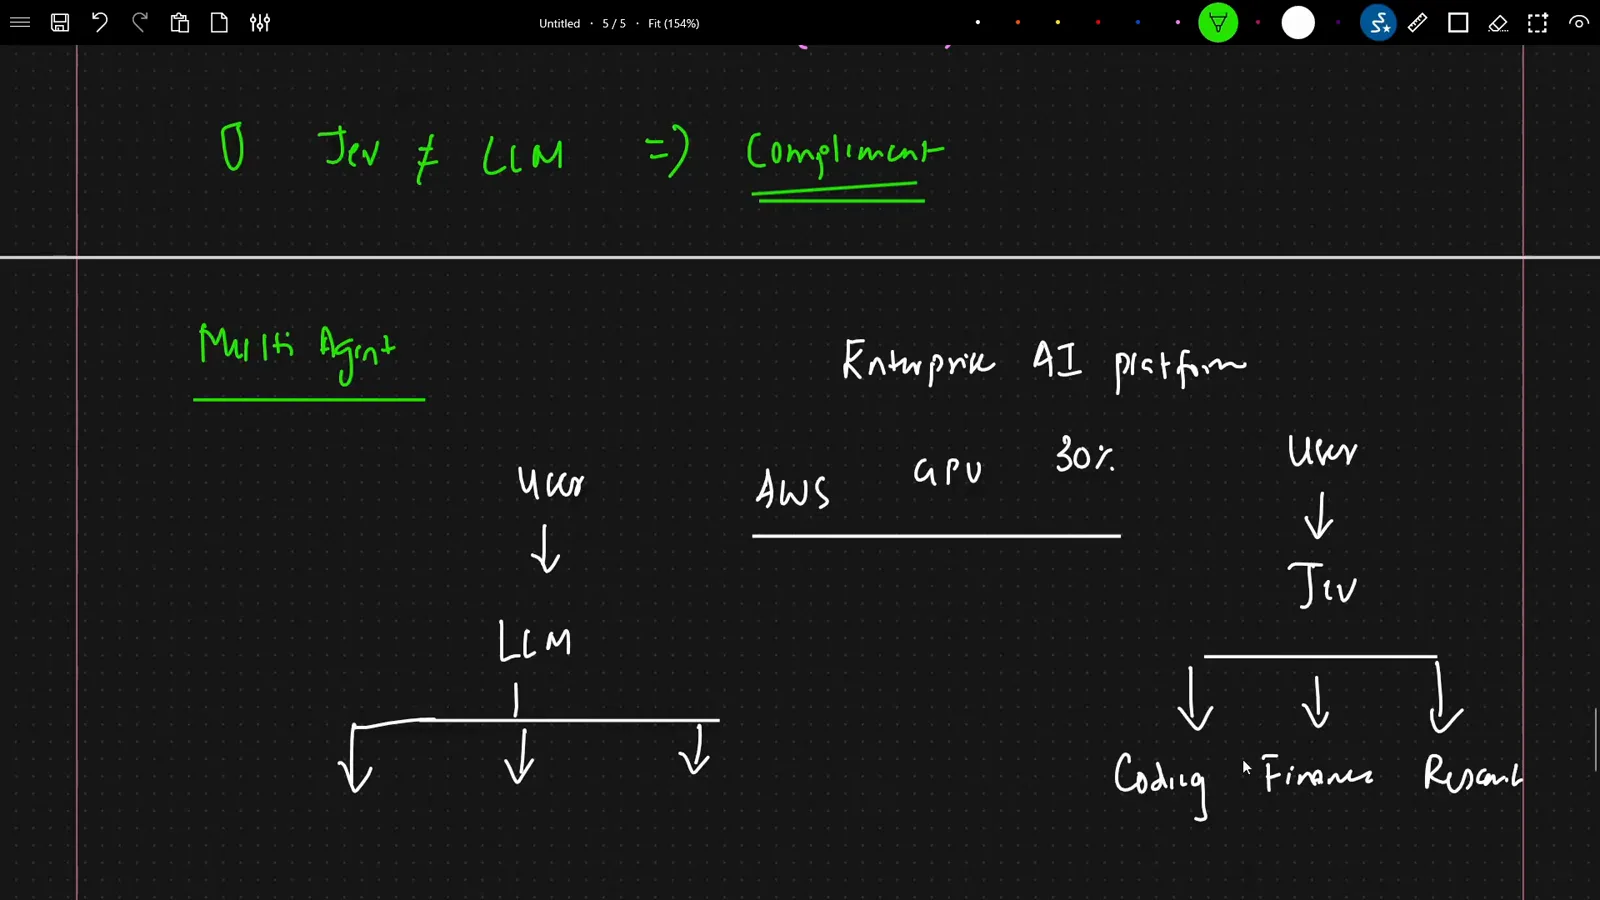
AWS 账单、GPU 支出涨 30%——Jev 把问题直达 finance agent。跳转至 19:20 - 6
落地混合架构:Jev 在两端把关
最终的 Agentic AI 架构把 Jev 放在入口和出口。用户查询先经 System One 模型完成分类、路由、打分、判断,决定调用哪个工具、RAG 还是 Agent;接着 LLM 承担复杂工作——推理、生成、解释;最后再用一次 Jev 做判断,像 guardrails 一样套上逻辑门,输出 accept 或 regenerate。因为 Jev 只做 yes/no 概率决策,幻觉更少、成本更低、整条链路更快。视频中引用 TypeSafe 的对比数字:0.114 秒 vs 8.5 秒完成、$0.00081 vs $0.013 成本,端到端 70–500ms——同等前沿智能水平下快 200 到 400 倍。
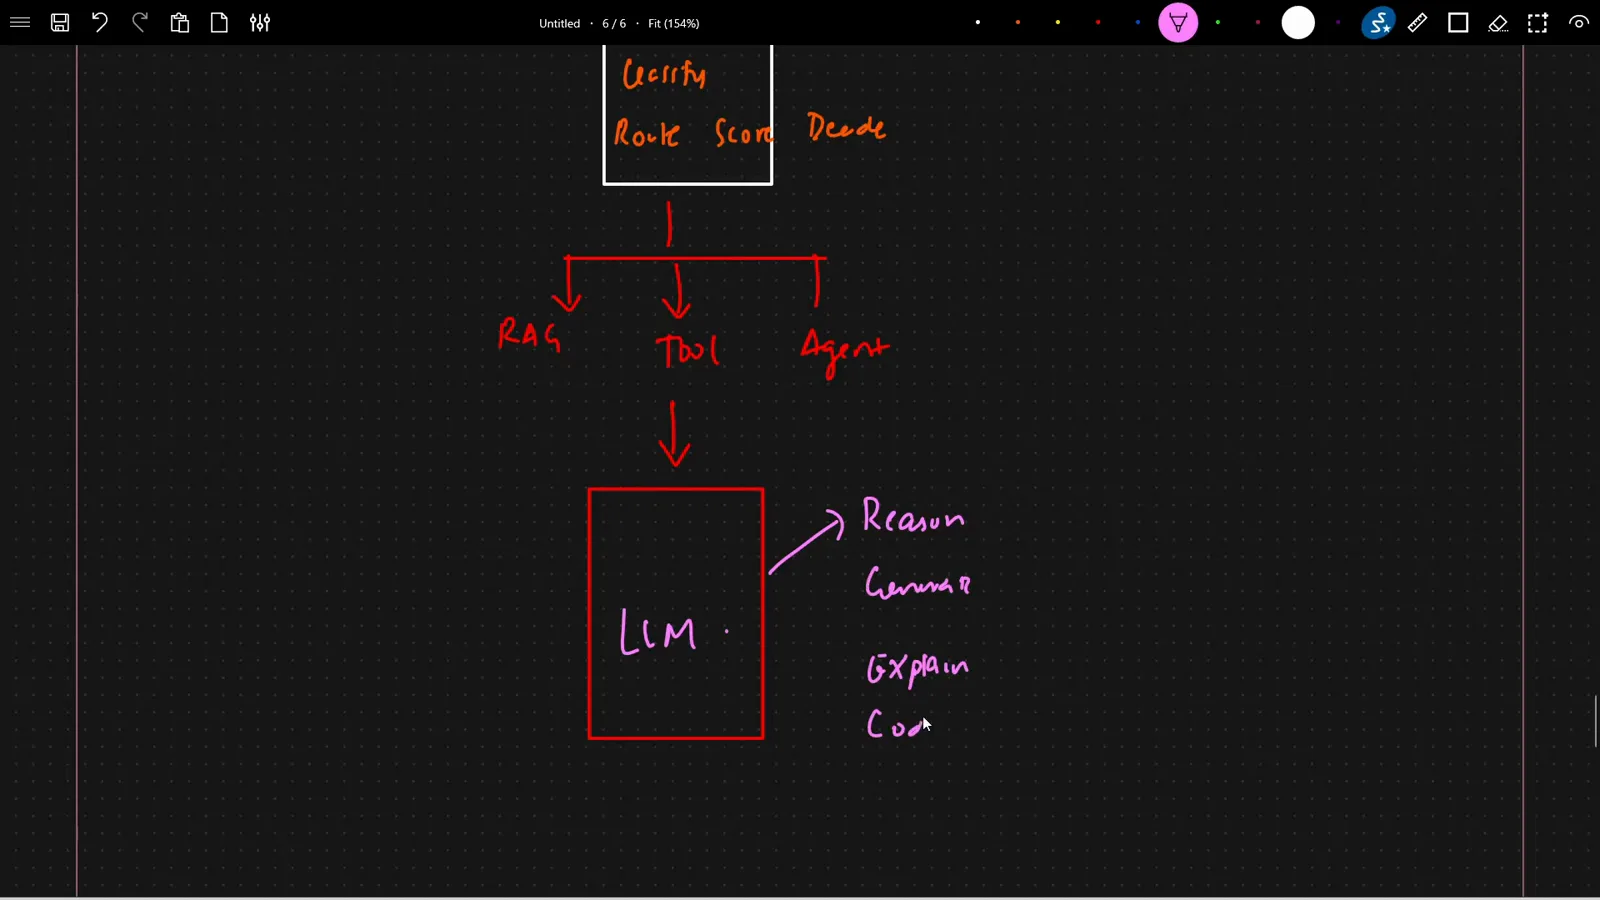
完整链路:Jev 分类与把关,RAG/工具/Agent 执行,LLM 生成,Jev 校验。跳转至 21:46
常见问题(FAQ)
Jev 会取代 LLM 吗?
不会——Krish Naik 在视频里给的答案是明确的「不会」。Jev 完全不生成文本,只做概率判断再交给 LLM。文本、代码、邮件、摘要生成以及推理、对话仍然是 LLM 的大脑职责。Jev 的价值是接管快速的路由与分类决策,让 LLM 少生成 Token,两者是互补关系。
什么时候该用 Jev 而不是 LLM?
当软件需要的是快速判断而不是成段文字时用 Jev:客服工单路由(视频中 EdTech 案例给出 support 0.3、finance 0.1、sales 0.6)、Agent 工具选择(五个工具里以 0.96 直选 SQL)、多智能体路由(AWS GPU 问题直达 finance agent),以及输出校验 guardrails。决策做完之后,生成类工作仍交给 LLM。
System One 模型是什么?
这是 TypeSafe 给 Jev 的定位术语:一个快速、直觉式的层,像分类器输出猫/狗/猴子/马的概率那样做概率决策或 yes/no 判断。与之相对的是 LLM 慢条斯理的 System Two 式推理——每做一次决策都要逐步思考并生成 Token。
Jev 和 LLM 能在同一条流水线里协作吗?
能——这正是 Krish 推荐的 Agentic AI 架构:用户查询先过 Jev 完成分类、路由、打分、判断;请求再流向选定的工具、RAG 或 Agent;LLM 负责重推理、生成与解释;最后再用一次 Jev 做 guardrail,通过 yes/no 逻辑门对输出给出 accept 或 regenerate。视频引用的数据:端到端 70–500ms、快 200–400 倍,演示成本 $0.00081 vs $0.013。
相关推荐
Jev 是什么?
Jev 作为 System One 决策模型的基础概览——它是什么,与生成式 LLM 有何不同。
阅读Jev 架构解析
为什么 70ms 概率决策模型在工作流自动化的延迟与成本上碾压自回归 LLM。
阅读Jev vs Instructor
原生概率决策与「逼 LLM 吐结构化 JSON」两种路线的实战对比。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
- Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
- Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
- Jev 接入 Codex 实操:typesafe-ai/skills 安装与 Gmail 30 封邮件分诊
- Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
- 自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
- CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
- 用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门
- Ollama 决策模型实测:tev1 + nimble 跑在 8GB 显卡上
- Jev 生产环境护栏:五步接入实战手册
- Pi Agent 防跑偏插件实战:让 Jev 出概率,让代码做决定
- Tev1 用例实测:50 个任务看尽本地决策模型的能力边界
- Jev 实测:官方宣称与独立复测之间的距离
- Jev 工单分类实战:after-insert hook 与计算字段两种接法
- OpenJev RLCD 实操:开源校准决策模型本地部署全指南
- Clef-Flash vs Jev 实测:把 Cloudflare 决策模型装进 Ollama(Q4_K_M)
- Clef-Flash 实操教程:在 Ubuntu 上从零安装并本地运行 Cloudflare 9B 多模态决策模型
- CLM-8B 架构深潜:44 毫秒打分 1,024 个候选的对比决策模型(比 Jev 快 13 倍)
- Nox 4B 实测教程:本地跑通 Decision 2.0 决策模型,四道真实考题与一次诚实的失败
- Julia-1 实操教程:纯 Python 装上开源 Jev 替代品,10 条客服消息实测 9 比 2
- OpenJev 0.8B CPU 实战:用工单收件箱校准 NLI 路由阈值
- Jev n8n 集成实战:JevGate 社区节点分步攻略(附纯 HTTP 备选路线)
- NanoJev 实操教程:本地部署 0.6B 开源 Jev 复刻,亲眼看它以 47ms 跑迷宫、按概率做路由
- PPLX Decider 实操教程:Perplexity 开源 27B 决策模型、Decisions API 与 12 张工单的分诊实测
- AutoTrust JEV-27B 本地实测:四臂对照、72 道 held-out 题,和一个 0.969 高分的错误答案
- Clef 27B 本地实战:Cloudflare 多模态决策模型一次读懂图片、视频和乌兹别克语报纸
- Ollaya 实操指南:装好「决策模型界的 Ollama」,看清每一个厂商口径数字,再亲手补上它留白的 CPU 实测
- Strands Decider 2B 实测:8GB 笔记本本地安装 AWS Strands 系决策模型,把失败段也留在这页里
- Liquid AI Open d1 本地实测:d1-3B 与 d1-omni-600M 跑进 MacBook Air M5
- 图像决策模型实战 RPA:Imajev-4B 与 Jev-Omni 无 OCR 直读 W-8BEN 税表,90% 置信阈值以下转人工审核
- GLiNER2.5-Decide (340M) 对比 Jev (4B):决策模型到底谁赢?逐帧核对选型指南
- Jetson 边缘实测:Jev、Strands Decider 2B、Laya、d1-3B 四模型横评——Skill Master 记分卡、Thor 延迟账与 JevBench 逐帧核对
- 微软 Decision-1 实测:146 道独立测试、93% 均分、高置信时 124/125——每个数字逐帧核过
- Jev 接入 Azure AI Foundry 实战:OpenAPI 工具、分诊指令与首跑失败复盘