
Guides / 视频转图文攻略
Clef-Flash vs Jev 实测:把 Cloudflare 决策模型装进 Ollama(Q4_K_M)
Cloudflare 开源了 Clef 决策模型,「小杯能不能在普通笔记本上跑」第一次变得可验证。两个 demo、一个关于 joint schema head 的诚实发现、以及严格标注来源的 Clef vs Jev 公开数字——这就是本页。
速览结论
Cloudflare 开源 Clef 之后,那个显而易见的问题第一次可以动手验证:小杯到底能不能在你的硬件上做决策?这支视频答得异常严谨。环境:bartowski 的 Clef-Flash GGUF Q4_K_M、Ollama 0.35.0、RTX 4060 笔记本 8GB 显存、2048 token 上下文。Demo 一路由一条 checkout 宕机工单:纯提示词要 JSON 输出畸形(冷启动 18.29 秒、其中 15.90 秒在加载);Ollama 的 JSON schema 约束修好了格式;第一次约束运行答出 technical/urgent/critical、2.27 秒——而同一提示词零温度复跑答出 billing、1.96 秒。Demo 二喂入裁剪静图,1.35 秒返回 gesture=peace_sign、holding_drink=false。然后是重新定义一切发现的发现:官方发布带独立的 joint schema head 给选项打分,但本地量化文件只有 427 个 backbone 张量、零 schema/head 匹配——Ollama 的答案是 21–30 个生成 token 拼出的 JSON,不是原生决策概率。公开对比(API-Bank Clef-Flash 93.11 vs 88.19;When2Call Jev 80.97 vs 65.58;工作流分数互有胜负)出自 Cloudflare 托管评测,回答的是另一个问题。判词:本地能跑;原生决策头没跟上;查运行时——模型名字不会告诉你跑的是哪种机制。
分步图文攻略
- 1
问题:小杯 Clef 到底能不能在本地做决策?
Cloudflare 以开放权重发布了 Clef 决策模型家族,营销问题就此变成可验证问题:把小杯装进普通笔记本的 Ollama,看它到底能不能用。画面按官方模型卡列出 Clef-Flash 的三个增量:9B Qwen3 backbone、带投影器的视觉输入、以及——整页故事围绕的细节——独立的 joint schema 打分头。刻意收窄的计划:一个文本 demo(支持工单路由)、一个图像 demo、只用公开证据对比原版 Jev。不摆基准擂台;视频把时间花在它真正跑过的少数例子上。
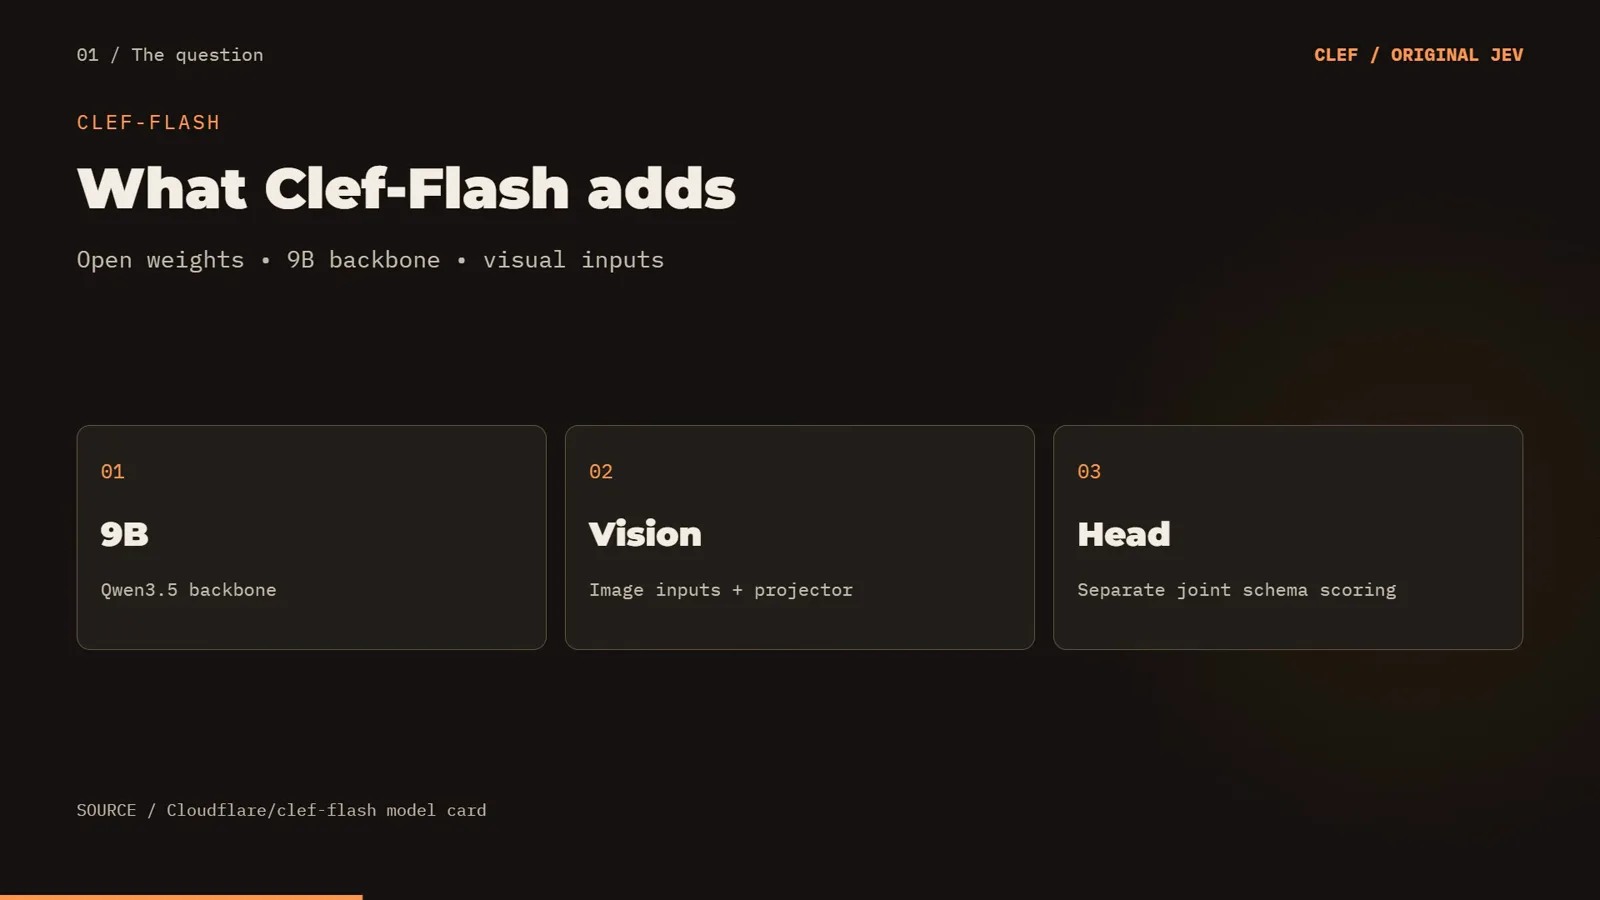
模型卡口径:9B Qwen3 backbone、视觉输入、独立 joint schema head——记住这个 head。跳转至 3:00 - 2
测试机:8GB 显存与诚实的约束
配置刻意平凡:NVIDIA RTX 4060 笔记本 GPU、8GB 显存、Ollama 0.35.0、Q4_K_M 量化、2048 token 上下文加短输出上限。作者开门见山:这是一次小上下文的笔记本运行——不测长上下文窗口,也不代表生产负载。测试期间 Ollama 报告 CPU/GPU 混合执行,约 87% 计算落在 GPU 上。这些约束本身就是论点:如果量化包在这档硬件上都做不了决策,开放权重的叙事就有个大洞。
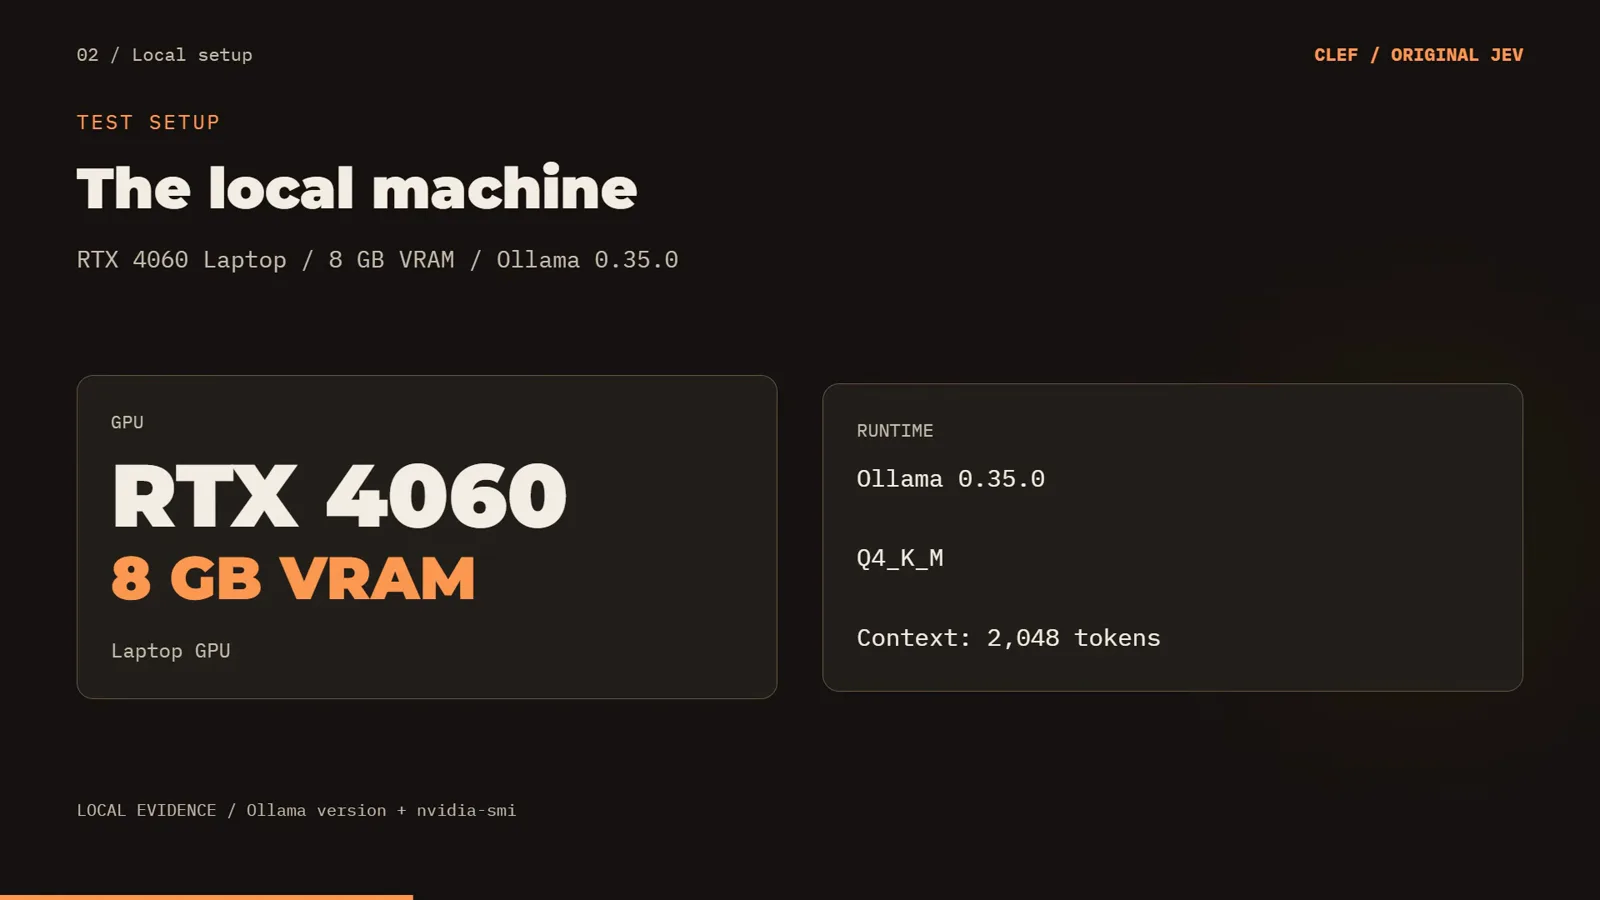
RTX 4060 笔记本、8GB 显存、Ollama 0.35.0、Q4_K_M、2048 上下文——刻意的平凡配置。跳转至 3:25 - 3
本地路线:一条 ollama run 命令
拿模型是最简单的部分,画面一卡拍全:ollama run hf.co/bartowski/Cloudflare_clef-flash-GGUF:Q4_K_M,之后请求打到本地 Ollama 端点 localhost:11434、上下文设 2048。两个体积数字跟着模型走,视频把它们分得很清:量化卡列 backbone 文件约 5.84GB,Ollama 显示安装包约 6.8GB——差值是随包的视觉投影器。作者也诚实说明录制开始时模型已在本地;你看到的是推理核查,不是下载过程。
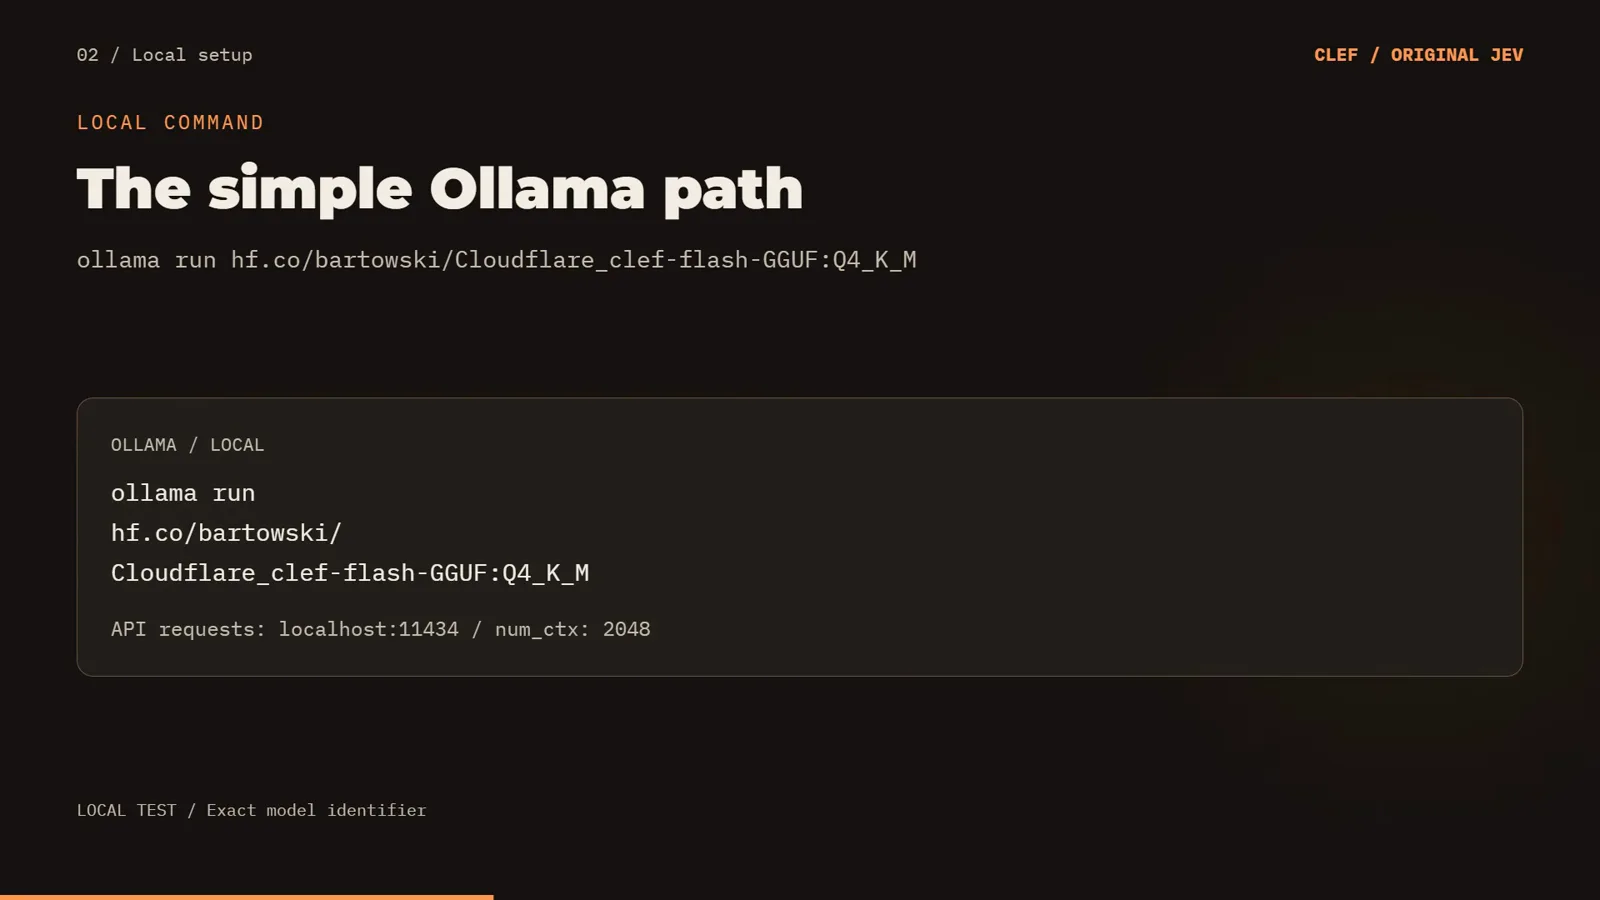
一条命令到本地:hf.co/bartowski/Cloudflare_clef-flash-GGUF:Q4_K_M,localhost:11434。跳转至 4:05 - 4
Demo 1:路由一条 checkout 宕机工单
支持工单刻意写得短,让任何东西都没法藏在大提示词后面:「Checkout has been failing for every customer for the last hour.」要三个字段——urgent 是/否、team 在 billing/technical/sales 里选、severity 在 minor/major/critical 里选——画面同时声明预期答案:urgent true、technical(大面积服务故障)、critical。整片把两个问题分开看:输出有没有守格式?选中的答案对不对?第一问通过永远不等于第二问通过。
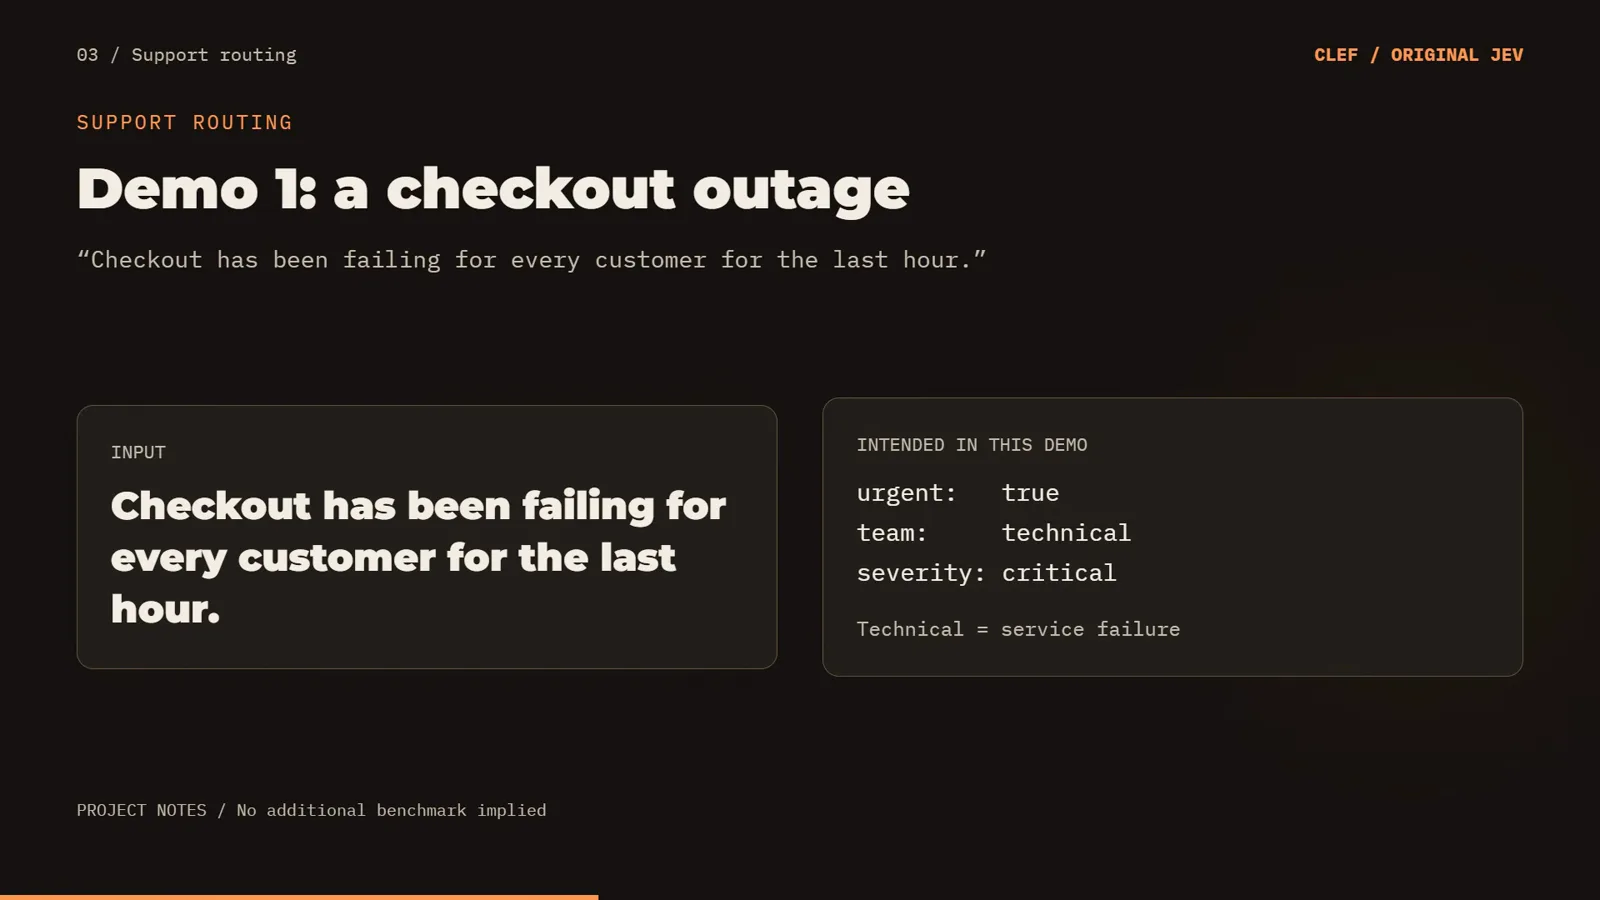
一句话进、三个类型化字段出——预期答案提前声明。跳转至 4:57 - 5
纯提示词败给格式
第一次尝试只是在提示词里要 JSON。精确输出:{"urgent": true, team technical, critical}——值在语义上对,但字符串不是合法 JSON,键值缺结构。冷启动总耗时 18.29 秒,其中 15.90 秒是模型加载。对任何期望可解析对象的应用,这是实打实的失败——也是每个「LLM+提示词要 JSON」集成品牌的老毛病。两页之后的 schema 修复会回收这个伏笔。
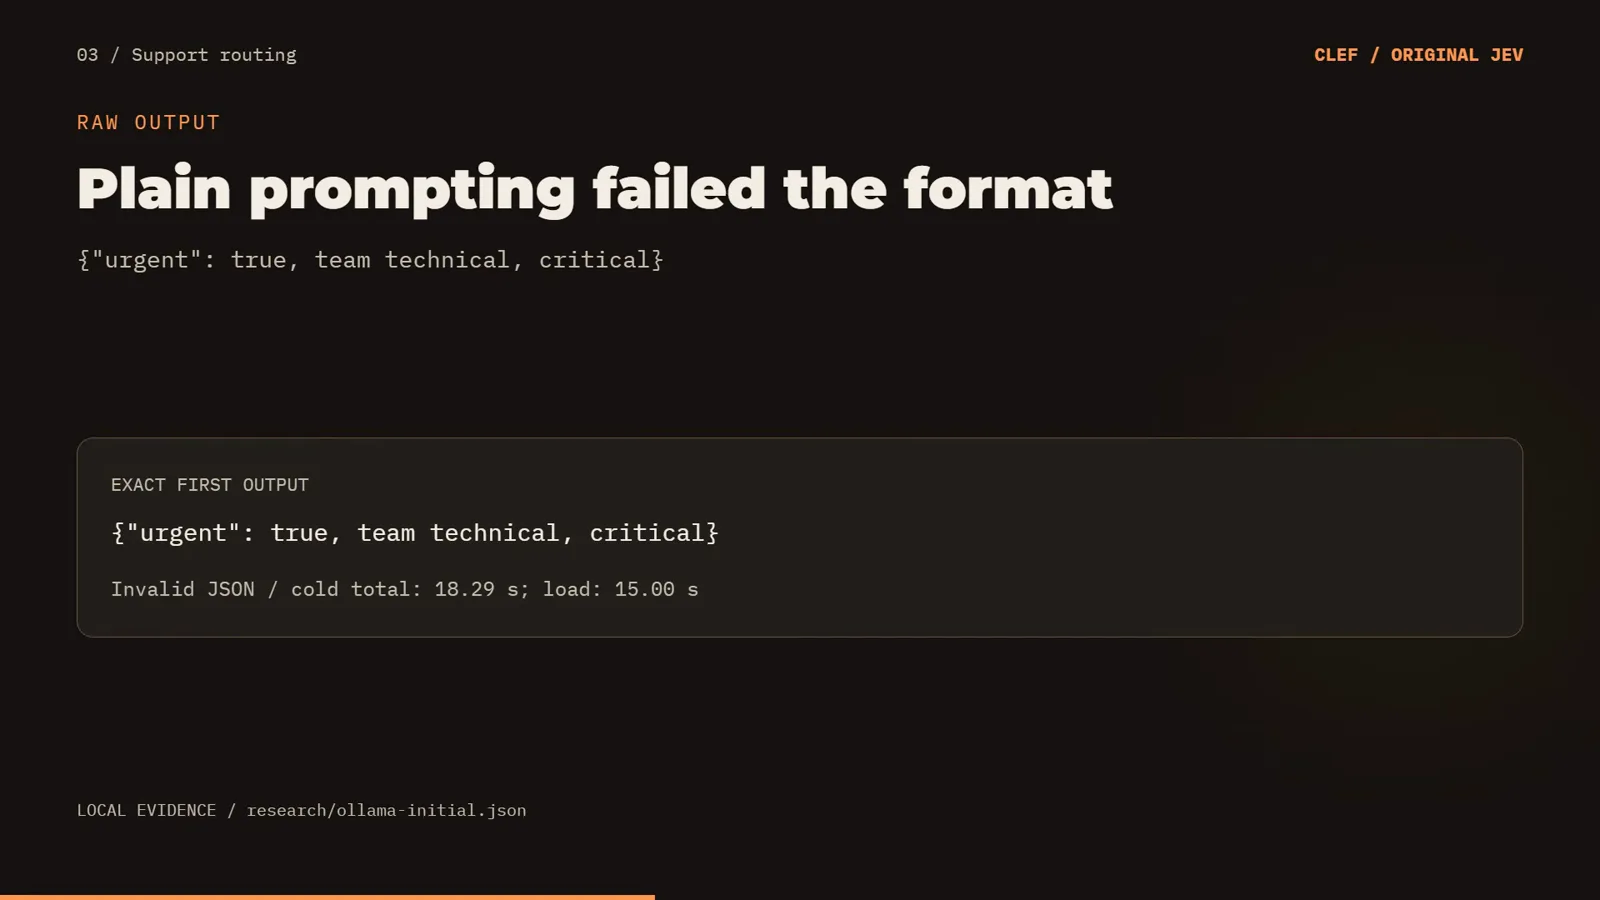
想法对、格式崩:invalid JSON,冷启动 18.29 秒(15.90 秒在加载)。跳转至 5:25 - 6
修法:在运行时层加 schema 约束
第二次尝试不再苦苦哀求,而是在 Ollama 层约束格式:urgent 定义为 boolean,team 是 billing/technical/sales 的 enum,severity 是 minor/major/critical 的 enum。答案空间被运行时强制之后,输出干净解析。视频把这个功劳记对位置——它证明的是「在运行时层约束格式」的价值,而不是模型突然听话了——并立刻指出格式从来不是有趣的问题。决策质量仍然悬而未决。
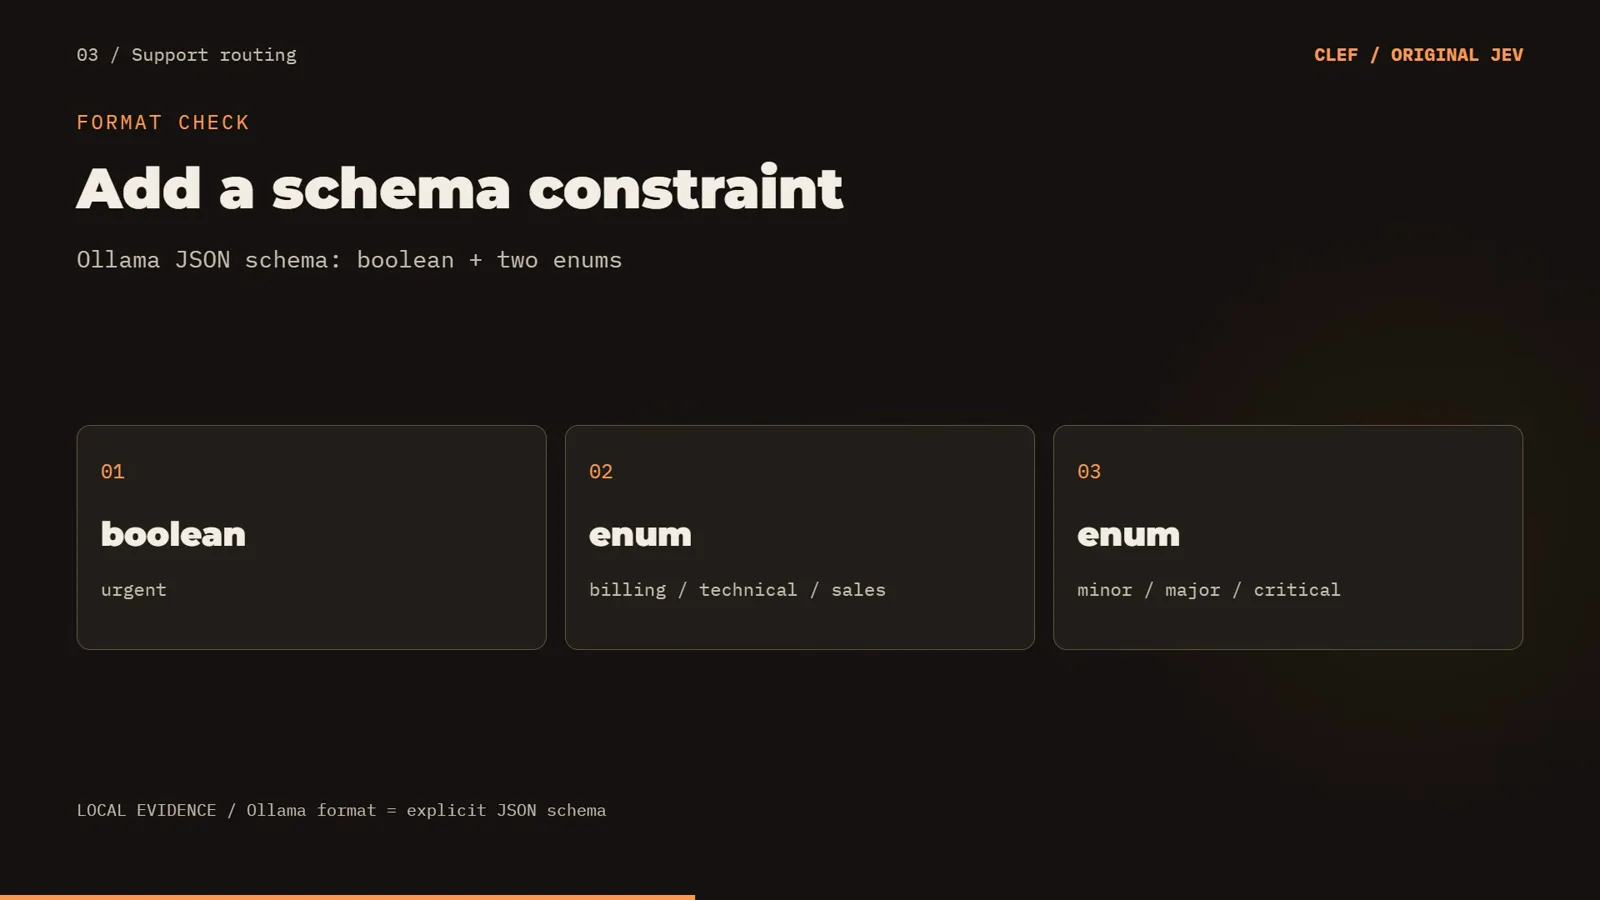
urgent:boolean。team 与 severity:enum。运行时从此保证形状。跳转至 5:45 - 7
Run A:合理的答案——technical,2.27 秒
第一次 schema 约束请求返回的正是 demo 预期:team "technical"、urgent true、severity "critical"——合法 JSON,热请求 Ollama 墙钟 2.27 秒。正如观察卡所写:合理的路由。如果视频只放这一帧,实验看起来就是一次干净的胜利、这支视频就是庆功片。作者把它留在屏幕上,正是为了下一帧把它收走。
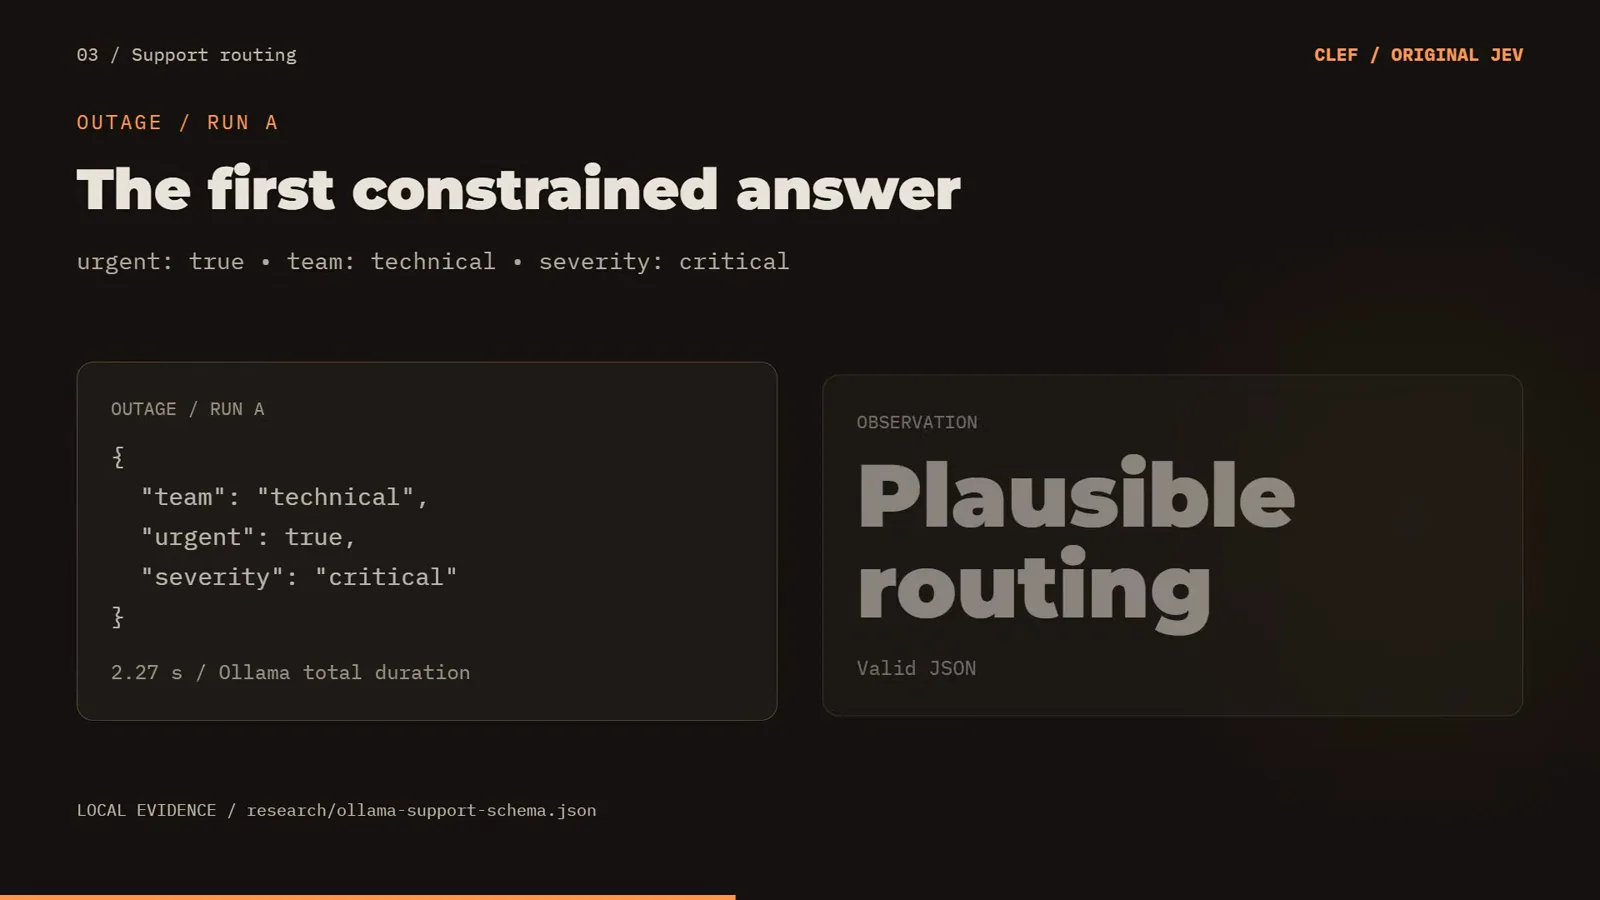
Run A:technical / true / critical,合法 JSON,2.27 秒——与预期完全一致。跳转至 6:05 - 8
Run B:复跑翻了——billing,1.96 秒
同一句宕机提示词、同一组允许字段、零温度——复跑返回 team "billing"、1.96 秒,urgent true 与 severity critical 保持不变。两个结果都留在片子里。诚实的读法(旁白原话):一次复跑诊断不了原因,但这条受测路径给不出稳定的 team 选择——而且 billing 是个完全合法的部门,哪怕这条消息本该去 technical。对自动路由每张工单的应用来说,这种不稳定正是「一张成功截图式评测」最容易藏掉的东西——要在有意义的样本集上评测,而不是在 demo 上。
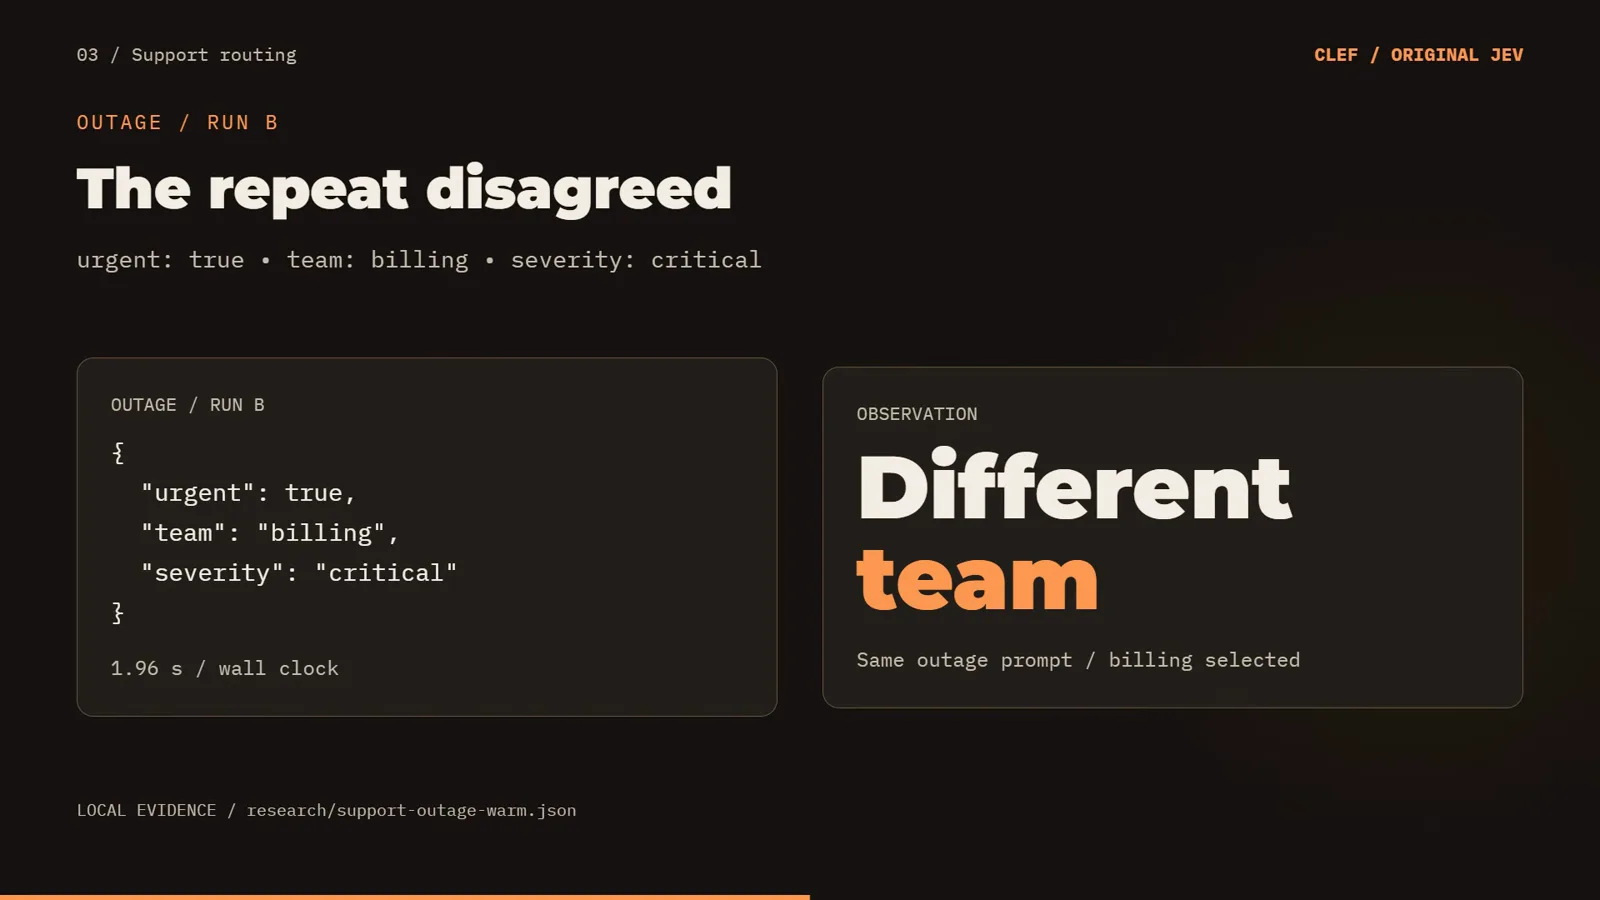
Run B:同一提示词、零温度——billing。这次复跑就是整篇评测。跳转至 6:42 - 9
Demo 2:视觉——1.35 秒认出比耶
第二个 demo 检验托管版 Clef-Flash 宣传的视觉输入。作者裁剪一张静图,让模型看到的是手势而不是整个桌面,请求前先固定允许的手势集合,然后问两个问题:哪个手势?手里有没有拿饮料?约束后的答案:gesture "peace_sign"、holding_drink false——1.35 秒——与输入对得上:两根手指伸出、手里没饮料。这是量化包接受图像输入的有用证据,视频同时挂上自己的警示:这只是一张图、而且走的是生成 JSON,不是视觉基准测试。
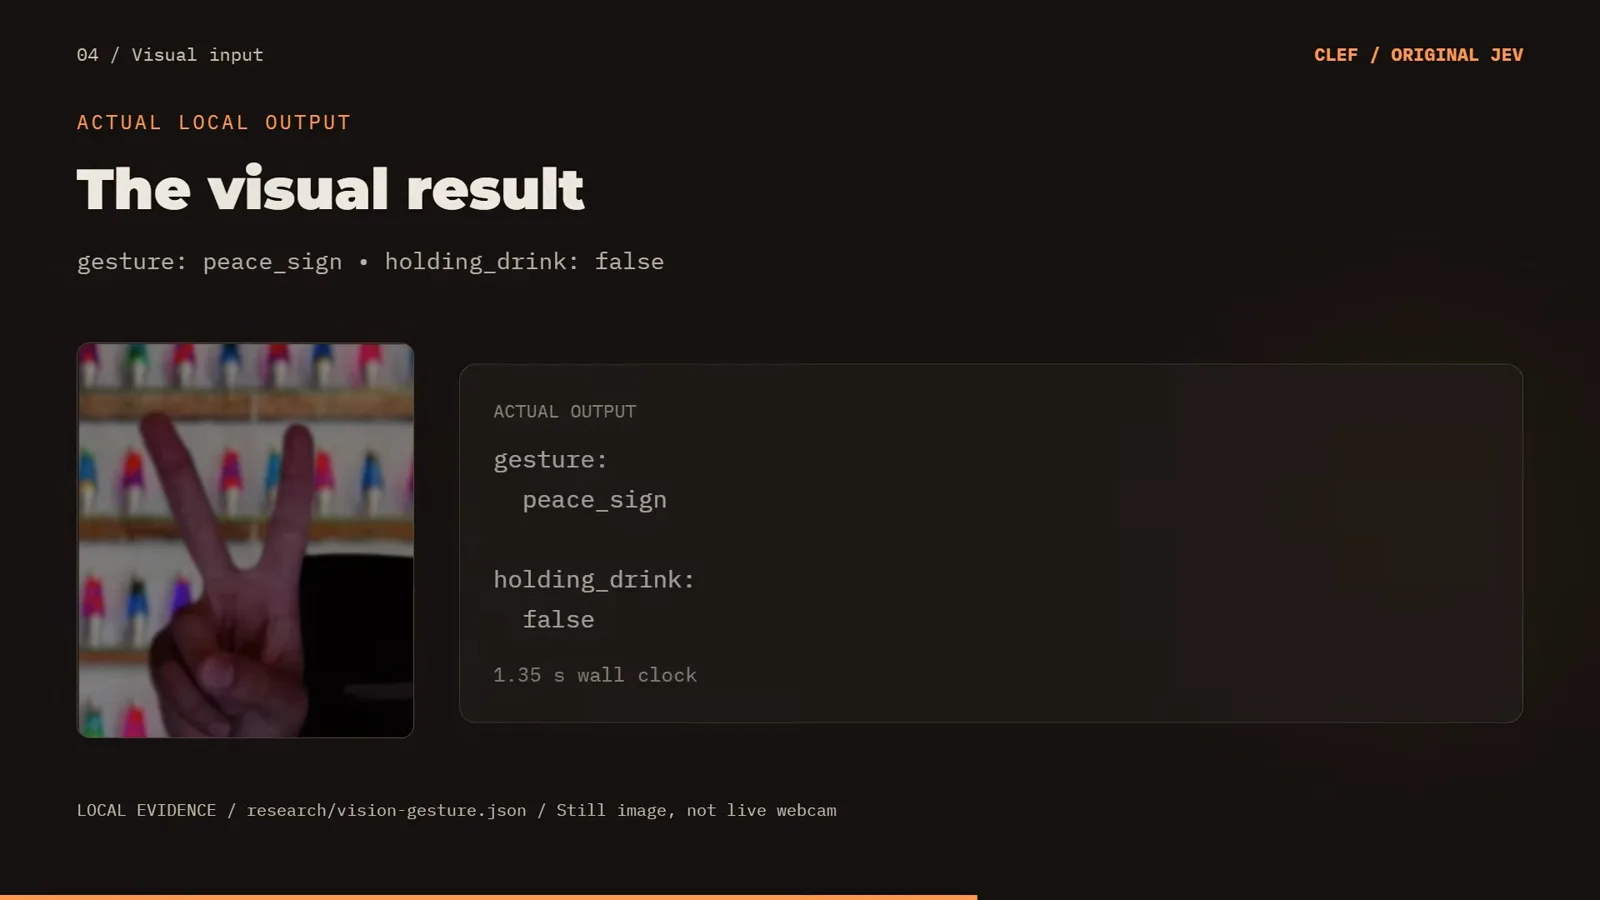
一张裁剪静图:peace_sign、holding_drink false、1.35 秒——视觉通路在 Ollama 里跑通了。跳转至 8:05 - 10
推理缝隙:决策头从未被加载
现在是可以重定义两个 demo 的发现。官方发布的文件清单里有独立件——backbone.safetensors 加 joint_head.safetensors 与 joint_schema_model.py——参考加载器显式地把 head 和 backbone 一起加载,用它给允许的选项打分。受检的 Ollama 路径是另一回事:427 个 backbone 张量、零 schema/head 名称匹配,而且按请求日志——是生成输出 token。支持工单的答案用了约 30 个 token,图像答案 21 个。那些是被解析成 JSON 的生成字符串,不是原生选项概率,视频拒绝包装这一点:「我不会为了把 demo 装扮成原版决策界面而编造置信度条。」
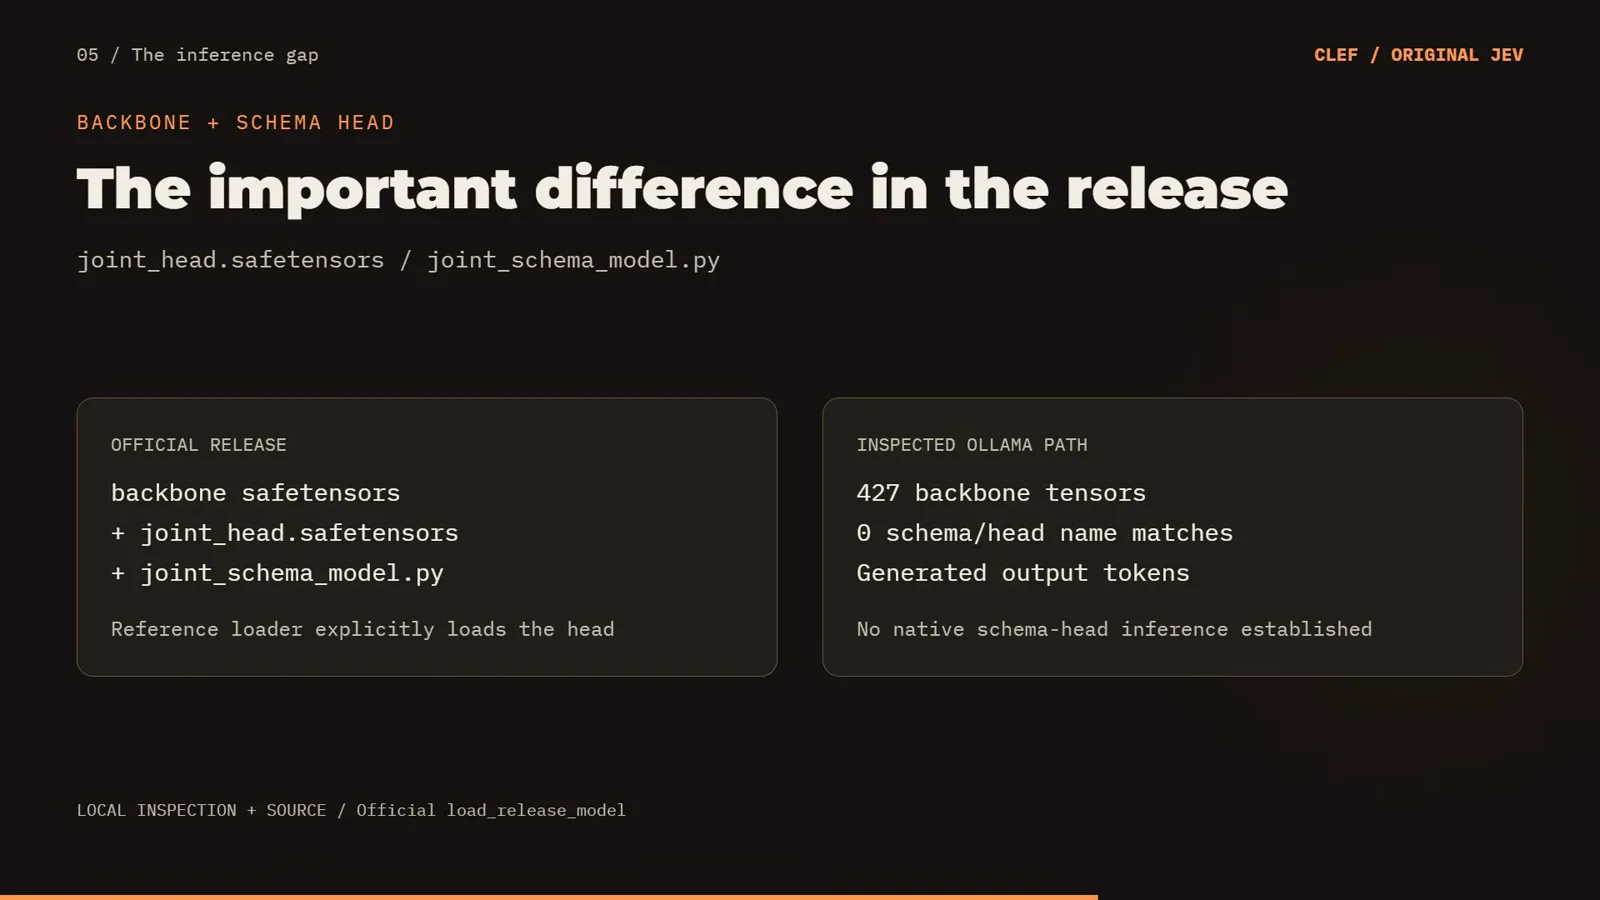
官方发布:backbone + joint head,加载并打分。Ollama 路径:427 个 backbone 张量、0 个 head 匹配——生成 JSON 代替。跳转至 9:05 - 11
公开对比:Clef-Flash vs Jev,标注清楚
与 Jev 对比要切换证据源——这几根条形来自 Cloudflare 公开评测,不是这台笔记本。API-Bank 上 Clef-Flash 93.11 对原版 Jev 88.19;When2Call 上反转,Jev 80.97 对 65.58。卡片自带警示标签——厂商评测、非我们 Q4_K_M 成绩——旁白补上诚实的框架:公开数字决定「该去查什么」,不决定「该部署什么」。它们真正确立的是:这个品类现在有两个各有所长的正经实现。
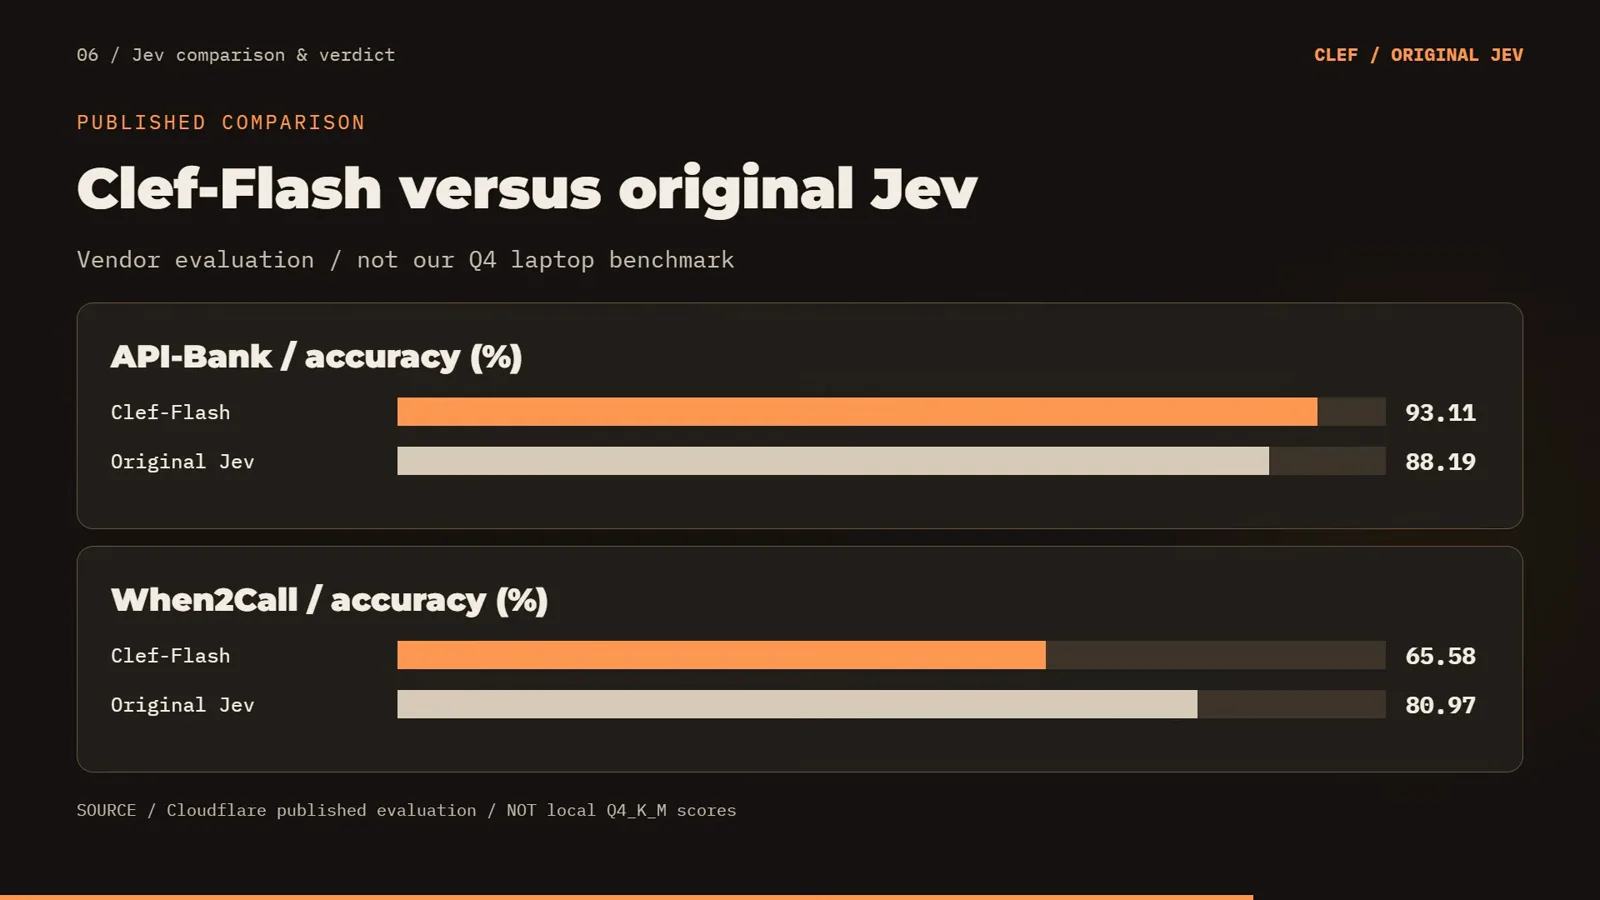
API-Bank 归 Clef-Flash(93.11 vs 88.19);When2Call 归 Jev(80.97 vs 65.58)——厂商评测,标注清楚。跳转至 10:22 - 12
工作流分数故意地不分胜负
工作流层的公开分数同样拒绝给冠军:客服 exact actions Clef-Flash 77 对 Jev 76(掷硬币)、发票处理 57.1 对 61.8 归 Jev、agent traces 69.8 对 71.6 归 Jev。视频把这条边界画了两遍:这些是厂商上报的评测分数,对这个量化版什么都不保证;而延迟数字活在两个世界——Cloudflare 报告托管 Clef-Flash 中位约 38.8 毫秒、同场托管评测 Jev 约 204.7 毫秒,而这台笔记本的 Q4_K_M 请求要 1.4–2 秒。托管厂商延迟和本地生成 JSON 延迟是两种测量;把它们画进同一张图就是抹掉差异。
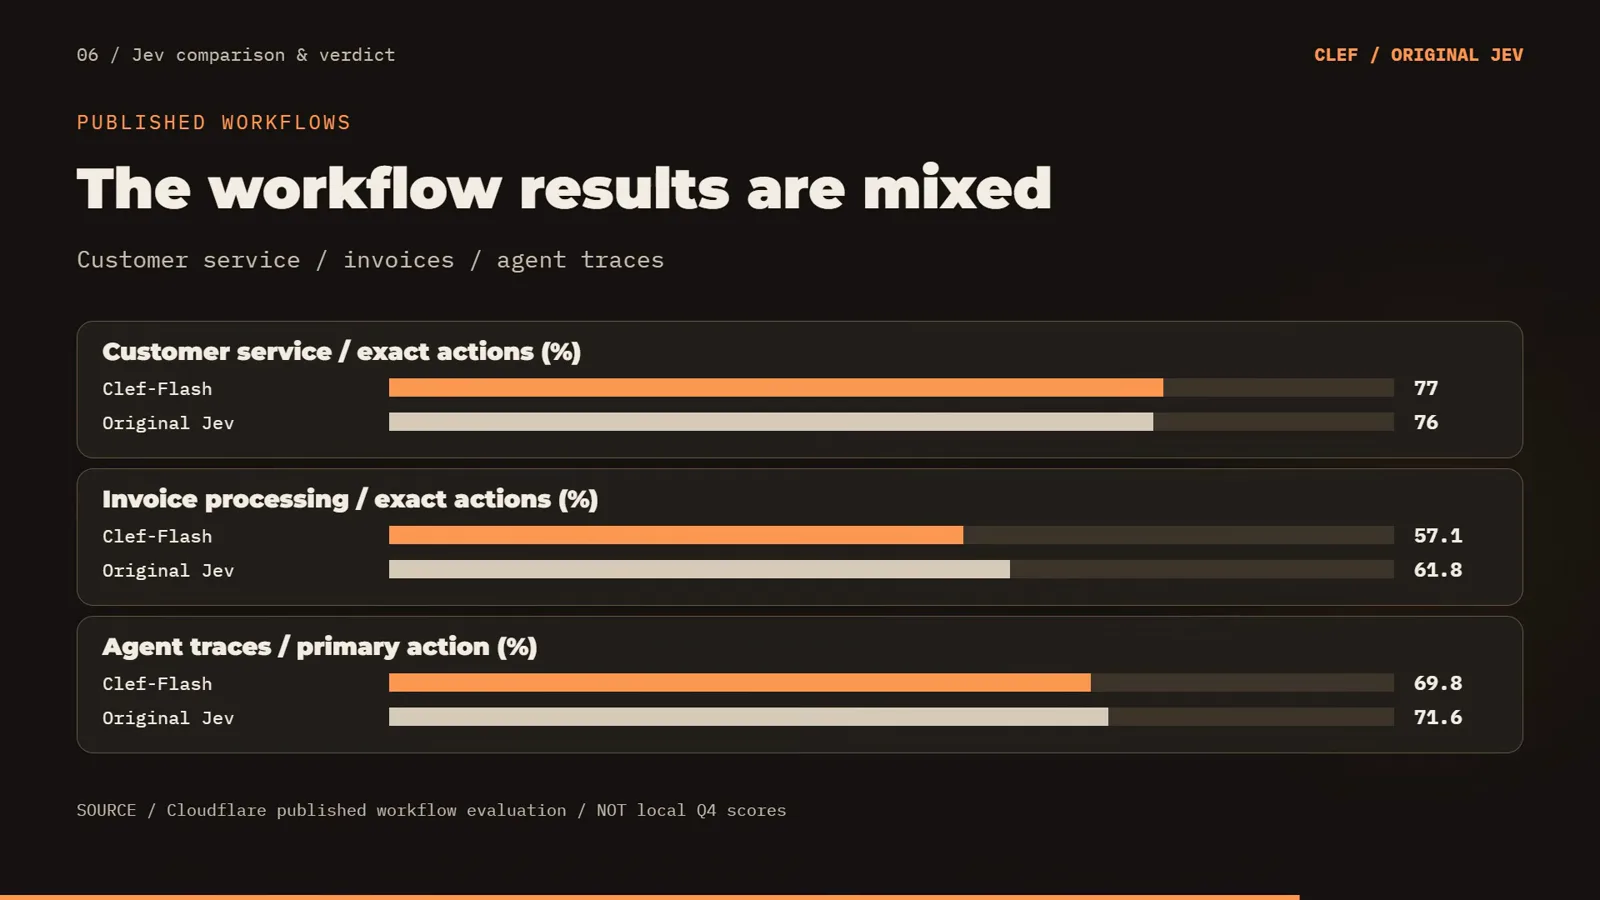
77 对 76、57.1 对 61.8、69.8 对 71.6——没有干净赢家,每个数字都标注了出处。跳转至 10:45 - 13
判词:本地能跑。原生决策头是另一回事。
收尾卡片把两个真相同时握住。本地能跑:Q4_K_M 包在 8GB 笔记本上工作、接受了图像、产出了 schema 合法的 JSON——但支持路由在重复的宕机请求上表现不稳。原生决策头没跟上:这里的 Ollama 输出是生成的 JSON,不是官方决策机制。收获可以推广到这个模型之外:查运行时,因为模型名字不会告诉你跑的是哪种机制。而务实的下一步与我们的打法完全一致——保留显式 schema、在代码里校验选中字段、复核模糊或高后果的案例(那次宕机复跑就是常设理由);想要完整决策模型体验,下一步是真正加载 joint schema head 的运行时——让生成的答案附带一个置信度数字,修不了这道缝。
It runs locally. Native head separate.——这个品类最需要的两句式诚实判词。跳转至 12:25
常见问题(FAQ)
Cloudflare 的 Clef-Flash 能在 Ollama 里本地跑吗?
能——bartowski 的 Q4_K_M GGUF 在 8GB RTX 4060 笔记本上经 Ollama 0.35.0(2048 token 上下文)正常加载并响应,热请求约 1.4–2 秒一次(约 87% 计算在 GPU)。backbone 文件约 5.84GB,安装包约 6.8GB(含视觉投影器)。但视频没有证明 Ollama 跑的是原生决策机制——见下面关于 joint schema head 的答案。
joint schema head 是什么?为什么重要?
它是官方 Clef 发布里给允许选项打分、产出原生类型化概率的部分:独立文件(joint_head.safetensors、joint_schema_model.py),参考加载器会显式地随 backbone 一起加载。视频检查了本地量化文件:427 个 backbone 张量、零 schema/head 名称匹配,Ollama 日志显示每次答案消耗 21–30 个生成输出 token。换句话说,本地路径生成的是「长得像决策的文本」而不是跑决策头——这也是它的答案没有原生置信度数字的原因。
Clef-Flash 比 Jev 强吗?
Cloudflare 公开评测是分裂的:Clef-Flash 在 API-Bank 上以 93.11 对 88.19 领先,Jev 在 When2Call 上以 80.97 对 65.58 大幅反超;工作流分数为客服 77 对 76、发票处理 57.1 对 61.8 归 Jev、agent traces 69.8 对 71.6 归 Jev。这些是托管厂商评测数字,回答的问题和本地 Q4_K_M 运行不同——把它们当强项地图,别当判决书,然后去测你真正要上线的那个工作流。
为什么同一句宕机提示词会路由到不同团队?
视频把 checkout 宕机工单在 JSON schema 约束、零温度下跑了两遍:Run A 以 2.27 秒答 technical,Run B 以 1.96 秒答 billing(两者都保持 urgent true、severity critical)。一次复跑确立不了原因,但足以说明受测路径给不出稳定的 team 选择——合法的选项照样可以是错误的决策。这正是「先在有标注的样本集上评测、再让任何模型自动路由工单」的论据,也是复核模糊与高后果案例的理由。
怎么让 Clef-Flash 在 Ollama 里输出合法 JSON?
在运行时层约束格式,而不是在提示词里哀求。纯提示词在冷启动跑出了畸形 JSON({"urgent": true, team technical, critical});给 Ollama 提供 JSON schema——urgent 为 boolean、team 与 severity 为 enum——之后每次输出都能解析。保留显式 schema、在代码里校验选中字段,并把约束理解为「格式保证」而不是「正确性保证」。
这和 clef-webcam 仓库有什么区别?
执行路径不同。cloudflare/clef-webcam 仓库用原版发布与参考推理代码,从摄像头帧产出带概率的类型化决策——其 quick start 面向 32GB+ 内存的 Apple Silicon。视频里的 Windows 实验经 Ollama 跑社区 GGUF 量化版,生成 JSON 而不调用决策头。两者都正当,但它们是顶着同一个模型名的两种机制——演示原生决策接口的是 webcam 仓库那一支。
相关推荐
Jev vs Luna:第三方基准指南
本页的「引用数字」姊妹篇:505 样本的 Jev 与 Luna 独立评测。本页动手装和测,那页读记分板。
阅读Jev vs OpenAI Decisions API
产品 API 对比轴:托管决策契约在输出形状、延迟与置信度语义上的差异。
阅读Ollama 决策模型:tev1 与 Nimble
在消费级硬件上真正伺服原生类型化输出的本地决策模型——本实验的对照组。
阅读我们自己的 49 任务基准
Jev 在真实工作负载上的独立 F1、P95 延迟与校准(ECE)测量——正是这支视频要求 Clef 达到的诚实标准。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
- Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
- Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
- Jev 接入 Codex 实操:typesafe-ai/skills 安装与 Gmail 30 封邮件分诊
- Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
- 自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
- CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
- 用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门
- Ollama 决策模型实测:tev1 + nimble 跑在 8GB 显卡上
- Jev 生产环境护栏:五步接入实战手册
- Pi Agent 防跑偏插件实战:让 Jev 出概率,让代码做决定
- Tev1 用例实测:50 个任务看尽本地决策模型的能力边界
- Jev 实测:官方宣称与独立复测之间的距离
- Jev 工单分类实战:after-insert hook 与计算字段两种接法
- OpenJev RLCD 实操:开源校准决策模型本地部署全指南