
Guides / 视频转图文攻略
Jev 接入 Codex 实操:typesafe-ai/skills 安装与 Gmail 30 封邮件分诊
中文实操教程:从 TypeSafe Playground 三原语练手,到把 typesafe-ai/skills 装进 Codex、配置 TYPESAFE_API_KEY,最后让 Codex 读取真实 Gmail 收件箱 30 封邮件按优先级分诊——Jev API 只花了 1.19 秒。
速览结论
这是「装进我的智能体」环节最缺的一条中文实操:作者先在 Playground 用一封面试邀请邮件把三种题型过了一遍——Choice 判定 100% 工作邮件、Noul 以 98% 判定需要回复、Score 打出高优先级;然后把官方 typesafe-ai/skills 仓库直接丢给 Codex,让它自己完成安装。要记住的核心提醒:skill 只是「说明书」,不是内置模型——智能体依然需要环境里的 TYPESAFE_API_KEY,一行 echo >> ~/.zshrc 配好。压轴实验是真实收件箱:Codex 读取最近 30 封 Gmail,Jev 把它们分进优先级——营销邮件和验证码沉底,唯一一封 Google 安全提醒以 98% 置信度排到最高。Jev API 的部分 1.19 秒完成,整个任务耗时 1 分 40 秒,大头全是 Codex 自己。一次安装会同时登记给 Codex、Claude Code、OpenCode、Hermes、Gemini CLI、GitHub Copilot 和 Antigravity。
分步图文攻略
- 1
决策模型回答的是什么:概率,而不是文章
视频开场就是 Jev 的定义式对比:问「这只股票会上涨还是下跌」,普通 AI 写一篇长文分析,Jev 直接返回上涨 72%、下跌 28%——就像开车遇到红灯会本能踩刹车,选 A 还是选 B 的决策不该从 300 字分析开始。第一段实操分析了来自女朋友的一条 WhatsApp 消息「算了,你忙吧,我不打扰你了」,返回的概率报告像一份关系分诊单:82% 概率并非真的想结束聊天,「感觉自己没有受到重视」以 76% 领跑意图分布,建议行动是先承认自己刚才没有认真听、再回复。追问「我最近是不是胖了」得到同样诚实的判定:对方不可能是要客观评估。玩笑背后的正题:意图、优先级、是非判断都是决策问题,而 Jev 原生就说这种语言。
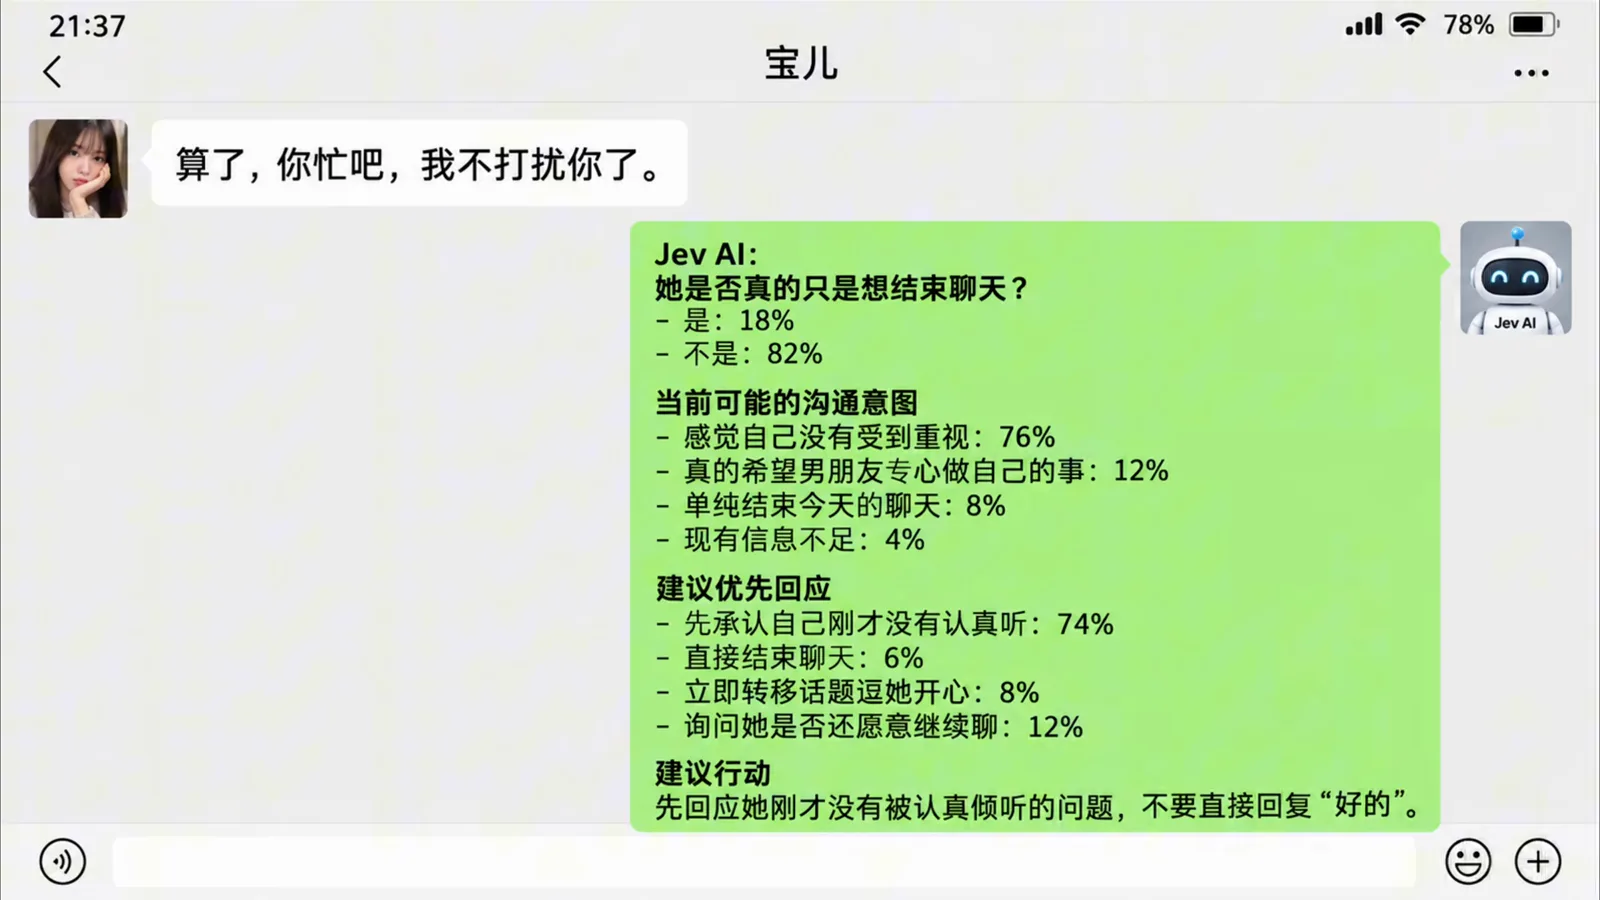
一条聊天记录进、一份概率报告出:82%「不是真结束」,连下一步建议都给好了。跳转至 0:42 - 2
从注册到 Playground:一眼看清控制台
所有操作都在 typesafe.ai:注册账号,点右上角进入 API Console,左侧导航就是全部入口——Playground 做实验、Usage 看消耗、API Keys 管密钥、Documentation 查 API 契约。首页本身就是教材:Learn to TypeSafe 卡片带 you 过 NOUL(「Is hotdog a sandwich?」)、CHOICE(「What color is the sky?」)、SCORE 打分三课,Quickstart 面板则提前展示了本页后面会用到的 agent skill 安装命令。Playground 的输入框吃一段 JSON 格式的 state——视频的类比是「就是提示词,只是要结构化」——下方的 Questions 面板负责挂类型化问题。
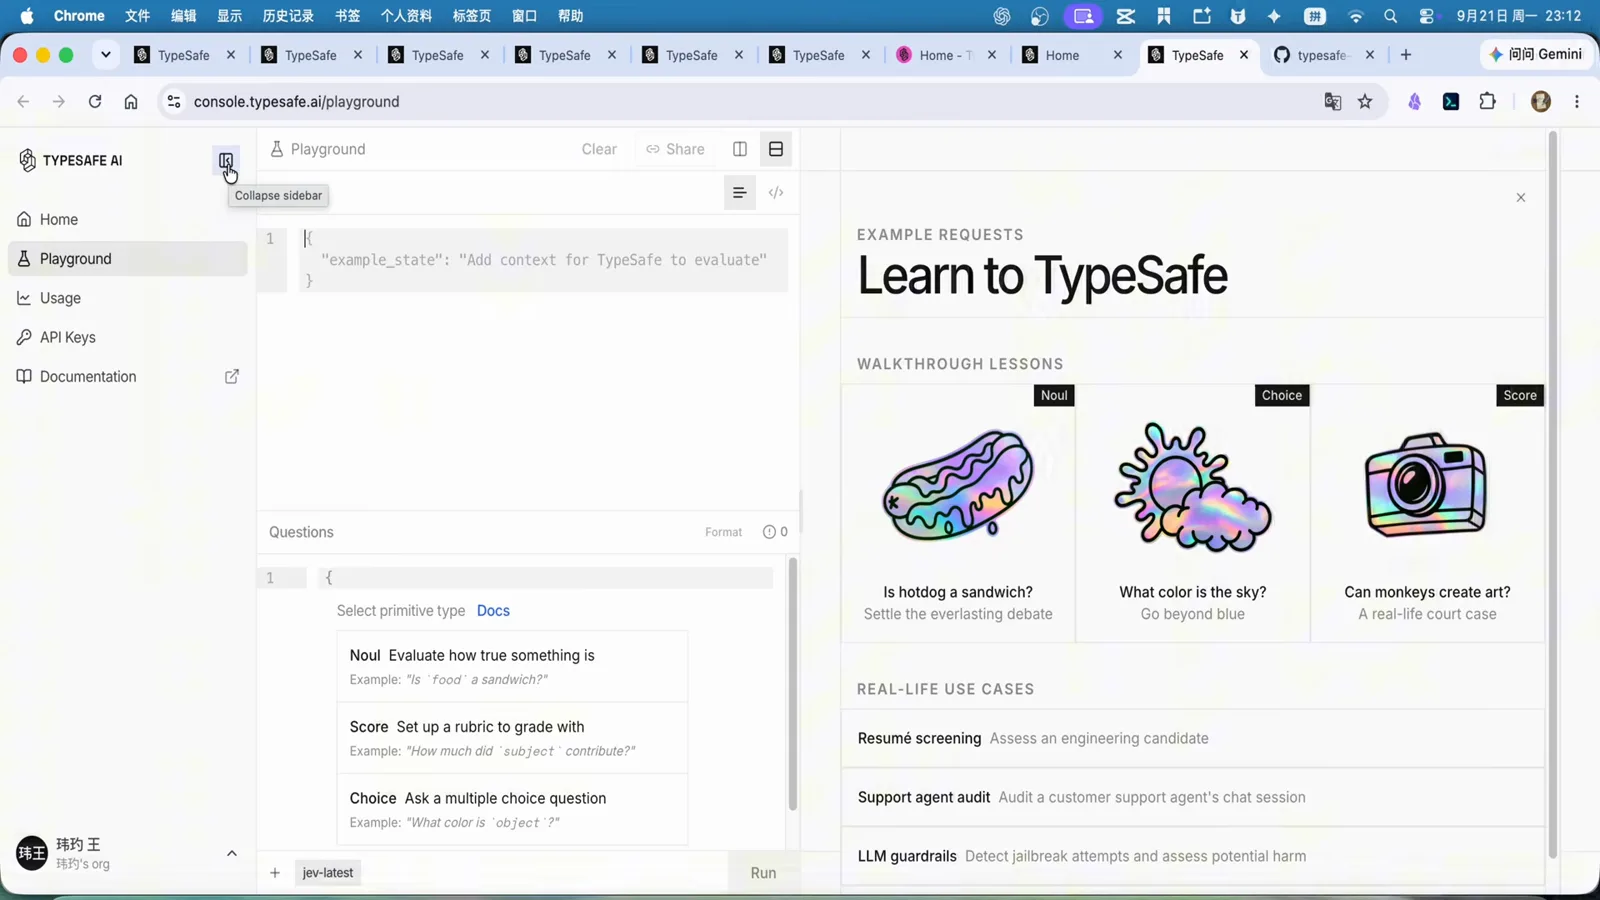
API Console 全家福:Playground 测试、API Keys 发密钥、Documentation 查契约——接入面就这四项。跳转至 2:10 - 3
三种题型:Score、Choice、Noul
接入智能体之前,视频把作者贴进 state 的一封面试邀请邮件当教具,把三种原语各练了一遍。Choice 给命名选项、模型选一个:email_category 以 100% 置信度判为 work,其他选项全部归零。Noul 是真假门:need_reply 以 98% 判 true,因为邮件明确要求收件人确认出席。Score 挂一个评分量表——作者定义了低、中、高三档——返回的是整个量表的概率分布,而不是一个光秃秃的标签。三种题型可以放进同一个请求,后面的收件箱实验吃到的正是这一点。
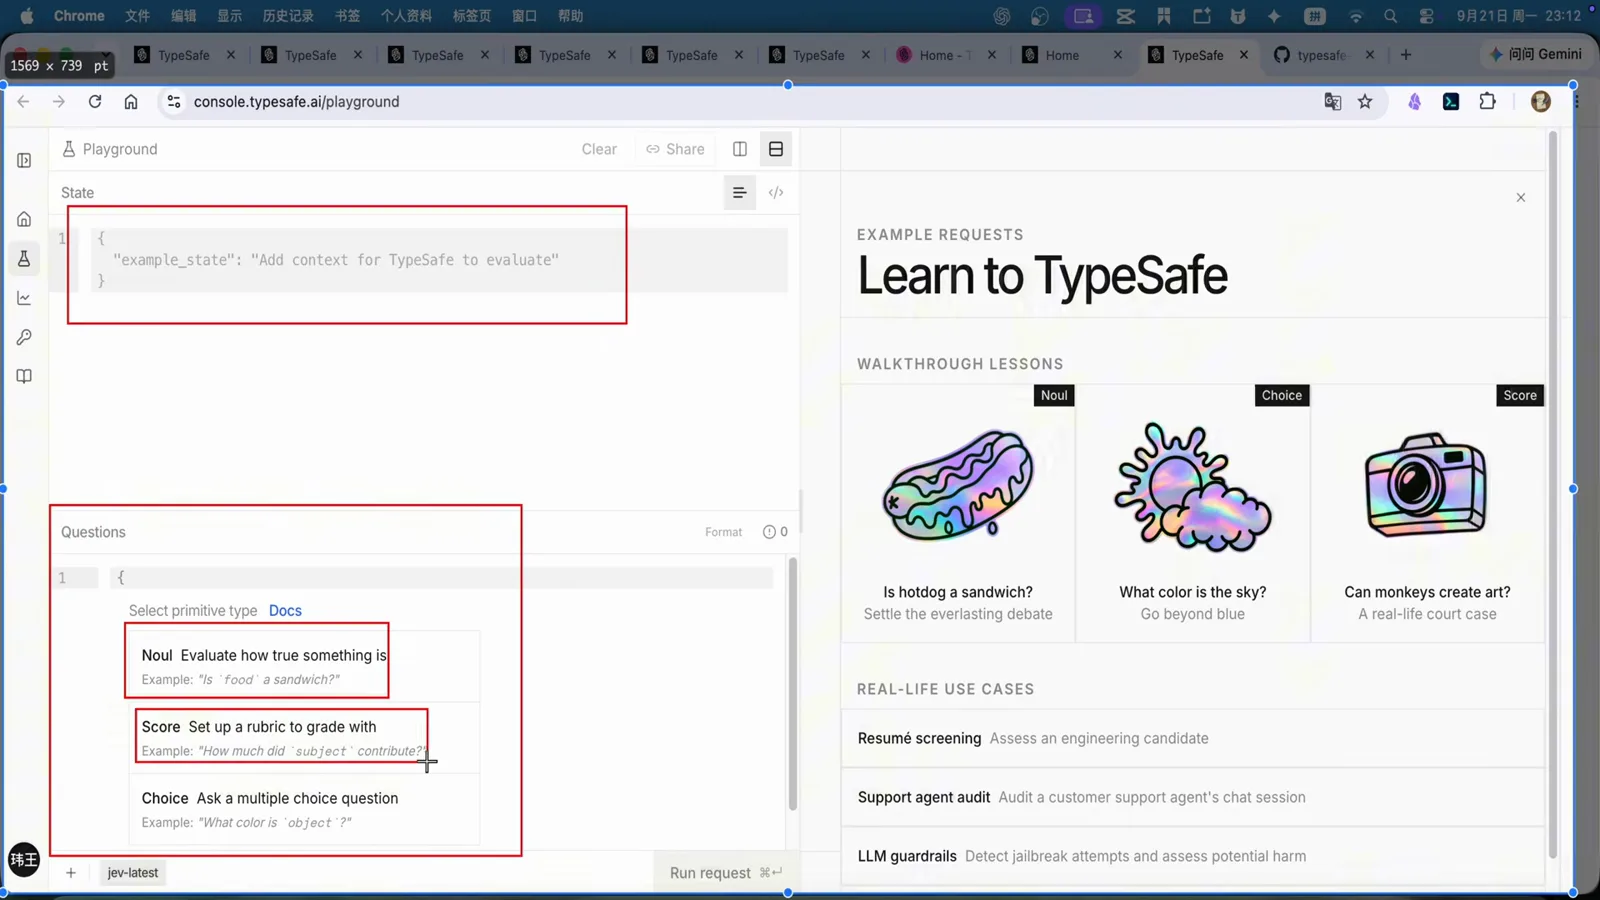
Playground 自带的课程卡:Noul 判真假,Choice 选选项,Score 按你的量表打分。跳转至 2:28 - 4
Choice 实测:一封邮件的路由,100% 工作邮件
email_choice 问题把判据直接写在选项里——需要认真回复的工作邮件、私人邮件、新闻通讯、营销推广——然后跑那封面试邀请。答案面板返回 email_category: work、置信度平直的 100%,其余选项全部钉在 0%,整体置信度盖在响应上。这正是邮件客户端、CRM、智能体需要的形状:不是一段关于邮件的描述,而是带置信度数字的路由键。作者给建设者的定位:如果你有大量邮件或数据要初筛,这一通调用就能替掉「全量丢给大模型读」的那一步。
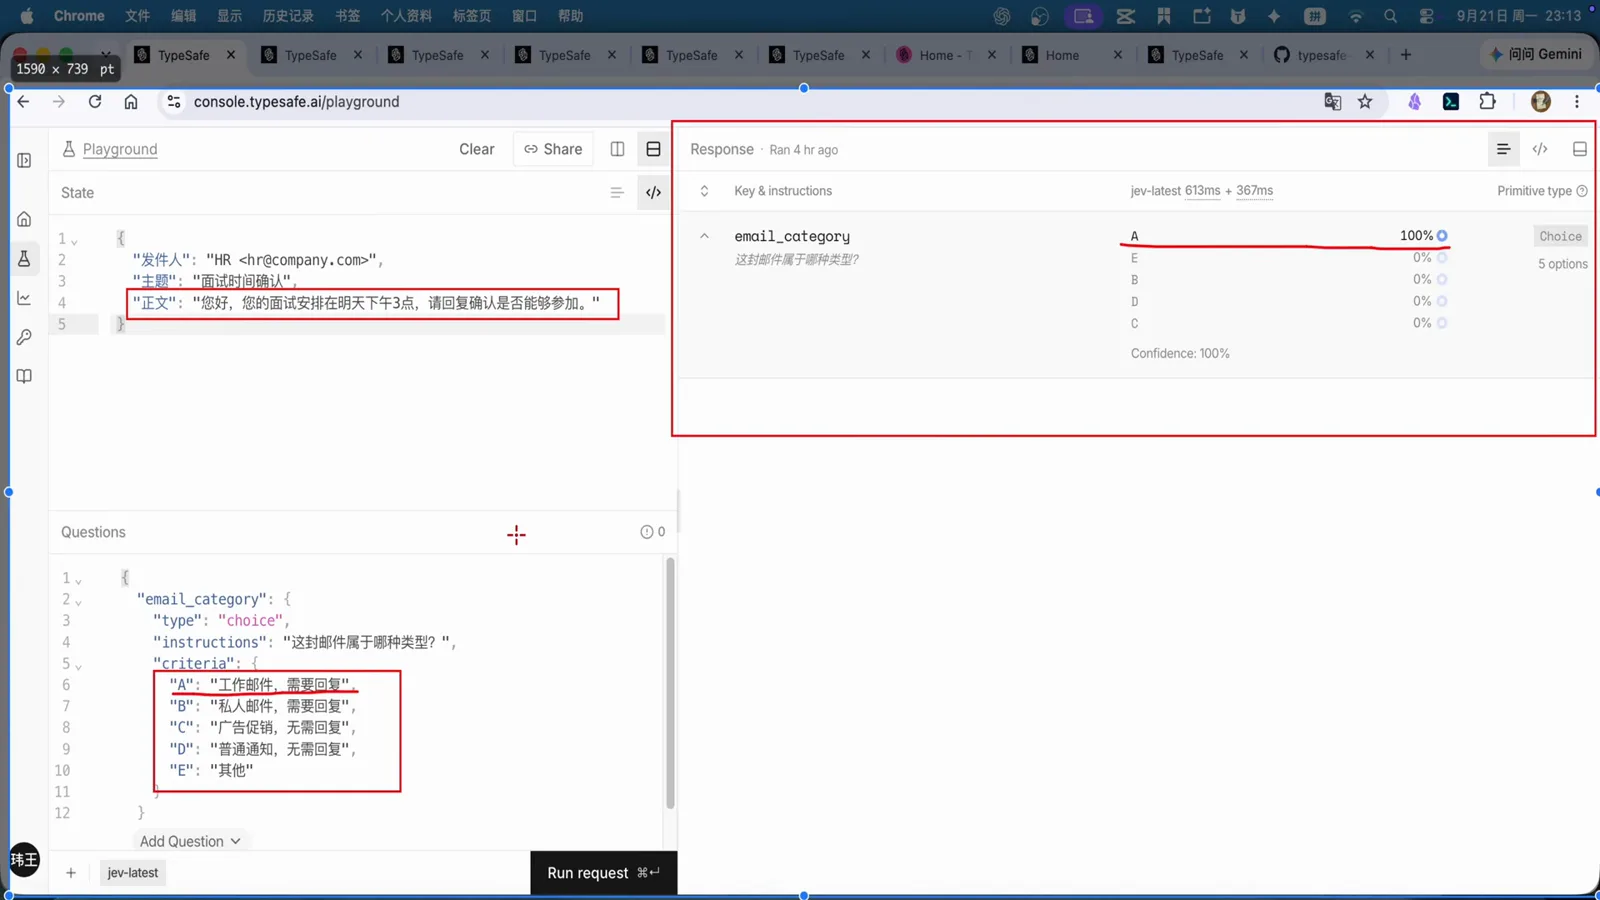
email_category → work,100%:一次类型化调用拿走路由键和置信度。跳转至 3:05 - 5
Noul 实测:要不要回复?98% true
同一封邮件的第二个问题是布尔判断:need_reply。模型以 98% 回答 true,答案旁边附了理由——邮件明确要求确认出席,这基本是「需要回复」所能达到的最无歧义形态。这正是自动化真正拿来分支的门:低于阈值自动归档,高于阈值交给人。前面 WhatsApp 演示用的是同一个原语、瞄准聊天意图,这里则对准了收件箱工作流。
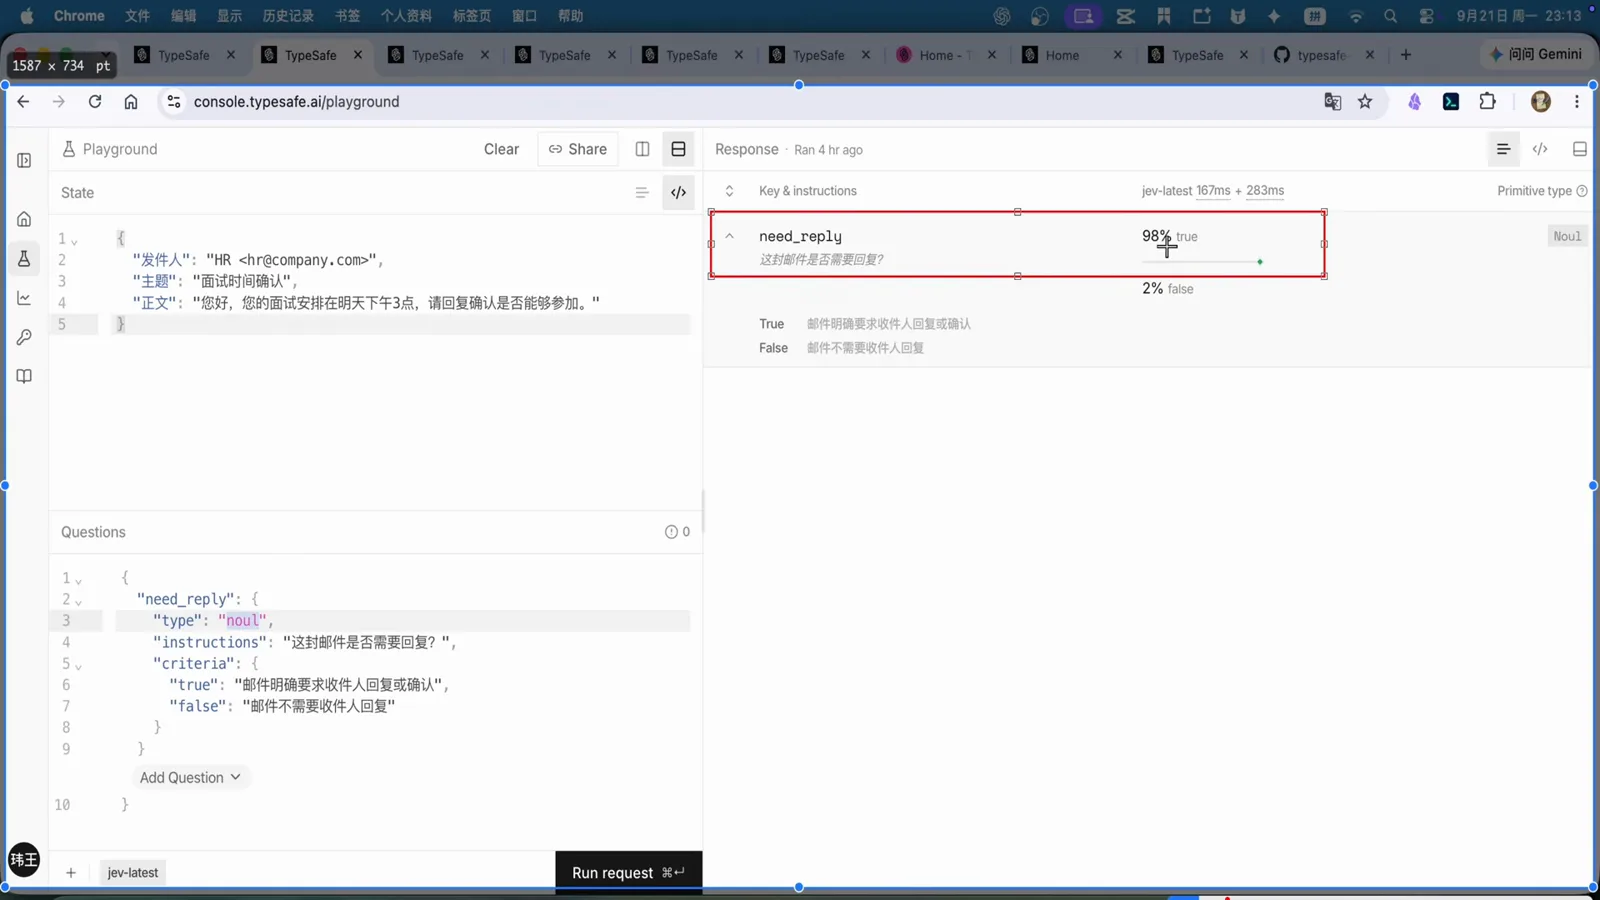
need_reply → true @ 98%:自动化可以真正拿来分支的布尔门。跳转至 3:25 - 6
Score 实测:按自己的量表给紧急度打分
第三种原语挂的是评分量规。作者定义了三档优先级,然后跑一封「密码一直试都不对、账号登不上」的客户投诉邮件。响应面板里 priority 问题把概率几乎全压在最高档,置信度 98% 以上——这正是支持队列在人工介入之前最想要的「先处理这封」信号。当「程度」比「哪个」更重要时,Score 就是该上的原语。
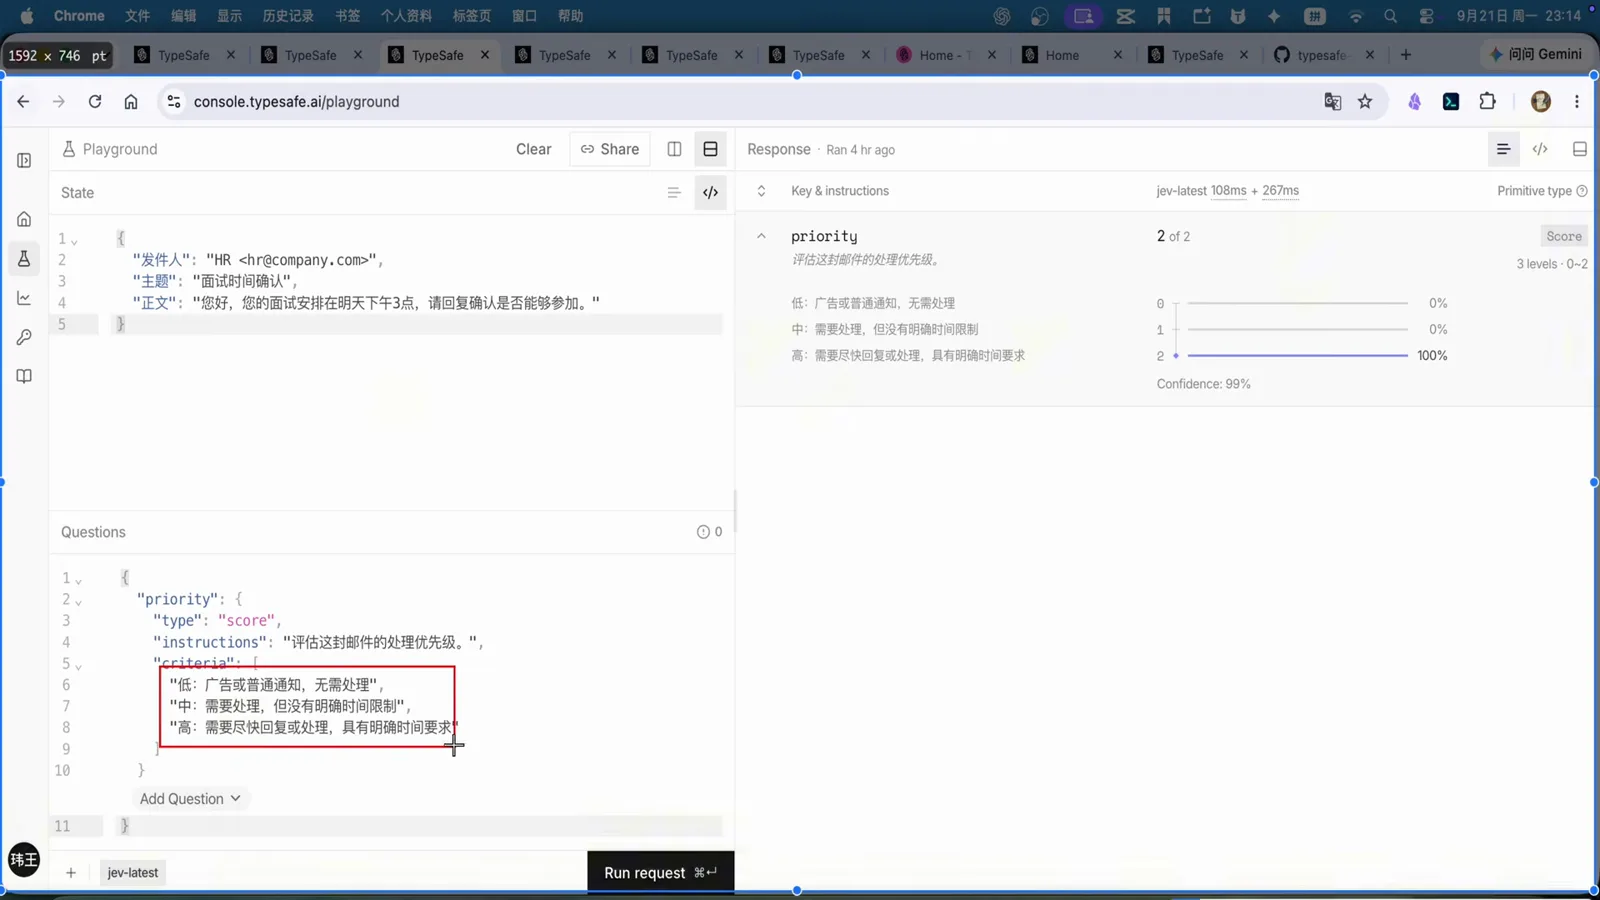
投诉邮件按低/中/高量规打分——概率全堆在最高档。跳转至 3:34 - 7
三题齐发:一份聊天记录、三个问题、一次响应
为了证明原语可以组合,作者把一段聊天记录放进 state,一次请求里问了三个不同类型的问题:她是不是不满(noul)、不满到什么程度(score)、她真正想要什么(choice 列意图选项)。一个响应面板同时带回全部三个答案和概率——很可能不满、感觉被忽视、希望被认真倾听。视频提到已经有人把这套模式接进微信分析聊天意图,也点名了更有商业价值的版本:电商客服、客户投诉处理、数据分析前的初筛。它还顺手回答了那个明显的质疑——手写 JSON 确实反人类,因为这些请求本来就是给智能体发的,不是给人敲的。
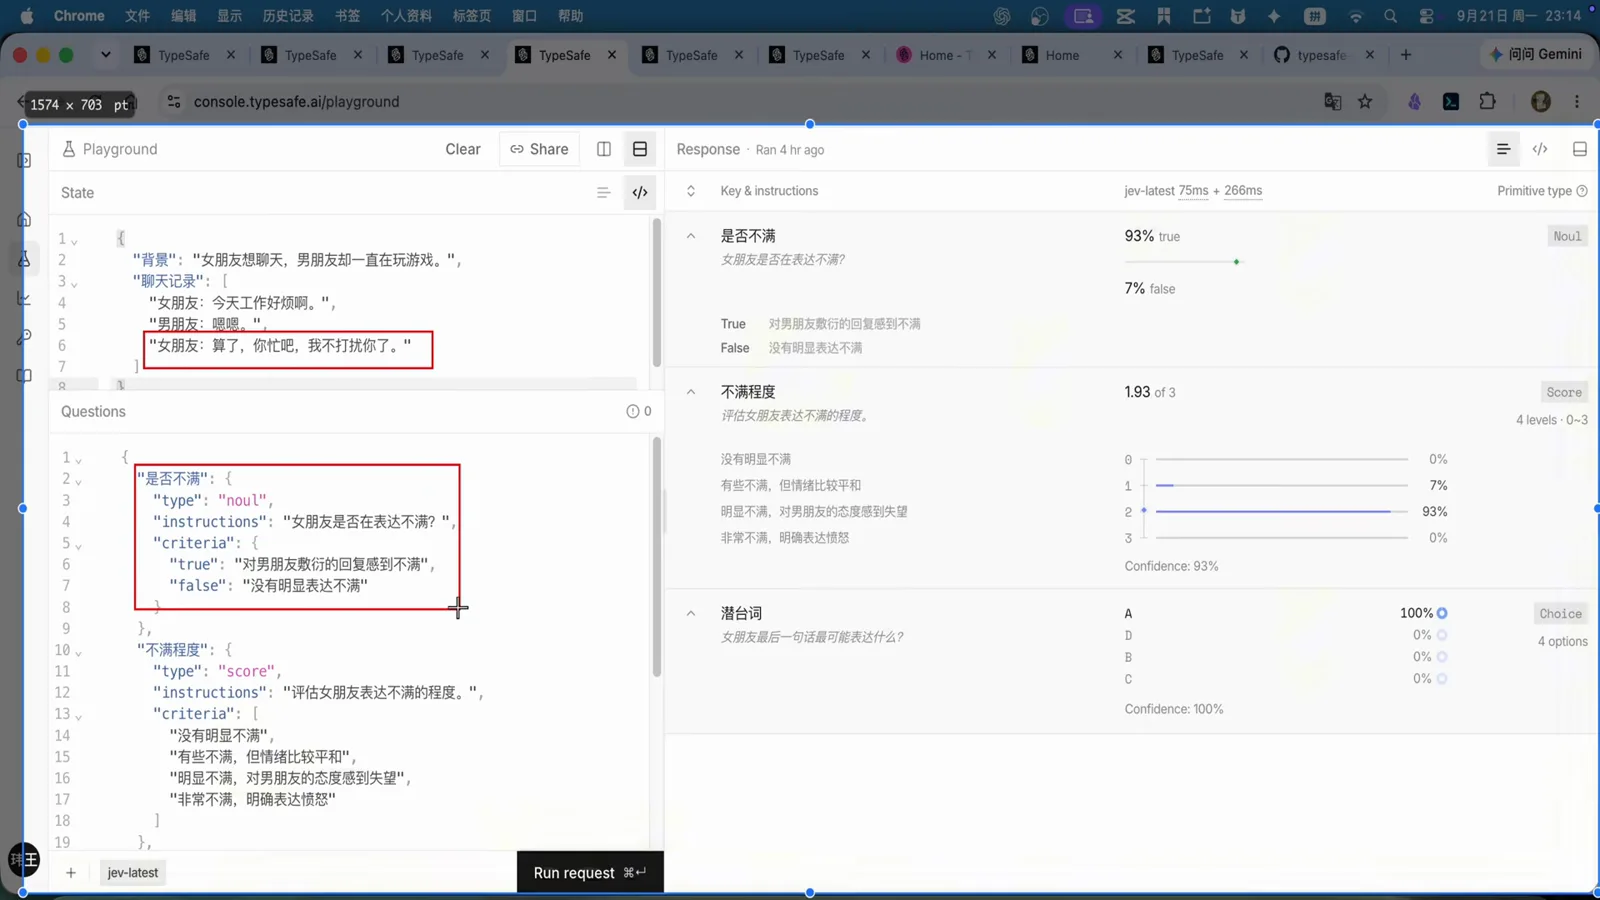
三种题型、一次请求:是否不满(noul)、程度(score)、想要什么(choice)。跳转至 3:52 - 8
让 Codex 自己装 skill
官方 skill 在 github.com/typesafe-ai/skills,视频实际演示的安装方式是懒人路线:把仓库链接发给 Codex,让它自己装。Codex 克隆仓库、检测机器上所有兼容智能体,然后回一张完成卡:全局安装用时 1 分 32 秒,覆盖 Codex、Claude Code、OpenCode、Hermes、Gemini CLI、GitHub Copilot 和 Antigravity,共享位置 ~/.agents/skills/typesafe-ai,各工具入口已验证可读。重启 Codex 即生效。想手动装也行:文档给出的等价一行命令是 npx skills add typesafe-ai/skills --skill typesafe-ai -g,-g 表示装到用户级目录而不是当前项目。
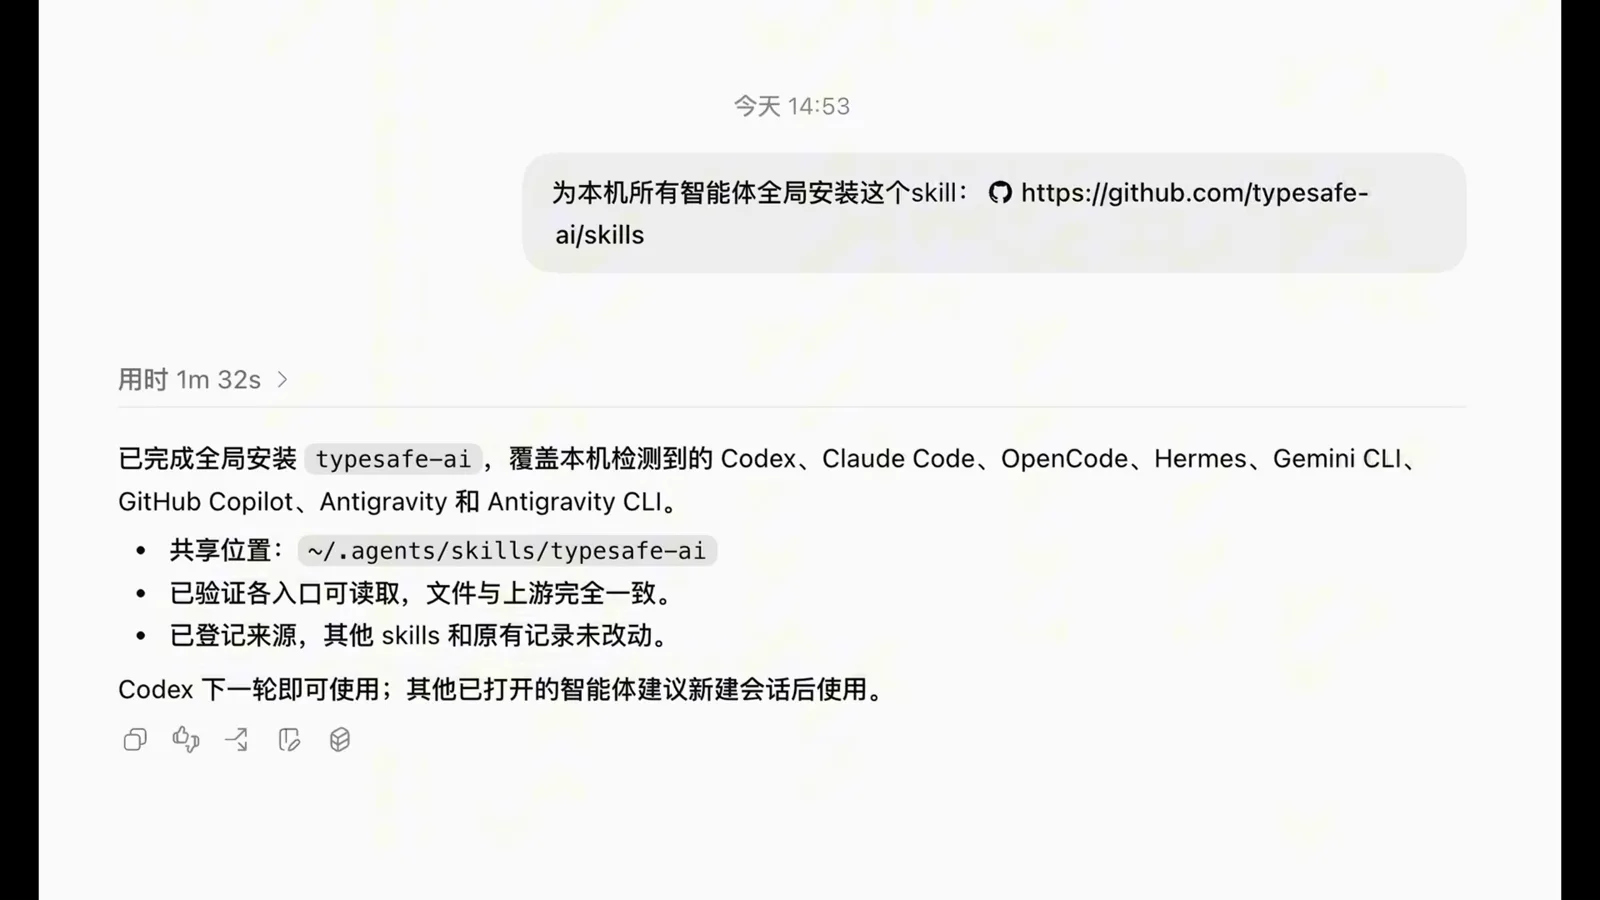
一次安装、八个智能体:skill 自动登记所有检测到的 CLI,共用 ~/.agents/skills/typesafe-ai 一份副本。跳转至 4:56 - 9
最容易踩的坑:skill 不是模型
视频在这个误区上专门停了一下:装 skill 只是教智能体「怎么调 Jev」,不附带模型权重,也不含免费额度。真实调用依然要鉴权,所以智能体必须能在环境里找到 TYPESAFE_API_KEY。屏幕上的文档页给了准确配方:在 TypeSafe 控制台的 API Keys 页创建密钥,然后用 echo 'export TYPESAFE_API_KEY="我的key"' >> ~/.zshrc && source ~/.zshrc 写进 shell 配置。之后智能体会自己判断任务是否需要决策模型——skill 里的指引告诉它什么时候找 Jev、怎么拼 evaluate 调用——你要做的只是保证密钥有效。Jev API 已全面开放,也可以走 OpenRouter 之类的平台当替代通道。
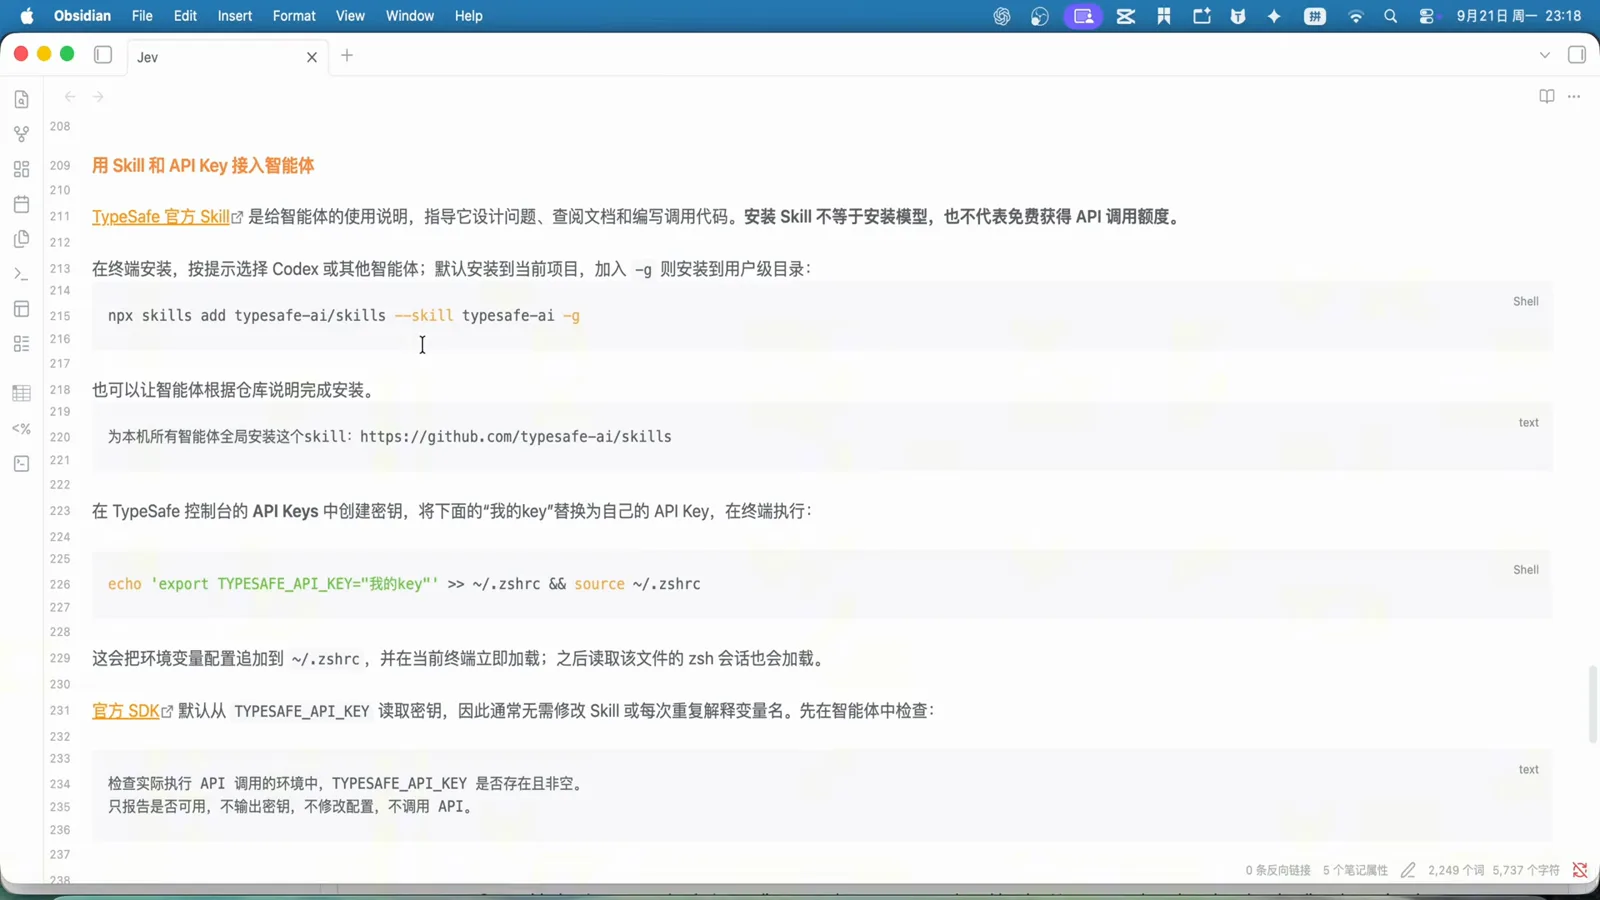
两条命令完事:给智能体装 skill,在 shell 配置里 export TYPESAFE_API_KEY。跳转至 5:20 - 10
验收:30 封真实 Gmail 按优先级分诊
正片来了:已连接 Gmail 的 Codex 被要求调用 Jev skill 读取最近 30 封邮件、按优先级筛选、以表格输出、并报告耗时。这个收件箱真实得可爱——新闻通讯、通知、验证码——表格也如实反映:一行行沉底,唯一一封 Google 安全提醒以 98% 被单独特到了最高优先级。没有任何人工标注,每一行的评级都来自 Playground 演示过的同一个类型化 score 问题。这就是开场论证的「选 A 还是选 B」负载——本就不该送去让大模型长考。
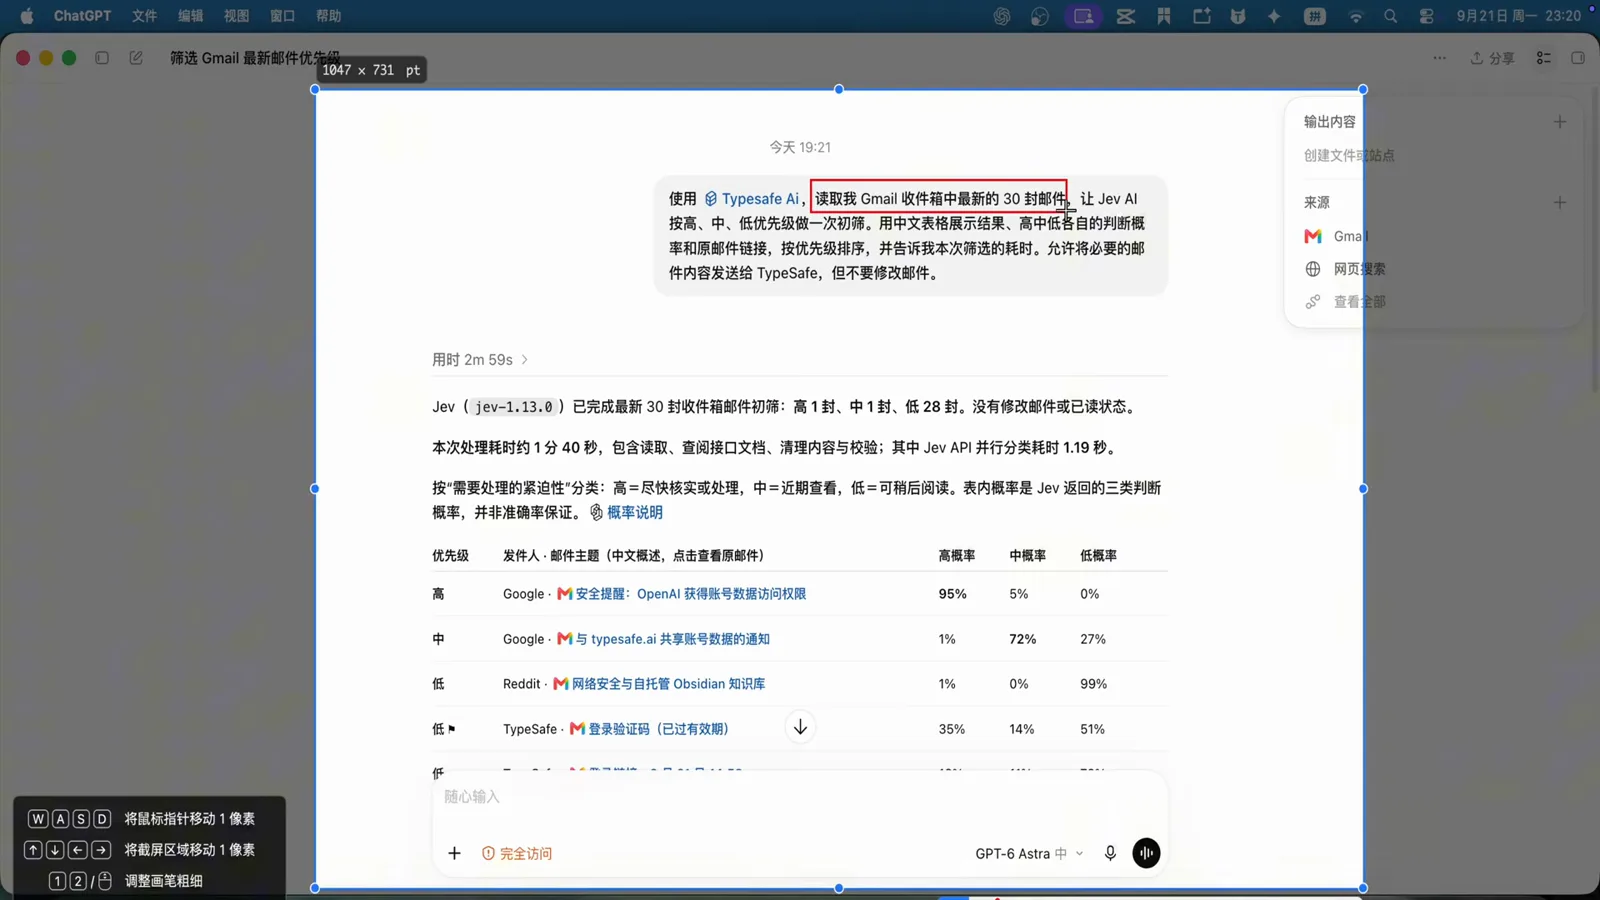
真实收件箱实测:30 封分诊完成,唯一的安全提醒以 98% 登顶。跳转至 6:02 - 11
账单:Jev 1.19 秒,智能体 100 秒
收尾卡片把两块表拆开看:Jev API 完成分诊决策只用了 1.19 秒;整个 Codex 任务耗时 1 分 40 秒,大头几乎全是 Codex 自己——读邮箱、做规划、写表格。把同样 30 封邮件直接放进 Playground 复测,几乎是瞬间返回,证明模型从来不是瓶颈。视频的收尾论点值得记住:把一个高效、快捷、低成本的决策模型接进智能体工作流,「选 A 还是选 B」类问题就不再消耗大模型的长时间思考——无论这条工作流是 AI 客服,还是每天过一遍自己的收件箱。
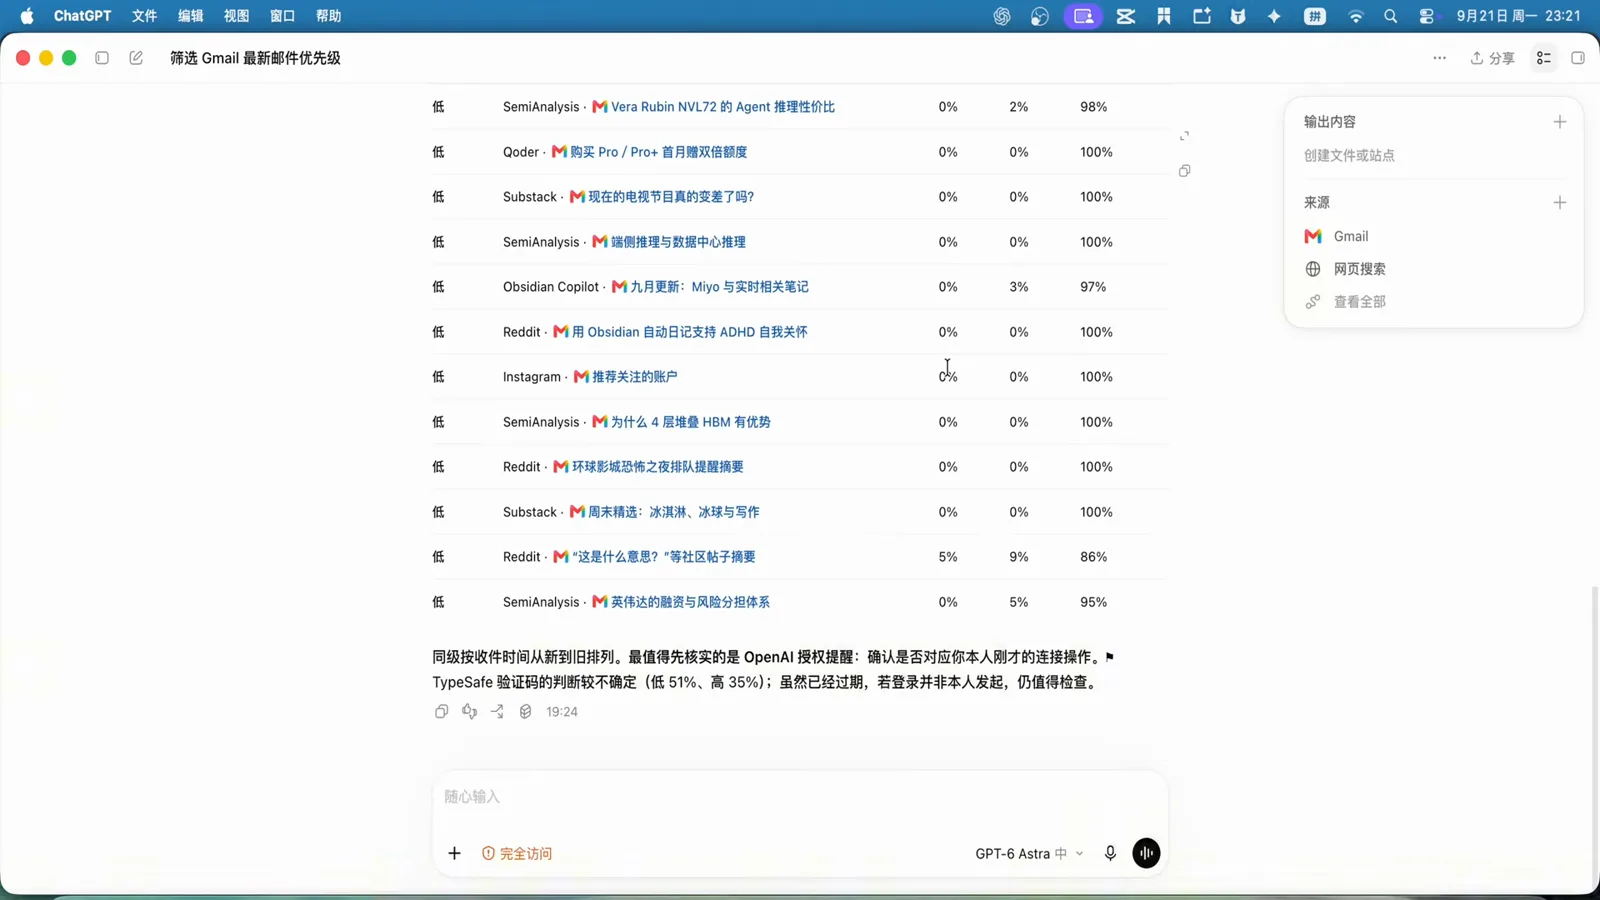
Jev:30 次决策 1.19 秒。剩下约 99 秒是智能体的,不是模型的。跳转至 6:42
常见问题(FAQ)
Jev 的 Codex skill 是什么?
它是官方的智能体 skill 仓库 github.com/typesafe-ai/skills:一组指令文档,教会编程智能体「什么任务该用类型化决策」以及「怎么拼 Jev 的 evaluate 调用」——用哪几种题型、state 的 JSON 怎么组织、返回的置信度怎么读。正如视频强调的:它是说明书和工具,不是内置模型——装它改变的是智能体「会什么」,不是「能算什么」。
装了 skill 之后 Jev 就免费吗?
不是——视频专门提醒过这一点。skill 只负责指导智能体,每一次真实调用仍然要用你的 TYPESAFE_API_KEY 鉴权并计入账户额度。密钥在 TypeSafe API Console 的 API Keys 页创建,通过环境变量暴露:echo 'export TYPESAFE_API_KEY="..."' >> ~/.zshrc && source ~/.zshrc。如果不想走第一方端点,也可以经 OpenRouter 之类的平台调用 Jev。
怎么给 Codex 安装 Jev skill?
两条路,视频都演示了。零 effort 路线:把 https://github.com/typesafe-ai/skills 发给 Codex 并让它安装——它会自动克隆、给检测到的每个兼容智能体登记(视频那台机器 1 分 32 秒覆盖了 Codex、Claude Code、OpenCode、Hermes、Gemini CLI、GitHub Copilot、Antigravity),重启 Codex 生效。手动路线(适用于任何智能体):npx skills add typesafe-ai/skills --skill typesafe-ai -g,其中 -g 表示装到用户级目录(~/.agents/skills/typesafe-ai)而不是当前项目。
Gmail 分诊实验到底在做什么?
Codex 读取真实收件箱最近 30 封邮件,对每一封问 Jev 几个类型化问题——这是什么类型的邮件、需不需要回复、按低/中/高量表紧急度几何——然后把答案拼成优先级表格。在视频的收件箱里,新闻通讯和验证码全部沉底,唯一一封 Google 安全提醒拿到 98% 并被标为高优先级。这套设计可以平移到任何「选 A 还是选 B」密集的数据流:客服工单、表单提交、分析前的数据初筛。
邮件分诊这一轮里 Jev 有多快?
Jev API 完成 30 封邮件的全部决策调用只用了 1.19 秒。端到端的 Codex 任务耗时 1 分 40 秒——几乎全是智能体自己的读信、规划、写表格,这恰恰是把决策外包给决策模型的价值所在。同样 30 封邮件直接贴进 Playground 几乎瞬间返回,进一步确认这条流水线里慢的从来不是模型。
Jev skill 该配 Codex 还是 Claude Code?
同一份安装两边都能用——skill 会给自己检测到的每个兼容智能体登记,演示机器一次性覆盖了八个 CLI。本站的分工是:本页是 Codex 侧实操(含 Gmail 工作流),我们的 Jev + Claude Code 指南覆盖同一条集成的 Claude Code 侧(语音进、Jev 决策、浏览器执行)。装一次,然后用哪个就在哪个里用。
相关推荐
Jev + Claude Code:智能体编排指南
本页的 Claude Code 姊妹篇——语音进、Jev 决策、浏览器执行。本页走 Codex 侧,那页走 Claude Code 侧。
阅读Jev API 参考与接入指南
skill 背后实际调用的东西:端点、evaluate 载荷、密钥管理与生产级集成的失败处理。
阅读客服工单路由 Recipe
收件箱演示的生产级版本:面向客服队列的类型化路由,带置信度门控的人工升级通道。
阅读Tev1 用例实测:50 项本地决策模型任务
还能接进智能体工作流的五十种决策形状——路由、防护、分诊——本地运行单次 $0。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
- Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
- Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
- Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
- 自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
- CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
- 用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门
- Ollama 决策模型实测:tev1 + nimble 跑在 8GB 显卡上
- Jev 生产环境护栏:五步接入实战手册
- Pi Agent 防跑偏插件实战:让 Jev 出概率,让代码做决定
- Tev1 用例实测:50 个任务看尽本地决策模型的能力边界
- Jev 实测:官方宣称与独立复测之间的距离
- Jev 工单分类实战:after-insert hook 与计算字段两种接法
- OpenJev RLCD 实操:开源校准决策模型本地部署全指南
- Clef-Flash vs Jev 实测:把 Cloudflare 决策模型装进 Ollama(Q4_K_M)