
Guides / 视频转图文攻略
Jetson 边缘实测:Jev、Strands Decider 2B、Laya、d1-3B 四模型横评——Skill Master 记分卡、Thor 延迟账与 JevBench 逐帧核对
把 JetsonHacks 的 Skill Master 实测视频整理成分步图文:托管 Jev 对 Strands Decider 2B、Laya、d1-3B 三只本地开源决策模型,同一组 14 道 Jetson 技能题逐题打分——99% 的识别题、45% 的维护题陷阱、0–3 干预评分、Orin Nano 内存账、Thor 直跑 30–50 毫秒、FastAPI 包装税,以及 JevBench 86.6/75.3/72.3 的记分卡,每个卡面数字都放大核对过。
速览结论
十二分钟视频的浓缩版,卡面数字全部对帧核实。测试台:jetsonhacks.com 的 Jim 自建 Skill Master,一个本地 Web 控制台,把同一个查询发给多个模型、用同一套 UI 渲染每个答案——全部选项的概率条、0–3 刻度的干预评分、逐题耗时、以及给十四道例题打字母等级的 summary 页。两次录制会话里出现过的标签页:Jev remote、CLM-8B local(仅首次会话、未参测)、Strands Decider 2B local、Laya local、d1-3B local。测试集:14 道例题——identity、processes、memory before/after、fit model、container、serve、LLM performance、speculate、codec support、video ready、transcode、video speed、vague、outside。头条答案:「Which Jetson module and L4T release is this board running?」→ Device info 99.0%、Ask for clarification 1.0%、其余十四个选项全为 0.0%,卡 MATCHES EXPECTED SKILL,本次往返 153 毫秒,界面标价约 0.000047 美元/次(每千次 0.047 美元)。置信度规则:「Set up a vLLM server for this model on my Jetson Thor」一题,胜出的 LLM serving setup 只有 45.0%(clarify 27.0%、Package compatibility 15.0%、Device info 10.0%)——口播规则:置信度通常要过 60% 才可信,重要问题要更高——而干预侧打得毫不犹豫:0–3 刻度 2.99、置信 99%、最可能等级 3「Change and verify」;这一屏的请求头正是 JEV · 137 MS ROUND TRIP,即他口播的那个数。两条退路:无上下文的「Can you check it?」→ Ask for clarification 100.0%,干预 0.11、置信 89%、最可能等级 0 Inspect——他觉得这个评级有点偏;「写一首关于机器恐龙的诗」→ No matching skill 100.0%(「请求很清楚,但目录里没有合适技能」),134 毫秒。请求原文:POST 到 https://api.typesafe.ai/v1/systemone,体为 {"model": "jev-latest", "state": "<用户查询>", "questions": {"skill": {"type": "choice", "instructions": "选出应首先处理用户请求的那一个技能;关键细节缺失选 clarify;请求清楚但超出目录选 no_matching_skill;多步请求选第一个有用的技能;不要推断测量、不要执行技能。", "criteria": {"jetson-print-device-info": "识别 Jetson 模块、L4T 版本、内核、OS 版本、运行时间或当前电源模式。", "jetson-diagnostic": "检查当前 RAM、进程、GPU、散热、电源、存储与服务健康。", "jetson-memory-audit": "测量 DRAM 与 NVMap 使用,变更前后核对内存回收。", "jetson-inference-mem-tune": "为 Jetson 工作负载选择 LLM/VLM 伺服栈及其内存设置。", "jetson-package": "为 JetPack 版本挑选兼容的容器、vLLM 镜像与 Python 包索引。", "jetson-llm-serve": "在兼容 Jetson 上立起 vLLM 或 SGLang 服务。", …}}}}——共十六个选项:十四个技能加 clarify 与 no_matching_skill,全部在请求里定义、不烙进模型。响应:{"model": "jev-1.13.0", "answers": {"intervention": {"type": "score", "score": 0, "confidence": 1, "legend": {"0": "Inspect:识别或读取现有设备状态。", "1": "Measure:跑测试、审计或基准,不请求配置变更。", "2": "Recommend:只建议设置、方案或计划、不落盘。", "3": "Change and verify:安装、配置、启停或修改某物并核对结果。"}, "probabilities": {"0": 1, …}}}}——代码按键读数,无散文可解析。概念卡:分类器、LLM、决策模型共享一个输入阶段(prompt → 编码/pre-fill → 上下文表示);分类器答训练时固定的标签——加类别就要重训;LLM 逐 token 写自由文本、一 token 一趟,框架还得事后解析字符串;决策模型在运行时任意提问——noul、choice、score——单次前向出类型化答案。「灵活、类型化、快。」本地阵容:AWS Strands Decider 2B;Laya(最小、最弱,视频没多花时间);Liquid AI d1-3B(实验室出自 MIT CSAIL 一脉,为快速单遍决策而生)。内存:三只都能上 Orin Nano,但 Strands 与 d1-3B 会吃掉大部分内存;更大的 Orin 与 AGX Thor 从容(示意图、非等比)。记分卡:Jev 14/14、平均每题 150 毫秒、平均 1109 token 进 / 222 出、0 题未跑——12 A、1 B(codec support)、1 C(serve);Strands 14/14、平均 353 毫秒、794 进 / 354 出——10 A、4 B(identity、processes、serve、vague);Laya 8/14;d1-3B 14/14——9 A、4 B、1 C。分题型看:识别题 Jev 99%,Strands 选对但只有不安的 61%(干预评级也低),Laya 选错技能,d1-3B 居中且干预判断正确;维护题翻盘——d1-3B 四模型最高,Strands 远超 Jev,Laya 也高于 Jev。LLM 基线:Claude 平均约 2.5 秒选一个技能;Jev 约 135 毫秒——18 倍差距,「比常规 LLM 快 10–20 倍」的宣传在这场测试完全成立。部署账单:Thor 直跑 30–50 毫秒;包进模拟 TypeSafe Jev API 的 FastAPI 服务要多付 75–100 毫秒——所以「基准数字其实低估了本地模型」;不走服务器直连可再快约 2 倍,作者预期这些本地小模型实战中至少不慢于托管 Jev。JevBench:Jev 1.13.0 86.6%(200/231)、d1-3B 75.3%(174/231)、Strands V19 72.3%(167/231)——简单题几乎持平、标准题 Jev 小胜、难题显著拉开;如今决策模型已过百个、榜满天飞,值得按自己的标准做调研;但把比较收敛到路由、策略决策、工具选择、复杂路由这几类真实任务,三家本质等价——而本地模型还有一张独有的牌:按你的工作负载微调。收尾:决策表由应用定义(noul 是否题、把 clarify 当选项的 choice、0–3 的干预评分),新决策要的是新上下文、不是重训——但 instructions、类别清单、组合测试都由应用来写来测,时间一长就是更多要维护的应用代码。模型更简单、快得多;系统可未必。
分步图文攻略
- 1
测试台:一个查询、四个模型、十四道例题
视频开场就是 Skill Master——Jim 为这次对比专门写的本地 Web 应用:一个查询框、一排模型标签页,同一个问题发给每一只。这一场是托管 Jev 对三个本地开源模型:Strands Decider 2B、Laya、d1-3B(更早的录制会话里还有一块 CLM-8B 标签,始终没参测——应用在两次录制之间长过)。样例集是十四道 Jetson 用户真会问的题:identity、processes、memory before/after、fit model、container、serve、LLM performance、speculate、codec support、video ready、transcode、video speed,外加一道故意含糊的、一道目录外的。第一枪打「Which Jetson module and L4T release is this board running?」——Device info 以 99.0% 拿下,Ask for clarification 是唯一另一个有存在感的选项(1.0%)。应用盖上 MATCHES EXPECTED SKILL 的章,显示这次调用 153 毫秒往返,甚至标了价:约 0.000047 美元一次、一千次 0.047 美元。
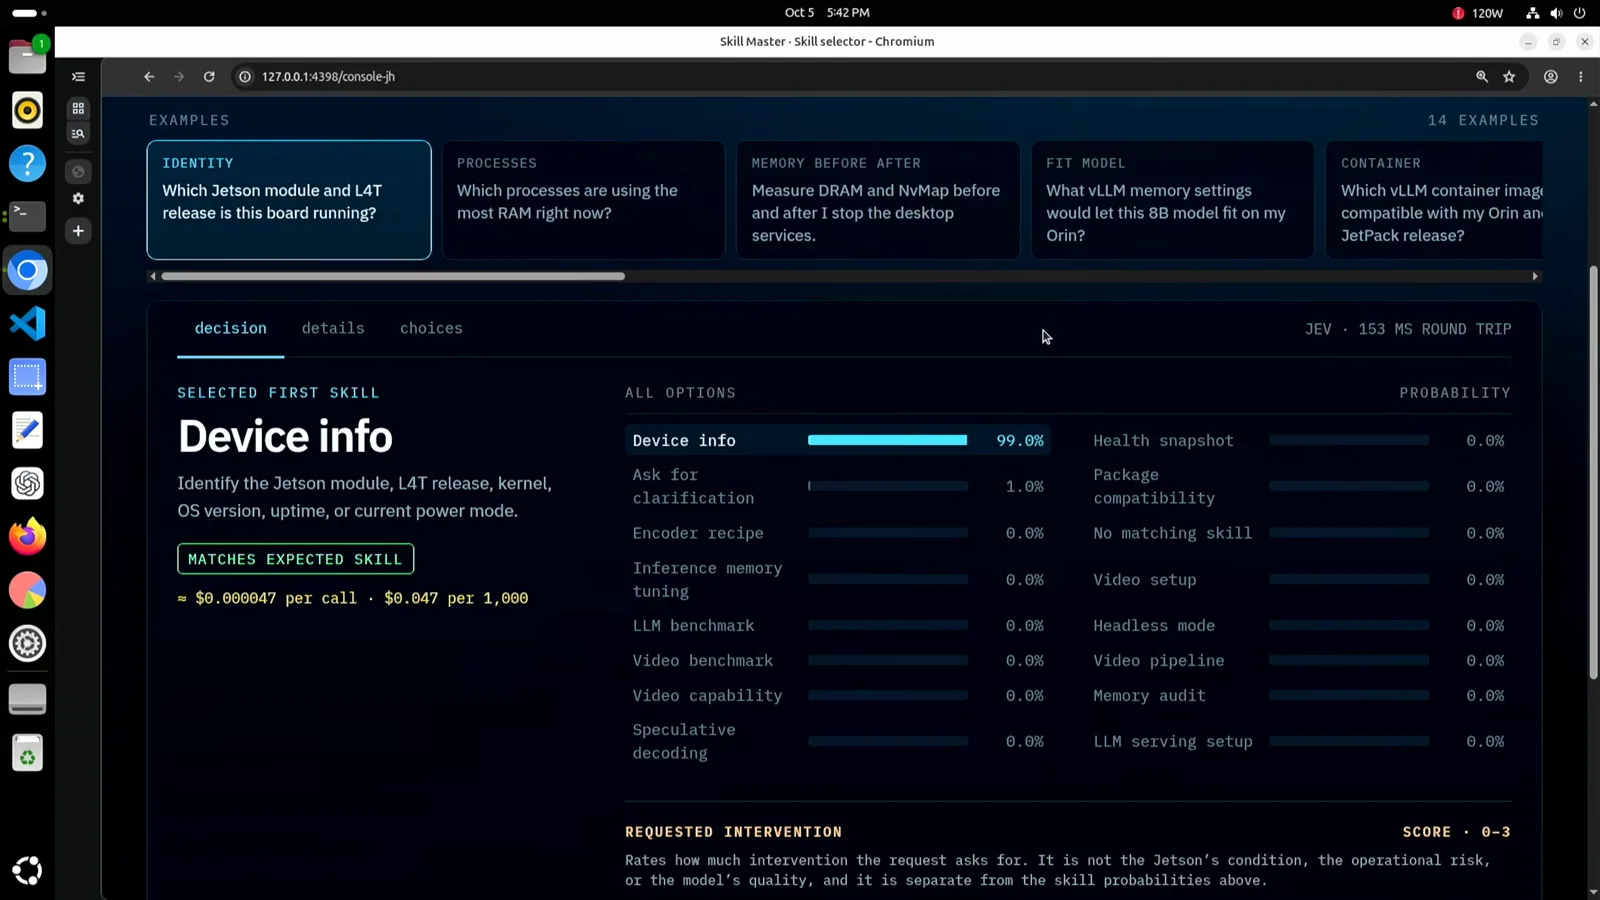
一个查询、一张概率表:Device info 99.0%、clarify 1.0%、其余全零——153 毫秒到手。跳转至 0:40 - 2
最高选项只有 45%:Jev 的置信度门槛
第二题故意上难度:「在我的 Jetson Thor 上为这个模型设置 vLLM 服务器」。Jev 还是选对了技能——LLM serving setup,「在一台兼容 Jetson 上立起 vLLM 或 SGLang 服务」——但只有 45.0%,身后还跟着 27.0% 的 Ask for clarification 和 15.0% 的 Package compatibility。Jim 的读数规则是整支视频最实用的带走物:置信度通常要过 60% 才值得信,重要问题要更高。同一响应里的另一问——干预评分——倒是一点不含糊:0–3 刻度上 2.99、置信度 99%、最可能等级 3「Change and verify」——安装、配置、启停或修改某物并核对结果。这一屏的请求头也正好是 JEV · 137 MS ROUND TRIP,就是他口播引用的那个数;往返耗时逐次有数毫秒级的浮动(本视频各屏在 130–178 毫秒之间)。
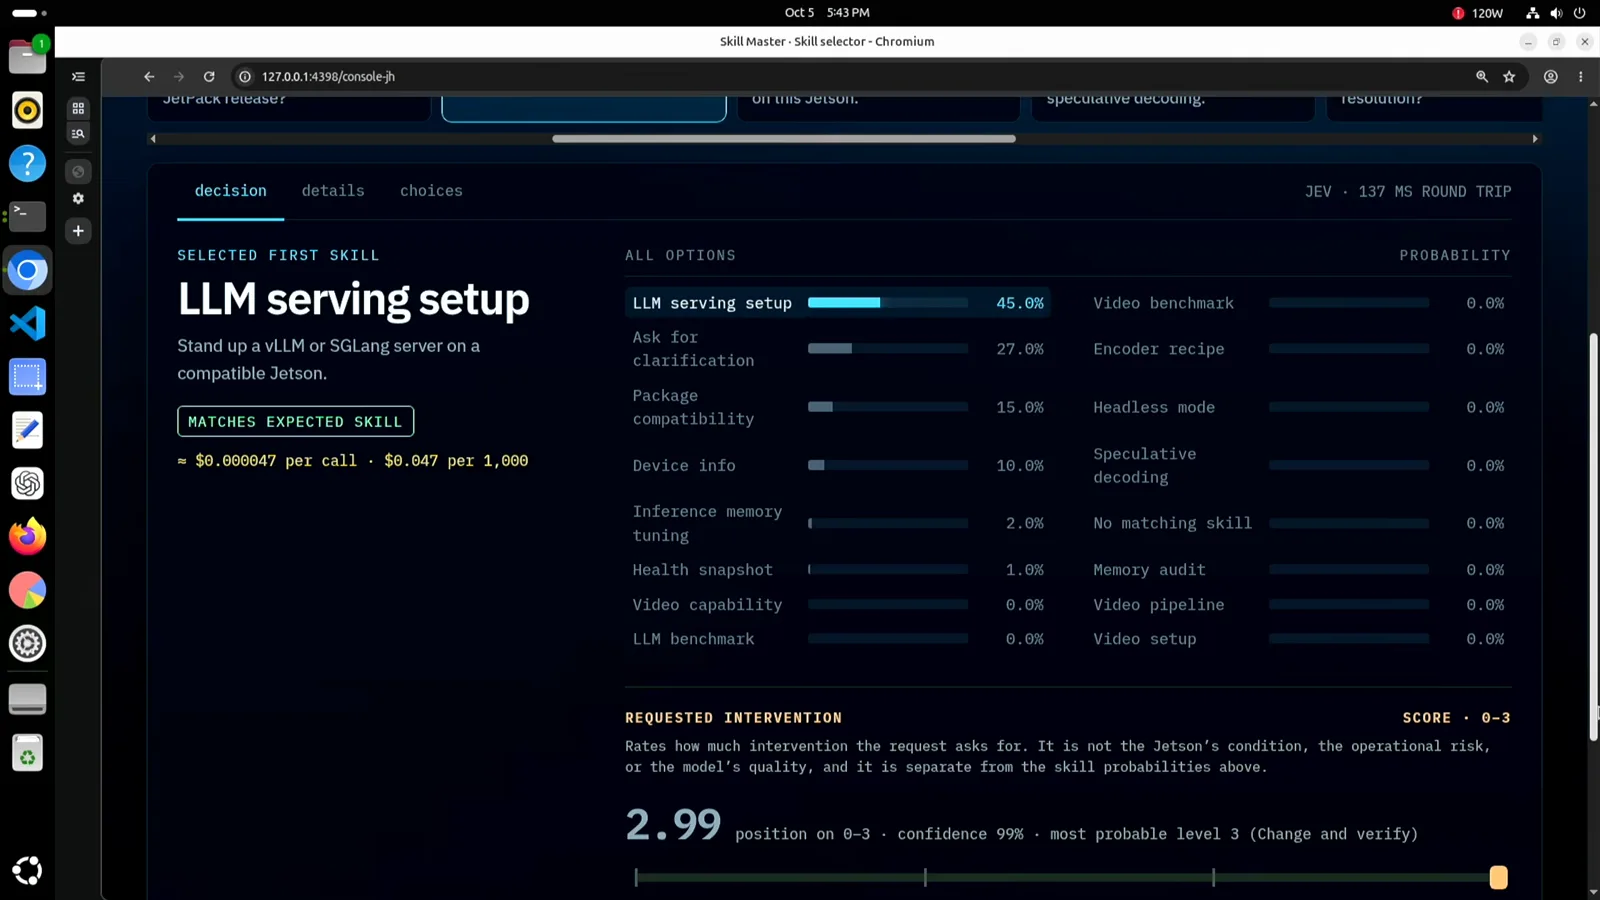
技能选对了、置信度不够:45.0% 低于 60% 信任线——但 2.99 的干预评分说明这题要动真格。跳转至 0:58 - 3
两条内置退路:要求澄清,或无匹配技能
一个必须永远选中的技能选择器是定时炸弹,所以请求格式内置了两条退路,演示把两条都踩了一遍。含糊 case——「Can you check it?」,零上下文——返回 Ask for clarification 100.0%:「任务缺细节,选不出技能」。它的干预评级是 Jim 点名的那处毛边:0–3 刻度上 0.11、置信 89%、最可能等级 0 Inspect——一个只读型标签,配这么含糊的请求,他也觉得有点怪。目录外 case 干净利落:「写一首关于机器恐龙的诗」返回 No matching skill 100.0%——「请求很清楚,但这个目录里没有合适的技能」——134 毫秒。这两条退路在记分集里对应 vague 和 outside 两题,也正是 summary 页能给全部十四题判对错的原因:正确地拒绝,也算对。
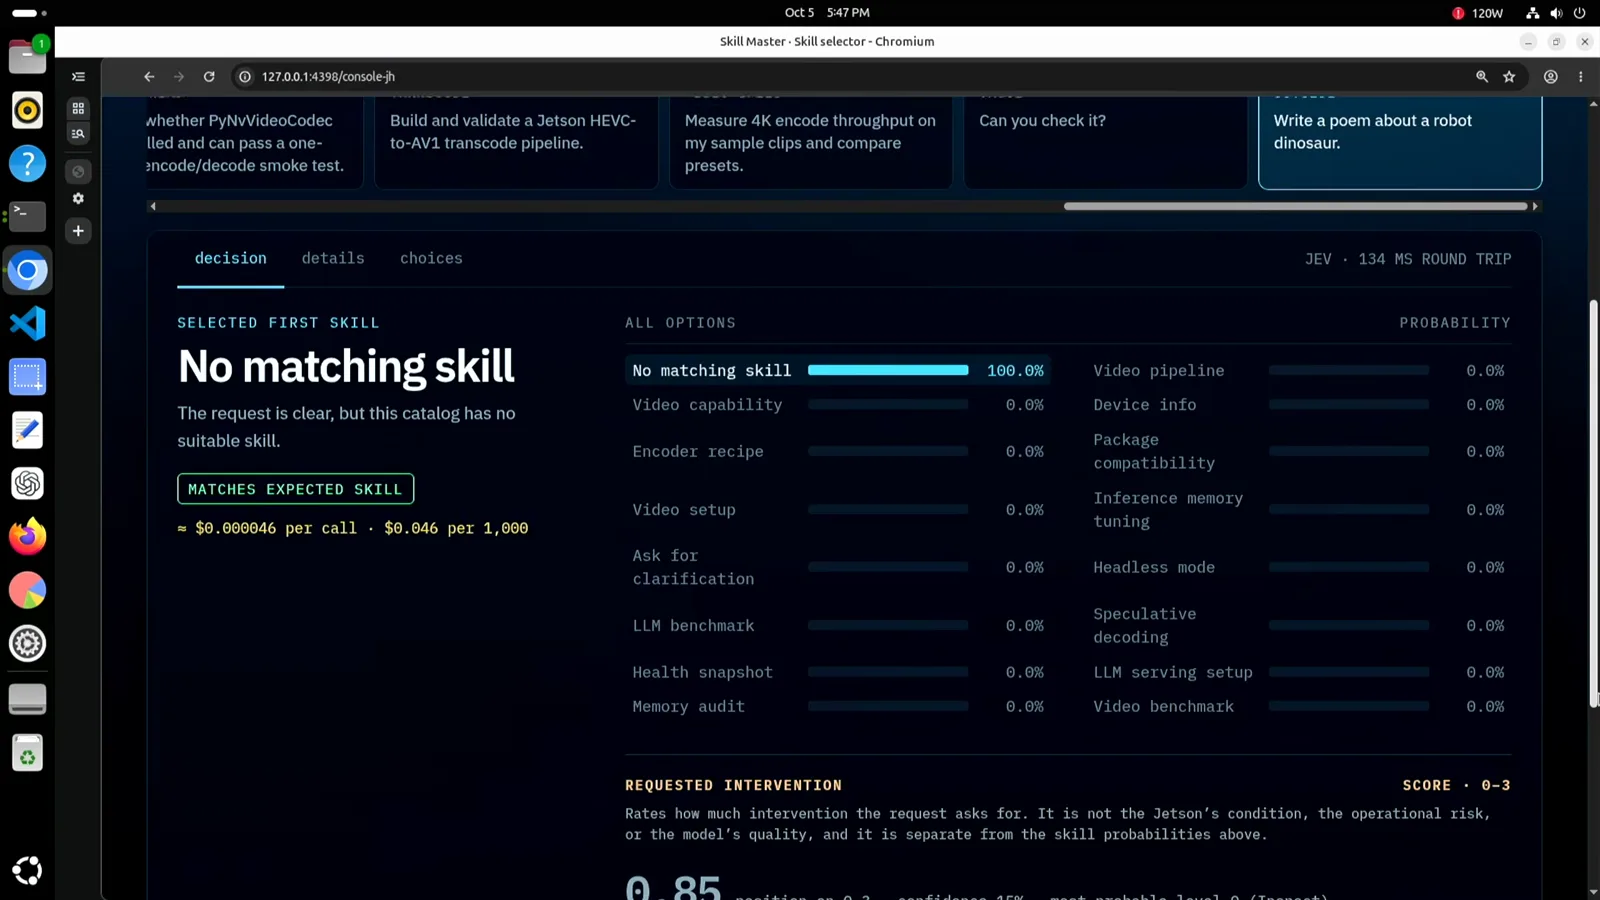
拒绝本身就是产品:清楚但目录外,拿 100.0% 的 No matching skill,而不是一个自信的错误答案。跳转至 1:40 - 4
请求内部:state、questions、criteria
应用的 details 视图把发给 Jev 的原始 JSON 摊开,这就是 TypeSafe SystemOne 的真实契约——请求头连端点都印着:api.typesafe.ai/v1/systemone。三个顶层键:model 填 jev-latest;state 原文承载用户查询(「Which Jetson module and L4T release is this board running?」);questions 是一张命名映射表,其中的 skill 条目是 choice 型问题。instructions 字段值得全文读一遍,因为你在前两步看到的退路全写在这里:选出一个应首先处理请求的可用技能;关键细节缺失就选 clarify;请求清楚但超出目录就选 no_matching_skill;多步请求只挑第一个有用的技能,不要推断测量、不要执行任何技能。然后是 criteria——把每个选项键映射到一行人话描述的对象:jetson-print-device-info 识别模块、L4T 版本、内核、OS 版本、运行时间或电源模式;jetson-diagnostic 检查 RAM、进程、GPU、散热、电源、存储与服务健康;jetson-memory-audit 测量 DRAM 与 NVMap 用量;jetson-inference-mem-tune 选伺服栈和内存设置;jetson-package 为 JetPack 版本挑容器、vLLM 镜像和包索引;jetson-llm-serve 立起 vLLM 或 SGLang。一共十六个选项——十四个技能加 clarify 与 no_matching_skill——全部在请求里定义,没有一个烙在模型里。
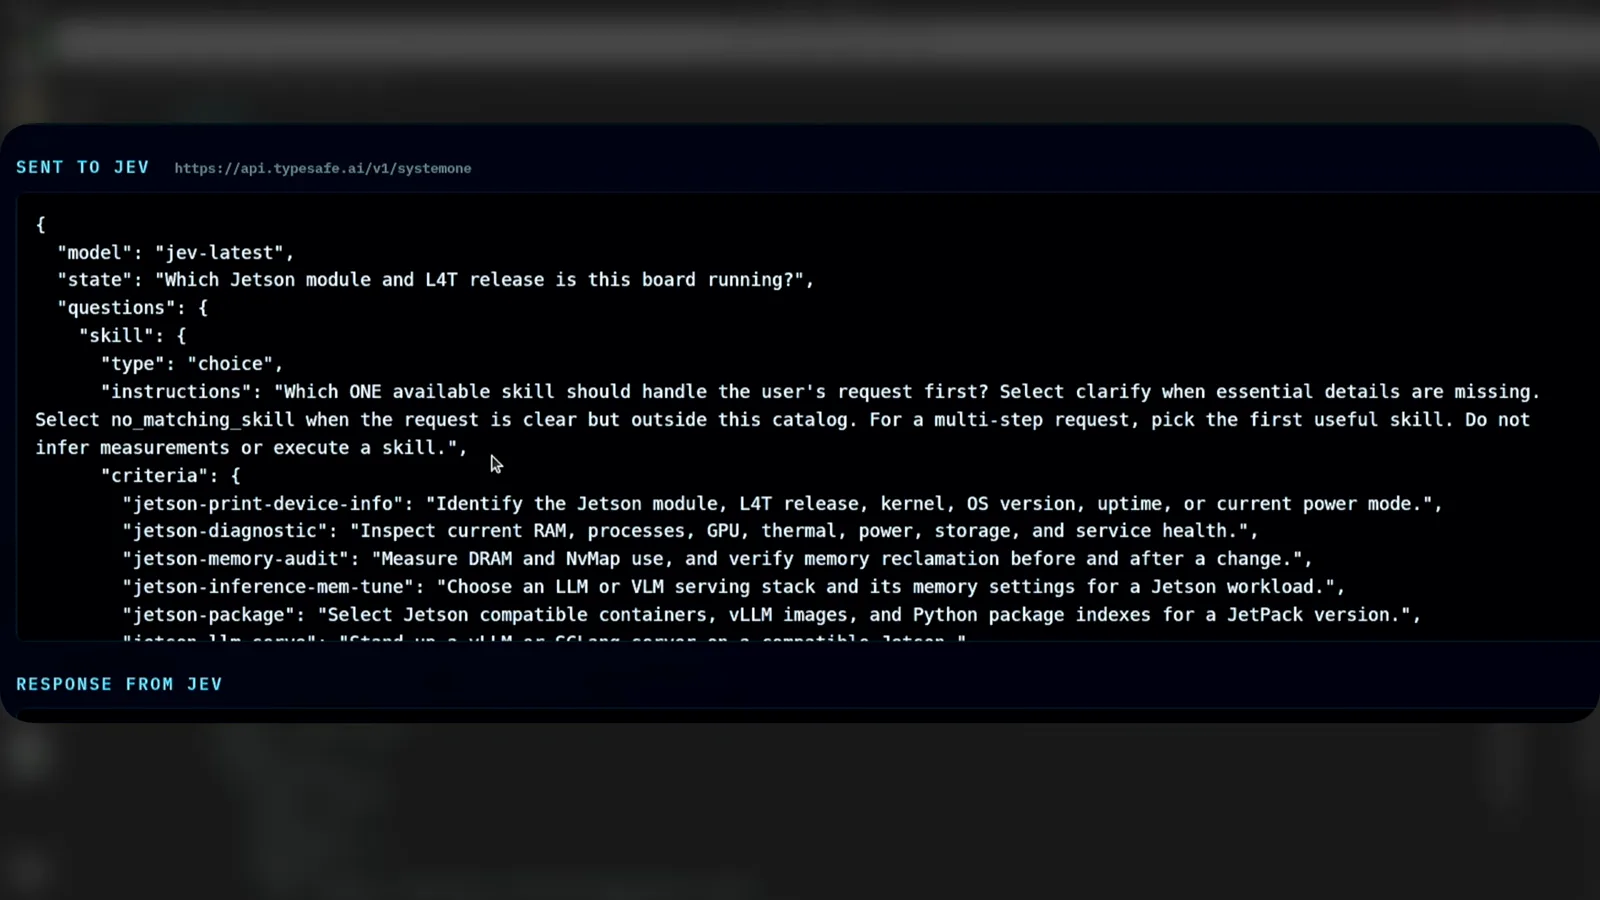
一屏装下整个契约:state 进,命名的 choice 问题出——十六个选项用人话描述,连拒绝路径都写明了。跳转至 2:22 - 5
响应内部:类型化答案、置信度、图例
响应侧同样一眼可读,这一帧正好抓到完整的 score 型答案:model jev-1.13.0,answers.intervention 里 type 为 score、score 0、confidence 1,配一张解释刻度的图例——0 Inspect:识别或读取现有设备状态;1 Measure:跑测试、审计或基准而不请求配置变更;2 Recommend:只建议设置、方案或计划而不落地;3 Change and verify:安装、配置、启停或修改某物并核对结果——外加逐级概率。choice 型答案是同一套形状:你命名的键下放选中的选项、一个置信度、以及横跨全部选项的完整概率表——决策面板上的概率条就是用它画的。全程没有一句散文;查询定义结构、响应填结构,调用代码读键读数就往下走。决策模型能直接插进 agent 循环而不用加解析层,原因全在这里。
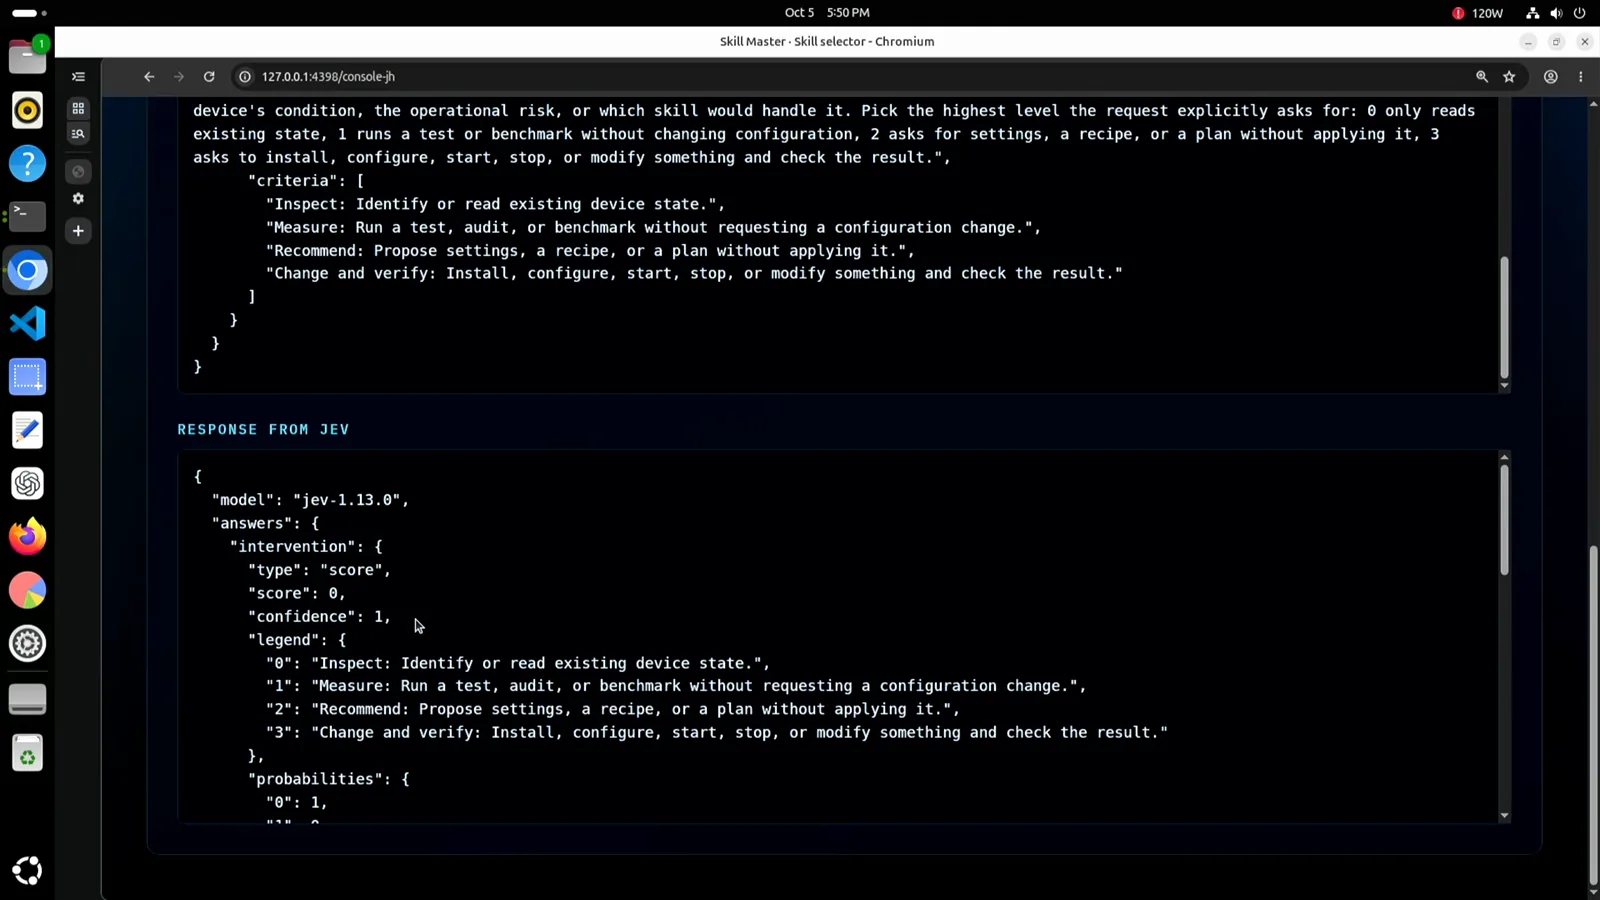
类型进、类型出:带图例和逐级概率的 score 答案——整份载荷里没有一句生成的话。跳转至 2:52 - 6
同一种表示,三种回答方式
Jim 的图解卡是本站核心品类最清楚的一屏分类学。所有文本模型的开头一模一样:prompt 走过编码阶段(你会听到它叫 pre-fill)变成上下文表示。输出阶段才是三个物种分道的地方。分类器把表示变成标签——但标签集在训练时就焊死了,加一个类别意味着新标注数据和一轮重训。LLM 是写:自由文本、一 token 一趟、每个 token 依赖前一个,这正是生成慢的原因——而且 agent 系统事后还得解析那串文字。决策模型走第三条路:问题在运行时才问,答案类型化回来——noul 是否题、你命名选项的 choice、你定义刻度的 score——单次前向完成,输入侧大量并行。他的图注就是论点:灵活、类型化、快——而同一种表示正是一个训练好的模型能横跨三种输出风格的原因。
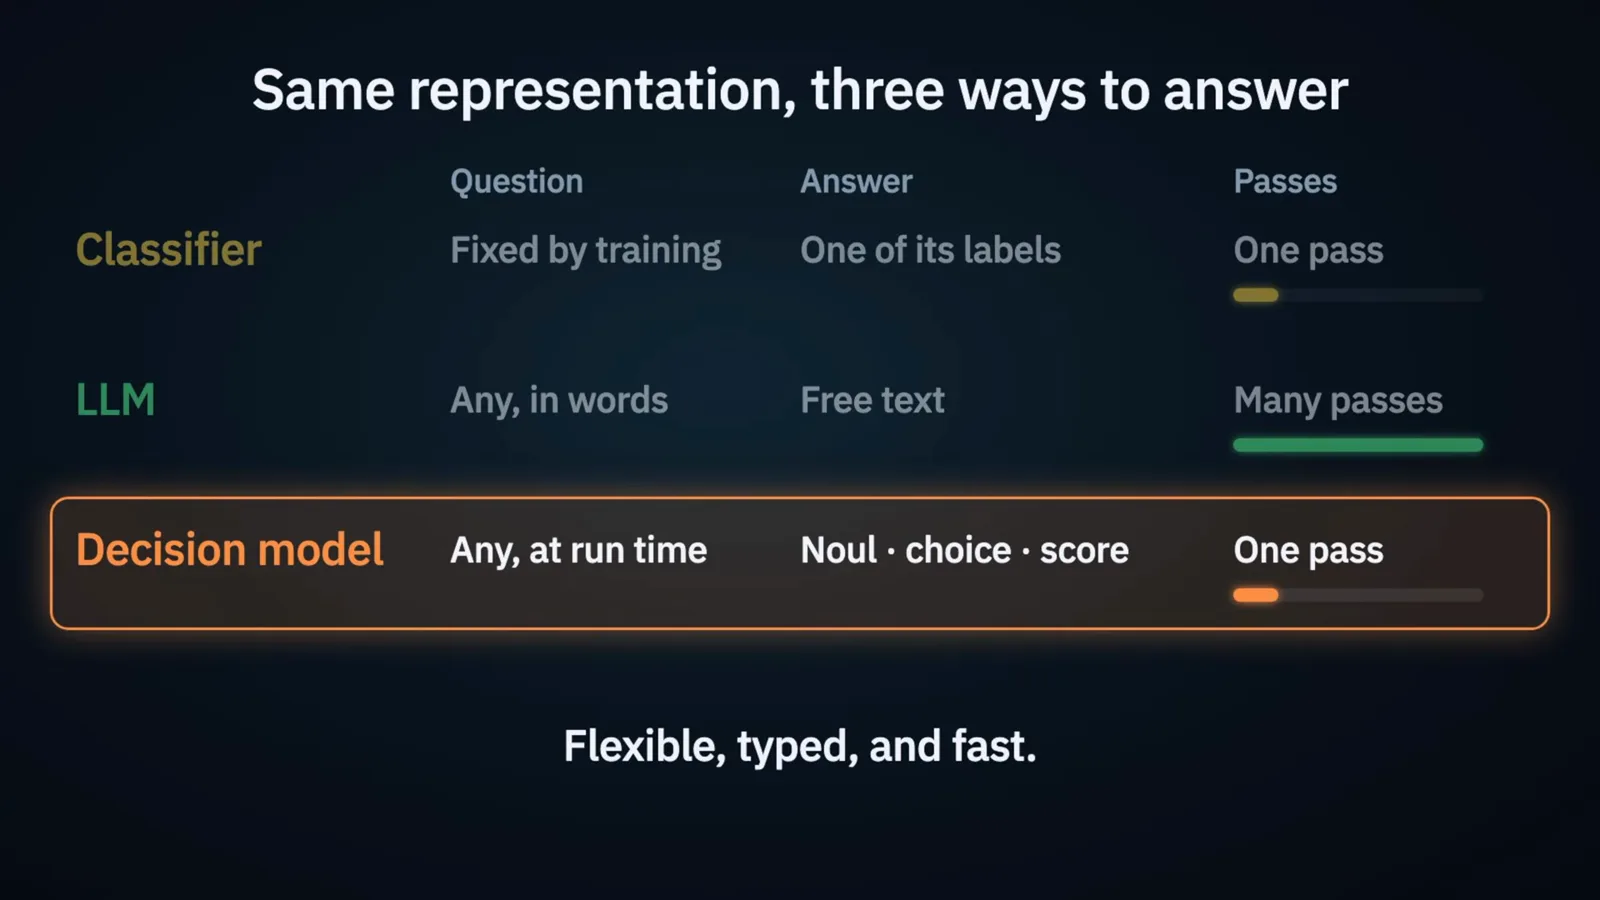
一次编码、三种输出:训练定死的标签、逐 token 的散文、或单次通过的类型化答案。跳转至 5:50 - 7
本地阵容:Strands 2B、Laya、d1-3B 对上 Jetson 内存
本地回合,三只开源权重挑战者加入托管 Jev:AWS Strands Decider 2B(「应该不用多介绍」)、Laya,以及 Liquid AI 的 d1-3B——实验室出自 MIT CSAIL 一脉、为快速单遍决策而生。选型标准很直接:小到能上 Jetson 级硬件,因为那里内存才是约束。示意图卡把话说死:在 Orin Nano 上,Strands 与 d1-3B 填满大部分内存;在更大的 Orin 和 Jetson AGX Thor 上则装得从容(画的是方块,明标非等比)。Laya 是全场最小的模型,哪里都塞得下,但视频也坦白不会给它太多镜头:实测成绩不行。规划自己的测试台时,这份坦白值得带走——模型尺寸、模块档位、预期驻留,三者得先对齐,再谈第一条查询。
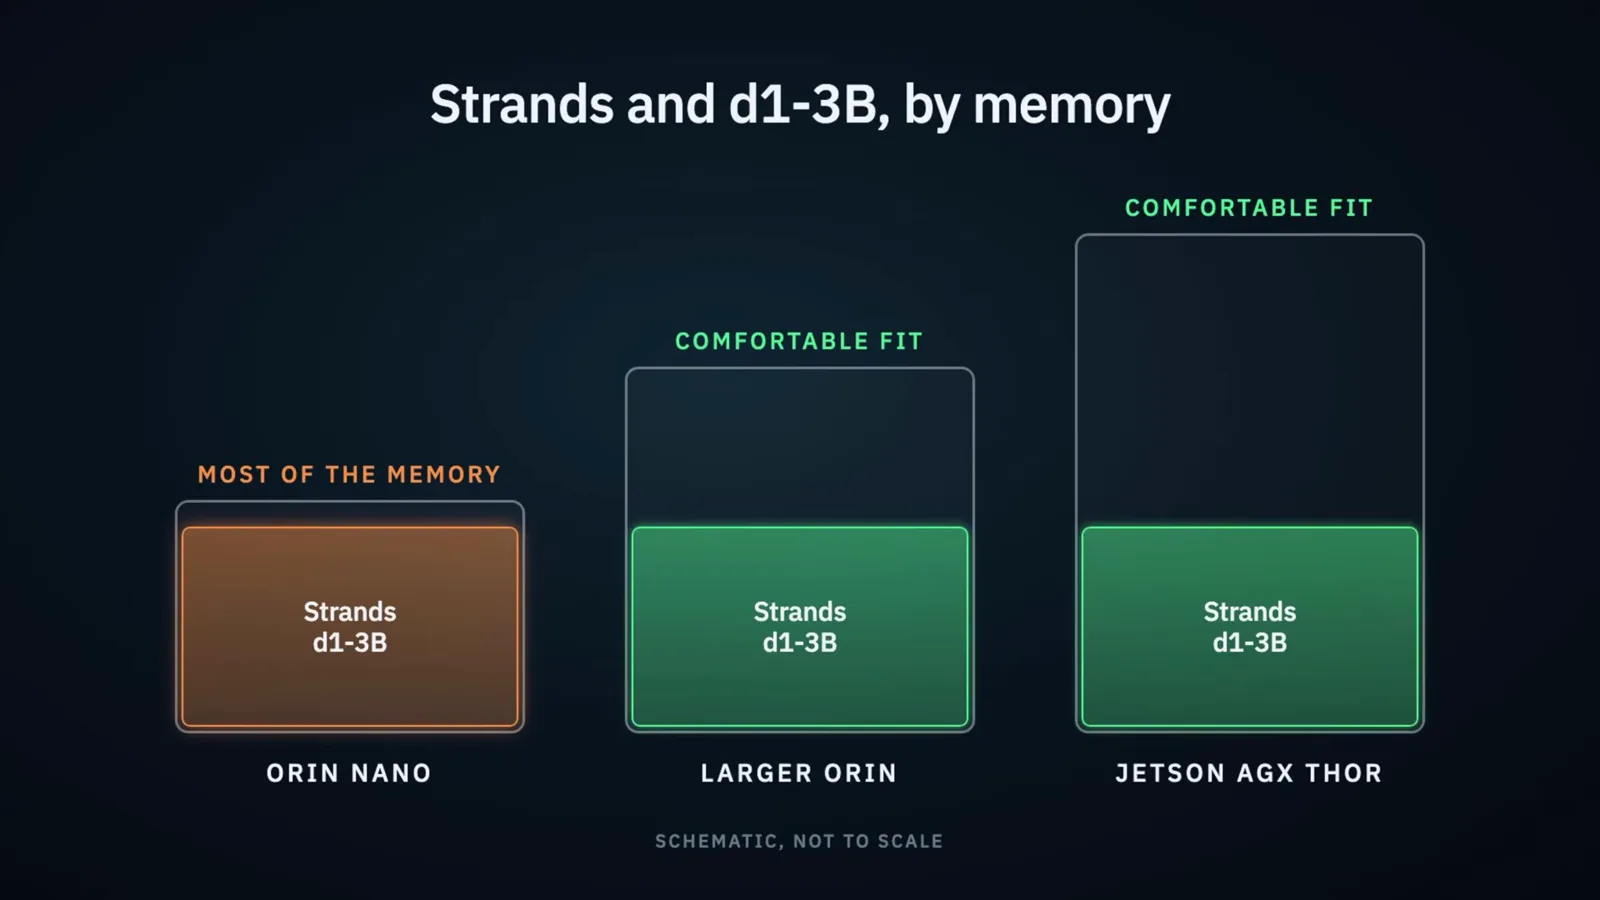
硬件问题一张卡讲完:Orin Nano 紧张,更大的 Orin 与 AGX Thor 从容——示意图、非等比。跳转至 7:32 - 8
十四题记分卡:Jev 14/14、平均 150 毫秒
summary 页按概率给每个模型的全部十四题打字母等级。Jev:14/14 全对、平均每题 150 毫秒、平均 1109 token 进 222 出——12 个 A、1 个 B(codec support)、1 个 C,而那个 C 不偏不倚落在 serve 题,正是那次 45% 低置信答案的位置。Strands Decider 2B 同样 14/14,但平均 353 毫秒、794 进 354 出——10 A、4 B。Laya 拿下 8/14,全场最弱。d1-3B 收官 14/14,9 A、4 B、1 C。分题细节解释了字母的来路:识别题上 Jev 答到 99%,Strands 选对却只有不安的 61%、干预评级也低,Laya 直接选错技能,d1-3B 落在 Strands 与 Jev 之间且干预判断正确。维护题把顺序翻了过来——d1-3B 打出四个模型的最高概率,Strands 远超 Jev,连 Laya 都比 Jev 高。同样十四道题,四份完全不同的置信度画像。
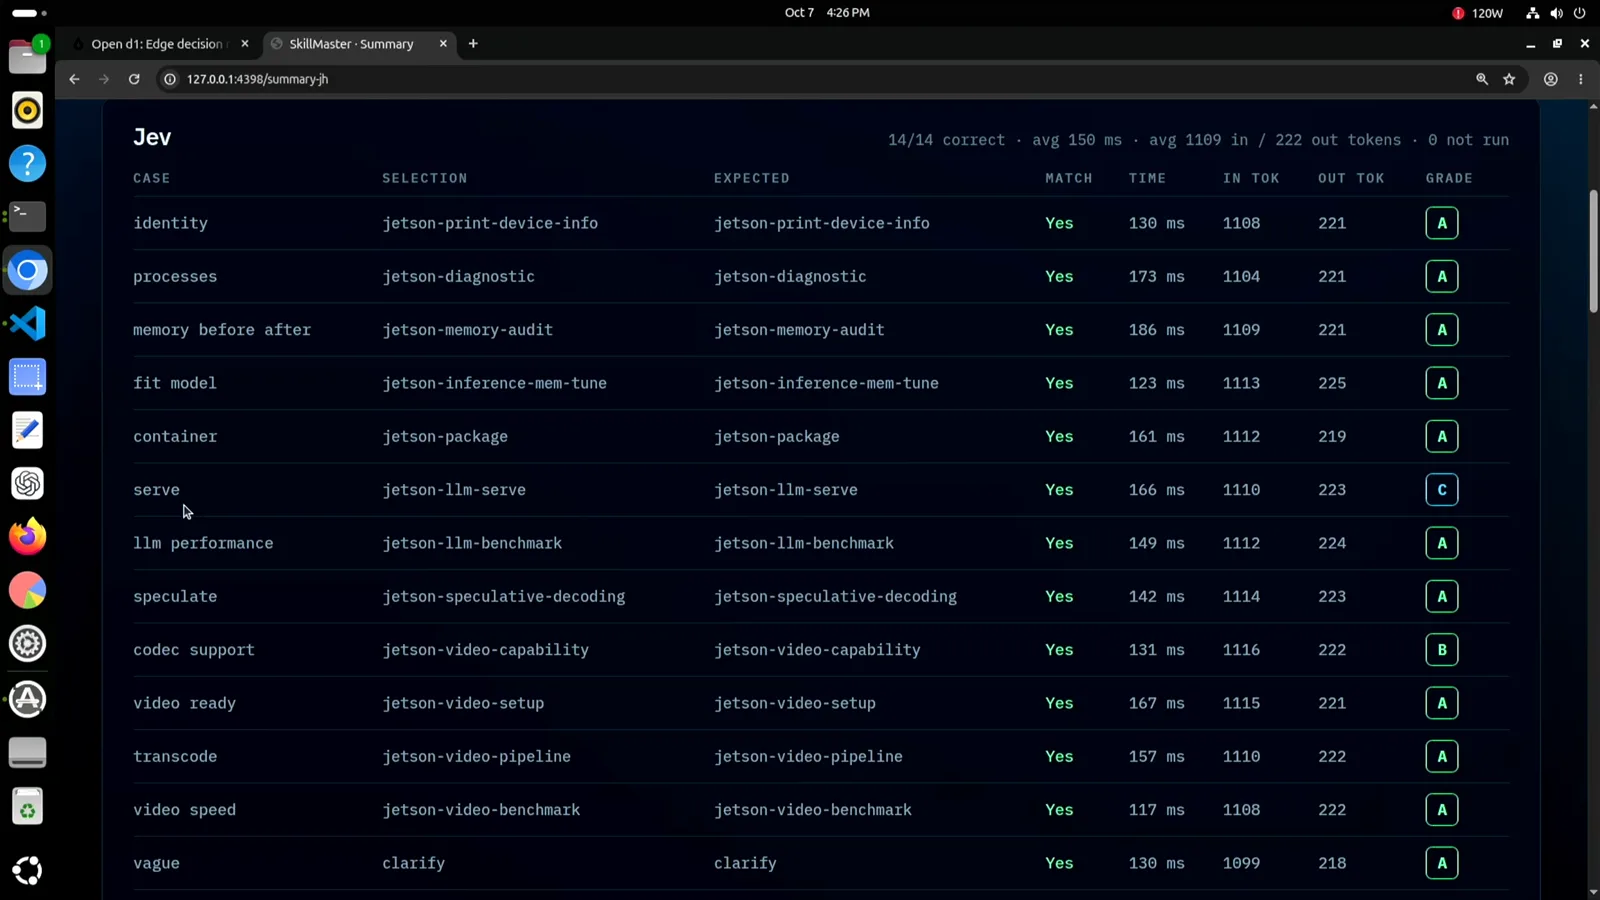
满分通关、诚实评级:14/14、平均 150 毫秒——唯一的 C 正落在只拿了 45% 的 serve 题上。跳转至 8:38 - 9
延迟账单:Thor 直跑、FastAPI 包装、与 Jev 同桌
速度是这条视频立住的地方,一共三个数。先立基线:同一套选题测试丢给 Claude,平均约 2.5 秒选一个技能;Jev 约 135 毫秒——18 倍差距,让「比常规 LLM 快 10–20 倍」的宣传在这场测试里完全站住。再看本地:直跑 Jetson AGX Thor,这些小模型典型 30–50 毫秒出决策。然后是那道坎——为了对比,Jim 把它们包进一台模拟 TypeSafe Jev API 的 FastAPI 服务,这层包装加了 75–100 毫秒延迟。他的结论是整页最该记住的一句话:基准数字其实低估了本地模型;如果延迟真的要紧,绕过服务器直连模型还能再快一倍。实战里他预期这些本地小模型至少不慢于托管 Jev——架构卡画的就是这笔账:蓝色的 Thor 直跑条、橙色的 FastAPI 税、右边 Jev 的 135 毫秒参照线。
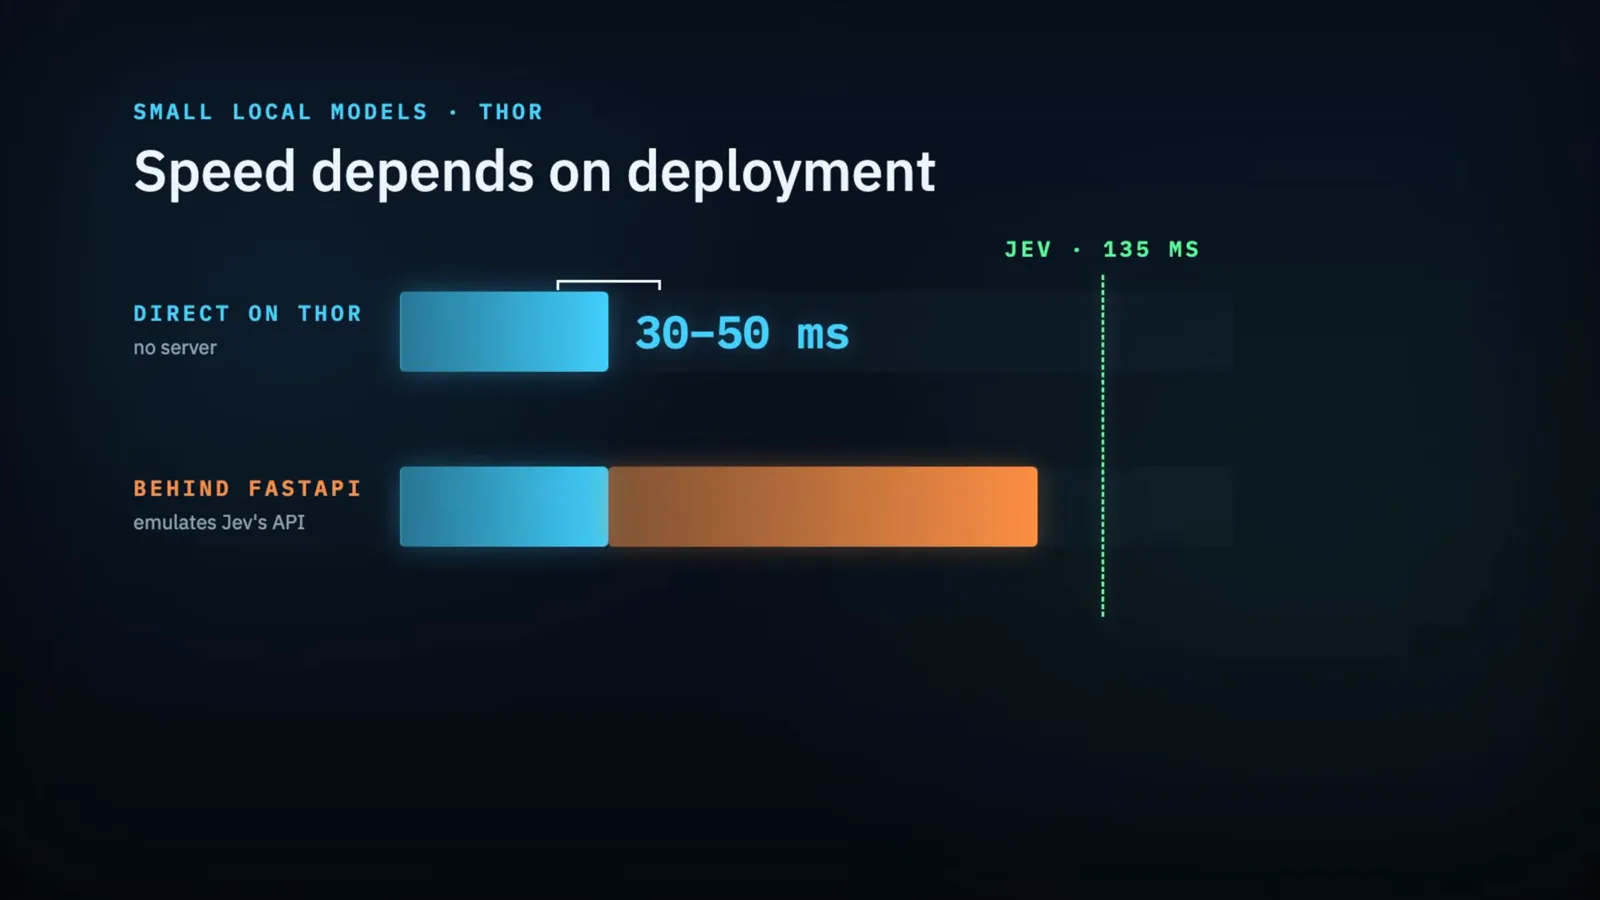
Thor 裸跑 30–50 毫秒,套上 FastAPI 加 75–100 毫秒,对面是 Jev 的 135 毫秒——部署方式本身就是基准。跳转至 9:44 - 10
JevBench:86.6 对 75.3 对 72.3——以及它们在哪里拉开
基准卡把三个模型放上同一张公开榜:Jev 1.13.0 拿 86.6%(200/231)、d1-3B 75.3%(174/231)、Strands V19 72.3%(167/231)。Jim 的读法比排名本身有用:简单题几乎三方持平;标准题 Jev 小幅领先;难题上它决定性地甩开。他也把镜头拉远——决策模型如今已过百个、榜满天飞,值得按自己的标准做一番调研。然后是对建设者真正要紧的反转:把比较收敛到这些模型真正被雇用的任务类型——路由、策略决策、工具选择、复杂路由——三家本质等价,而且本地模型握着一张托管模型没有的牌:可以按你自己的工作负载微调。权重不同、活一样、总成本不同——所以上一步那张延迟账单,比这张排行榜更能决定你的选型。
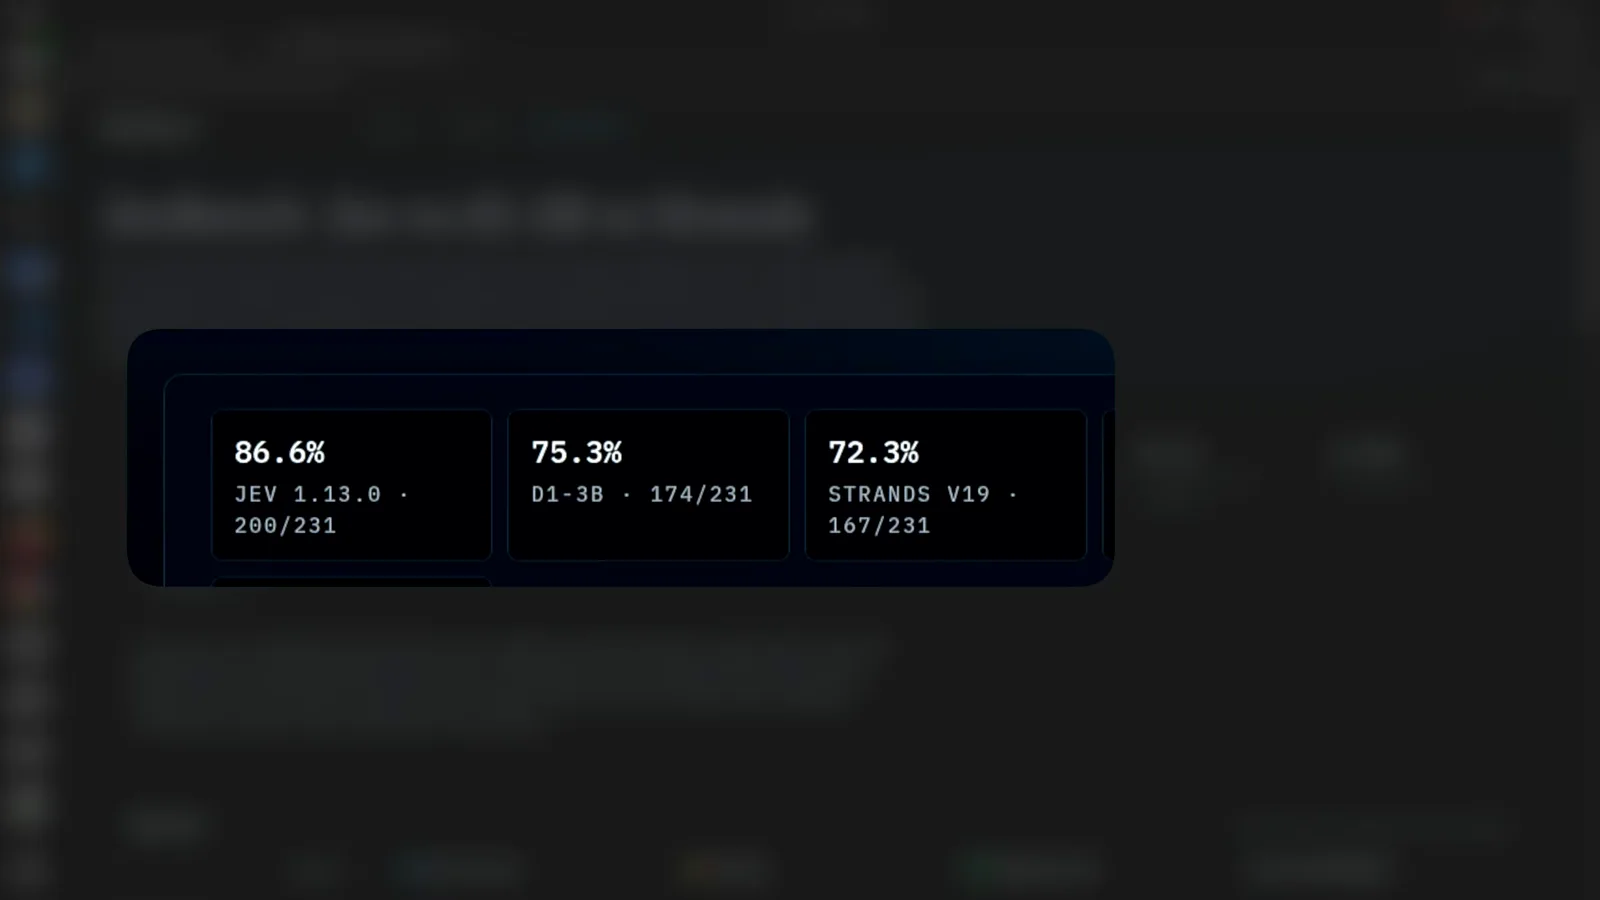
一块榜、三行数:86.6 / 75.3 / 72.3——题目一难才见分晓。跳转至 10:22 - 11
决策上下文——灵活,但不免费
收尾两张卡是整支视频对品类的论证。「My board keeps running out of memory」的决策上下文不是一个问题,而是一张应用定义的表:一道 noul——这个请求是否需要健康快照技能,true 或 false;一道 choice——哪个技能该第一个上手,十四个选项里画出 jetson-diagnostic、jetson-memory-audit 和 clarify;一道 score——intervention 按 0 到 3 级,这个请求要动多大的手术。clarify 就列在 choice 的选项里,这是最安静也最妙的一笔:「退路本身也是一个类别。」因为表长在应用里,新决策要的只是新上下文,不是一轮重训——不像分类器,类别在训练时就冻死了——而开源权重的本地模型还能按工作负载再微调。但最后一张卡把价格亮出来:instructions 由应用写、类别清单由应用列、组合测试由应用做——时间一长,就是要维护的应用代码。Jim 的收尾句是以上一切诚实总结:模型可以更简单、快得多;系统可未必。
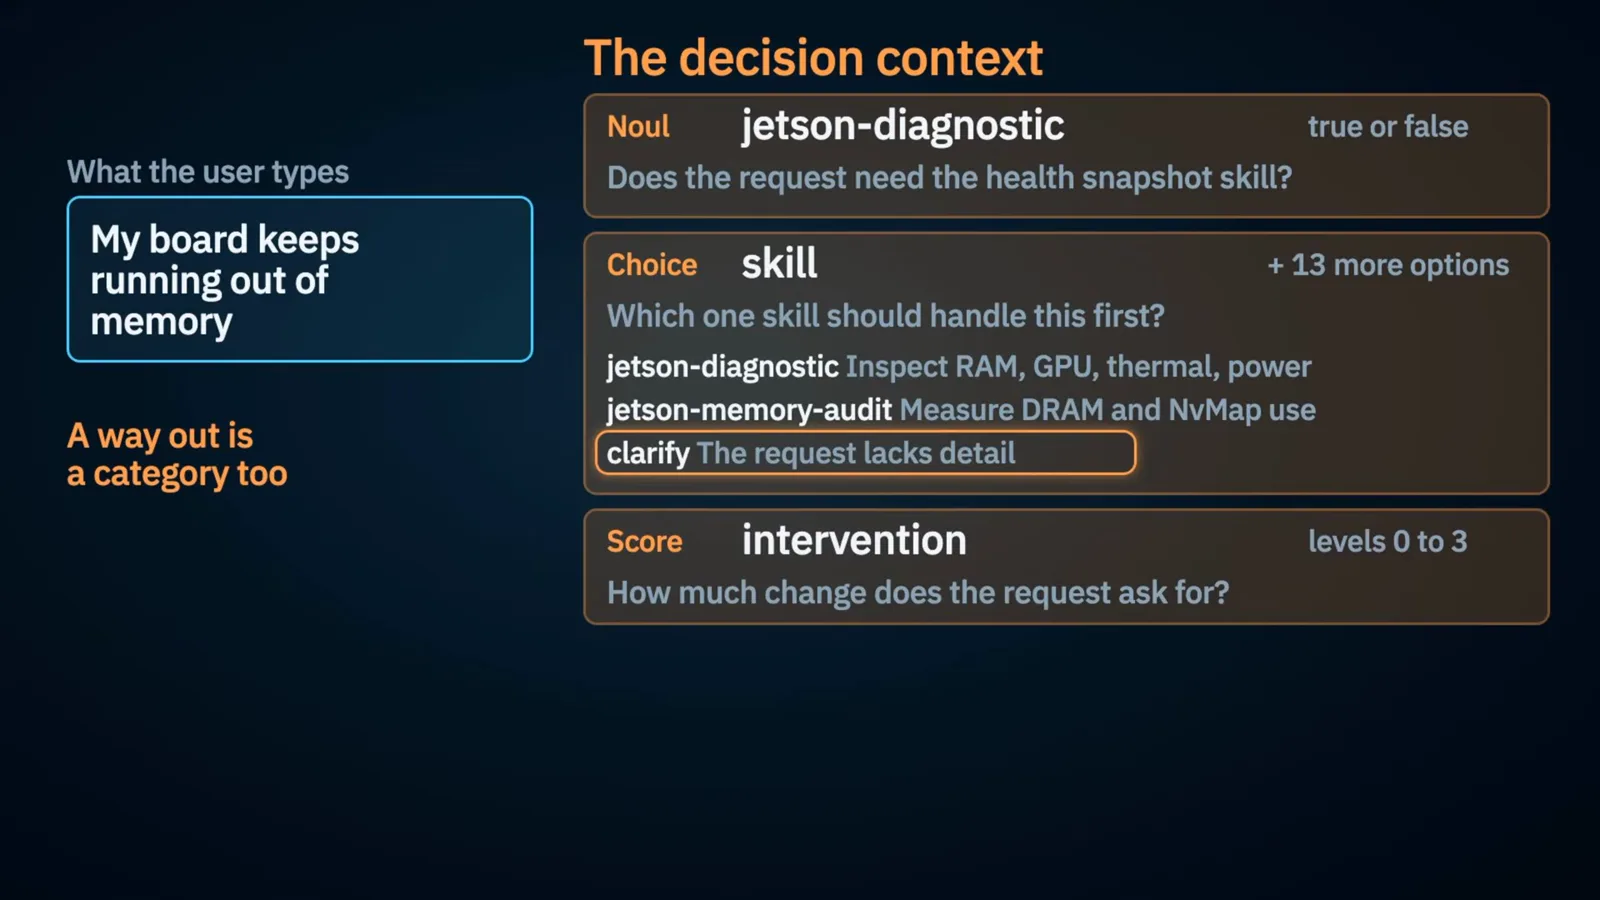
决策表由应用来写——noul、带 clarify 的 choice、0–3 的 score——维护也归应用。跳转至 11:30
常见问题(FAQ)
决策模型真的能跑在 Jetson 上吗?
能——这正是这支视频的存在意义。三只小尺寸开源决策模型(AWS Strands Decider 2B、Laya、Liquid AI d1-3B)都能在 Jetson Orin Nano 上跑,只是 Strands 和 d1-3B 在 Nano 上会吃掉大部分内存;换更大的 Orin 或 Jetson AGX Thor 就从容了。直跑 Thor 时单次决策约 30–50 毫秒。托管 Jev 在同一张桌面上答同样的选题查询约 135 毫秒往返(屏上各次调用在 130–178 毫秒之间),界面标价约每次调用 0.000047 美元。唯一的硬门槛是内存:跑分之前,先把模型和模块档位对齐。
Jetson 上到底谁赢了——Jev、Strands、d1-3B 还是 Laya?
取决于你问哪道题,视频把四种结果都摆了出来。十四题技能测试:Jev 14/14(12A、1B、1C)、平均 150 毫秒;Strands 14/14(10A、4B)、平均 353 毫秒;d1-3B 14/14(9A、4B、1C);Laya 8/14。识别题上 Jev 的 99% 碾压 Strands 的 61%,Laya 直接选错;维护题顺序反转——d1-3B 打出四模型最高概率,Strands 远超 Jev。JevBench 上:Jev 86.6%(200/231)、d1-3B 75.3%(174/231)、Strands 72.3%(167/231)。但收敛到常见工作负载——路由、策略决策、工具选择、复杂路由——三家本质等价,真正决定选型的往往是延迟、内存和能不能微调。
做技能选择时,决策模型比 LLM 快多少?
这场测试里约 18 倍。同样的查询,Claude 平均约 2.5 秒选出正确技能;Jev 约 135 毫秒——口播原话:「比常规 LLM 快 10–20 倍」的说法在这里完全成立。本地模型还能再进一步:直跑 Jetson AGX Thor 只要 30–50 毫秒。有个细节值得记住:对比时它们被包在一台模拟 TypeSafe Jev API 的 FastAPI 服务里,这层包装加了 75–100 毫秒——所以公开基准数字其实低估了本地模型,绕过服务器直连还能再快约一倍。
Skill Master 是什么?
jetsonhacks.com 的 Jim 为这次对比写的测试应用:一个本地 Web 控制台,把同一个查询发给多个模型、用同一套 UI 渲染每个答案——全部选项的概率条、0–3 刻度的干预评分(Inspect / Measure / Recommend / Change and verify)、逐题耗时,以及给十四道例题(identity、processes、memory before/after、fit model、container、serve、LLM performance、speculate、codec support、video ready、transcode、video speed、vague、outside)打字母等级的 summary 页。托管 Jev 还会显示每次调用成本(约 0.000047 美元)。模型标签页出现过 Jev remote、CLM-8B local、Strands Decider 2B local、Laya local、d1-3B local——不过真正参测的只有 Jev 加三只开源模型。
Jev 的请求和响应在线上到底长什么样?
应用向 api.typesafe.ai/v1/systemone 发三个顶层键:model(jev-latest)、state(用户查询原文)、questions——一张命名映射表,每个条目是一道类型化问题。这里的 skill 题是 choice 型:instructions 写明只选一个技能、关键细节缺失选 clarify、请求清楚但超出目录选 no_matching_skill;criteria 对象给全部十六个选项各配一行人话描述。响应以 {"model": "jev-1.13.0", "answers": {...}} 返回:choice 答案给选中选项、置信度和完整概率表;score 答案给 score、confidence、解释每级含义的 legend(0 Inspect、1 Measure、2 Recommend、3 Change and verify)和逐级概率。全部是带键的 JSON——没有散文要解析,这正是它能直接插进 agent 循环的原因。
本地决策模型该直连,还是包一层服务?
两种都要,看目标。视频里的数字:Thor 直跑 30–50 毫秒;包进模拟 TypeSafe Jev API 的 FastAPI 服务要多付 75–100 毫秒——直连快约一倍,而且按包装路径测出来的基准数字低估了本地模型。但服务这层形状的价值在于可替换:你的 agent 代码无论后面是托管还是本地,说的都是同一套 state 加 questions 的契约,换模型不用动调用方。视频收尾的提醒对架构同样成立——灵活,但不免费。谁定义决策表(instructions、类别清单、clarify 与 no_matching_skill 退路、组合测试),谁就担维护,而这件事无论哪条路都落在你的应用里。延迟就是产品就先直连;要契约就包装。
相关推荐
Liquid d1 指南
d1-3B 本尊的深度拆解——架构、noul/choice/score 契约,以及这台在维护题上夺冠的模型在 MacBook Air M5 上的实测。
阅读Strands Decider 指南
AWS Strands Decider 的独立实测轴——这只在本页追平 Jev 14/14、却只跑了三分之一速度的 2B 模型,装起来跑起来什么样。
阅读Jev 本地运行指南
自托管 Jev 的端到端路线——配合本页的 Jetson 档位,补上本地部署地图的边缘一角。
阅读Jev 对比 Ollama 指南
到底要不要本地化:托管校准对本地权重——本页延迟账单所指向的那条决策轴。
阅读Ollaya 指南
走 Ollama 系运行器的决策模型——本页里被包进 FastAPI 的那套玩法,在桌面端的兄弟版。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
- Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
- Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
- Jev 接入 Codex 实操:typesafe-ai/skills 安装与 Gmail 30 封邮件分诊
- Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
- 自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
- CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
- 用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门
- Ollama 决策模型实测:tev1 + nimble 跑在 8GB 显卡上
- Jev 生产环境护栏:五步接入实战手册
- Pi Agent 防跑偏插件实战:让 Jev 出概率,让代码做决定
- Tev1 用例实测:50 个任务看尽本地决策模型的能力边界
- Jev 实测:官方宣称与独立复测之间的距离
- Jev 工单分类实战:after-insert hook 与计算字段两种接法
- OpenJev RLCD 实操:开源校准决策模型本地部署全指南
- Clef-Flash vs Jev 实测:把 Cloudflare 决策模型装进 Ollama(Q4_K_M)
- Clef-Flash 实操教程:在 Ubuntu 上从零安装并本地运行 Cloudflare 9B 多模态决策模型
- CLM-8B 架构深潜:44 毫秒打分 1,024 个候选的对比决策模型(比 Jev 快 13 倍)
- Nox 4B 实测教程:本地跑通 Decision 2.0 决策模型,四道真实考题与一次诚实的失败
- Julia-1 实操教程:纯 Python 装上开源 Jev 替代品,10 条客服消息实测 9 比 2
- OpenJev 0.8B CPU 实战:用工单收件箱校准 NLI 路由阈值
- Jev n8n 集成实战:JevGate 社区节点分步攻略(附纯 HTTP 备选路线)
- NanoJev 实操教程:本地部署 0.6B 开源 Jev 复刻,亲眼看它以 47ms 跑迷宫、按概率做路由
- PPLX Decider 实操教程:Perplexity 开源 27B 决策模型、Decisions API 与 12 张工单的分诊实测
- AutoTrust JEV-27B 本地实测:四臂对照、72 道 held-out 题,和一个 0.969 高分的错误答案
- Clef 27B 本地实战:Cloudflare 多模态决策模型一次读懂图片、视频和乌兹别克语报纸
- Ollaya 实操指南:装好「决策模型界的 Ollama」,看清每一个厂商口径数字,再亲手补上它留白的 CPU 实测
- Strands Decider 2B 实测:8GB 笔记本本地安装 AWS Strands 系决策模型,把失败段也留在这页里
- Liquid AI Open d1 本地实测:d1-3B 与 d1-omni-600M 跑进 MacBook Air M5
- 图像决策模型实战 RPA:Imajev-4B 与 Jev-Omni 无 OCR 直读 W-8BEN 税表,90% 置信阈值以下转人工审核
- GLiNER2.5-Decide (340M) 对比 Jev (4B):决策模型到底谁赢?逐帧核对选型指南
- 微软 Decision-1 实测:146 道独立测试、93% 均分、高置信时 124/125——每个数字逐帧核过
- Jev 接入 Azure AI Foundry 实战:OpenAPI 工具、分诊指令与首跑失败复盘