
Guides / 视频转图文攻略
OpenJev 0.8B CPU 实战:用工单收件箱校准 NLI 路由阈值
在 AlexWortega 独立发布的 OpenJev 0.8B NLI 检查点上搭一个真实工单收件箱:premise×hypothesis 三分数直读、两版路由规则的权衡推演、4+12 用例的诚实评测口径——全程 CPU、下载后离线。
速览结论
这支视频的主角是一个真实应用——工单收件箱——而不是模型评测:它跑在 AlexWortega 独立发布的 OpenJev 0.8B 检查点上,NLI 交叉熵训练,并全程明确与 TypeSafe 官方 Jev 划清界限(「同名不代表官方模型的性能声明可以照搬」)。机制:每张工单是 premise,对 refund、billing、login、broken functionality 四条部门假设分别输出 contradiction/entailment/neutral 三个分数,适配器直读分数、不让模型生成任何回复。退款 demo 蕴含约 0.995;路由规则 v1 取最大蕴含,≥0.60 且领先 0.10,否则转 review。真正诚实的是校准段:一张同时提到登录故障和重复扣款的工单打出 billing 0.97、login 0.78——v1 选了 billing,把第二个真实问题悄悄丢掉——于是 v2 只加一条「多命题过阈即转 review」,同一张工单变成 Human Review。代价也当面结清:一句干净的退款请求(refund 0.9883、billing 0.7277)本来路由正确,v2 把它也推迟进复核队列。三例 miss 全部在 JSON 层归因——过期密码重置工单上 bug(0.687)因类目重叠胜过 login(0.491)、发票副本请求被写得过窄的 billing 假设漏接、表扬消息没有类目可去——冻结测试集交出 2/4 校准、7/12 留出的成绩,视频把它定义为「模型 + 类目定义 + 路由逻辑」的整体计数,不是独立模型准确率。体积与延迟:权重 1.71GB、峰值内存 3.20GB、CPU float32、每请求中位 5.63 秒,下载后完全离线。建议的落地形态是「建议队列 + 人工拍板」——本地推理消掉的是一次数据传输,不是全部风险。
分步图文攻略
- 1
实验本体:一个真实收件箱应用,和它的边界
视频在跑实验之前先给实验画了围栏。应用是一个围绕 AlexWortega 独立 OpenJev 0.8B 检查点搭建的收件箱,模型加载在本地 Mac 上——没有任何托管模型应答请求。工单是自写的合成工单,不含客户数据。卡片把这件事从两侧说清:实验是什么(独立模型、自写工单、本地 CPU),以及实验不是什么(不是官方 TypeSafe Jev、无客户数据、无云端推理)。右面这一栏框住了本页之后的每一个数字:它们描述的是一台机器上、一次自写试点里的一个检查点,不是一个托管产品。
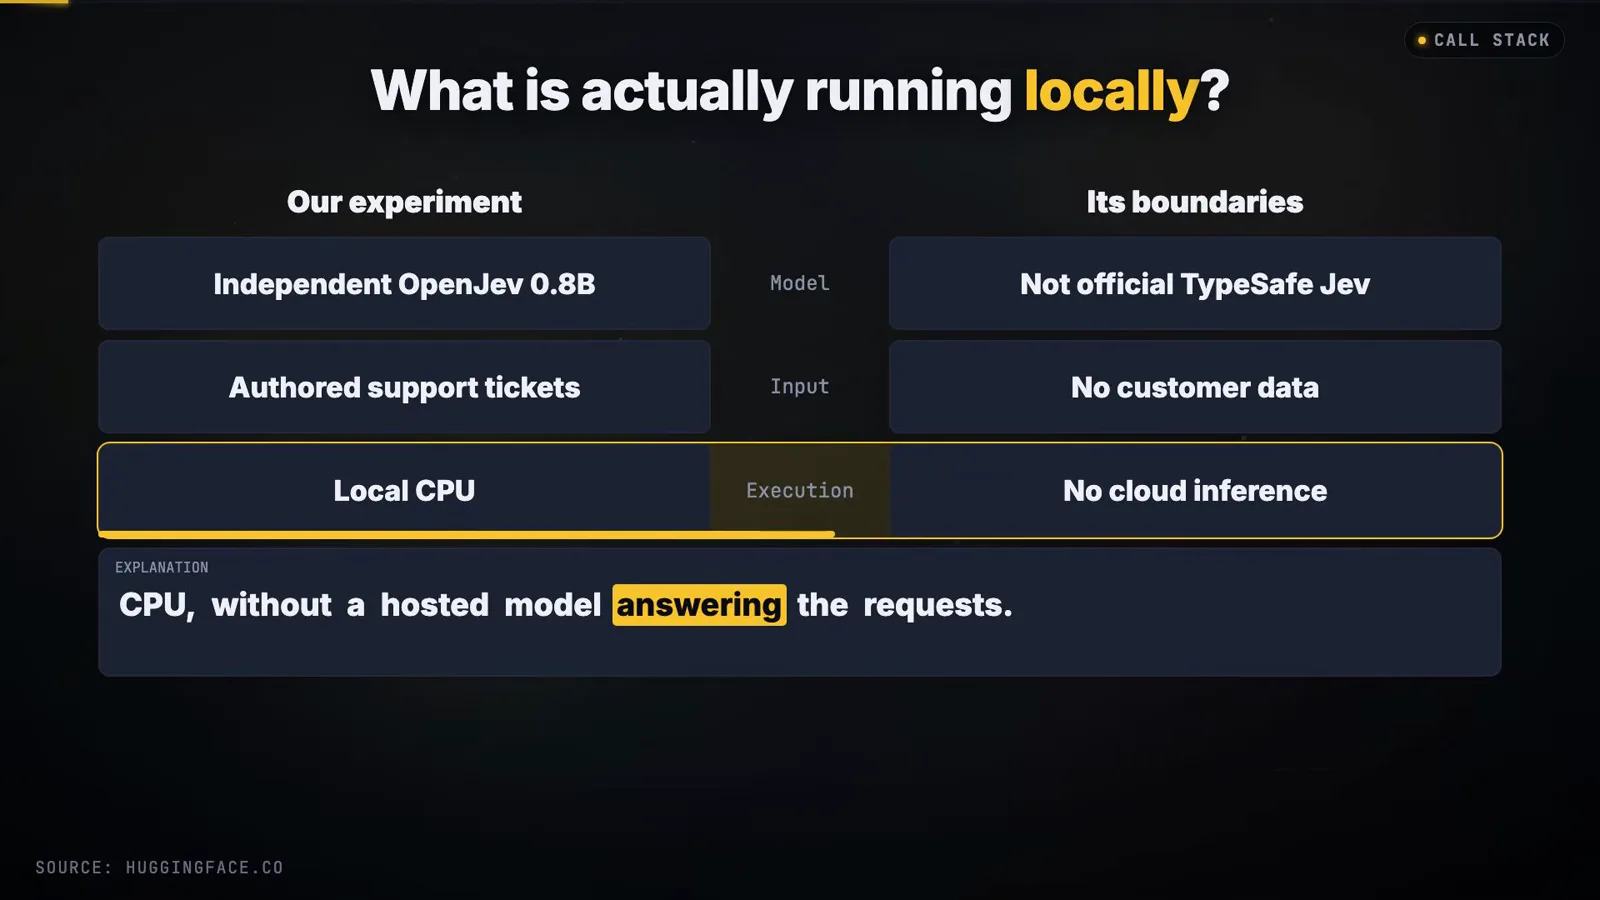
两栏围栏:实验是什么——以及它明确不是什么。跳转至 0:22 - 2
共享的名字,不同的模型:一条必须保留的免责声明
OpenJev 与 TypeSafe 官方 Jev 共享名字,视频特意停下来切断这份混淆。对比卡把两者并排放:发布方 TypeSafe 对 AlexWortega,训练口径「强化学习做校准决策」对「NLI 交叉熵」,「此处未测」对「真实本地试点」。接着是视频反复讲、本页也必须原样保留的一句话:同名不代表官方模型的性能声明可以照搬。无论你怎么看这两个项目,它们是训练目标不同的两个模型——评测其中一个,对另一个什么都不说明。
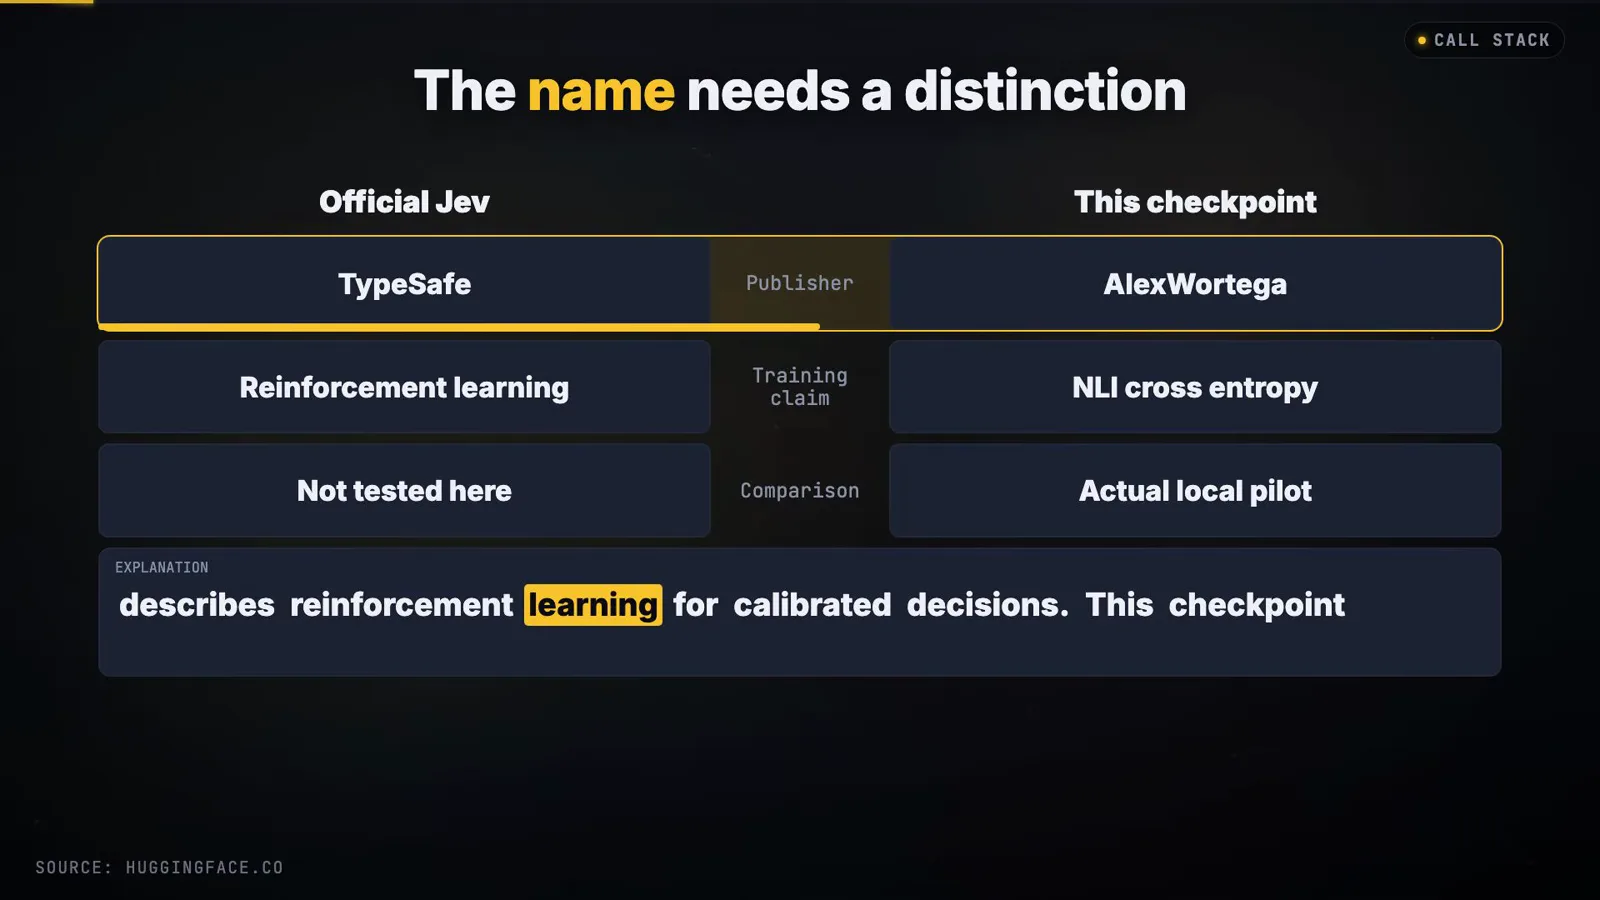
TypeSafe 对 AlexWortega,RL 对 NLI 交叉熵——同名不同物。跳转至 0:30 - 3
一张工单变成四对 premise×hypothesis
模型读收件箱的方式和聊天模型完全不同。每张工单变成 premise,每个部门变成一条假设——一句平实陈述,比如「the customer is requesting a refund」。画面展示的是首张 demo 工单("Please refund my unused subscription")的那一对;应用先评估这一对,再对 billing、login、broken functionality 重复同样的事。四个候选、四对独立的 premise×hypothesis——以及整页故事所依赖的那个设计决策:适配器直读分数,不让模型生成客服回复。
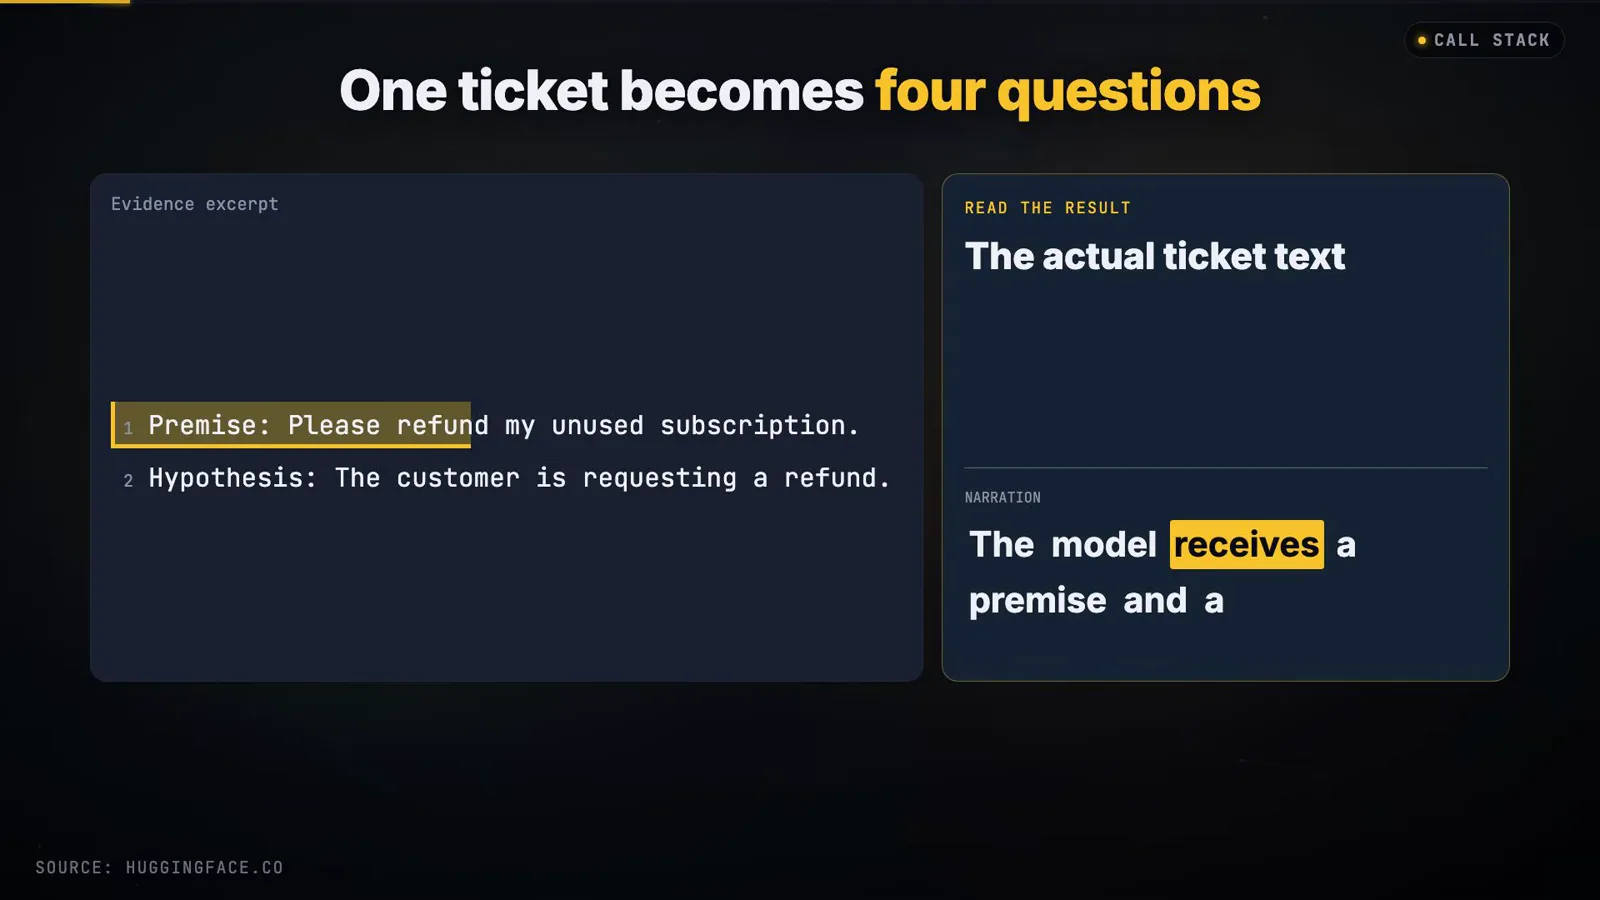
工单进、每部门一条假设——被打分的是这一对。跳转至 0:42 - 4
每对三个分数,三种不同的读法
每对 premise×hypothesis 返回 contradiction、entailment、neutral 三个分数,卡片给每个分数一种读法:contradiction 是工单在反驳这条陈述(去查否定了什么),entailment 是工单支持这条陈述(候选证据),neutral 是证据缺失或无关——它不等于弱化版的矛盾。Demo 工单对 refund 假设的蕴含约 0.995,contradiction 和 neutral 分掉这条命题输出的其余部分。应用选中 refund,返回的精确数字原样留在 JSON 里——是从分数算出的应用输出,不是生成的文本。
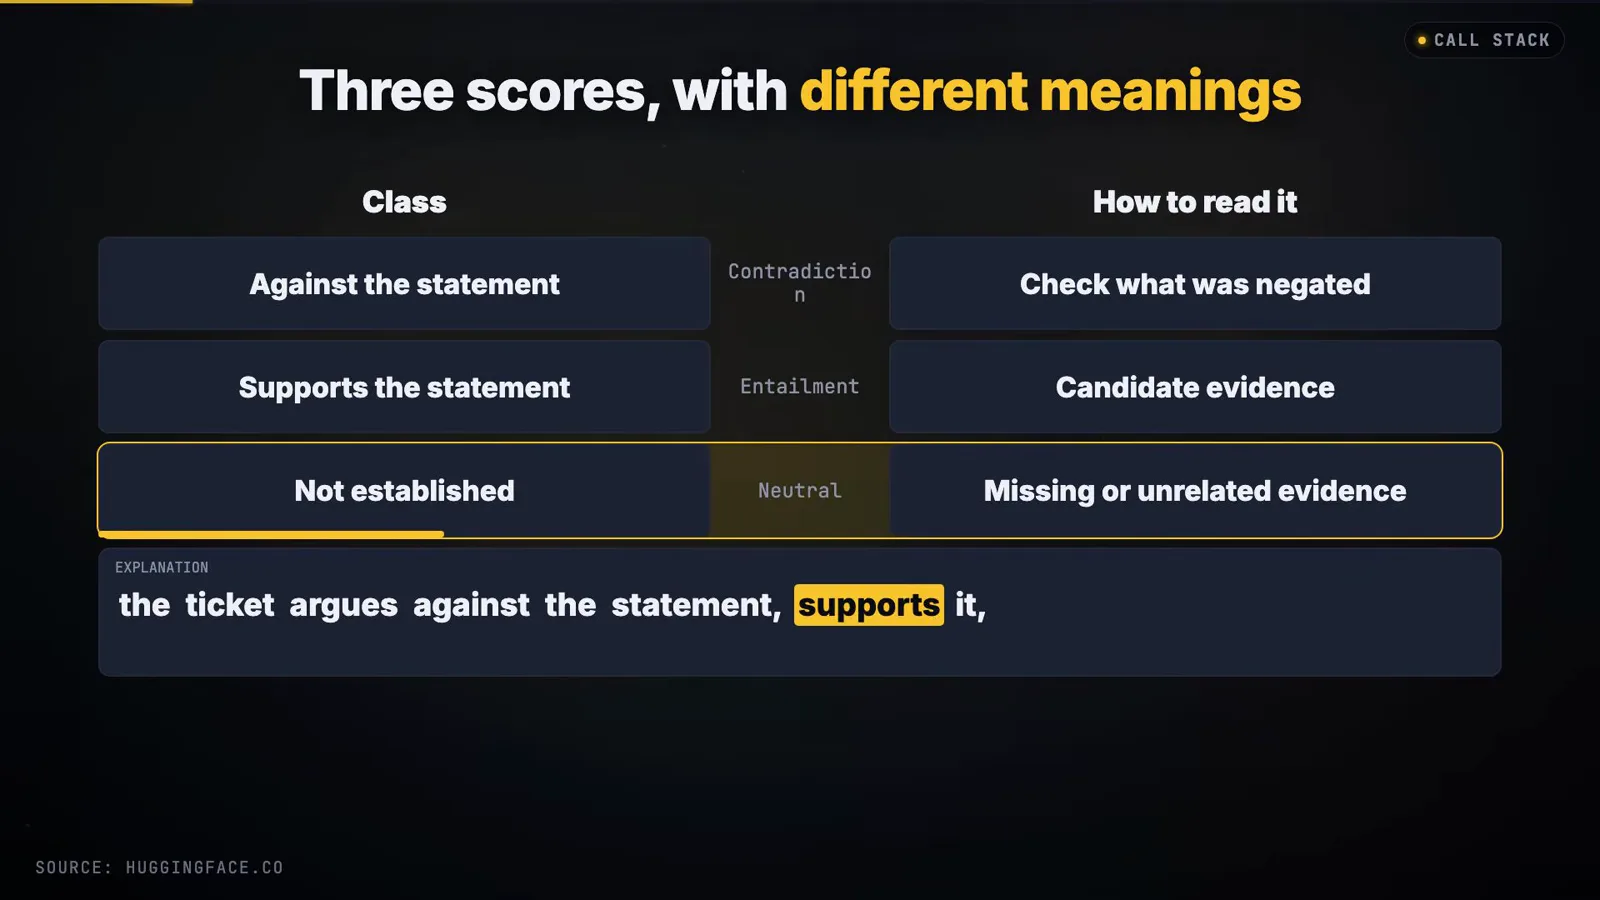
矛盾、蕴含、中立——以及为什么中立不是弱化版矛盾。跳转至 1:02 - 5
第一张跑完路由的工单:refund 蕴含 99.46%
第一张 demo 工单端到端跑完。证据表列出全部四条命题、每条三个分数——refund 蕴含 99.46%(口播约 0.995),billing、login、product bug 全部不足 0.5%。路由横幅给出答案:refund,规则通过,最高分 0.9946、对第二名 billing 领先 0.9904。同一帧上还有两行脚注值得同样认真:每行内部加和为 100%,但这些不是校准过的部门概率;而跨命题的蕴含分数从来不需要加和为一——一张工单可以同时支持两条部门陈述。这行脚注就是两步之后那个问题的种子。这次模型请求在本机 CPU 上耗时 6.22 秒。
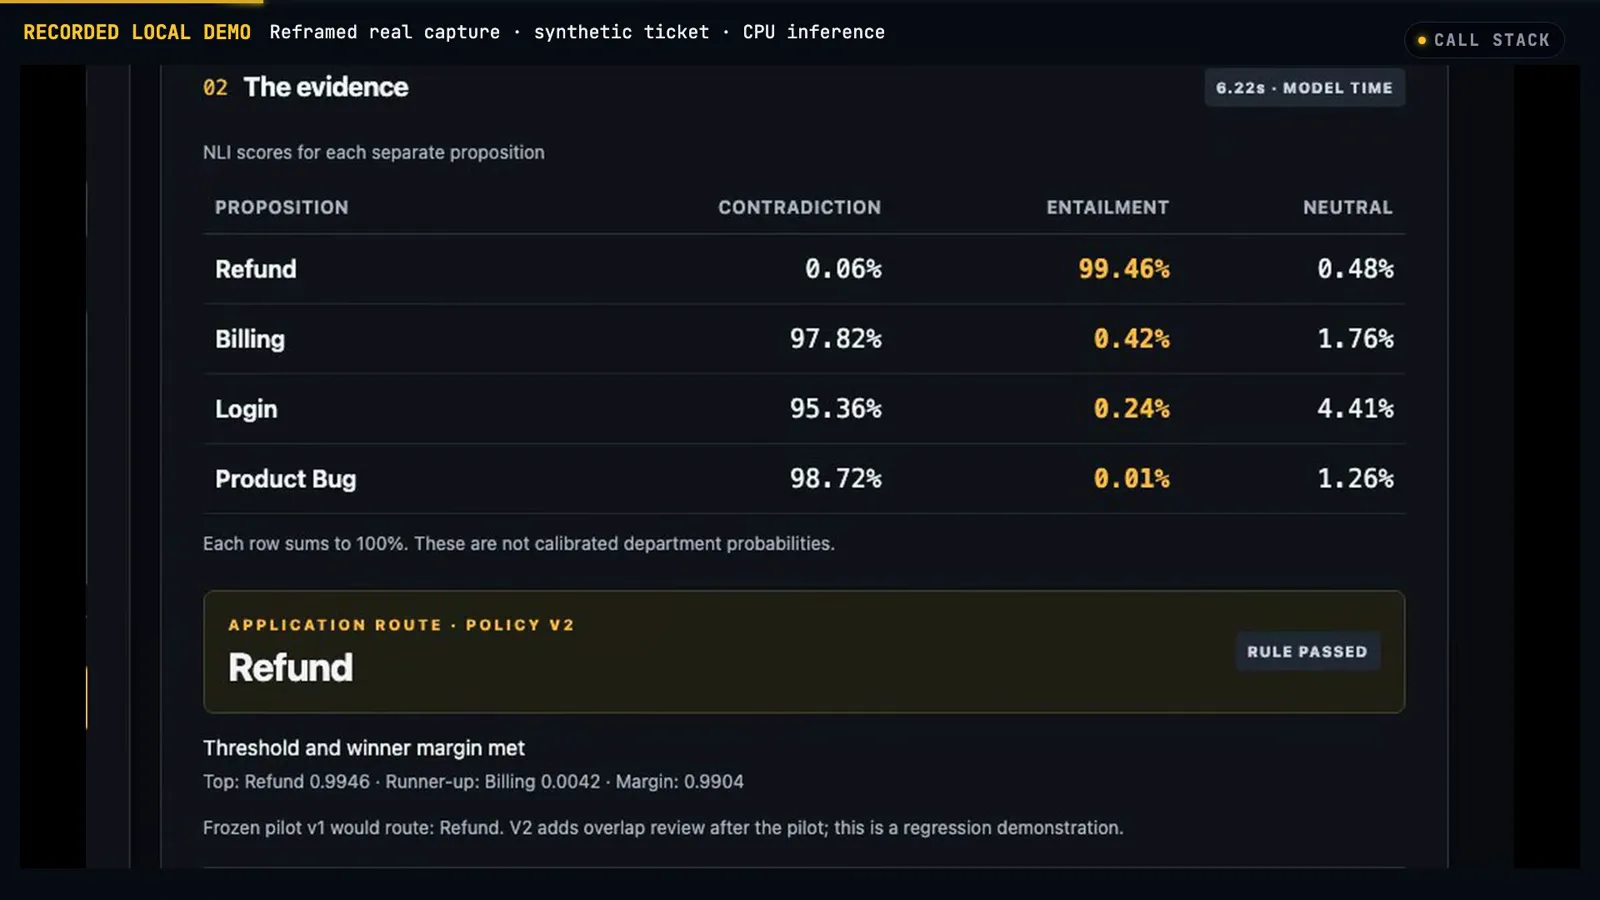
Refund 0.9946、领先 0.9904——一次干净路由,「未校准」脚注已经同框。跳转至 1:25 - 6
路由规则 v1:阈值 0.60、领先 0.10,否则转 review
分数本身不路由任何东西,应用需要一条策略。v1 一共三行:取最大蕴含分数,要求不低于 0.60,要求对第二名领先 0.10,其余全部转 review。卡片对自己的身份很谨慎——这些是看到试点输出之前就定下的临时阈值,不是经过验证的正确性保证。顺序是对的:先定策略再测试,而不是拿 demo 输出调完阈值再把调出来的结果叫「评测」。
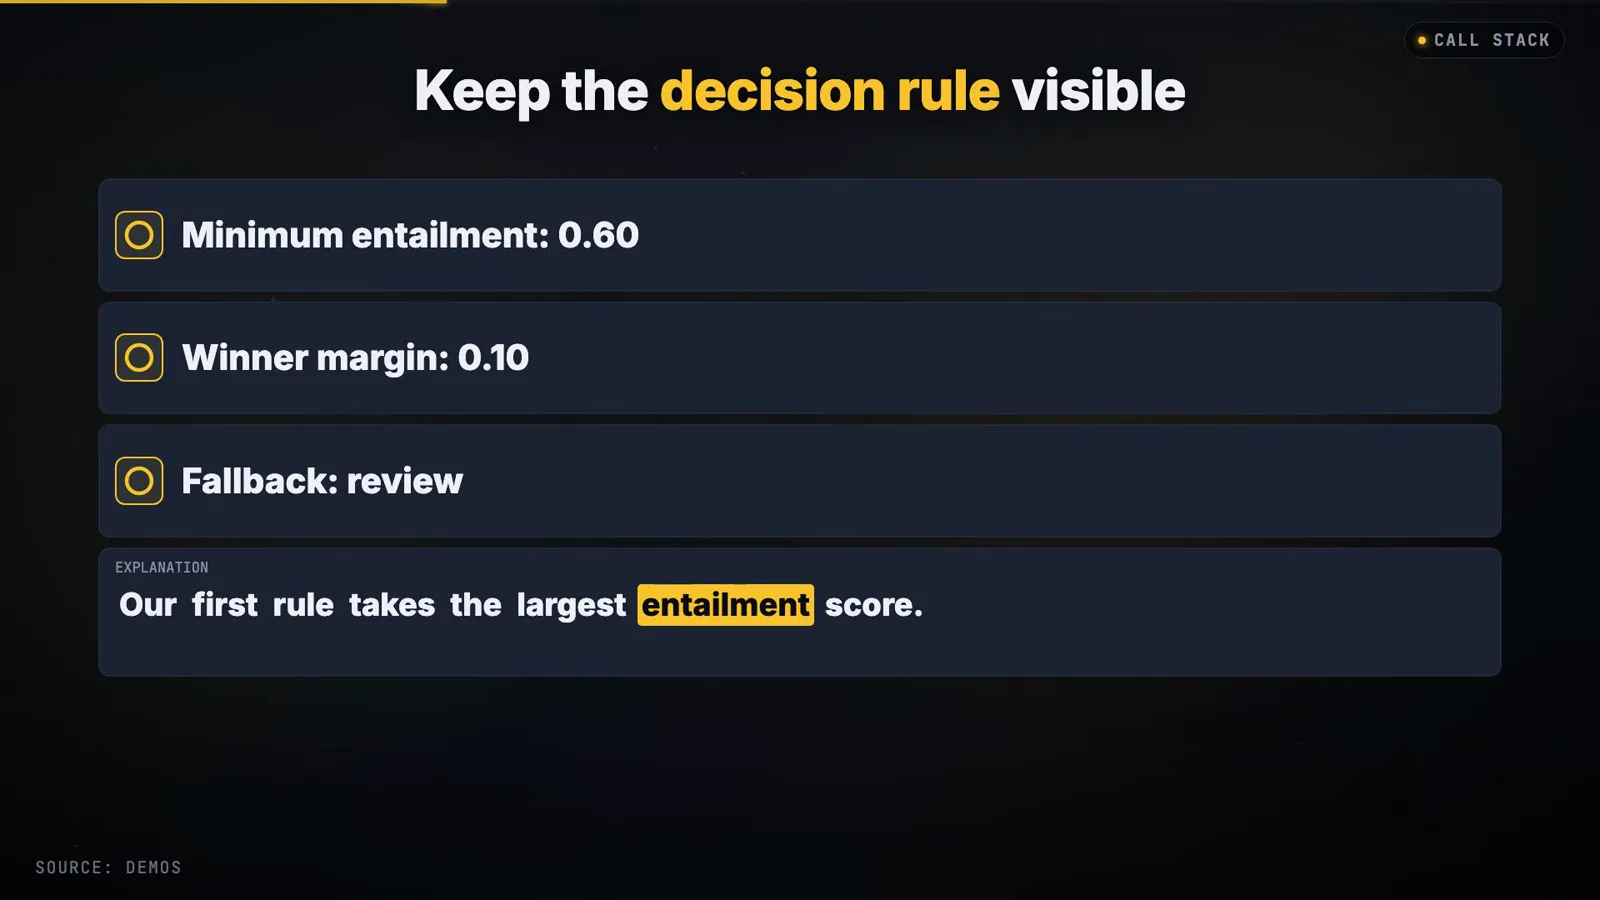
三个数字定义 v1——试点前选定,标注临时。跳转至 2:24 - 7
双问题工单:v1 悄悄藏掉了第二个问题
试点开门第一张工单,一句话里同时提到登录故障和一笔重复扣款。模型这边没掉链子:billingEntailment 0.973130、loginEntailment 0.776559——两个都过了 0.60 阈值,JSON 也把两个数字都留住了。但 v1 只取最大分,于是它路由给 billing,login 证据从未变成一个决策。视频对此的定性很准:这不是模型失败——login 证据一直留在模型输出里——而是策略局限,应用在路由那一层把它丢掉了。工单明明把两个问题都写在了明面上,规则却只听得见一个。
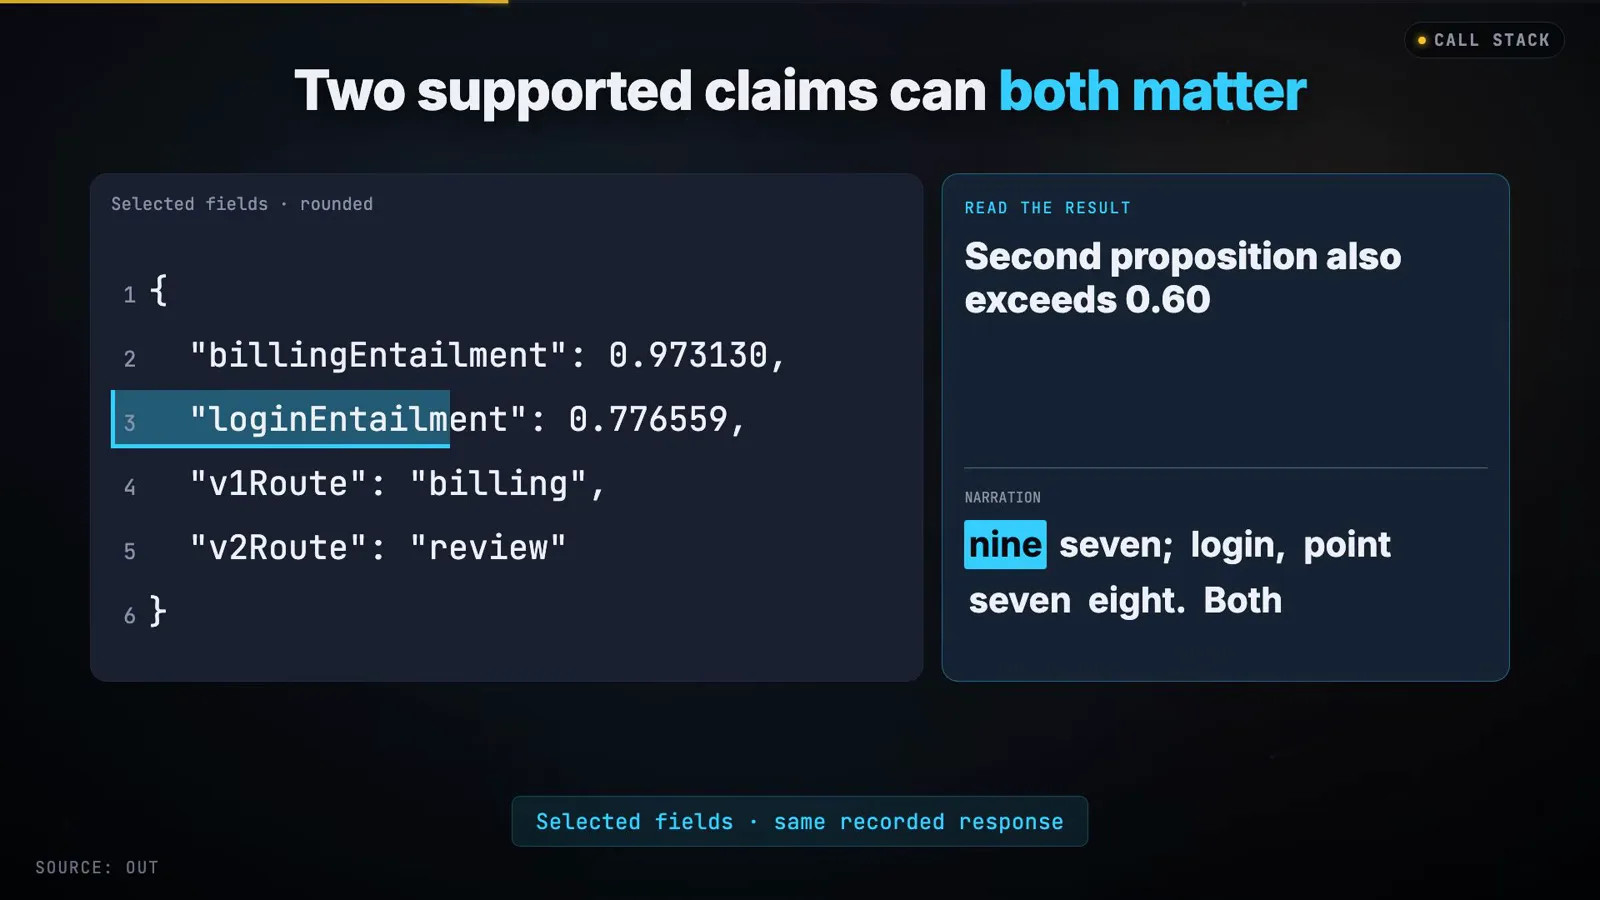
两个分数都过了 0.60。v1 挑了一个,把另一个扔在了地上。跳转至 2:44 - 8
规则 v2:多命题过阈即转人工复核
v2 只改一个条件:当多条命题都过阈值时,不再选赢家,而是把工单转去复核。画面是视频冷开场回放的那个瞬间——billing 97.31%、login 77.66% 双双过线,路由横幅回答 Human Review 并挂上 ABSTAIN 标记,同时注明冻结试点的 v1 会路由 billing。模型分数一个都没变,变的是应用决策。这是「藏掉第二问题」这个失败模式最便宜的修法——而下一步就要为它付账。
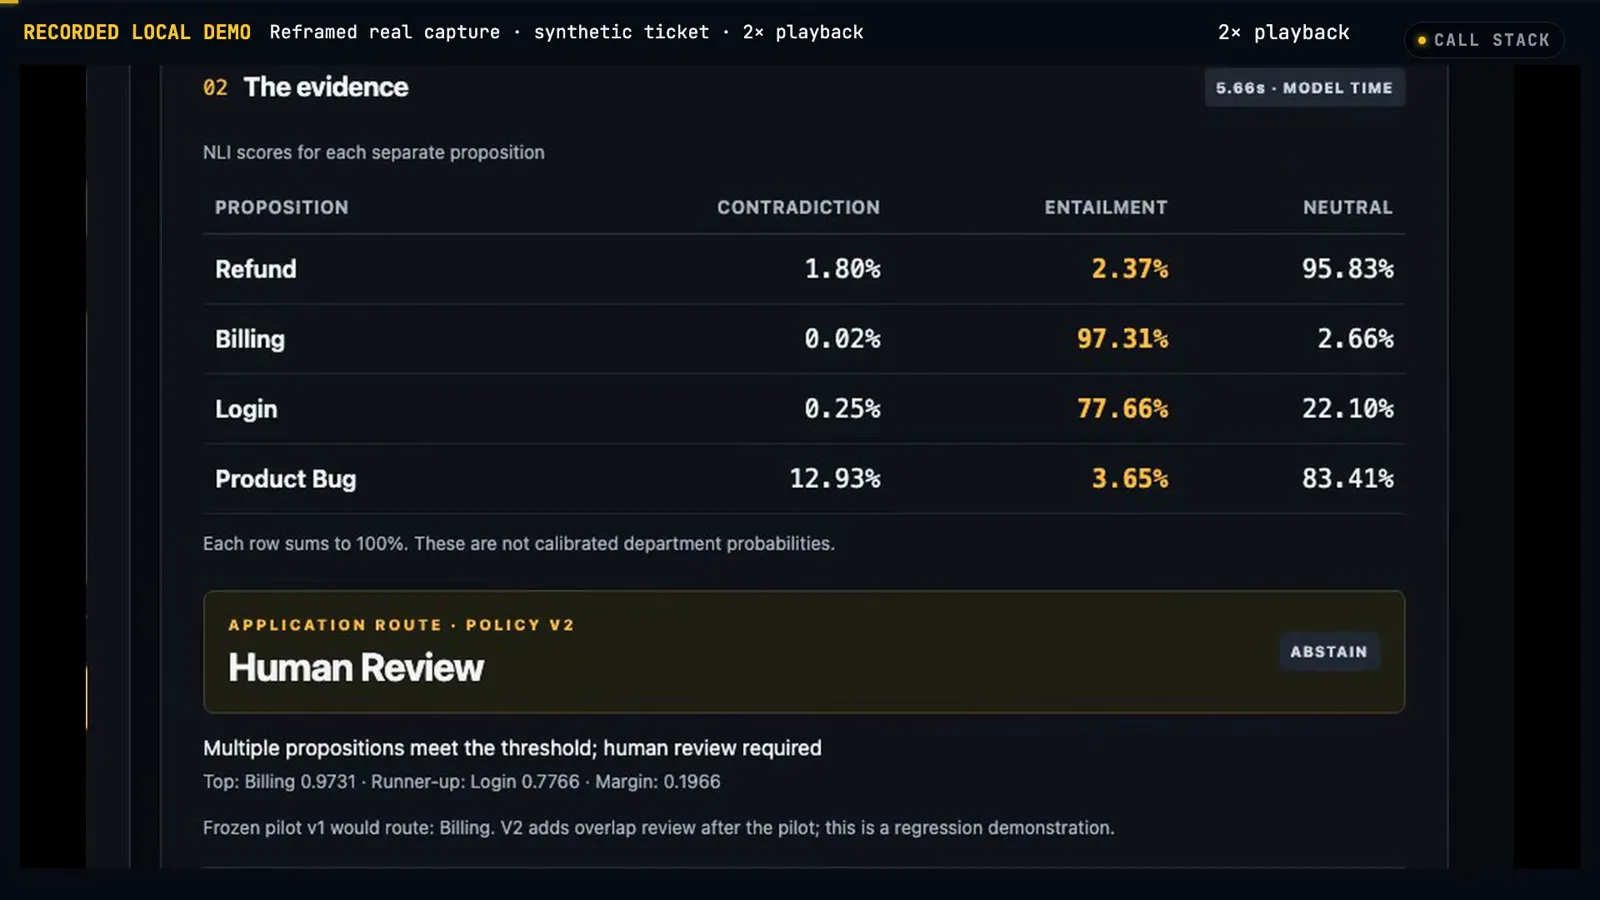
同样的分数,新的规则:两条命题过 0.60,现在交给人工。跳转至 0:06 - 9
代价:一张干净的退款工单被推迟了
更严的规则一定会在某处失手,视频把失手处拍了出来。"I cancelled yesterday. Please return the payment for the unused month" 是一条提到支付的退款请求——于是 refund 蕴含 98.83%、billing 蕴含 72.77% 双双过阈,v2 把这张冻结试点中本该正确路由到 refund 的工单推迟进了复核队列。两个结果都留在片里:双问题案例变好了,退款案例退化进了复核队列,而更多复核意味着更多人工作量。视频还补上本页反复强调的口径:这次回归检查跑在早就看过的样例上——它不能证明对未见工单表现更好。
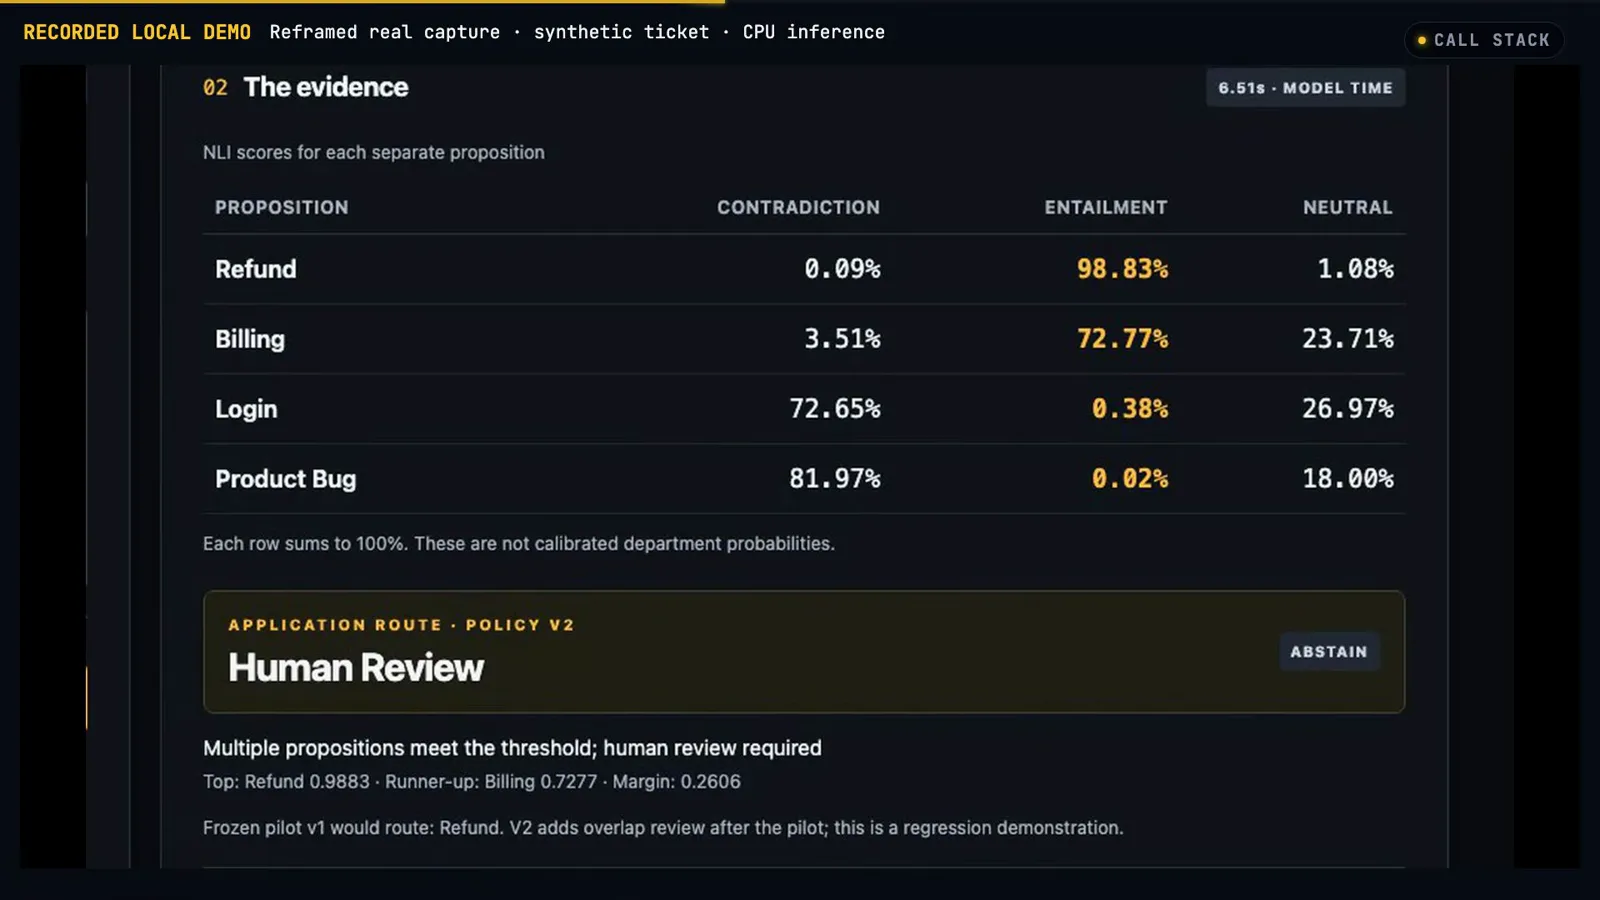
Refund 0.9883 与 billing 0.7277 双双过阈——v2 把一张好工单送去复核。跳转至 3:54 - 10
Miss 归因:密码重置工单上 bug 胜过 login
下一个 miss:过期的密码重置链接,事前标注为 login。返回的分数把 product bug 顶了上去——0.6866 对 login 的 0.4913——应用路由 Product Bug,规则通过。视频拒绝停在「怪模型」:「broken application functionality」本来就可能覆盖一个登录问题,所以要同时审视措辞和分数,判断该修订的是模型、类目体系还是路由策略。一个合法的概率向量照样能产出不想要的路由。片里还有两例自写 miss 得到同样对待:只要发票副本的请求落进了写得过窄的 billing 假设(「a problem with a charge or invoice」),以及一句表扬找不到任何类目——硬塞进某个部门只会引入类目体系从未挣得的假设。
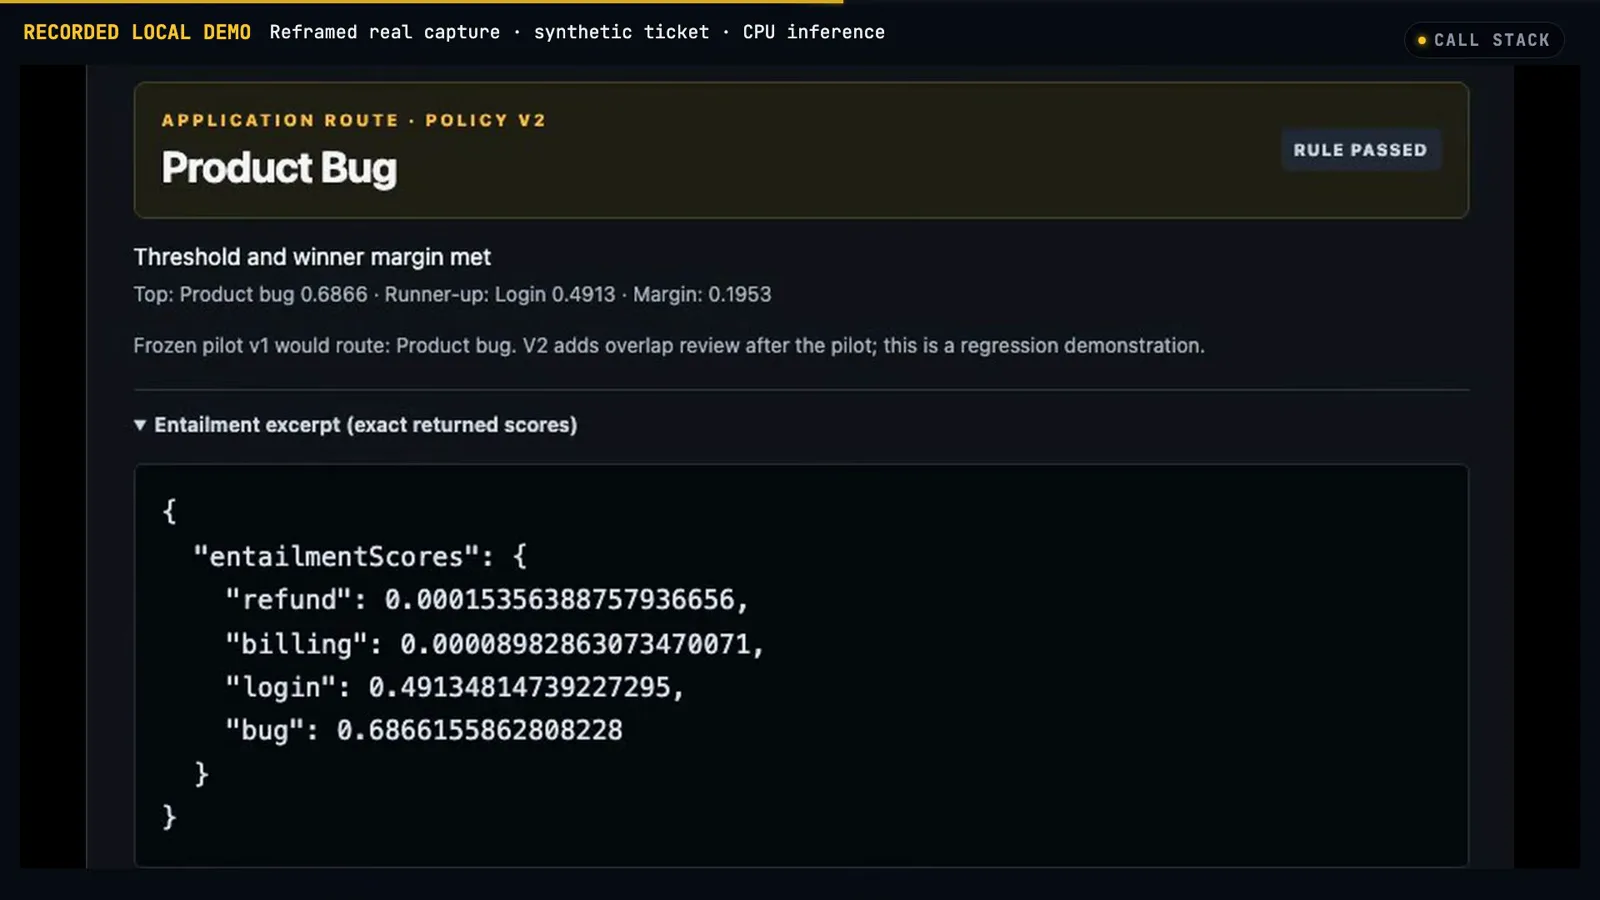
Bug 0.6866 对 login 0.4913——JSON 让这次错路由可直接检视。跳转至 4:32 - 11
诚实的记分板:2/4 与 7/12
在推理之前,视频先写好了 4 条校准用例和 12 条留出用例——直陈请求、否定句、多问题、无关消息——并提前冻结。在原 v1 规则下,应用命中 2/4 条校准路由和 7/12 条留出路由,口径就是 JSON 里的那个字段:"authored end-to-end route match"。然后是本页借用的那个框架:这些计数度量的是模型、类目定义与路由逻辑的整体——它们不是独立模型准确率,分数也不是校准过的正确概率。收尾建议层层加码:先厘清每个部门到底意味着什么;看预测之前先写用例;修订策略后用不变的测试集做公平对比;保留失败样本,别拿好看的样例替换尴尬输出——否则你测的就是展示层。
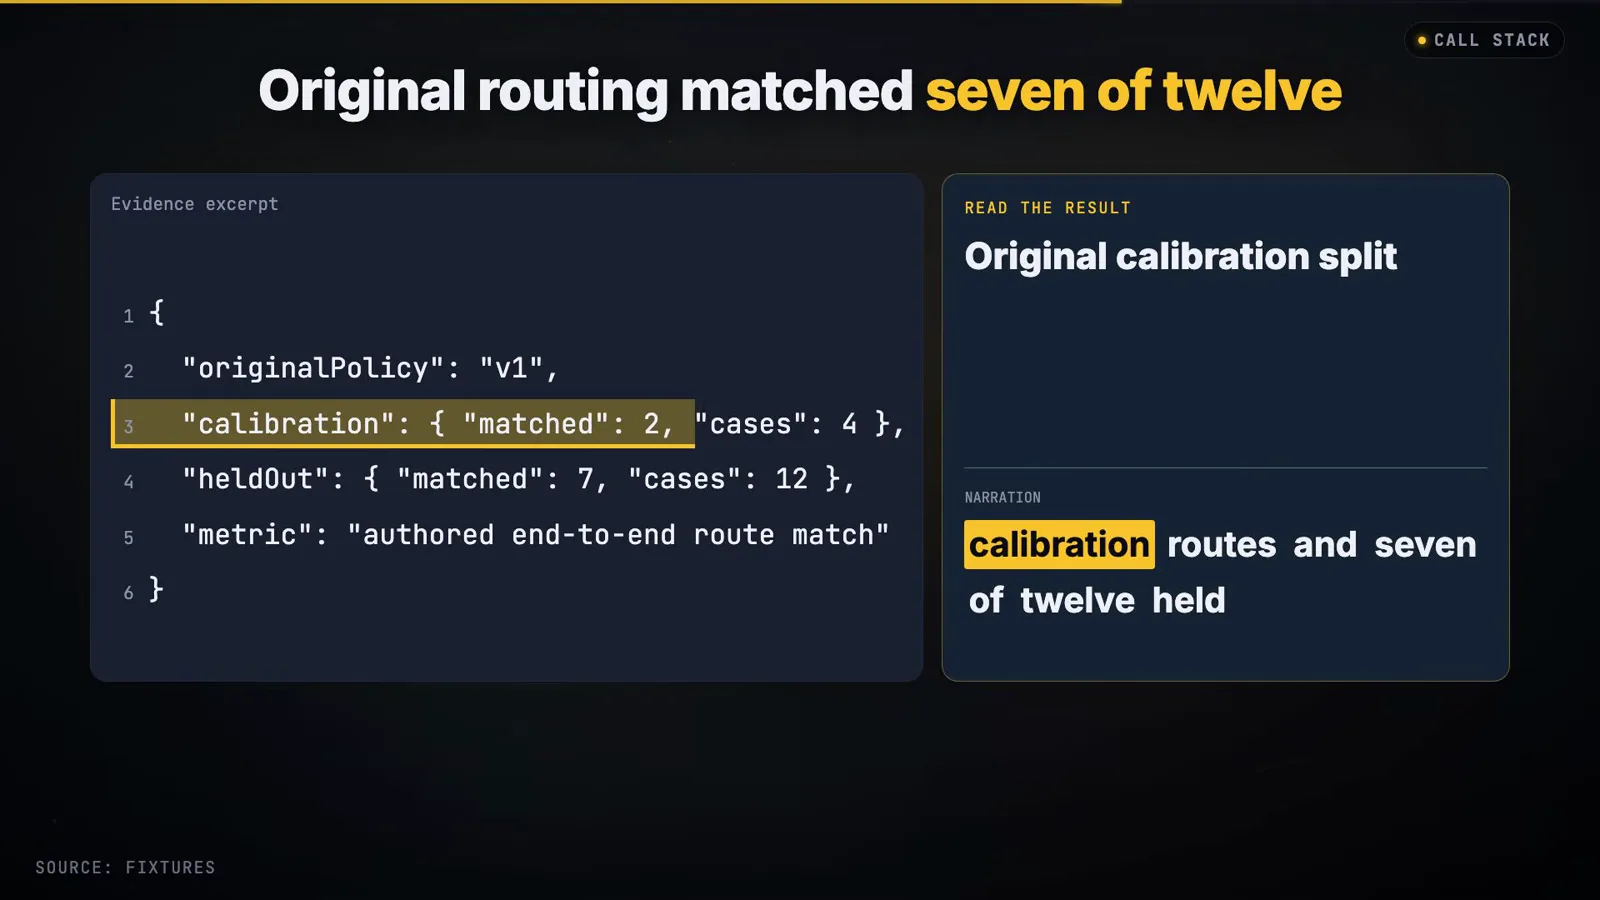
calibration 2/4、heldOut 7/12——这是整个系统的记分板,不只是模型的。跳转至 6:02
常见问题(FAQ)
OpenJev 0.8B 检查点是什么?它是官方 Jev 模型吗?
它是 AlexWortega 独立发布的 0.8B 参数检查点,用 NLI 交叉熵训练:把 premise(工单)对 hypothesis(部门陈述)打分,返回 contradiction、entailment、neutral 三个分数,应用直接读这些分数,而不是让模型生成文本。它不是 TypeSafe 的官方 Jev——视频说官方走的是强化学习校准决策路线——并且按视频自己的免责声明:同名不代表官方模型的性能声明可以照搬。
这套 CPU 收件箱需要什么硬件?
按本地模型的标准相当轻:权重在磁盘上约 1.71GB,试点进程峰值内存约 3.20GB,CPU float32 推理,全程无 GPU。16 次请求(每次串行评估四条假设)的中位模型耗时 5.63 秒——该数字不含模型加载和浏览器交互,也未测优化的 GPU 部署。文件下载完成后,一切离线可跑。
contradiction / entailment / neutral 三个分数怎么读?
每条部门假设都单独对工单打分:entailment 是工单支持该陈述(候选证据),contradiction 是工单反驳该陈述(去查否定了什么),neutral 是证据缺失或无关——不是弱化版的矛盾。视频给的两条读数规则:跨命题的蕴含分数不需要加和为一(一张工单可以同时支持 billing 和 login),每行内部三个分数虽加和为 100%,但不是校准过的部门概率。
0.60 阈值和复核规则是怎么定的?
临时定的,而且在看到输出之前:v1 取最大蕴含,要求 ≥0.60 且对第二名领先 0.10,否则转 review;v2 只加一条——多条命题过阈即转 review。视频把权衡摆在明面上:v2 让被藏住的第二问题(billing 0.97 + login 0.78)浮出来,但也把 refund 0.9883、billing 0.7277 双过阈的干净退款工单推迟了。两个版本都没被验证为正确;片中的建议是先修策略,再用不变的测试集去量错路由和多余复核。
7/12 是不是说模型准确率 58%?
不是——视频对此毫不含糊。试点用了 4 条自写校准用例和 12 条留出用例,v1 端到端命中 2/4 与 7/12。这些计数度量的是模型、类目定义与路由逻辑的整体;它们不是独立模型准确率,原始分数也不是校准过的概率。这些用例是为了检验应用而写的探针——不是真实客户流量的样本——所以把它们当「下一轮策略修订的基线」,别当基准测试分数。
这个应用适合什么,不适合什么?
片中的建议形态刻意保守:一个在旁边建议队列、决定权始终握在人头上的助手;类似分类器还可以顺延到内部笔记打标或反馈分拣——那是可能的项目,不是这次 16 工单实验的进一步结论。它不适合拿原始分数自动路由高后果工单;把类目外的话(比如表扬)硬塞进部门只会引入错误假设。本地推理消掉的是一次数据传输——不是全部风险:日志与部署仍要自己盯,公开部署需要真正的后端设计,因为浏览器只是本地 Python worker 的界面。
相关推荐
OpenJev RLCD:在本地跑校准决策模型
「装好并伺服」那一轴:Kaggle 免费显卡或 llama.cpp 跑起 RLCD decider。本页则是用一次下载的 NLI 检查点造应用。
阅读Build Your Own Jev:自建类型化决策器
自建轴:给自家的 typed 决策器喂 state 加 strategy 问题。本页用现成检查点,把时间花在校准路由策略上。
阅读Train Your Own Jev:训练杠杆
训练轴:从零产出一个决策模型要动哪些杠杆——本页所用检查点的上游。
阅读Run Jev Locally:官方路径
官方 TypeSafe 模型跑在自己硬件上——校准路线的对照组,其性能声明本页检查点明确不共享。
阅读官方 API 的工单分类
同一份工作的托管 API 版:类型化问题加置信度的支持工单路由——拿它的延迟与置信度语义对照这场 CPU 试点。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
- Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
- Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
- Jev 接入 Codex 实操:typesafe-ai/skills 安装与 Gmail 30 封邮件分诊
- Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
- 自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
- CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
- 用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门
- Ollama 决策模型实测:tev1 + nimble 跑在 8GB 显卡上
- Jev 生产环境护栏:五步接入实战手册
- Pi Agent 防跑偏插件实战:让 Jev 出概率,让代码做决定
- Tev1 用例实测:50 个任务看尽本地决策模型的能力边界
- Jev 实测:官方宣称与独立复测之间的距离
- Jev 工单分类实战:after-insert hook 与计算字段两种接法
- OpenJev RLCD 实操:开源校准决策模型本地部署全指南
- Clef-Flash vs Jev 实测:把 Cloudflare 决策模型装进 Ollama(Q4_K_M)
- Julia-1 实操教程:纯 Python 装上开源 Jev 替代品,10 条客服消息实测 9 比 2
- Jev n8n 集成实战:JevGate 社区节点分步攻略(附纯 HTTP 备选路线)