
Guides / 视频转图文攻略
CLM-8B 架构深潜:44 毫秒打分 1,024 个候选的对比决策模型(比 Jev 快 13 倍)
把 Prompt Engineering 的 CLM-8B(CLM-v0.1)深潜视频整理成分步架构图文:决策版 CLIP 双塔设计、动作嵌入一次缓存后 1,024 个候选 44 毫秒(Jev 570 毫秒)、冻结 Qwen3-8B 上的三阶段对比训练、DGX Spark 实操栈、1,080 工具路由与 WikiRace 复刻——86%→17% 的准确率崩落原样保留在页面上。
速览结论
这是一篇 CLM-8B(CLM-v0.1)的架构深潜。CLM = Contrastive Language Model(对比语言模型),出自斯坦福 + NVIDIA Research 团队,官方宣称至多比 Jev 快 9 倍、精度持平——快的原因不是模型更小,而是把决策变成了检索。冻结的 Qwen3-8B 骨干(卡面原话「just a reader」)只读不训,两侧各一个约 2,000 万参数的头把 state 和动作嵌进同一空间,于是给 1,024 个候选打分 = 一次 state 编码 + 几次点积:视频曲线上 44 毫秒,同图 Jev 570 毫秒、普通约束解码 LM 爬到 4,185 毫秒——约 13 倍,而且候选越多 CLM 曲线越不弯。它说 Jev 的三原语(yes/no、多选、打分),底层都是 state 加封闭候选列表:永远不会发明列表外答案,但可能自信地选错列表内答案。训练分三段且顺序敏感——先是 6,000 万条 NVIDIA Nemotron QA 对,再加 3,000 万条 Gemini 生成的难负样本(先世界后细分:难负样本测试 52%→69%;从第一天就混则只到 62% 并过拟合),最后约 100 万步真实 agent 轨迹加 40% QA 回掺(无回掺 69 掉到 56)。骨干不变意味着数据集只需嵌入一次,全量预训练单卡 RTX 4090 约 1 小时。DGX Spark(GB10)实操:vLLM 起冻结的 Qwen3-8B 编码器、上面跑团队发布的约 75MB CLM server(全栈约 25GB 内存),一条「被重复扣费还找不到人」的客服工单一炮三问——urgent 84%、billing 99%、frustration「very angry」;同票复问 <2 毫秒(模型延迟 0.8 毫秒、往返 9 毫秒、encoder_tokens 0,什么都没重新编码)。诚实段:8 个工具 top-1 86%(77/90),1,080 个工具掉到 17%(5/30)——同音 refund 工具互相混淆,根因是双塔的 state 永远看不到候选、无法并排比较;自建的 WikiRace 复刻 5 场只赢了 1 场。推荐用法:让 CLM 毫秒级把上千候选砍到 top 10,再交能并排读选项的 System 2 模型终审;动作集小而稳定(游戏循环、固定路由)可以直接用。时效注记:截至视频(2026-09-26)仅文本版,35B 多模态版宣称下月发布。
分步图文攻略
- 1
CLM-8B 是什么:斯坦福 + NVIDIA 的对比语言模型
Jev 带火了 System 1 模型——不推理的小模型,专门毫秒级回答「下一个工具跑哪个?这张工单急不急?agent 该点哪条链接?」。但大多数开源复现剥开来看仍是语言模型:读你的文本、逐个读选项、再一个 token 一个 token 解码出答案。CLM-v0.1——斯坦福 + NVIDIA Research 团队的 Contrastive Language Model(对比语言模型)——带着一套完全不同的架构来了。它是一个 80 亿参数的模型,和那些复现品同一个尺寸级别,官方宣称至多比 Jev 快 9 倍、精度持平。关键在于:速度不是靠把模型做小,而是靠架构本身——这正是本页剩下的部分要拆开的东西,最后还有一块 DGX Spark 上的实操 demo。注意卡面本身的画法:LLM 解码器被整把叉掉了。
CLM = 对比语言模型——LLM 解码器在架构图上被整个划掉。跳转至 1:01 - 2
决策版的 CLIP:双塔架构
视频给出的心智模型:CLIP,但用在决策上。CLIP 把图像和文本放进同一个嵌入空间,让狗狗照片落在「a photo of a dog」这个词旁边。CLM 对态势和动作做同样的事:state encoder 读「现在发生了什么」,action encoder 读「你可以做什么」。以马里奥为例——板栗仔(Goomba)正走过来,state 就是游戏画面,动作是 left、jump、run right。做决策时,把 state 嵌入一次,把每个选项各嵌一次,按每个选项与 state 在共享空间里的距离打分,再过一层 softmax 把距离变成概率——视频例子里 jump 拿 80%、run right 15%、left 5%——于是马里奥起跳。全程不生成任何一个 token,答案是几何算出来的。
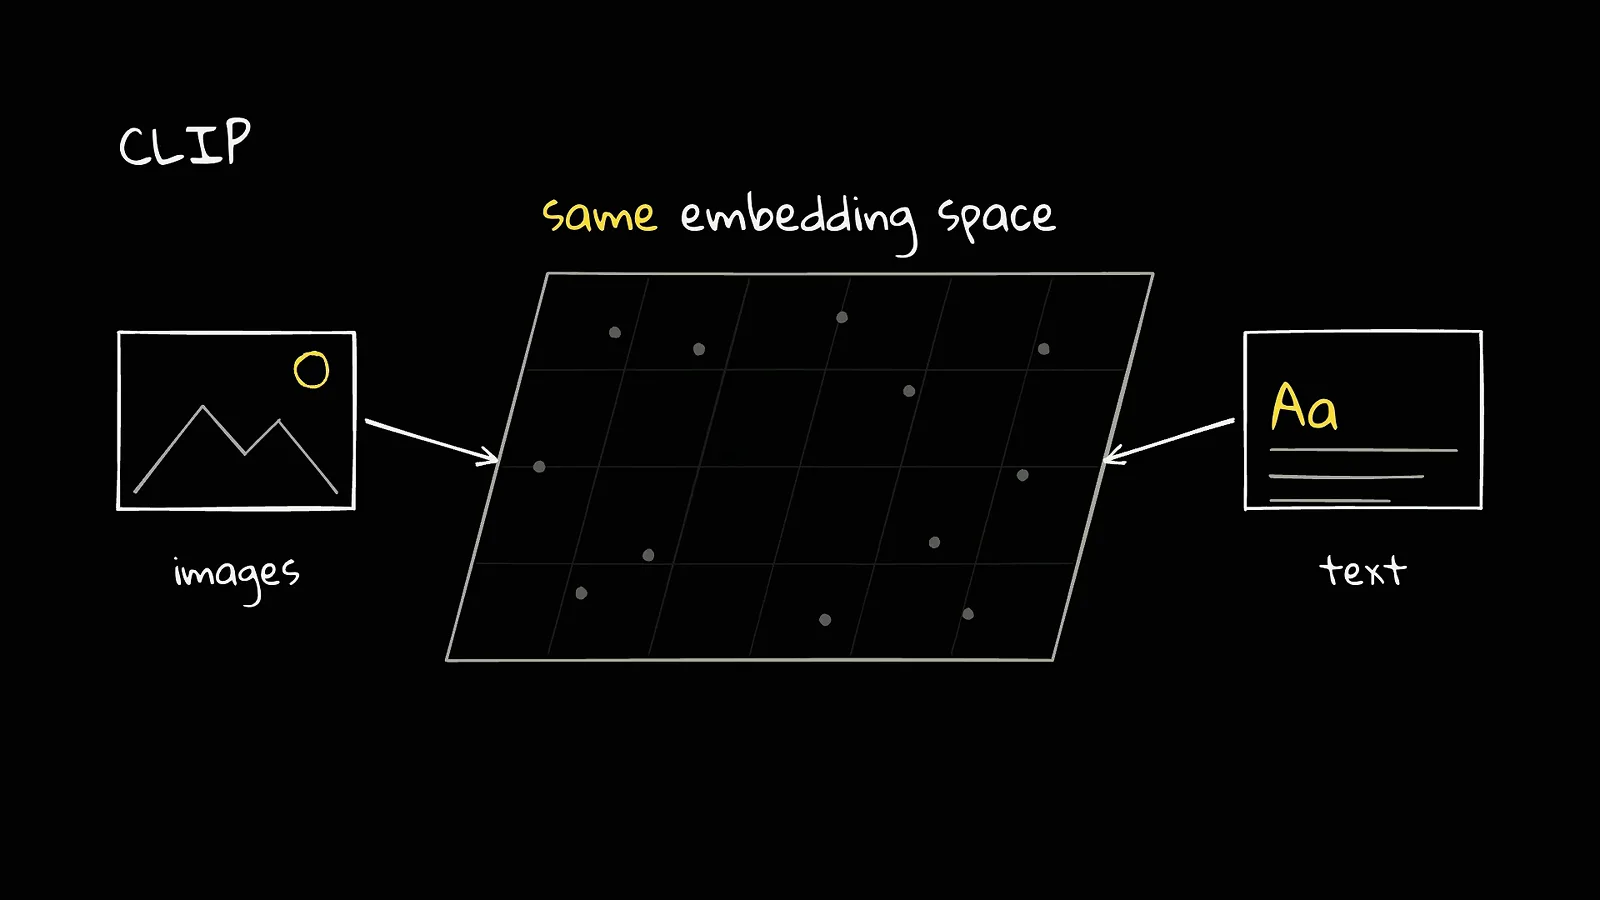
CLIP 对齐的是图像与文字;CLM 对齐的是态势与动作。跳转至 2:00 - 3
它说的是 Jev 的 API——附赠同一张 fine print
CLM 被设计成说 Jev 的同款 API,所以它暴露的正是本站反复讲的三个类型化原语:yes/no 问题、多选问题、打分。底层三者为同一种运算——一个 state 加一个封闭候选列表;yes/no 不过是 true/false 两个候选。于是它继承了 Jev 那句著名的承诺,也继承了同一个诚实的星号:它永远不会发明列表外的答案——就是「Jev 不会幻觉」那句话——但它仍可能从列表里挑出错误的那个,而且挑错时可以非常自信。围栏挡得住发明,挡不住围栏内选错。记住这个星号,本页最后它会带着数字回来。
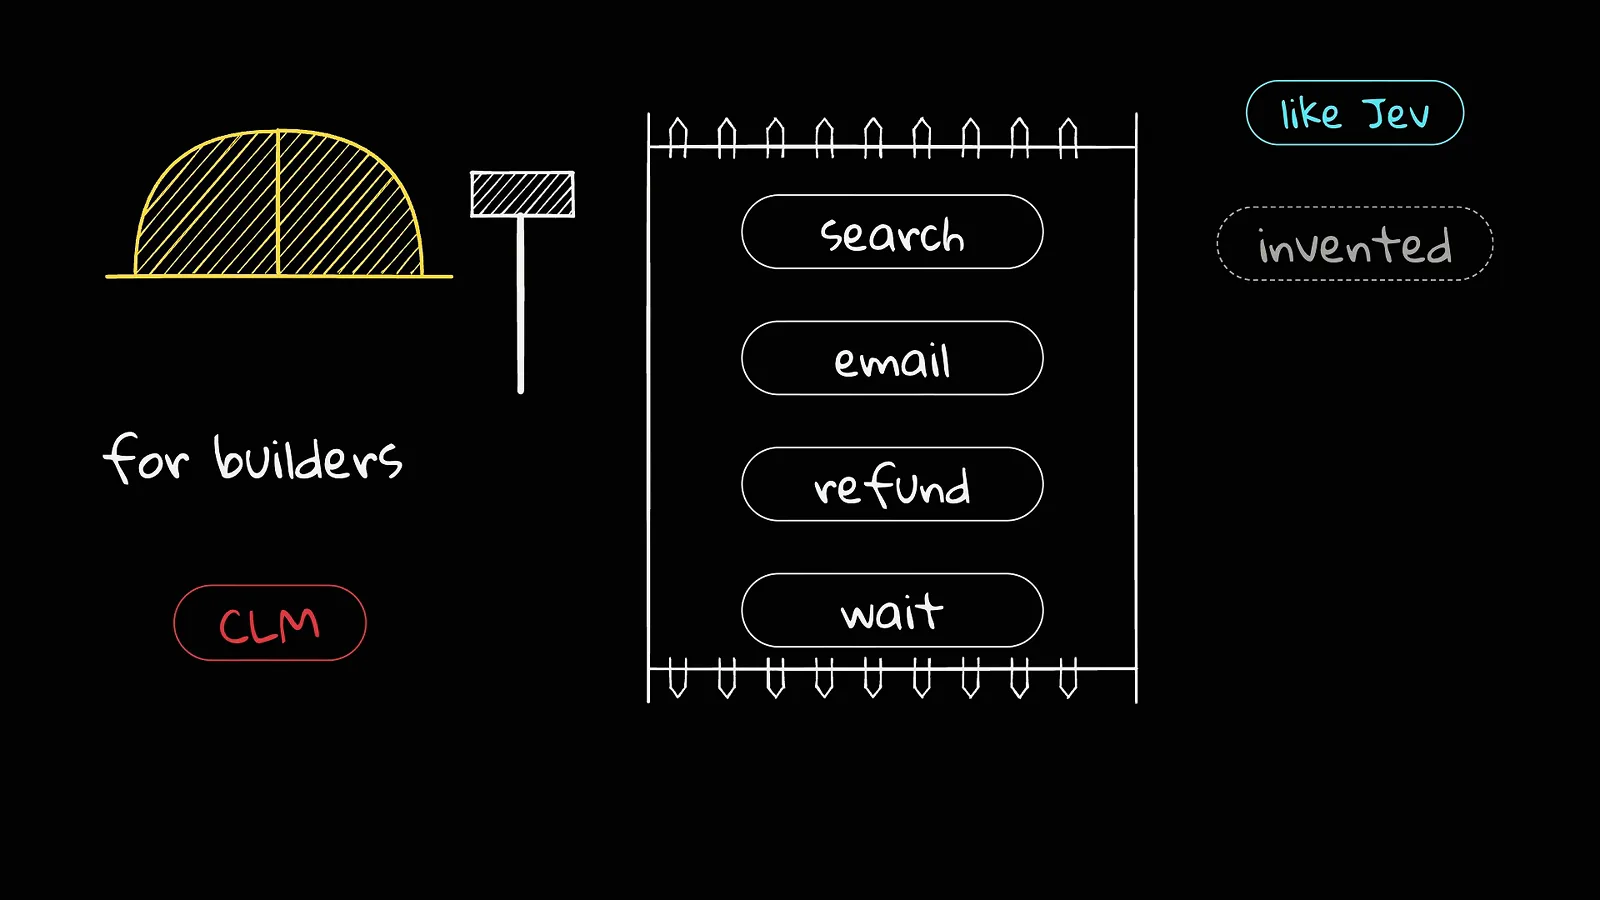
模型逃不出这个围栏——但围栏内的错误答案照样是错误。跳转至 3:21 - 4
速度从哪来:动作只嵌一次,永久缓存
Jev 式模型每次调用都把 state 和全部选项一起塞进模型:选项翻倍,读取量翻倍,还要从大模型里逐 token 解码答案——昂贵,而且随规模复利。CLM 把两座塔拆开。大多数 agent 循环里,动作列表在步与步之间根本不变,变的是 state。于是动作只嵌入一次然后缓存,之后每个新步骤只花一次 state 编码加每个选项一次点积——而点积约等于免费。视频的马里奥 demo 里,这把每步五次前向传播降成一次。帧里就是这套形状:state encoder 每步都跑(agent loop 已经转到第 6 步),action encoder 对 left、jump、run right、duck 只跑一次。
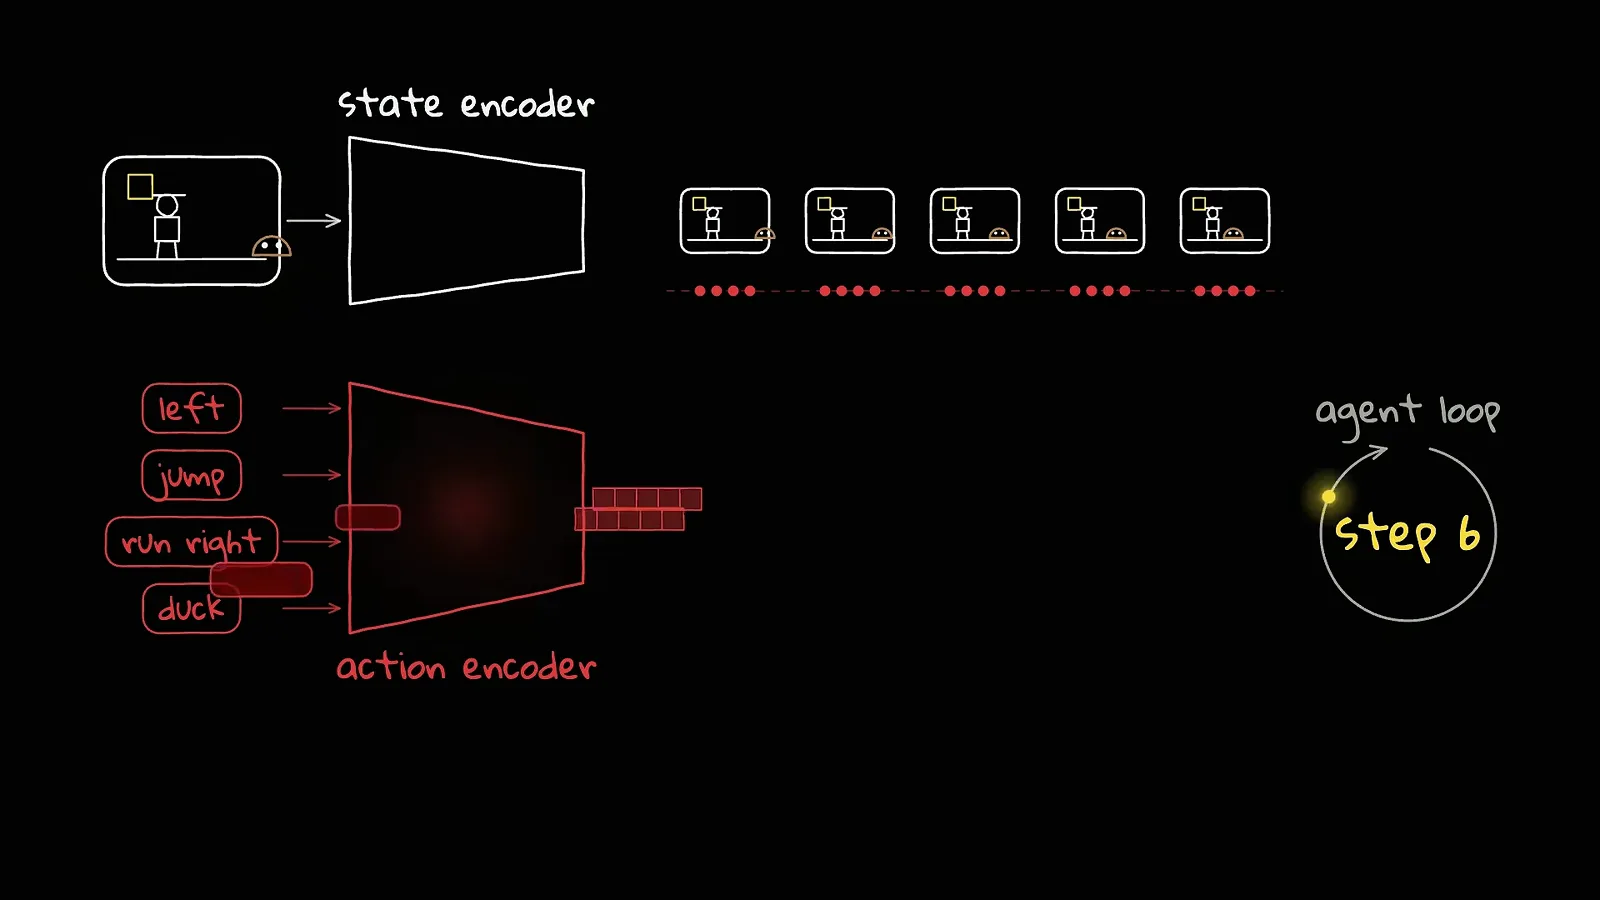
state 每步编码;动作嵌一次之后只是反复复用。跳转至 5:41 - 5
13 倍曲线:1,024 个候选,44 毫秒对 570 毫秒
视频标题里的那个数字,就在团队这张图上。候选数从 1 涨到 1,024:普通 LM 的约束解码线爬到 4,185 毫秒;Jev 在右端停在 570 毫秒;CLM 几乎不动,落在 44 毫秒——一千多个候选的列表,比 Jev 快约 13 倍。视频前面还提到,约束解码在几百个选项时就已经超过 4 秒,而这恰恰是真实工具列表所在的区间。用之前那期 System 1 / System 2 的话说:System 1 在宽度上扩展——一次回答大量小问题——而 CLM 把这件事推到了极限:一千个候选,只花一个的价钱。
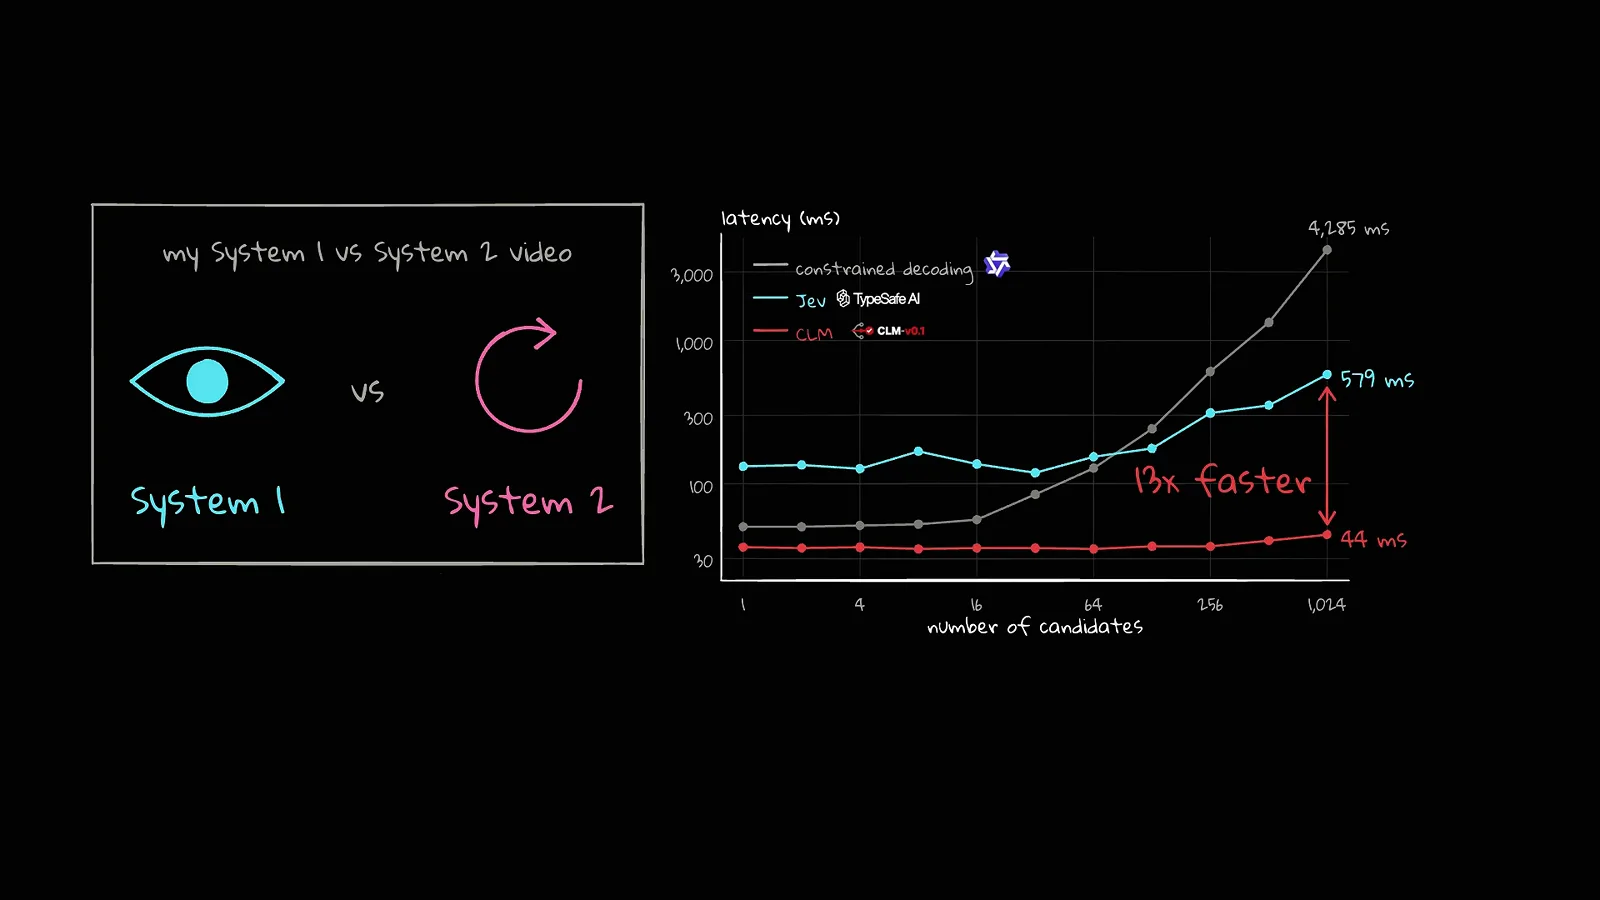
候选数几乎撬不动 CLM 的线:1,024 个候选时 Jev 要 570 毫秒,它只要 44 毫秒。跳转至 6:25 - 6
代价:state 永远看不到候选列表
所有双塔设计的经典代价,视频没有藏。因为 state 是单独编码的,它永远看不到选项——不能把候选摆在一起并排比较,每个候选都孤立地对着一个它无法回看的态势向量打分。选项彼此差异明显时(jump 对 run right)这没问题;选项彼此雷同时(三个描述几乎一样的 refund 工具),孤立评判恰恰是最糟的比较方式。这一条架构性质就是下面 1,080 工具实验里准确率崩落的根因,所以抓住它:让打分变便宜的那个设计,同时也让比较变得不可能。
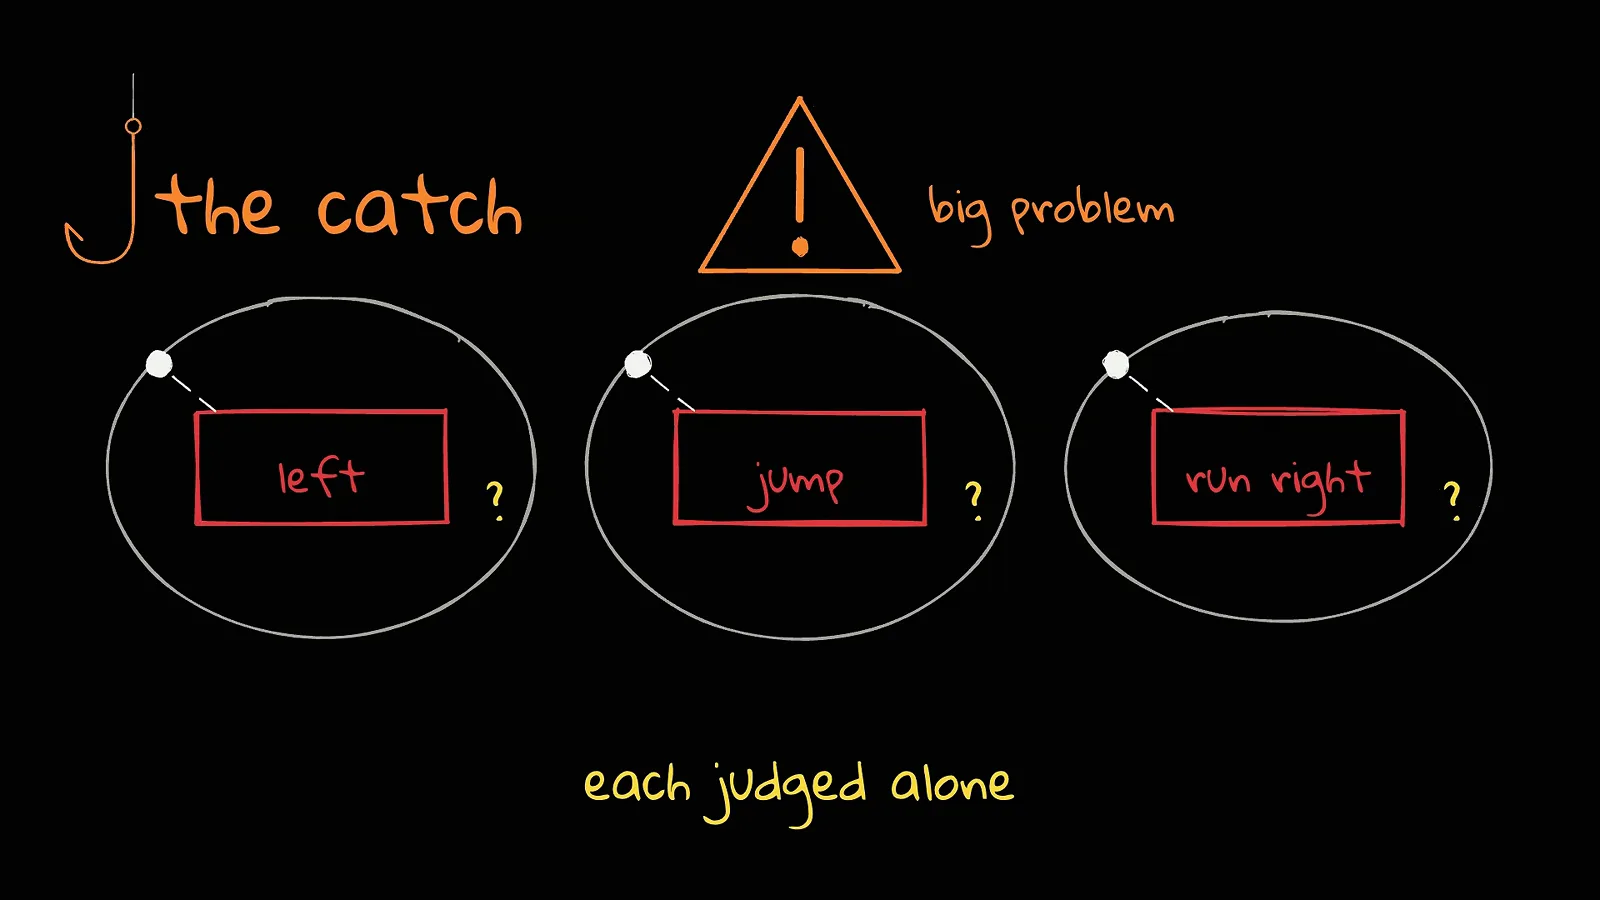
每个选项孤立打分——永远没有并排比较。这张图请记到第 13 步。跳转至 7:01 - 7
三阶段训练——顺序本身就是设计
为什么不是随便抓一个嵌入模型就用?因为「相似」不等于「正确」:拿裸的 Qwen3-8B 嵌入问「谁写了《罗密欧与朱丽叶》」,莎士比亚排不到第一——视频 demo 里克里斯托弗·马洛以 23.9% 排第一,莎士比亚 22.2% 第二(理论页那张片子里他甚至排第三)。CLM 靠三阶段对比训练走到「正确」。第一阶段:NVIDIA Nemotron 数据的 6,000 万条 QA 对——问题是 state,答案是动作——学世界知识。第二阶段:Gemini 生成的 3,000 万条难负样本(hard negatives)——听着对但错的答案,比如离太阳最近的行星填金星而不是水星——教会模型「听着对」和「是对的」的区别。顺序是承重墙:难负样本测试上,仅预训练 52%,预训练后再加难负样本阶段跳到 69%;但从第一天就混进难负样本,只到 62% 然后过拟合。第三阶段把它变成 agent:约 100 万步真实 agent 轨迹,混回 40% 的原始 QA 数据;没有这份回掺,难负样本分数从 69 掉到 56。
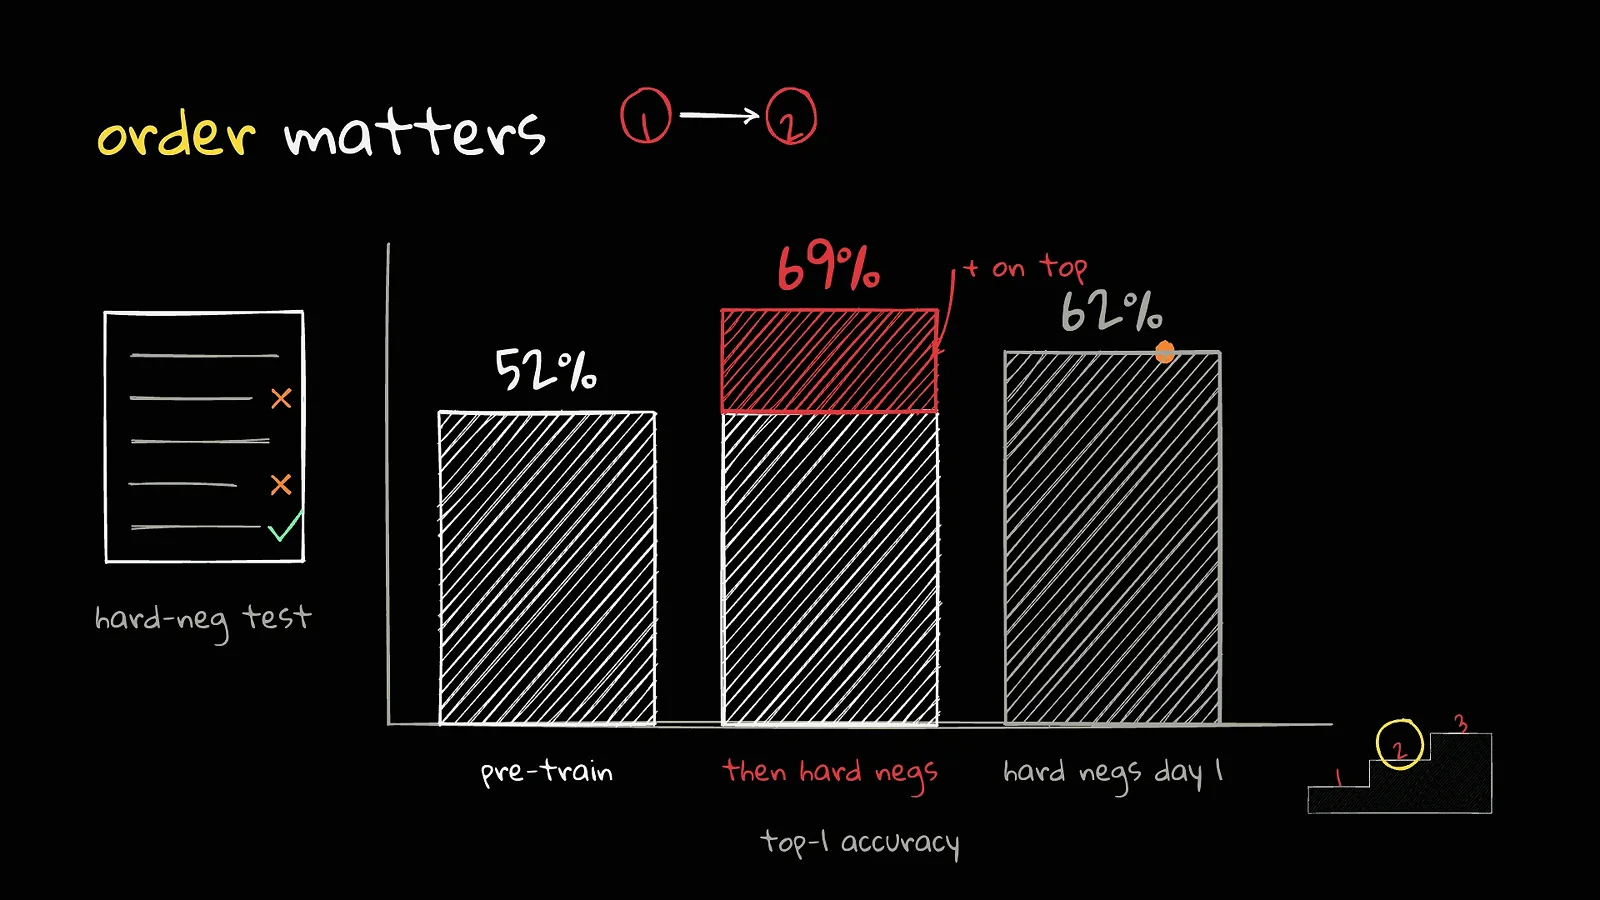
先学世界、再学细分:52%→69%——顺序反过来就是 62% 加过拟合。跳转至 8:27 - 8
骨干冻结:真正训练的只有约 4,000 万参数
视频作者自己都被这部分惊到:这个 80 亿参数的模型是冻结的。骨干就是拿来当阅读器的 Qwen3-8B——它只收一个梯度,卡面上直接写「just a reader」加一把锁。真正训练的只有两个小头,塔的两侧各约 2,000 万参数。因为骨干永不改变,整个数据集只需嵌入一次,之后全量预训练跑一遍只要单卡 RTX 4090 约 1 小时——对一个 8B 级的模型来说近乎离谱。损失对算力、数据、头尺寸、编码器尺寸都呈幂律(图中编码器尺寸的指数是 -0.172),其中编码器尺寸的收益最大——这正是团队说下一个更大骨干的原因。一条时效注记:截至这支视频(2026-09-26),放出的模型只有文本版,35B 多模态版宣称「下月初」来——引用前先去官方仓库核实。
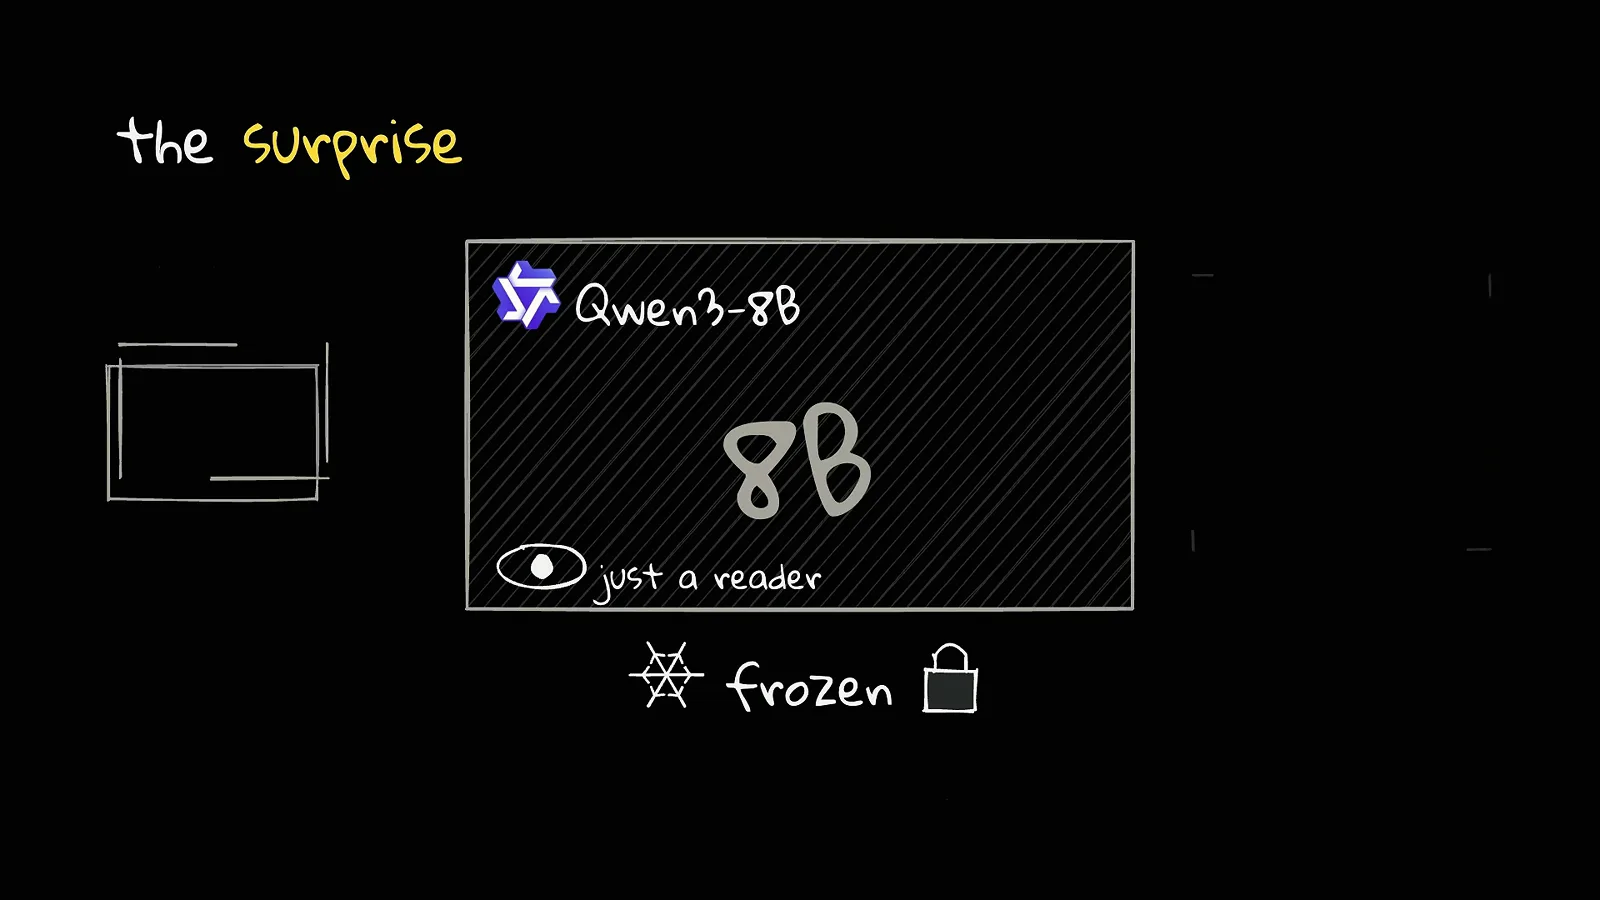
8B 阅读器永不更新——只有两个约 2,000 万参数的头在训练,所以预训练在 4090 上重跑只要约 1 小时。跳转至 9:21 - 9
上手:一块 DGX Spark 跑通全栈
下半场所有 demo 都跑在一块 DGX Spark(GB10)上。分层蛋糕:Qwen3-8B 编码器走 vLLM serve——终端里 vllm/vllm-openai 容器已经跑了 26 小时——上面坐团队实际发布的 CLM server。server 本体约 75MB,整套东西占约 25GB 内存。第一个 demo 喂进一条客服工单——客户被重复扣费还找不到人——一次调用里问三个类型化问题:急不急?哪个团队接?客户多沮丧?每个答案都以概率返回:urgent 84%(读数 83.7%)、billing 99%、frustration「very angry」。而这张工单见过一次之后再问,2 毫秒内返回——模型延迟 0.8 毫秒、往返 9 毫秒、encoder_tokens 0——因为什么都没重新编码,选项向量全在缓存里。
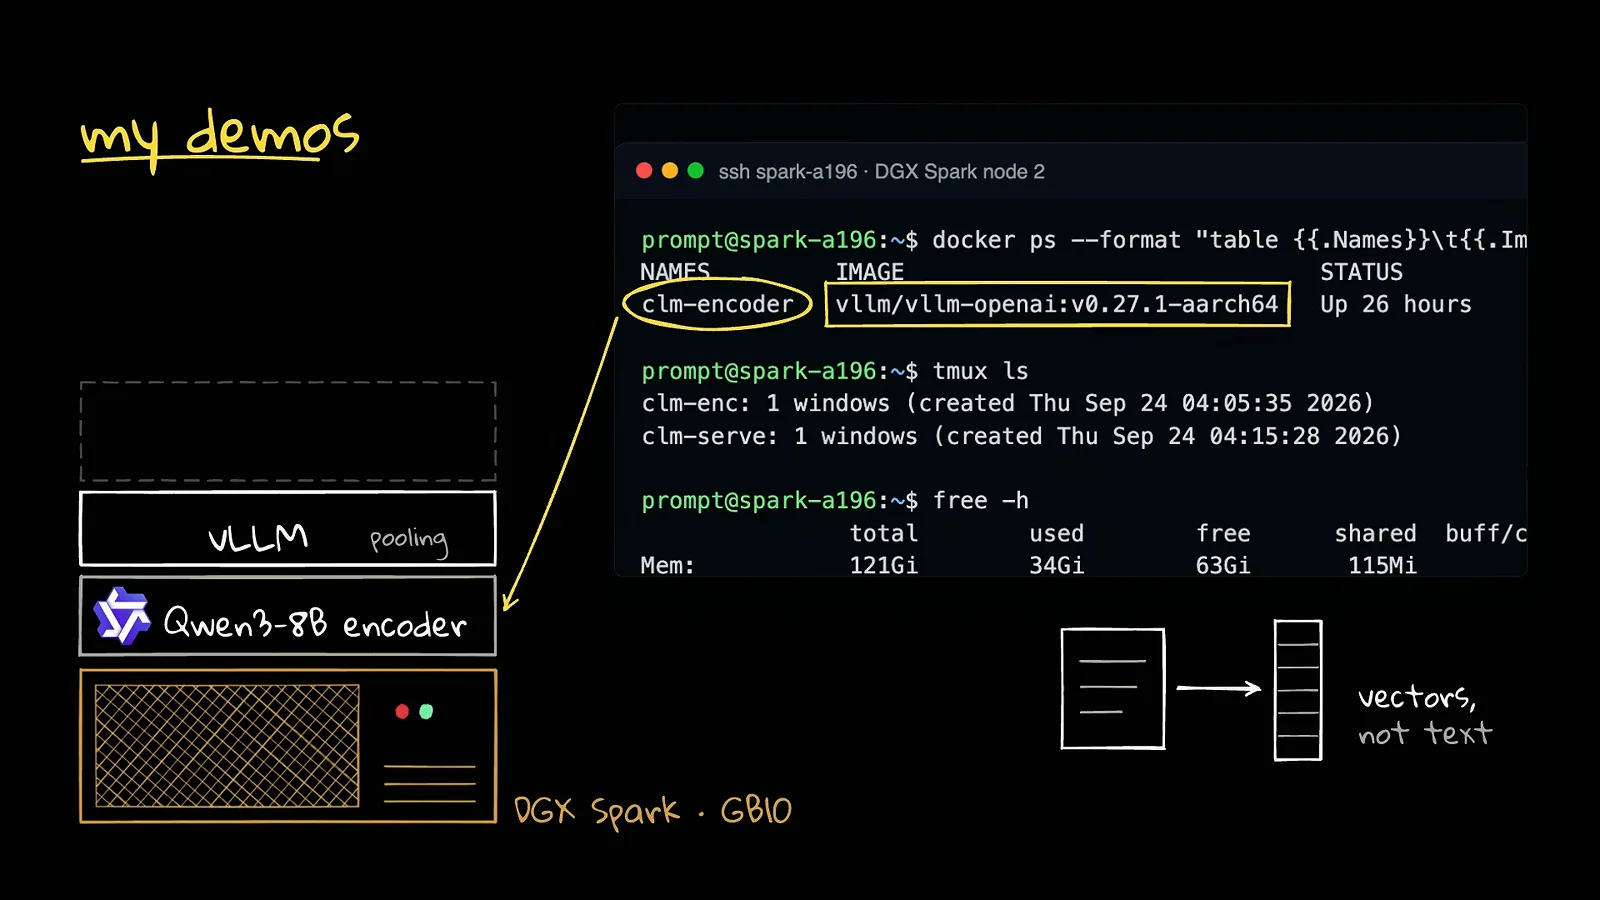
vLLM 服务冻结的编码器;上面约 75MB 的 CLM server 消费的是向量,不是文本。跳转至 10:10 - 10
亲眼看 20M 参数把莎士比亚从 22% 抬到 98.2%
「谁写了《罗密欧与朱丽叶》」这道题回来做了一次架构的现场 A/B:同一个编码器、同一份候选——唯一的差别是顶上那个小头。裸 Qwen3-8B 嵌入:马洛第一(23.9%),莎士比亚第二(22.2%)——听着都挺像作者的候选,答案是错的。切到训练过的 CLM 头:莎士比亚直接跳到 98.2%、稳坐第一。这就是约 2,000 万训练参数做到的事:把嵌入空间从「相似」重塑成「正确」——第 7 步那些难负样本阶段买的就是这个。它也是最干净的一帧反驳,回应「我们不是早就有嵌入模型了吗」:普通检索找到的是相似的东西,对比训练出来的决策头找到的是对的那个。
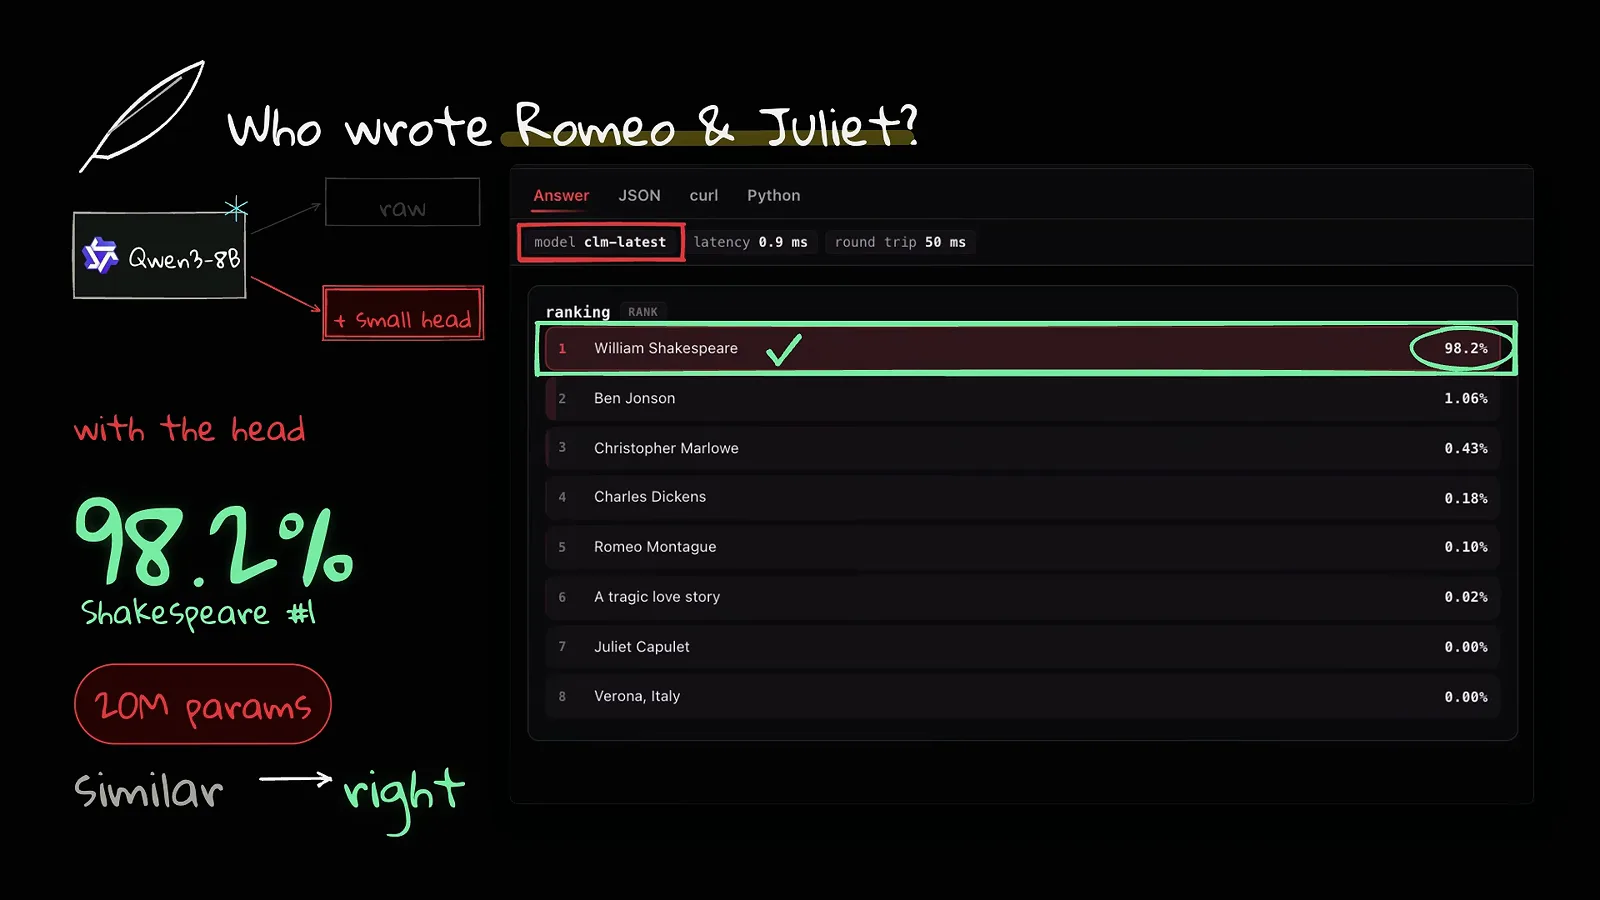
同编码器、同候选——2,000 万训练参数把「相似」变成「正确」(莎士比亚 98.2%)。跳转至 11:37 - 11
给 1,080 个工具做路由——Jev 连一次调用都塞不下
接下来是架构的表演时刻。作者自建了一份 1,080 个工具的清单——Stripe、Twilio、QuickBooks、Zoom 等——用来给请求做路由。这里有两件事。第一,Jev 物理上接不了这张列表:Jev 的 choice 调用上限 255 个选项,1,080 个怎么切都塞不进一次调用。第二,CLM 轻松吃下:第一次请求花了几秒(卡面 6,788 毫秒),因为模型把每个工具各嵌一次;之后每个新请求约 80 毫秒——屏上的逐请求读数在 79 到 84 毫秒之间。视频还给出一张计时表:进了缓存之后,从 1 个工具里挑和从 1,024 个工具里挑耗时基本一样——热列里 0.5 毫秒对 2.9 毫秒。嵌一次,之后选项数量在延迟账单上就是个舍入误差。
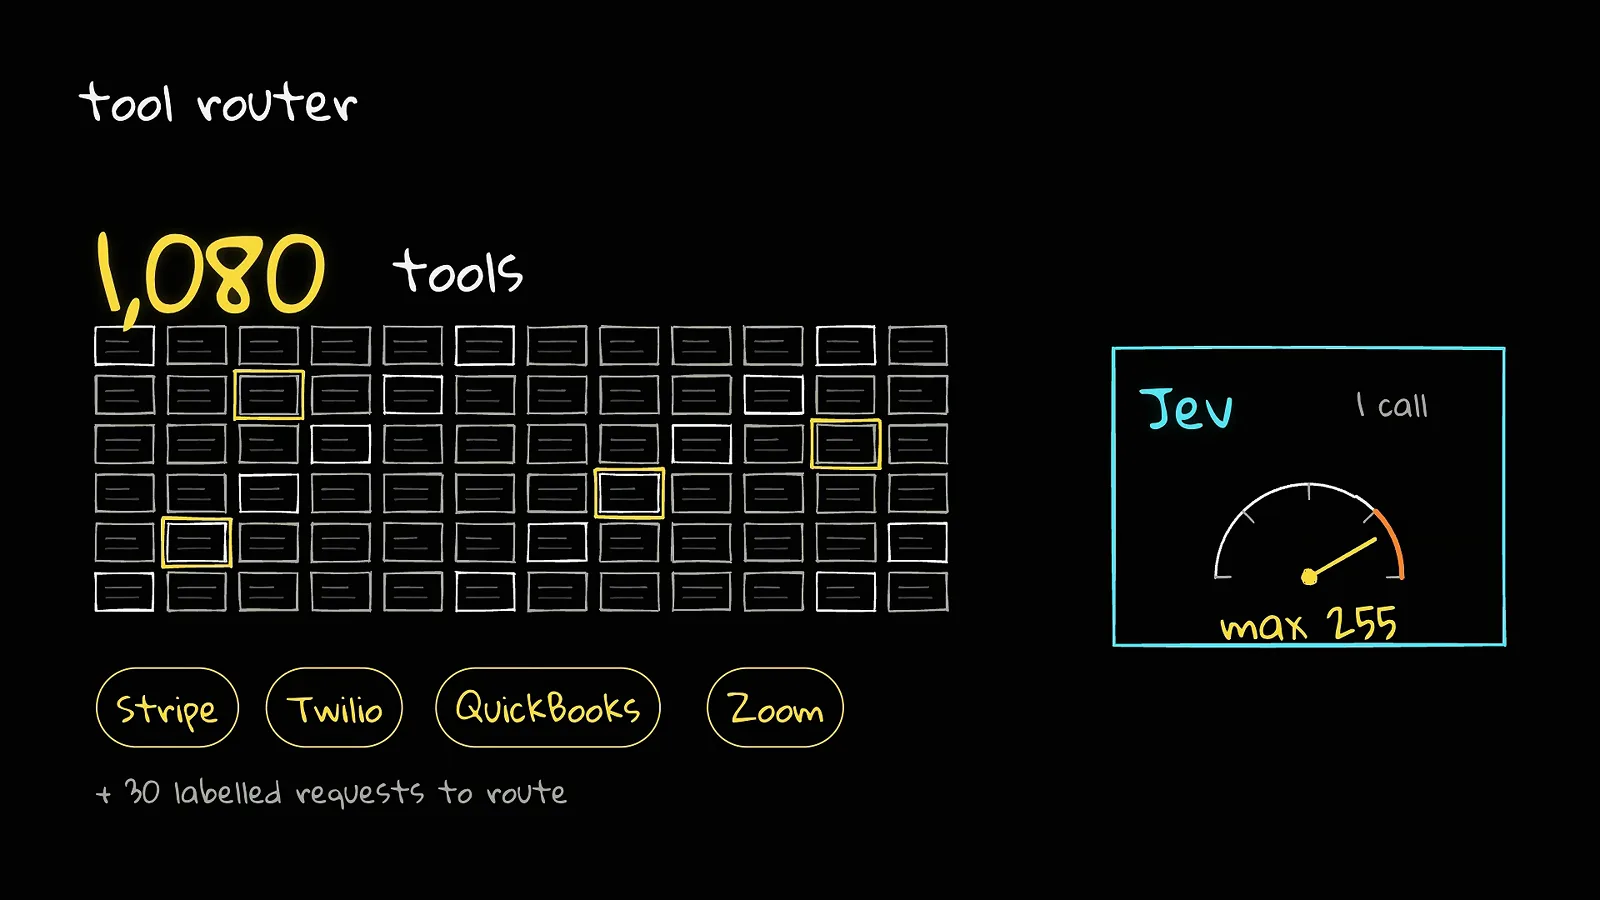
一张 1,080 个工具的清单——超出 Jev 255 上限,对 CLM 只是一次嵌入的事。跳转至 11:53 - 12
WikiRace 复刻:一次给 934 条链接打分,4 次点击到达
最好玩的一个。WikiRace 的 demo 代码没有公开,作者自己重建了一个:从一个维基页面出发,只靠点链接抵达目标页。从板块构造(Plate tectonics)到生物发光(Bioluminescence),CLM 把当前页的每一条链接都朝目标打一次分——首屏 934 条链接 84 毫秒排完,Biosphere 以 27.2% 居首,Abiogenesis 16.7%、Biogeochemical cycle 13.0%。策略是贪心、无前瞻(上限 15 次点击):选最高分,重扫,重复。这场用了 4 次点击——板块构造 → Biosphere → Biota (ecology) → Plankton → 生物发光——团队官方 demo 约为 6 次。但卡片也要诚实地读:页眉那一排五场比赛里,只有这一场赢了——Chess→Volcano、Jazz→Photosynthesis、Pizza→Albert Einstein、Tokyo→Penguin 全部失败。有的局它稳赢,有的局它晃出去,原因和下一步的双塔是同一个。
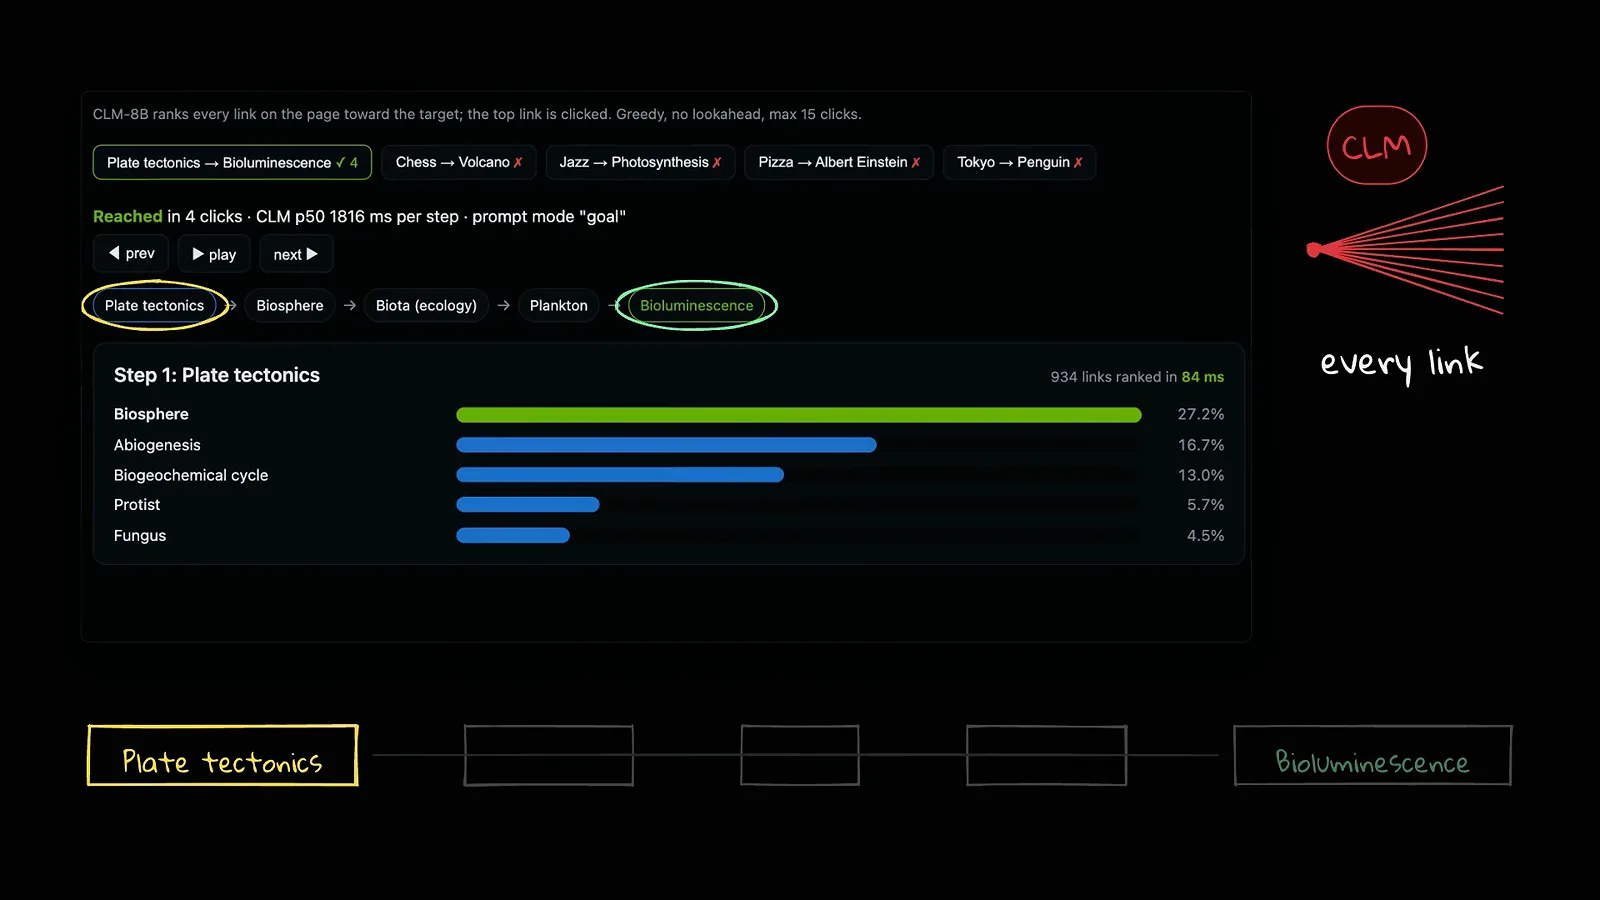
一次给全部链接打分——934 条 84 毫秒——贪心点击器 4 跳抵达(五场唯一赢的一场)。跳转至 12:41 - 13
诚实数字:8 个工具 86%,1,080 个工具 17%
漂亮扩展的是算力账;不漂亮的是准确率账。8 个工具里选,CLM 86% 选对(创作者实测 90 次里 top-1 对 77)。换全部 1,080 个工具,掉到 17%(30 次里对 5)——主要是同音工具互相混淆:refund (Stripe)、refund (QuickBooks)、refund (PayPal)。WikiRace 卡片说的是同一件事:有的局稳赢,有的局晃出去。这就是第 6 步那个 catch 在实测里的样子:每个选项孤立编码,模型永远无法并排比较,长得像的选项在任何速度下都分不开。视频给的建议就是本页的 takeaway:别给 agent 一千个工具——按子 agent 拆小工具集。今天用 CLM 的正确姿势是当第一级:毫秒级把上千候选砍到 top 10,再交给能并排读选项的模型——System 2——做终审。动作集本来就小而稳定(游戏循环、固定路由)的话,直接用效果就很好。以及本页所有数字的长期脚注:这些是视频创作者在自己 demo 上的实测,不是独立基准。
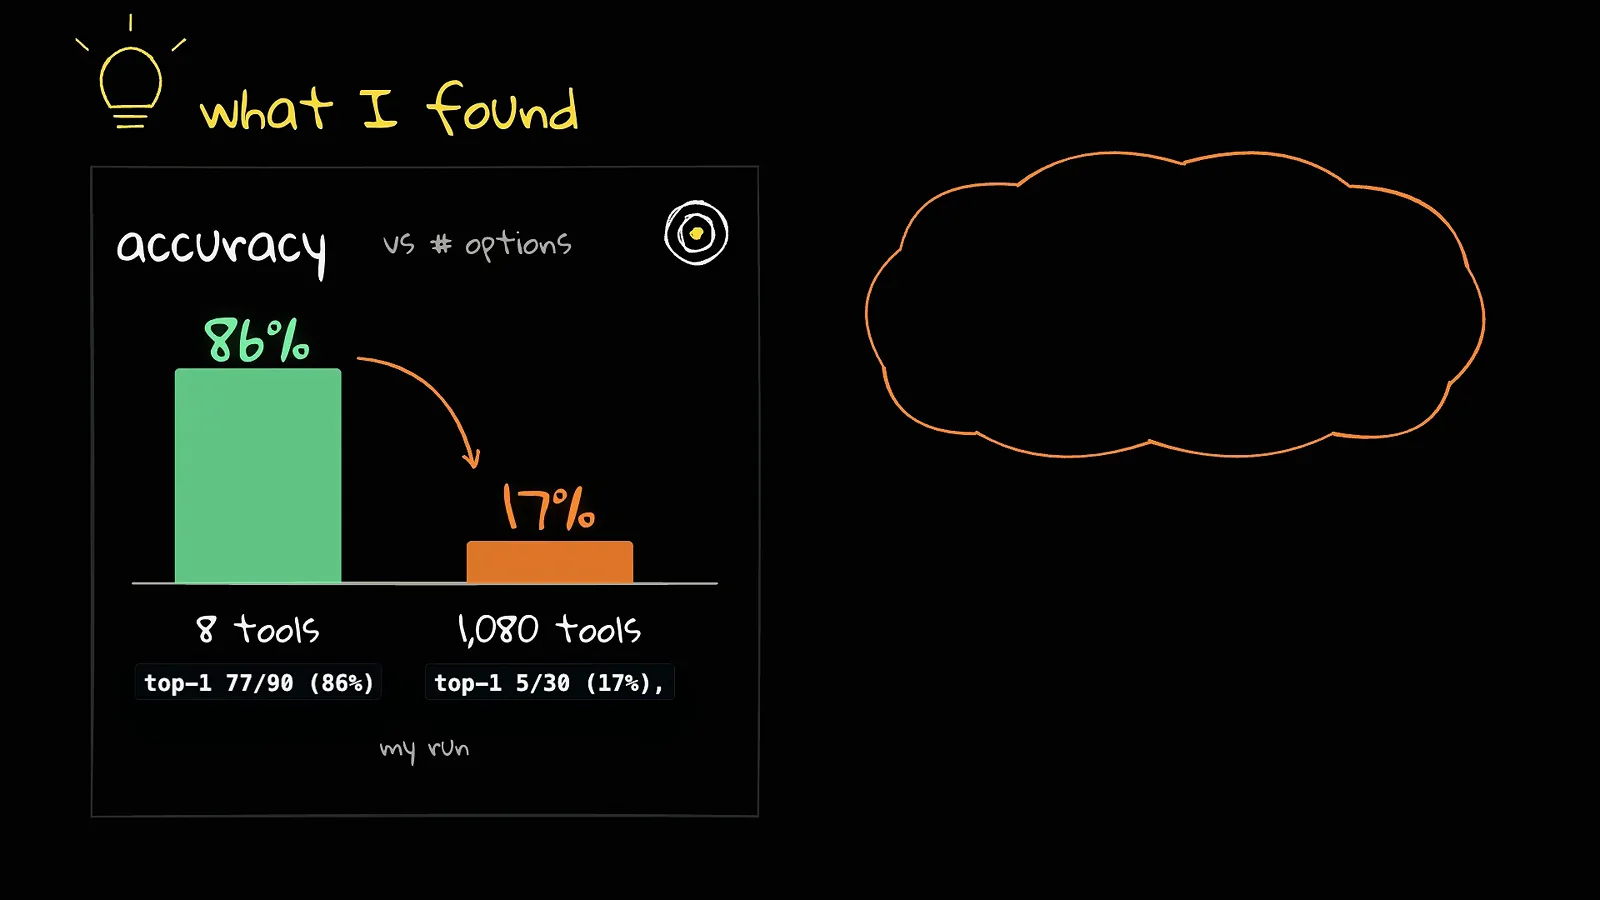
延迟会扩展,准确率不会:工具列表放大 135 倍,86% 跌到 17%。跳转至 13:41
常见问题(FAQ)
CLM-8B 是什么?
CLM-8B(发布名 CLM-v0.1)是斯坦福 + NVIDIA Research 团队打造的 Contrastive Language Model(对比语言模型):一个 80 亿参数的模型,Qwen3-8B 骨干被冻结、纯粹当阅读器用,真正训练的是两个各约 2,000 万参数的小头,它们把态势和候选动作嵌入同一个共享空间。做决策 = 嵌入态势、嵌入每个选项、按距离选——视频的说法是「CLIP,但用在决策上」。官方宣称至多比 Jev 快 9 倍、精度持平。时效注记:截至视频(2026-09-26)只有文本版,官方仓库名与宣称的 35B 多模态后续版本,引用前请先到项目页复核。
CLM-8B 和 Jev 到底差在哪?
API 形状完全相同:对 state 加封闭候选列表提 yes/no、多选、打分三类问题,承诺与 fine print 也同款——永远不会发明列表外答案,但可能自信地选错列表内答案。底下的引擎完全是两回事。Jev 式模型把 state 和所有选项一起读入、用约束解码逐 token 写出答案,延迟随选项数增长(视频曲线上 1,024 个选项 570 毫秒;普通约束解码 LM 4,185 毫秒),而且 Jev 单次 choice 调用上限 255 个选项。CLM-8B 把选项嵌一次、缓存、点积打分——1,024 个选项 44 毫秒,约 13 倍快。代价是:Jev 的解码器答题时能看到所有选项并排摆着;CLM 对每个选项孤立评判,这就是它在相似候选上准确率崩掉的根源。
CLM 为什么比 Jev 快?
因为它把决策变成了检索。选项嵌入一次就缓存,之后每个新步骤只花一次 state 编码加每选项一次点积,而点积约等于免费计算。agent 循环里动作列表很少变,所以最贵的部分只付一次、永久摊销。视频的马里奥 demo 里,这把每步五次前向传播降成一次;延迟曲线上候选数从 1 涨到 1,024,CLM 的线只从几十毫秒挪到 44 毫秒——约束解码爬到 4,185 毫秒、Jev 到 570 毫秒。选项数量从主要成本变成了舍入误差。
本地跑 CLM-8B 需要什么?
视频把全部东西跑在一块 DGX Spark(GB10)上:冻结的 Qwen3-8B 编码器走 vLLM serve,上面坐团队发布的 CLM server——server 本体约 75MB,全栈约 25GB 内存。因为选项向量有缓存,见过的 state 复问 2 毫秒内返回(模型延迟 0.8 毫秒、往返 9 毫秒、零 token 重新编码)。训练门槛同样不高:骨干不变意味着数据集只嵌一次,全量预训练单卡 RTX 4090 约 1 小时——始终只有两个约 2,000 万参数的头在更新。
选项列表变大之后,13 倍速度还成立吗?
延迟成立,准确率不成立。给 1,080 个工具打分和给 1 个工具打分耗时基本一样(视频表格热列 0.5 毫秒对 2.9 毫秒),但 top-1 准确率从 8 个工具的 86%(77/90)掉到 1,080 个工具的 17%(5/30)——主要是听上去一样的工具互相混淆,比如三个不同的「refund」端点。原因是架构性的:state 编码时看不到选项,任何东西都不会被并排比较。视频的建议:别给 agent 一千个工具——按子 agent 拆小工具集,把 CLM 当毫秒级第一级,砍到 top 10 之后交由能并排读选项的 System 2 模型终审。动作集小而稳定(游戏循环、固定路由)的场景可以直接用。
对比决策模型(对比语言模型)是什么?
一种用「拉近-推远」目标而不是逐 token 预测训练出来的模型:每条训练样本是一个态势加一个当事人实际采取的动作,模型学着把态势放到它自己的动作旁边、离其他所有动作远远的。负样本是免费的——1,000 条一批里其余 999 个动作都属于别的态势——真正难的是 3,000 万条 Gemini 生成的难负样本:听着对但错的答案(金星对水星),它们教会模型区分「听着对」和「是对的」。这与 CPC/InfoNCE、SimCLR、CLIP 是同一支对比学习谱系,只是这次用在了决策上——所以视频把它讲成一门老手艺(2017-2018 年火过的对比学习)在 System 1 模型里回魂。
相关推荐
Nox 4B 实测:vLLM Decision 2.0 家族
另一家快速决策模型押注的四场景实测——本页是单模型架构深潜,那一篇是动手横评。
阅读Clef-Flash 本地安装与运行
又一个 Jev 同形决策模型,按 Ubuntu 从零安装轴讲,还带多模态图像 demo——那边是安装轴,本页是架构轴。
阅读Jev 开源模型:开放权重全景
20-30 个复现模型的全景横评。先看广度,再来本页看唯一一个跳出 LM 解码范式的架构。
阅读Jev vs LLM:System 1 遇上 System 2
「第一级砍候选、终审交 System 2」这套模式背后的概念页——CLM-8B 把它推到了极限。
阅读什么时候该用 Jev(什么时候不该)
本站所有决策模型共享的适用边界指南——包括被 CLM-8B 缓存嵌入绕开的 255 选项上限。
阅读Benchmarks:我们自己的测量口径
本页所有数字都是视频创作者在自己 demo 上的实测;推荐之前我们自己如何重新测量决策模型,看这里。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
- LangChain + Jev 集成实战:路由、护栏与评测
- Jev MCP Server 接入指南:把 Jev 决策层接进 Claude Code 与 Cursor
- Jev vs Luna 独立基准实测:「更快更准更便宜」是真是假?
- Jev Agent Harness 实战:决策闸门该装在 LLM 循环的哪个位置
- Jev Playground 实测攻略:热狗课程、criteria 校准与四平台 token 账单
- Jev 文本分类 API 实战:用 classifier.dev 打通零样本 CLI 与 REST 调用
- Jev API 实战示例:第一条 curl、载荷结构与三种问题类型
- 用 Expanso Edge 和 Jev 搭建日志分流流程
- Treg + Jev 线索丰富:ICP 分类与注册用户评分
- 在 Heym 中使用 Jev 决策节点:语言判断与模型路由
- Laya 上手教程:开源自托管决策引擎的安装、路由与概率校准(Laya vs Jev 实操)
- 训练自己的 Jev:花 $5–$17 微调一个 Jev 式决策模型(能训什么、不能训什么)
- Jev 实用技巧:拿到更好决策结果的 8 条最佳实践(state、questions、criteria 与阈值)
- Jev 上下文压缩实战:不用生成式摘要,直接剪枝 Agent 记忆
- Jev 当 LLM 评审:置信度级联,只要强模型 0.36% 的成本
- TypeSafe Computer Use 实操:用 Jev 做本地桌面自动化
- Jev 简历筛选实战:Express + Jev JavaScript SDK 搭一个 AI 简历评估器
- Jev + Claude Code 实战:语音控制浏览器,类型化决策全程接管
- Jev 接入 Codex 实操:typesafe-ai/skills 安装与 Gmail 30 封邮件分诊
- Jev vs Ollama:本地跑 AI 决策,数据不出门真的可行吗?
- 自己动手造一个 Jev:免费开源零样本分类器(还能打 Doom)
- CUA-S1-Forms:706K 参数的 Jev 型表单填写模型,CPU 就能跑
- 用 Jev 做 NOC/SOC 告警分诊:规则先行、一个类型化问题、一道策略闸门
- Ollama 决策模型实测:tev1 + nimble 跑在 8GB 显卡上
- Jev 生产环境护栏:五步接入实战手册
- Pi Agent 防跑偏插件实战:让 Jev 出概率,让代码做决定
- Tev1 用例实测:50 个任务看尽本地决策模型的能力边界
- Jev 实测:官方宣称与独立复测之间的距离
- Jev 工单分类实战:after-insert hook 与计算字段两种接法
- OpenJev RLCD 实操:开源校准决策模型本地部署全指南
- Clef-Flash vs Jev 实测:把 Cloudflare 决策模型装进 Ollama(Q4_K_M)
- Clef-Flash 实操教程:在 Ubuntu 上从零安装并本地运行 Cloudflare 9B 多模态决策模型
- Nox 4B 实测教程:本地跑通 Decision 2.0 决策模型,四道真实考题与一次诚实的失败
- Julia-1 实操教程:纯 Python 装上开源 Jev 替代品,10 条客服消息实测 9 比 2
- OpenJev 0.8B CPU 实战:用工单收件箱校准 NLI 路由阈值
- Jev n8n 集成实战:JevGate 社区节点分步攻略(附纯 HTTP 备选路线)