
Guides / 视频转图文攻略
Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
基于 OpenRouter 的 Jev 上手图解:System 1 分类器、Choice/Score/Noul 三大原子类型、真实概率分布、情绪打分与多语言识别实测,输入仅 4.2 美分/百万 Token。
分步图文攻略
- 1
建立心智模型:Jev 是 System 1 分类器,而非对话模型
Typesafe AI 将 Jev 定位为与前沿推理模型相反的方向:不做自回归文本生成,而是传入 state(工单、日志、Agent trace)与一个或多个 typed 问题,返回结构化值——选中选项、数值分数或 yes/no 概率——以及归一化分布。输出 Token 免费,因为模型从不逐字生成 prose。
Jev 将软件决策映射为对非结构化 state 的 typed 提问——无需聊天界面。跳转至 3:05 - 2
选对原子类型:Choice、Score 或 Noul
Choice 从枚举选项中选一类(语言检测、团队路由)。Score 在你定义的刻度上打分(情绪 0–2、严重度 1–5)。Noul 返回 yes/no 命题为真的校准概率——适合「是否申请退款」「是否紧急」「是否违规」等门禁。多个问题可在普通代码中组合;业务规则变更时改常量即可,不必重写 Prompt。
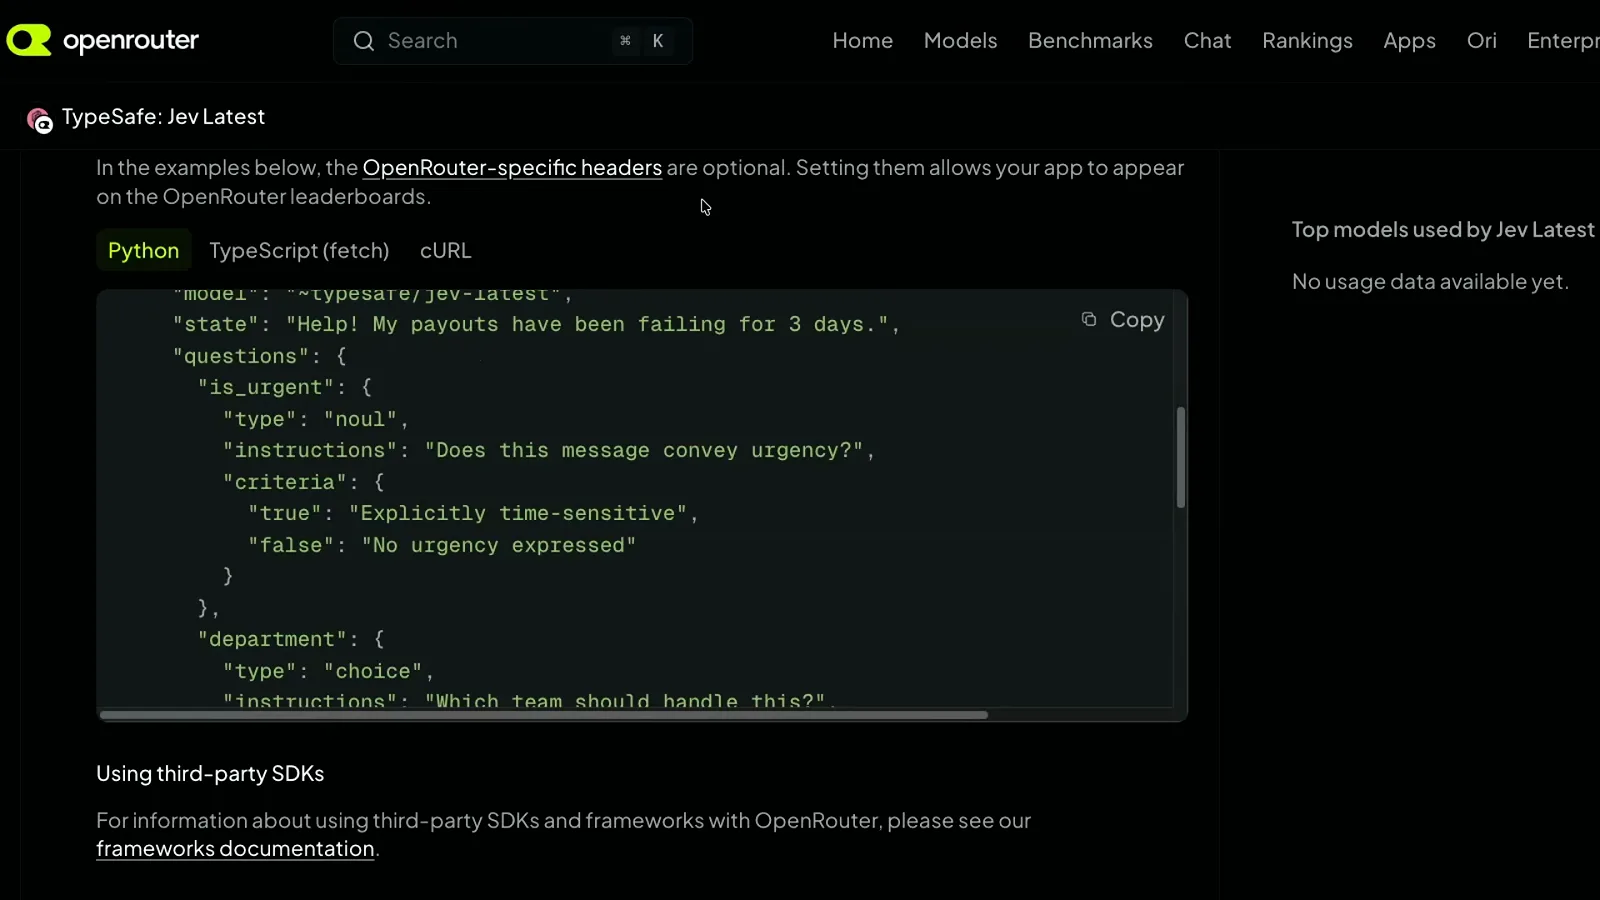
Choice 演示:五类语言标签及每项概率与综合置信度。跳转至 5:20 - 3
运行情绪 Score 并观察边界样本的置信度变化
现场 Demo 中,0–2 刻度的 Score 对明显正面文本返回 2/2,负面返回 0/2,混合语气返回中间值。单次调用约 $0.000014,足以串联数十次微分类。模糊输入时置信度下降,提示应转人工而非自动执行。
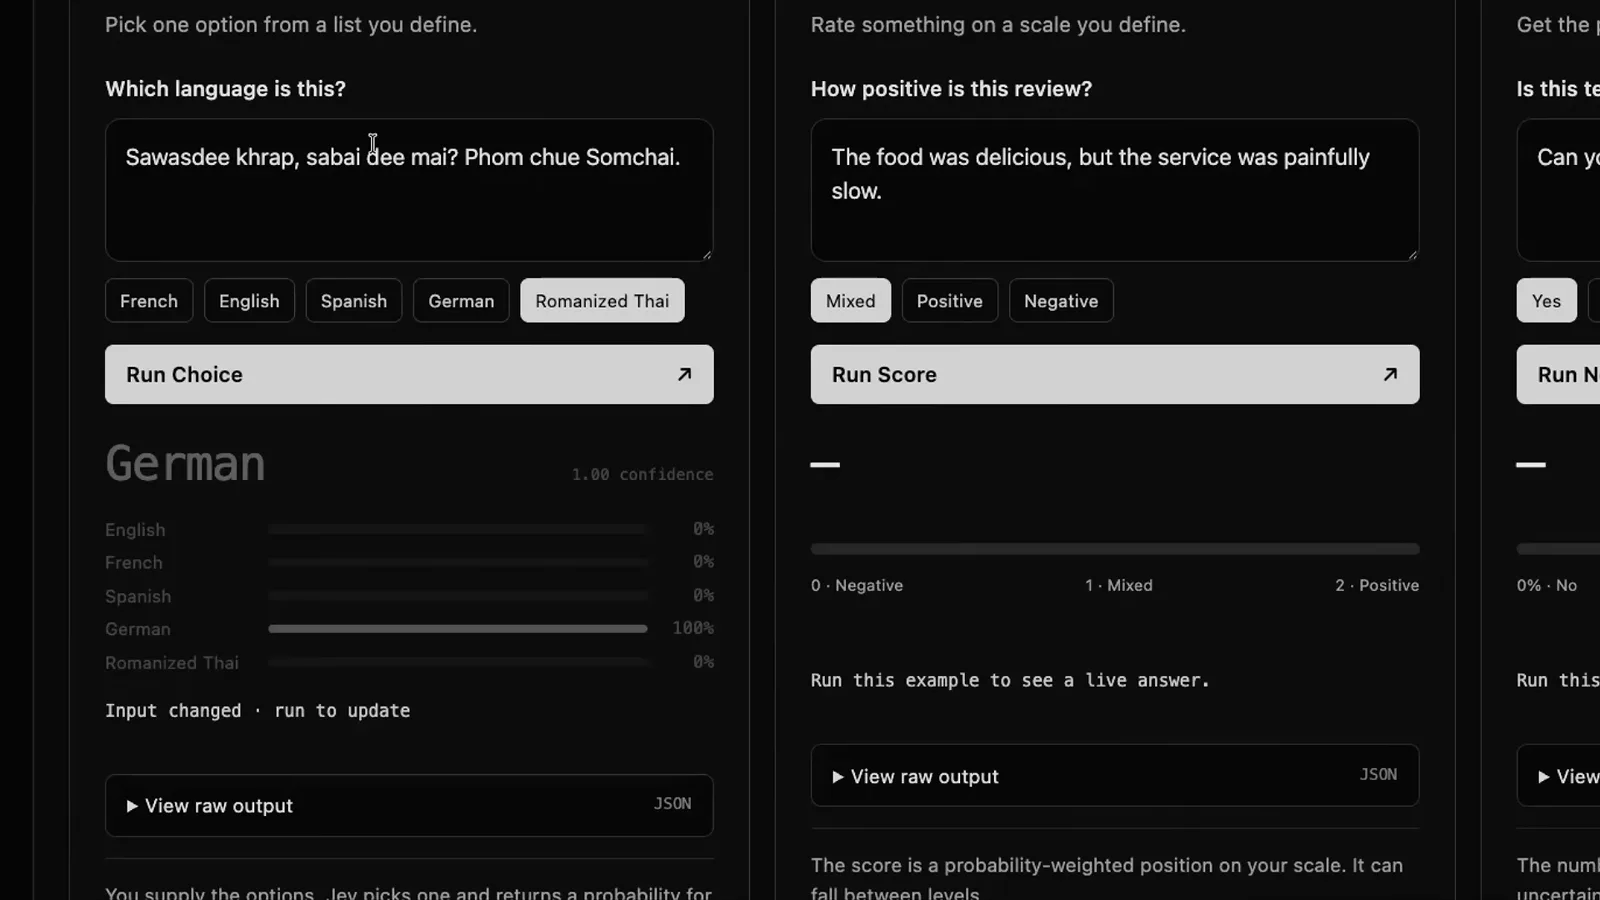
Score 原语:0–2 情绪刻度,置信度随输入歧义度变化。跳转至 6:15 - 4
解析 API 响应:真实概率,而非 JSON 里的假数字
与 LLM-as-judge 输出字符 "0.9" 不同,Jev 返回原生概率张量:type、选中值、各选项 probabilities 与 confidence。Demo 涵盖多语言 Choice(含泰文)、同一工单上的并行 Noul 门禁(退款、时效),以及抗注入路由——歧义升高时模型会给出 "unclear" 类而非过度自信。
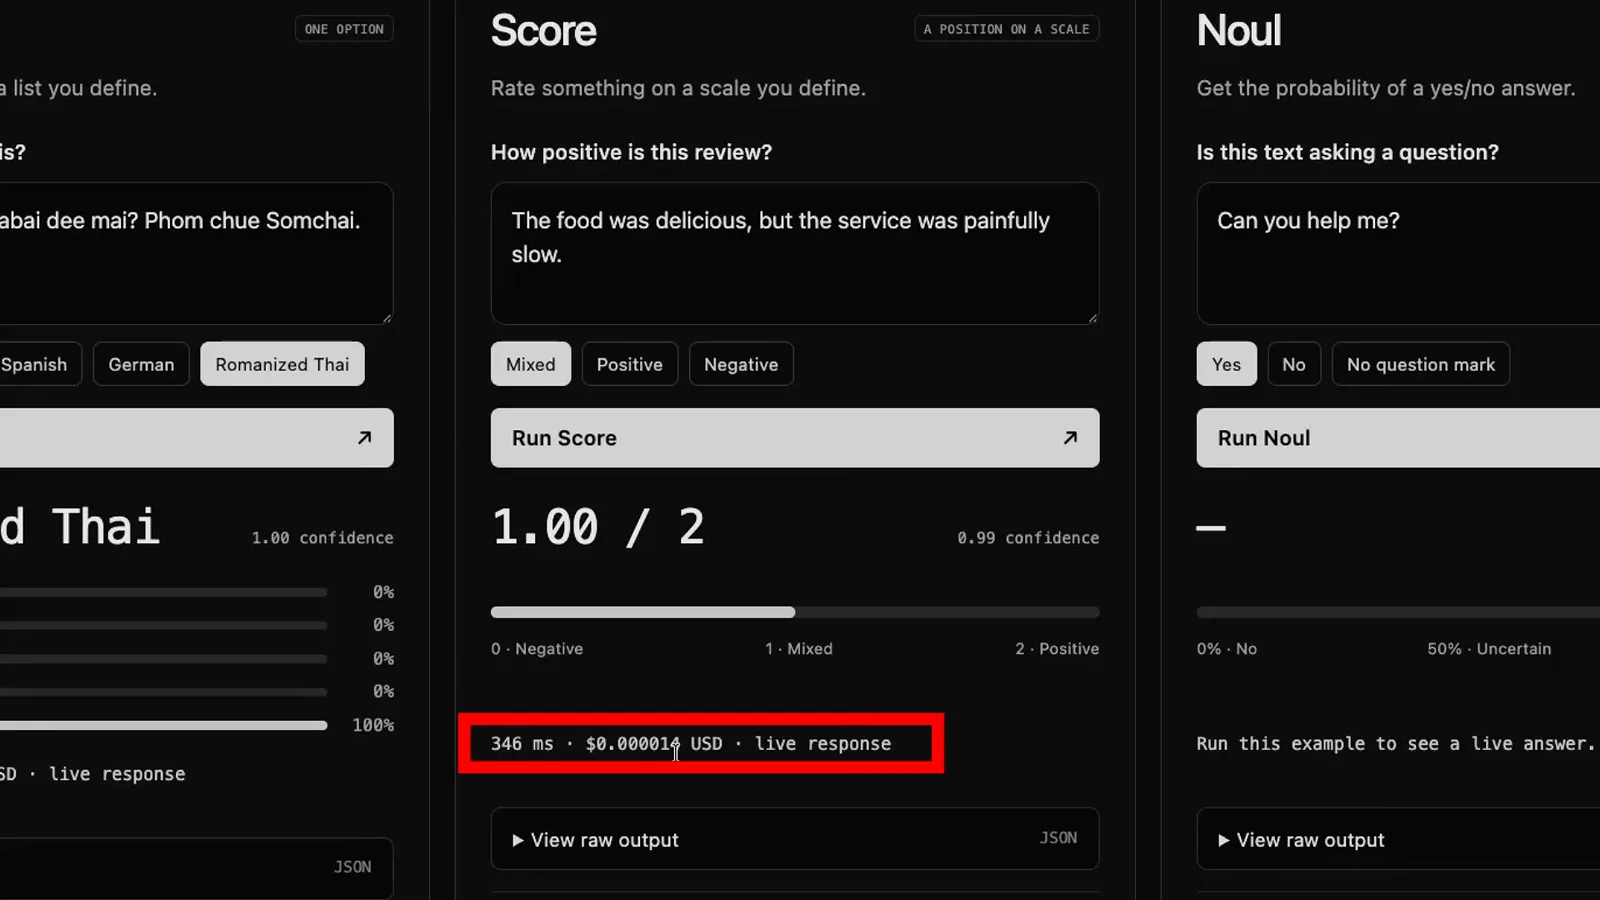
API 载荷:typed 答案 + 完整概率向量,可直接用于阈值自动化。跳转至 7:00
常见问题(FAQ)
为什么 OpenRouter 上 Jev 的输出 Token 免费?
Jev 不做自回归文本生成,前向推理直接计算分类头,因此没有可计费的输出 Token。仅对输入 state 与 question schema 的 Token 计费,单次决策通常为几分之一美分。
Jev 与让 GPT-4 返回 JSON 分类有何不同?
JSON Mode 仍逐 Token 生成,且无法提供校准不确定性。Jev 输出严格受 schema 约束,并通过 RLCD(Reinforcement Learning for Calibrated Decisions)训练得到可用作自动化阈值的概率分布。
能否对同一工单并行运行多个 Jev 问题?
可以。单次请求传入多个 Choice、Score、Noul,或在代码中编排。Demo 同时完成 billing/sales 路由、退款检测与时效判断——每个门禁暴露独立置信度,可分别设置 Fallback 规则。
更长的输入是否会提高 Jev 置信度?
Demo 中观察到:极短输入(两词)在 Noul 问题上置信度较低,更完整上下文则更稳定。设计 state 时应包含 criteria 所需的信号,但避免无关噪声稀释决策边界。