
Guides / 视频转图文攻略
OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
Sam Witteveen 用 21 分钟实测开源 Jev 生态:JevBench 排名、冻结 Qwen3.5-4B 的 Semif logits 读出、Nimble 对比数据 LoRA 配方、Decider 约 33ms 的类型化答案、DiffusionGemma 批量路由,以及在免费 Colab T4 上微调 Laya。
速览结论
Jev 走红后约 24 小时内冒出 20-30 个开源实现。在 JevBench(智力、校准、速度、成本各占 25%)上,Jev 1.13.0 拿 75.3 分,Semif(冻结的 Qwen3.5-4B)以 74.6 紧随其后——简单任务差距很小,困难档差距仍明显。零训练方案:学 Semif 直接读选项 token 的 logits;要窄域高准确率:用 Nimble 的对比数据 LoRA 配方(约 3000 条样本);追求吞吐:Decider 单次答案约 33ms、DiffusionGemma 每秒 27.4 次决策;最小本地方案:421M 参数的 Laya,免费 T4 就能微调。难样本再级联给推理模型兜底。
分步图文攻略
- 1
先看 JevBench 记分板,再挑你的开源 Jev
JevBench v1.2.2 对每个系统跑 534 次决策,按智力、校准、速度、成本各 25% 取几何平均打分。官方榜上 Jev 1.13.0 以 75.3 领跑,紧随其后的是 Semif(Qwen3.5-4B)74.6,然后是 djev(Maisa 的 diffusion-gemma)74.3 和 Laya 70.1。前沿模型则是另一番景象:GPT-5.6 Luna 的智力子项高达 97,总分却只有 66.0,成本约为 Jev 的六倍、速度也慢得多。把权重切成只看准确率,小开源模型的差距会拉大——顺便一提,Jev 自己的服务条款甚至禁止拿它与其他模型跑基准对比。
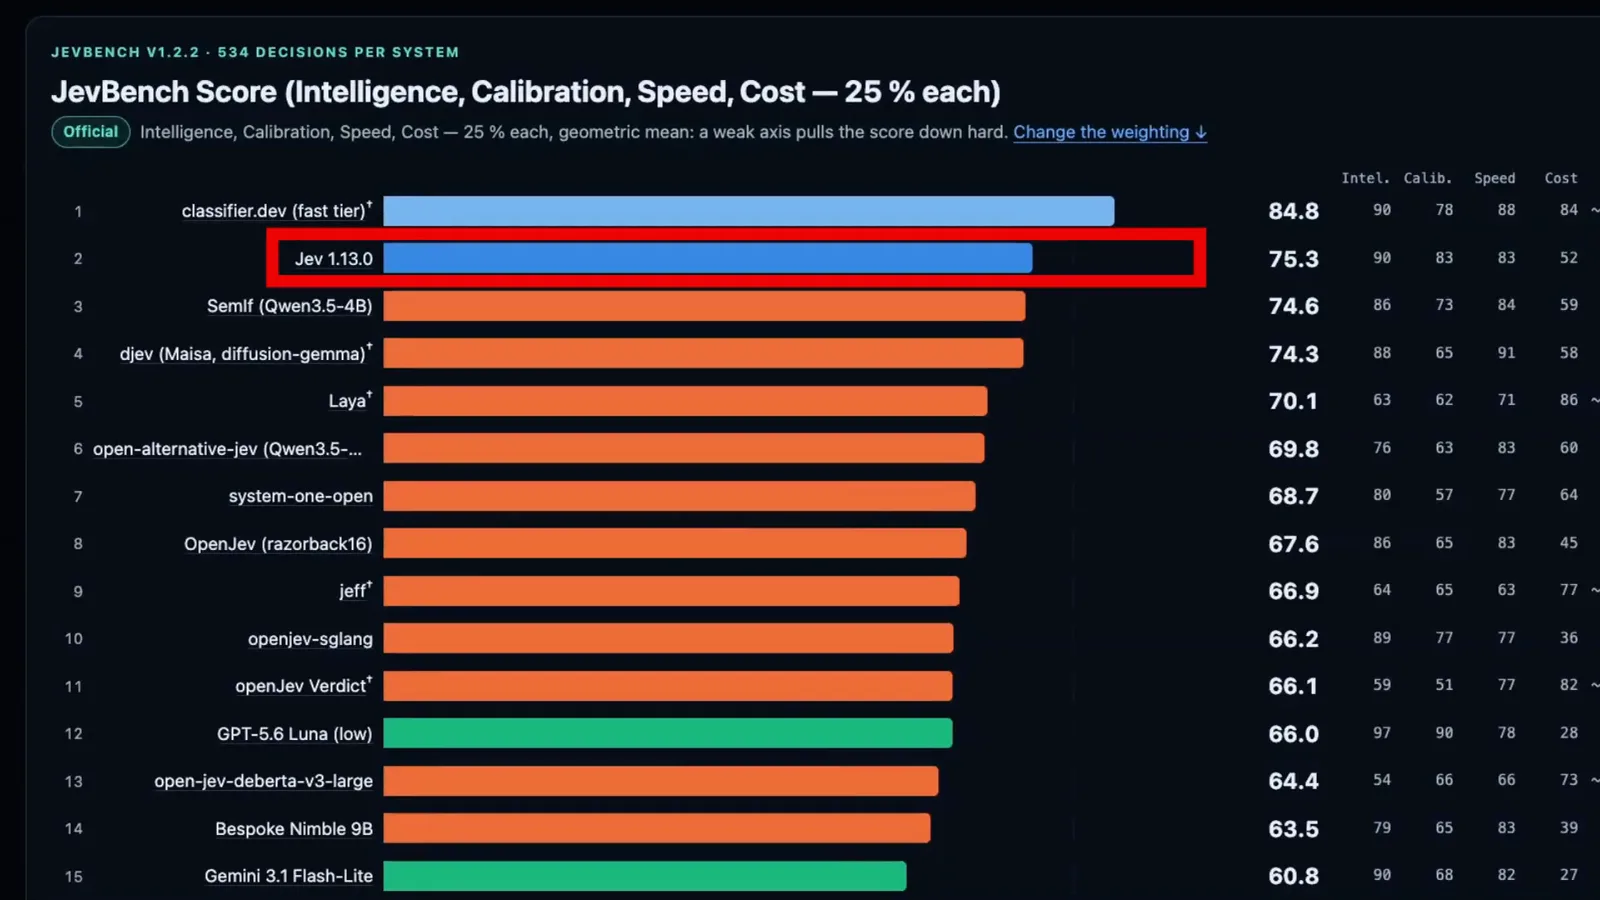
JevBench 官方榜:Jev 75.3、Semif 74.6、djev 74.3——开源阵营在综合分上咬得很紧。跳转至 4:02 - 2
零训练上手:在已有模型上跑 Semif 读出法
Semif(原名 OpenJev)就是一个冻结的 Qwen3.5-4B,完全没有训练。把问题和选项写进 prompt,跑一次 prefill,然后不让模型生成文本,直接读选项 token 的 logits 做 softmax。演示里,一张双重扣款的客服工单被打到 billing 86.7%、account_access 9.1%、sales 1.6%、escalate 2.6%——前向 31 毫秒、总耗时 35 毫秒、零输出 token、输入 209 token。Sam 指出这正印证了他对 Jev 本体的猜测:在 prefill 阶段直接做预测;改一句政策措辞,分布立刻跟着变。
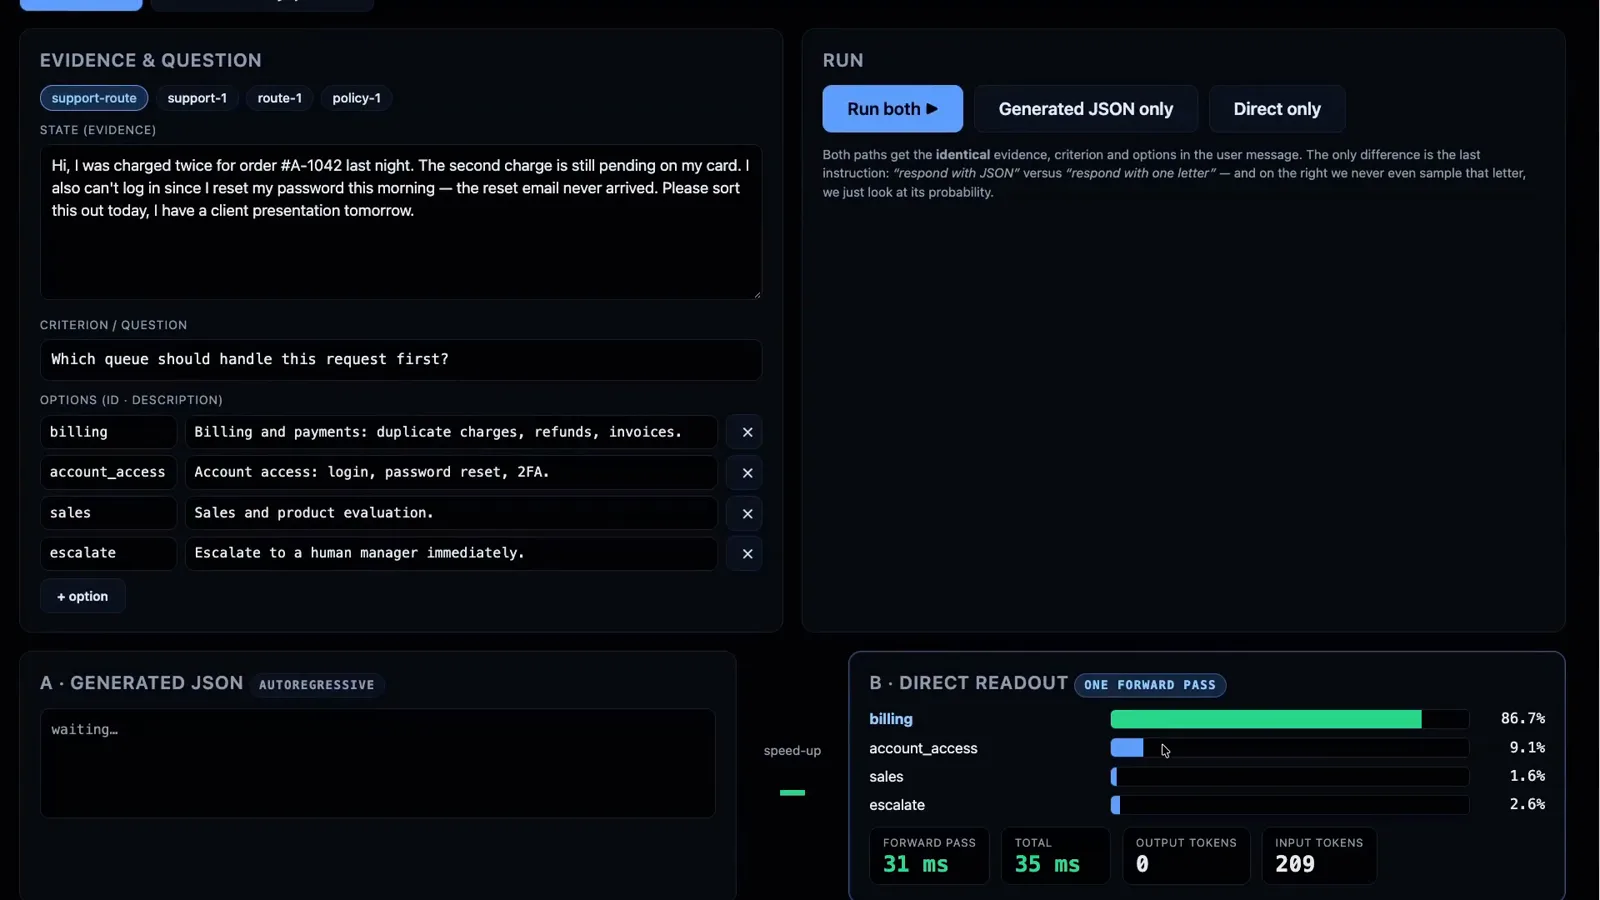
单次前向:直接从原始选项 logits 读出 billing 86.7%,无需生成。跳转至 6:16 - 3
用 Bespoke Nimble 的对比样本微调 LoRA
Bespoke Nimble 在 Qwen3.5-9B 上挂 LoRA,用不到 3000 条样本训练,并明确表示没有从 Jev 蒸馏。诀窍是对比数据策展(contrastive data curation):写两条几乎一样的记录,只翻转一个事实,让正确答案跟着翻转——退款由 Mira 签字即授权,同一记录换成 Noah 签字就不授权。演示中适配器返回 refund_authorized true、customer_tone CALM,总耗时 141 毫秒(每字段 47 毫秒),点一下 Flip the fact 按钮把 Mira 换成 Noah 就能看到判定翻转。它在自己的保留集上约 90%,基座模型约 66%,Jev 约 93%;但在 JevBench 困难档只有约 44——Priya 预审批那个例子甚至要到措辞对上才判对,所以它的强是窄域的强。
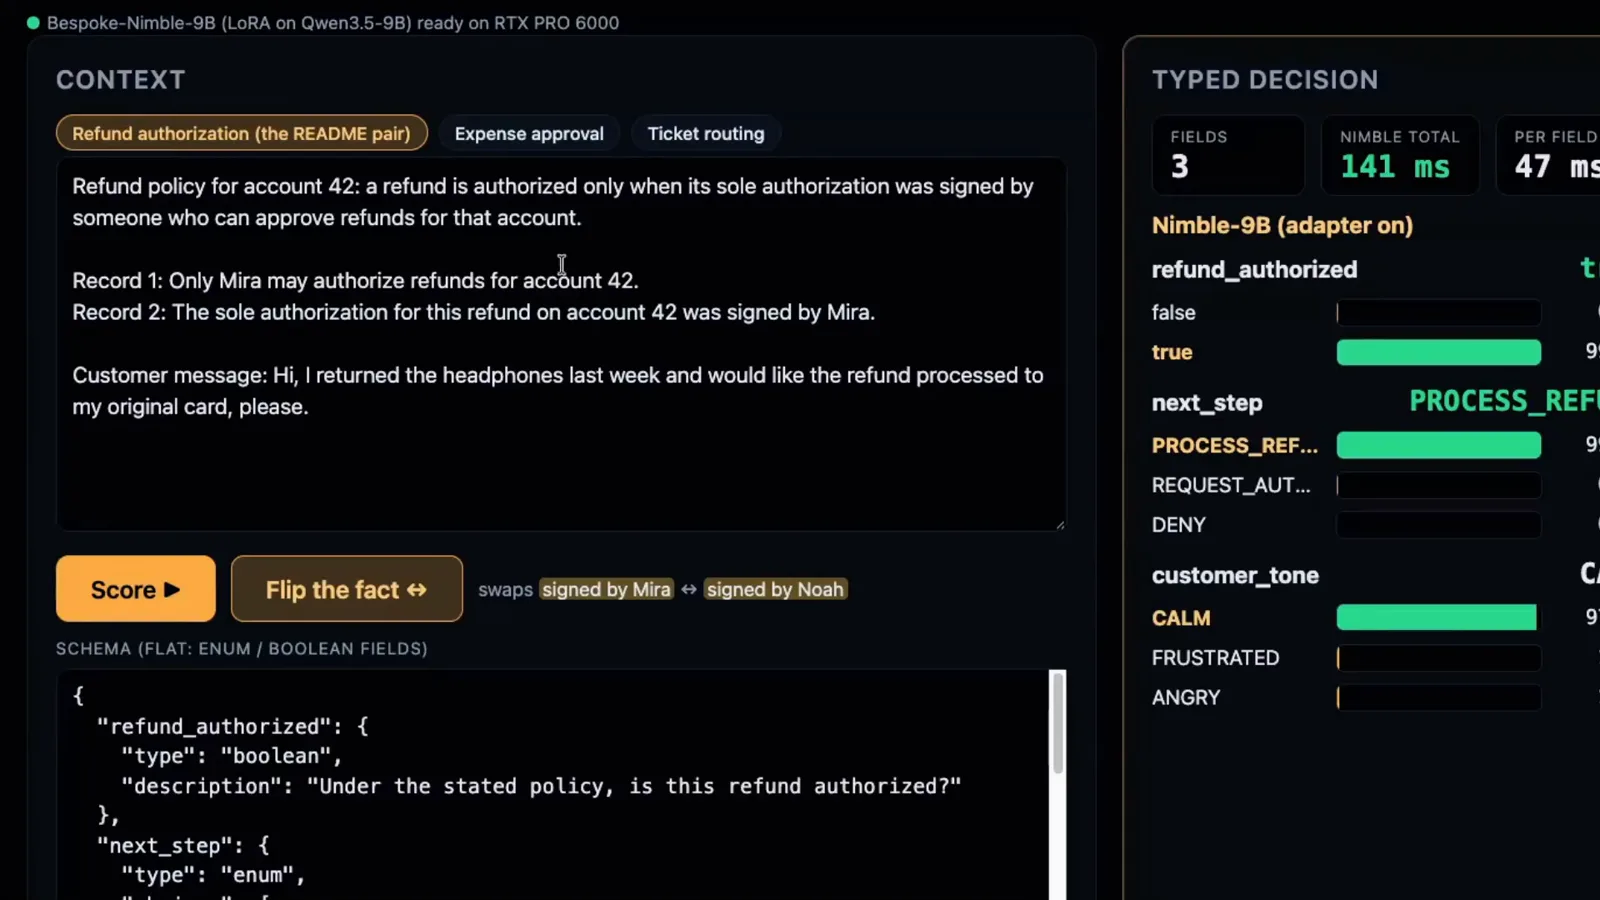
Flip the fact:把 signed-by-Mira 换成 signed-by-Noah,看判定当场翻转。跳转至 9:08 - 4
用 Decider 做约 33 毫秒的类型化速答服务
Mapika 的 Decider 跑在小得多的 Qwen3.5 base 模型上,读的是每个答案槽位的隐藏态并投影到你的选项上,而不是用输出 logits。它与 Jev 一样支持 choice、score、null 三种问题类型,上下文最长 32K,还直接对外提供与 Type Safe API 相同的 wire format,可以无缝顶到现有客户端后面。ANSWERS 面板把一张双重扣款工单判给 billing 99.8%,urgency 1.78、escalate yes 72.3%、frustration 1.52——连跑十次平均每次约 33 毫秒。Sam 的保留意见是:这个模型爱骑墙,分布常常停在中间,而 Jev 大多数时候给出高置信度的果断判定。
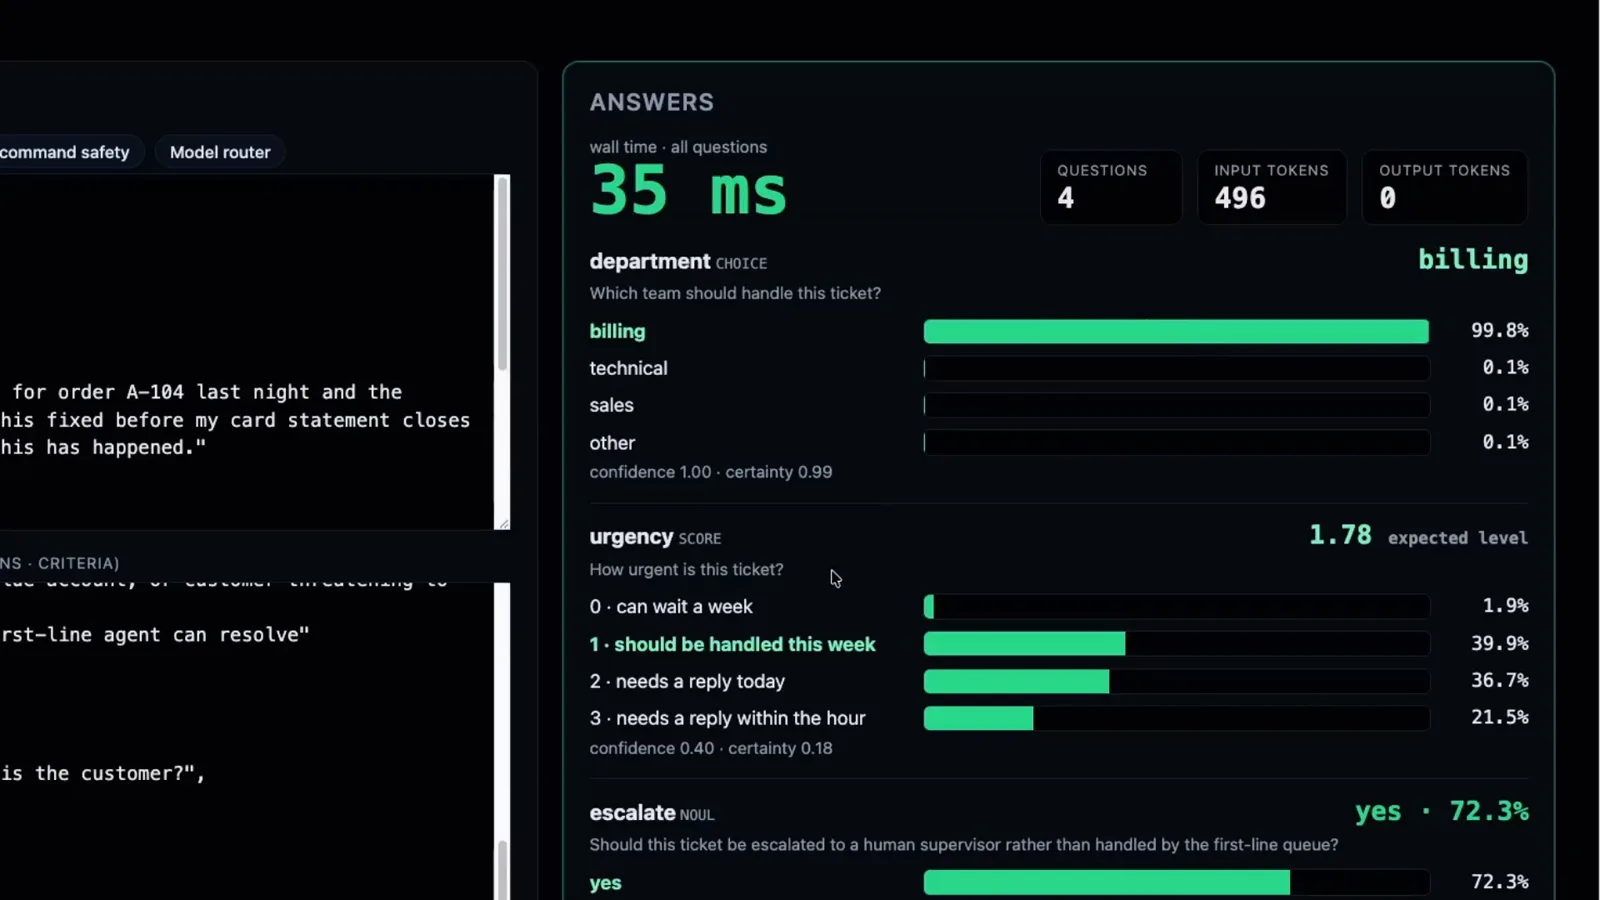
Decider 的 ANSWERS 面板:billing 99.8%、平均约 33 毫秒、escalate 72.3%。跳转至 12:00 - 5
体验 DiffusionGemma 的批量分类吞吐
DiffusionGemma 是完全不同的物种:一个 26B 的扩散语言模型(本次演示为 RTX Pro 6000 上的 diffusiongemma-26B-A4B NVFP4),每步去噪一整块画布,同时读出所有答案槽位的分布,并通过一个 vLLM PR 接上了 Jev 的 schema 格式。演示里 16 张客服工单以并发 16 一次齐发,「boom——直接跑完」,MEASURED 面板测得约每秒 27.4 次决策。Sam 称这个吞吐 insane,还提到它在技术/账单路由和「客户很恼火」的情绪识别上质量在线,只是相比同尺寸的 Gemma、Qwen 同类,他感觉训练欠火候。如果你要做天量问题分类,就是它了。
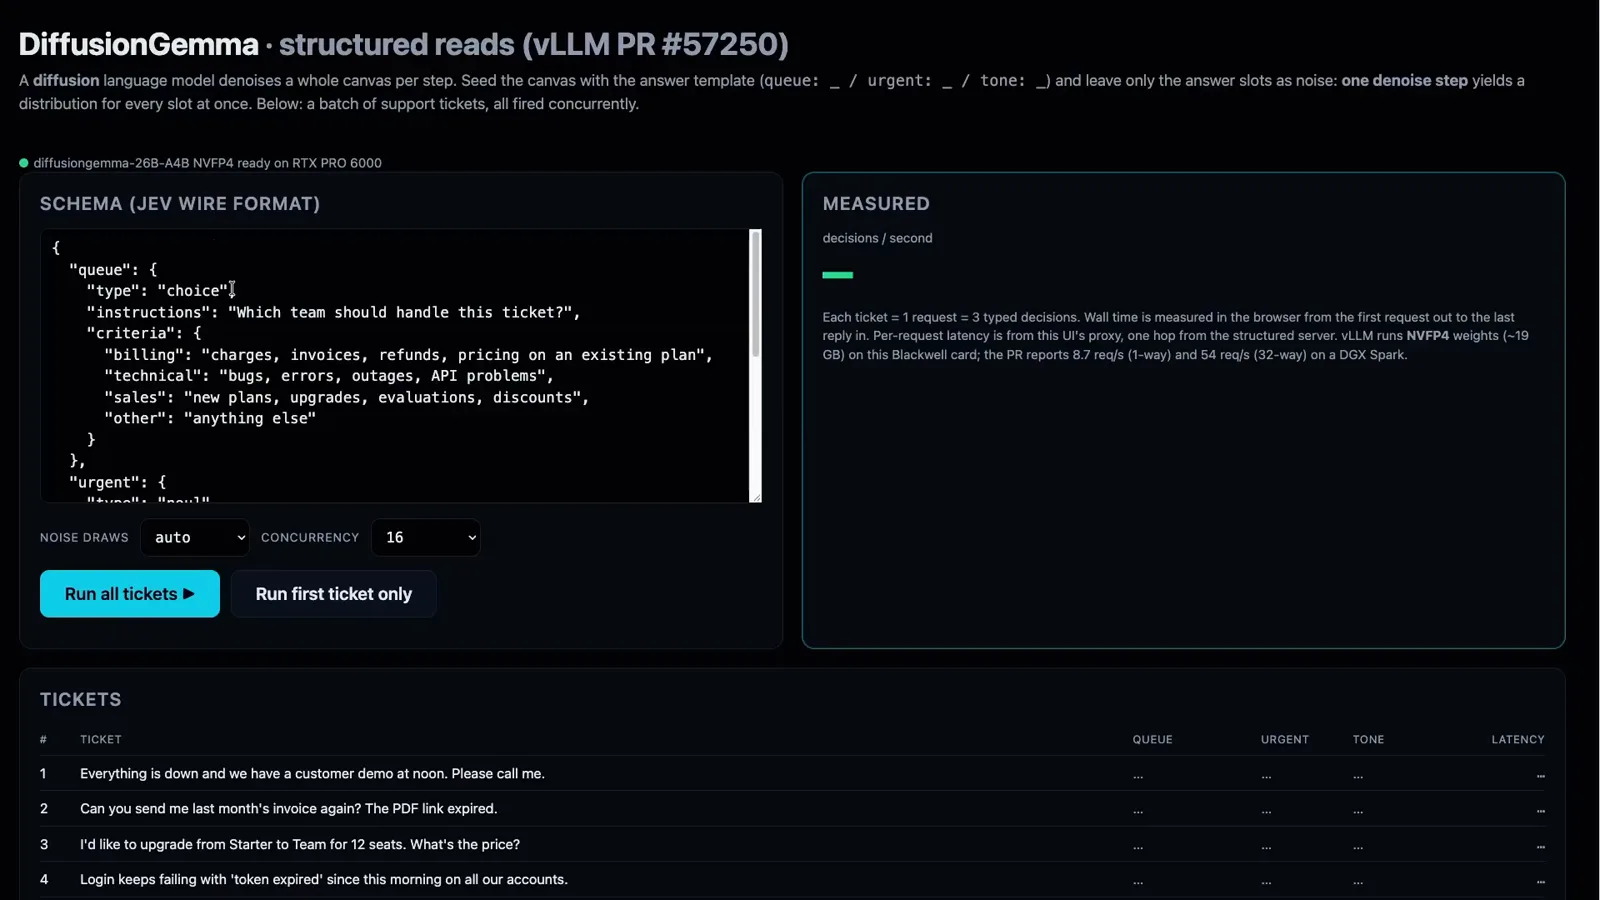
16 张工单、每张一次去噪:DiffusionGemma 实测每秒 27.4 次决策。跳转至 14:48 - 6
在免费 Colab T4 上运行并微调 Laya
Laya 是老路线的新生:一个 421M 参数的非自回归决策模型,基于 ModernBERT-large 加一个 2 层决策头,单次前向约 35 毫秒答完 choice、score、null 三类问题,覆盖约 100 种语言。团队发布了 Google Colab,用 RLCD 策略梯度(log-score + spherical score + ranked probability score)在免费 T4 上微调,FP16 峰值显存约 6.5GB。Sam 的评价:这个体量算得上惊艳,但在只看准确率的 JevBench 权重下它落后于更大的模型——多半因为个人作者在老编码器上做的微调,泛化不过资金充足的实验室。不过在你已有的硬件上,它仍是接触 Jev 式模型最便宜的方式。
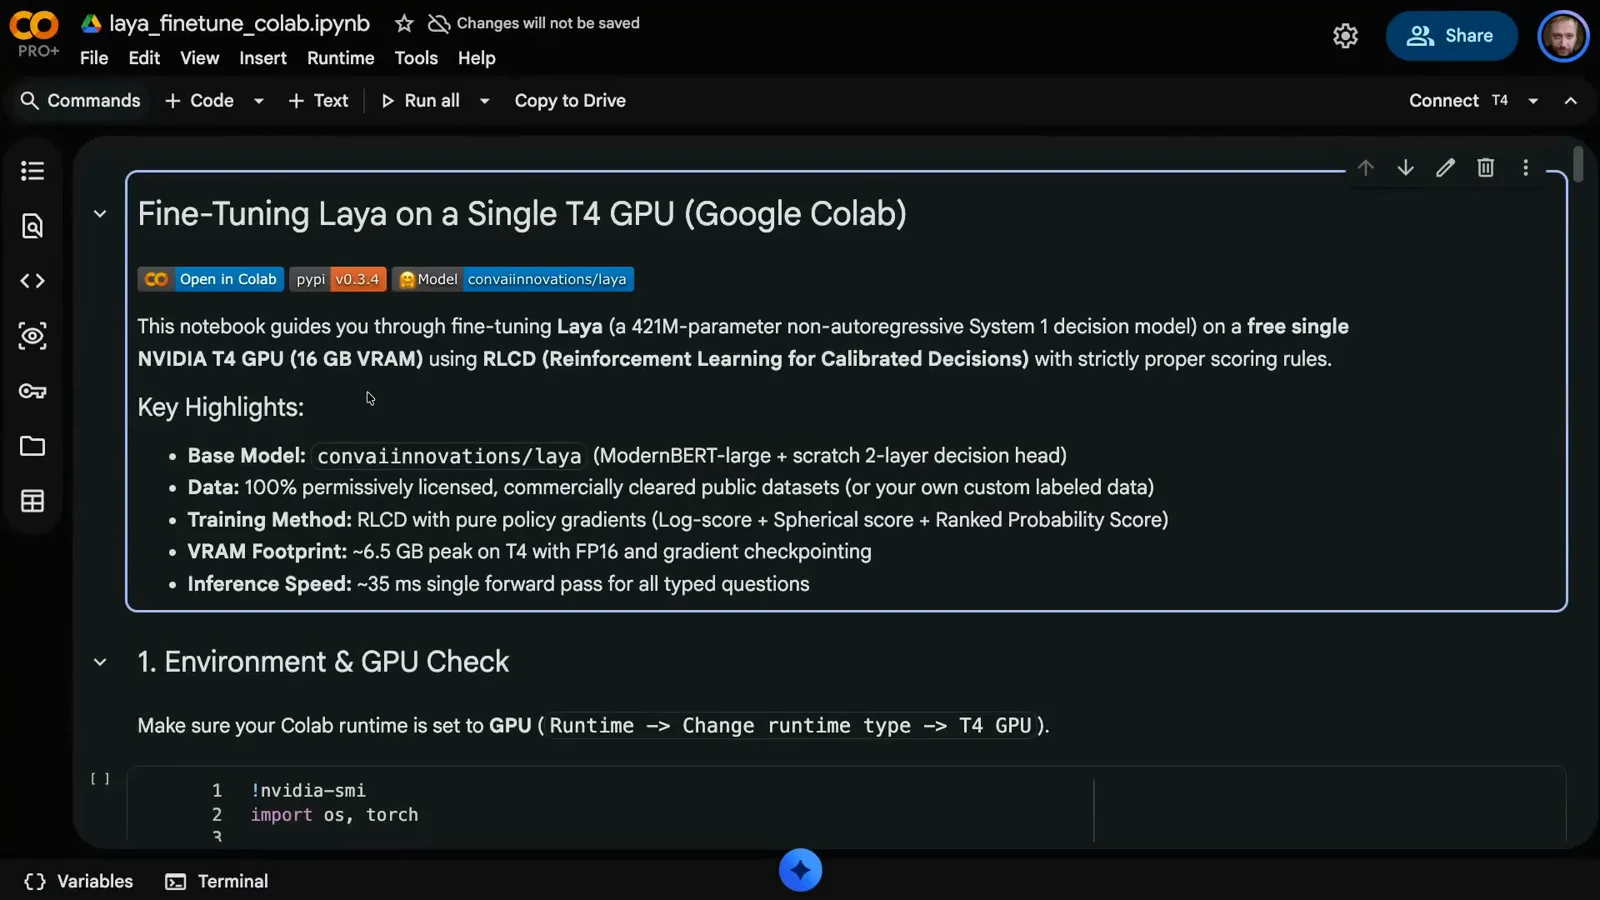
在免费 T4 上微调 Laya(421M 参数):显存约 6.5GB,推理约 35 毫秒。跳转至 18:22
常见问题(FAQ)
开源 Jev 替代品有哪些比较好?
截至这期视频已经有 20-30 个开源实现。JevBench 上最强的是 Semif(冻结 Qwen3.5-4B 的 logits 读出,74.6 对 Jev 的 75.3)、djev(74.3)和 Laya(70.1)。要处理图片输入可以看 Alex Wartega 的 OpenJev,它能根据画面状态玩 Doom 和 Minecraft;Nano Jev 则是一个 600M 参数的小模型,靠网格选项打 Pac-Man 风格的小游戏。
能不能免费在本地跑一个 Jev 式分类器?
可以。Laya 提供了官方 Google Colab,在免费 T4 GPU 上微调并运行一个 421M 参数的模型(峰值显存约 6.5GB,单次前向约 35 毫秒)。Semif 的读出法在你已有的任何模型上都能用;视频里更是把六套实现跑在同一张 RTX Pro 6000 上。
开源 Jev 模型离官方 Jev 有多远?
看 JevBench 综合分非常接近:Jev 75.3 对 Semif 74.6、djev 74.3。但困难档差距就拉开了——Bespoke Nimble 在自己保留集上约 90%,困难档却只有约 44;多跳推理和日期运算这类任务,仍建议级联给推理模型(低/中推理力度即可)兜底。
怎么在自己的数据上微调开源 Jev 模型?
抄 Bespoke Nimble 的对比数据策展作业:成对撰写几乎相同的记录,只翻转一个事实让正确答案翻转,再训练 LoRA——约 3000 条这样的样本就让他们在自己保留集上拿到约 90%(基座 Qwen3.5-9B 约 66%)。Sam 还点名 MiniCPM 5 2B 是这套配方值得尝试的候选基座。