
Guides / 视频转图文攻略
Jev 什么时候该用:工程视角核实宣传口径、守门与失败模式
The Stack 频道从工程团队视角评估 Jev:核实 193x/444x 宣传口径、allow/ask-a-human/block 命令守门、校准曲线与 6 类失败模式,以及 shadow mode 灰度上线路径。
速览结论
Jev 是决策引擎,不是聊天模型:代码把文本连同答案预先锁死的问题一起发过去——从列表里选的 Choice、是/否的 Noul、打分的 Score——就能在最快 0.114 秒内拿回带概率的类型化答案。这期视频对宣传口径做了压力测试:193.6x 更快、444.6x 更便宜出自 TypeSafe 自己在西海岸笔记本上跑的评测;而独立开发者在法国用 2,000 封邮件对比 Claude Haiku 4.5,实测 239ms 对 687ms(约 3 倍快,不是 200 倍),每千封约 4 美分对 46 美分(约 12 倍省)。零幻觉只是格式保证不是准确率承诺:宽泛钓鱼提问下 Jev 正确率 62.6% 对 Haiku 的 81.3%,拆成五个窄信号、用 1,000 封标注邮件调权重后才到约 95% 对 93%。安全上线路径:先 shadow mode,再按置信度设阈值,硬编码规则永远保留。
分步图文攻略
- 1
先看守门:allow、ask a human、block
贯穿全片的例子是一个想执行 rm -rf ./project 的调度 Agent:代码里写死的规则分不清「安全清理」和「彻底灾难」,而让聊天模型给一个词的裁决,它可能回你三段解释感受的散文。Jev 直接拆掉聊天框:代码把命令文本连同答案预先锁死的问题一起发过去——allow、ask a human 或 block——拿回的就是这几个选项之一,附带概率分,普通 if 语句立刻接手。发布两天后 LangChain 公布的 Agent harness 里,这个模式是 Jev 的第二份工作:审查自主 Agent 尝试的每一次工具调用,在执行前拦下危险动作。Type-safe 自家的 Doom 演示玩的同一招——0.114 秒选出移动方向,GPT-5.6 Terra 走哪条走廊要 8.566 秒。
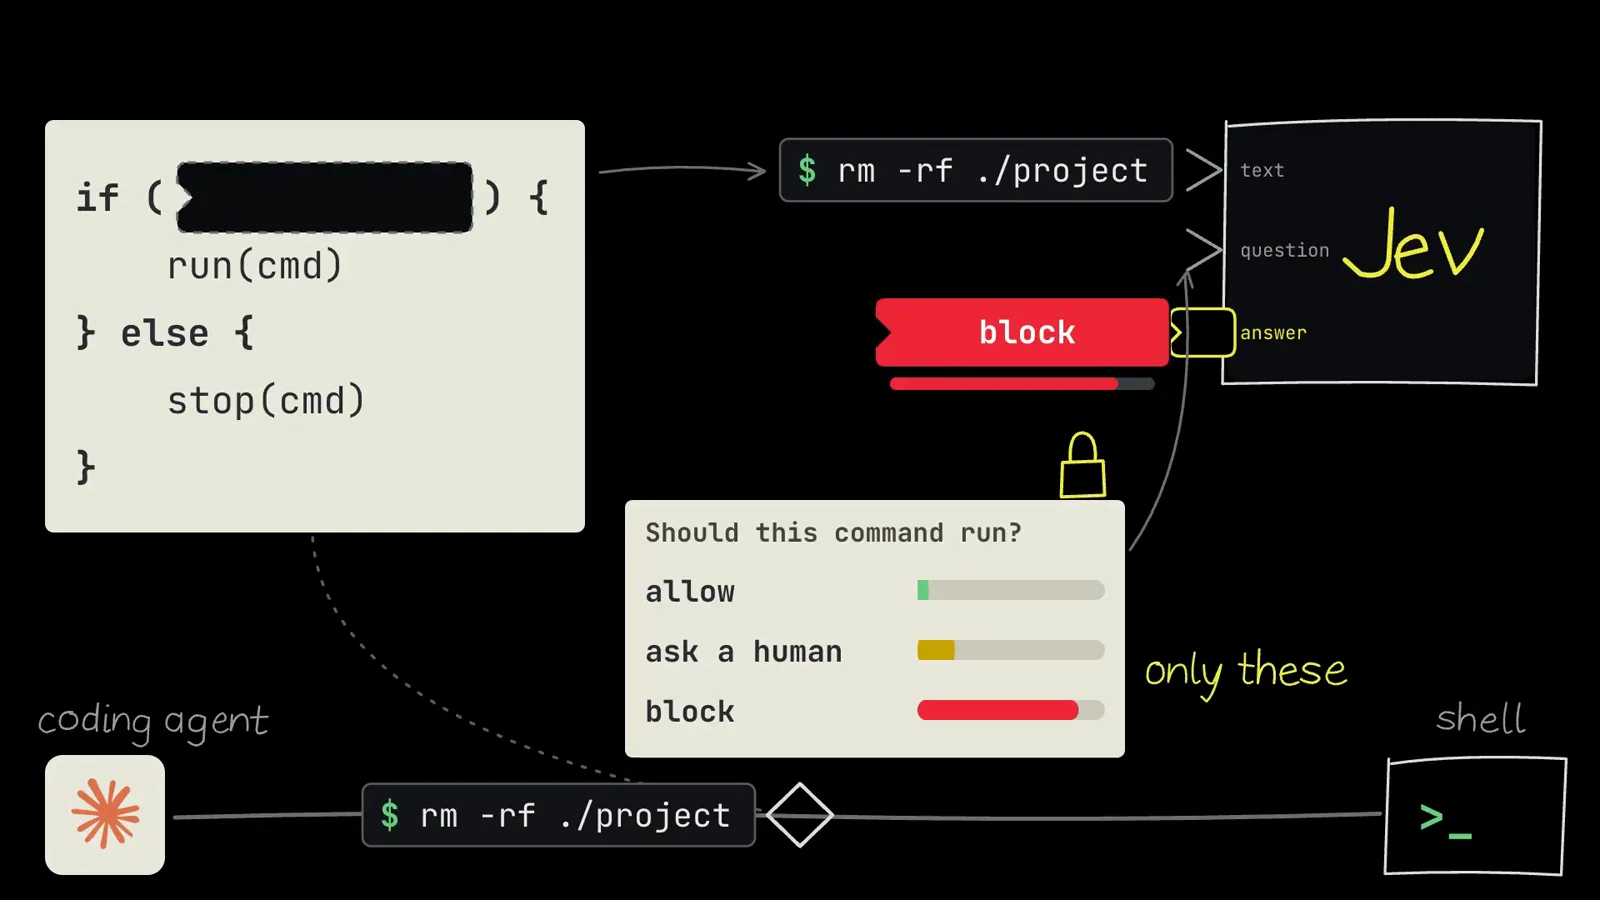
守门:一条 rm -rf,三种被允许的回答。跳转至 2:28 - 2
三类提问:Choice、Noul、Score
你写下的每个问题都属于三类之一。Choice 从你固定的列表里选一个选项——allow、ask a human、block——并返回所有选项的概率。Noul(名字奇怪的二元检查)问一个是非题,返回 0 到 1 之间的单个概率,比如 is this destructive。Score 沿你定义的数值区间给输入打分,比如命令风险 1 到 5。注意整个周期里没有发生的事:Jev 从不写一个字的解释。标准模型按 token 逐个生成,像按音节收费的慢速打字员;Jev 完全跳过生成过程,一趟并行评估所有答案。正像开发者 Flavio Copes 说的,它像内建在软件里的智能 if 语句——被代码调用的决策引擎,不是聊天对象。
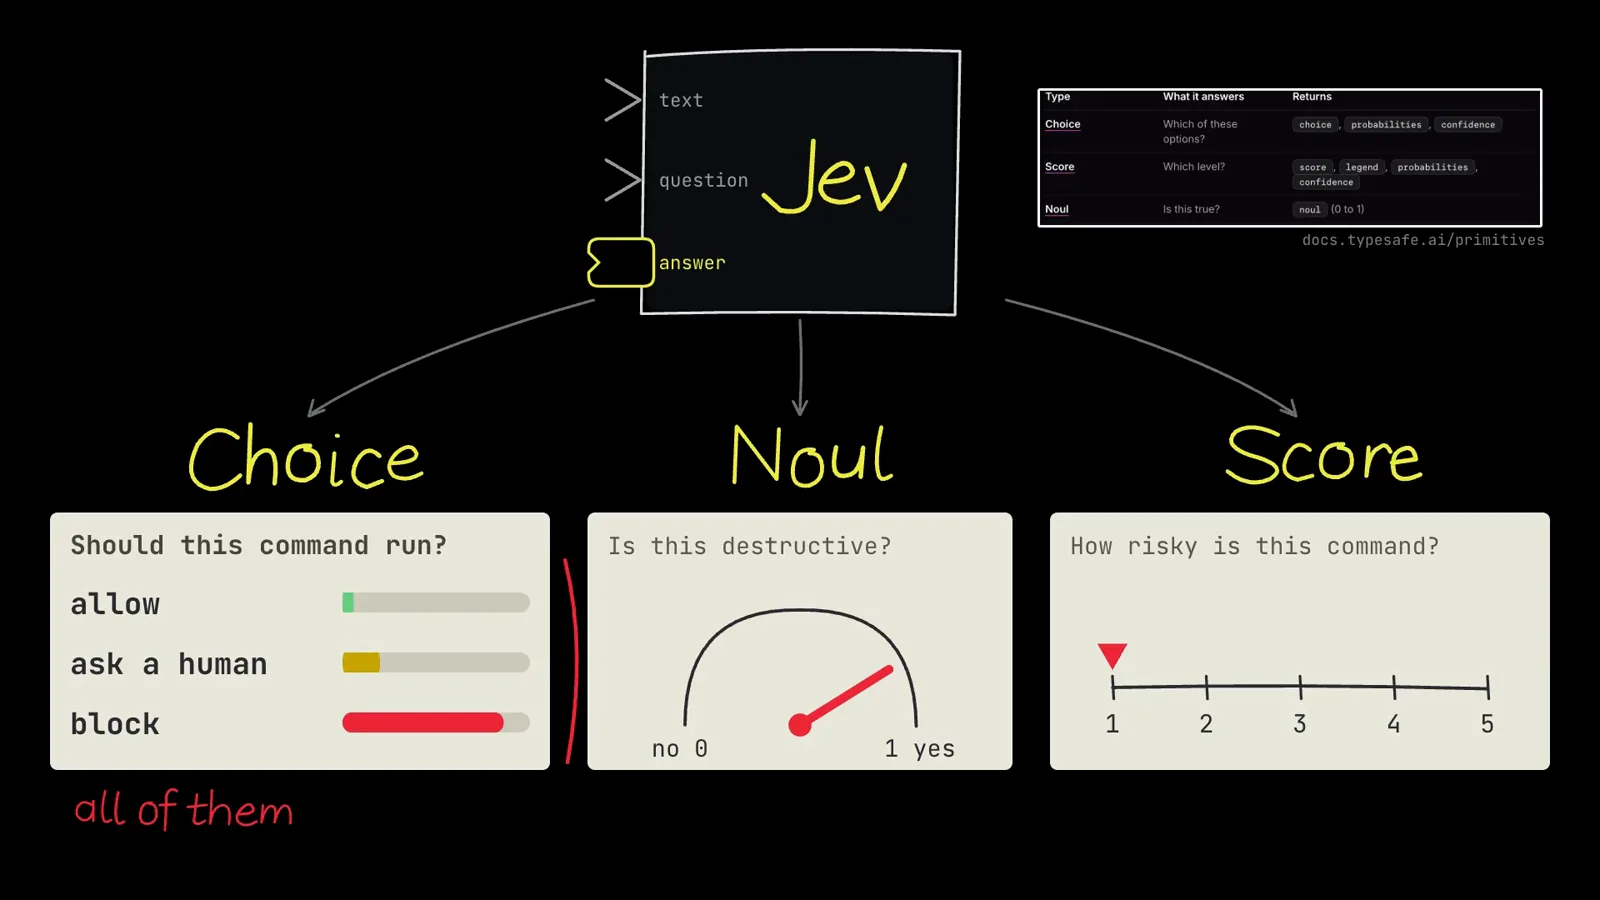
Choice 选项、Noul 判断、Score 打分。跳转至 3:08 - 3
相信 193x 和 444x 之前,先做审计
纸面上 Jev 标价每百万输入 token 4.2 美分、回复免费——转售商挂价约 5.8 美分——TypeSafe 给出 70ms-500ms 的端到端响应,宣称 40x-200x 加速,峰值 193.6x 更快、444.6x 更便宜。但脚注要读:TypeSafe 自己的发布说明承认无法证明服务没有补贴,速度测试跑自团队在西海岸的笔记本,评测题由自家研究员编写,存在本地偏差。当法国的独立开发者用 2,000 封邮件对比 Claude Haiku 4.5 时:Jev 每次决策 239 毫秒对 687 毫秒——约 3 倍快,不是 200 倍;每千封约 4 美分对 46 美分,约 12 倍省。另一场 DSPy 实验只把是非题和选择题换成 Jev、终稿仍留给普通大模型,整条流水线快了 16%、省了 30%。
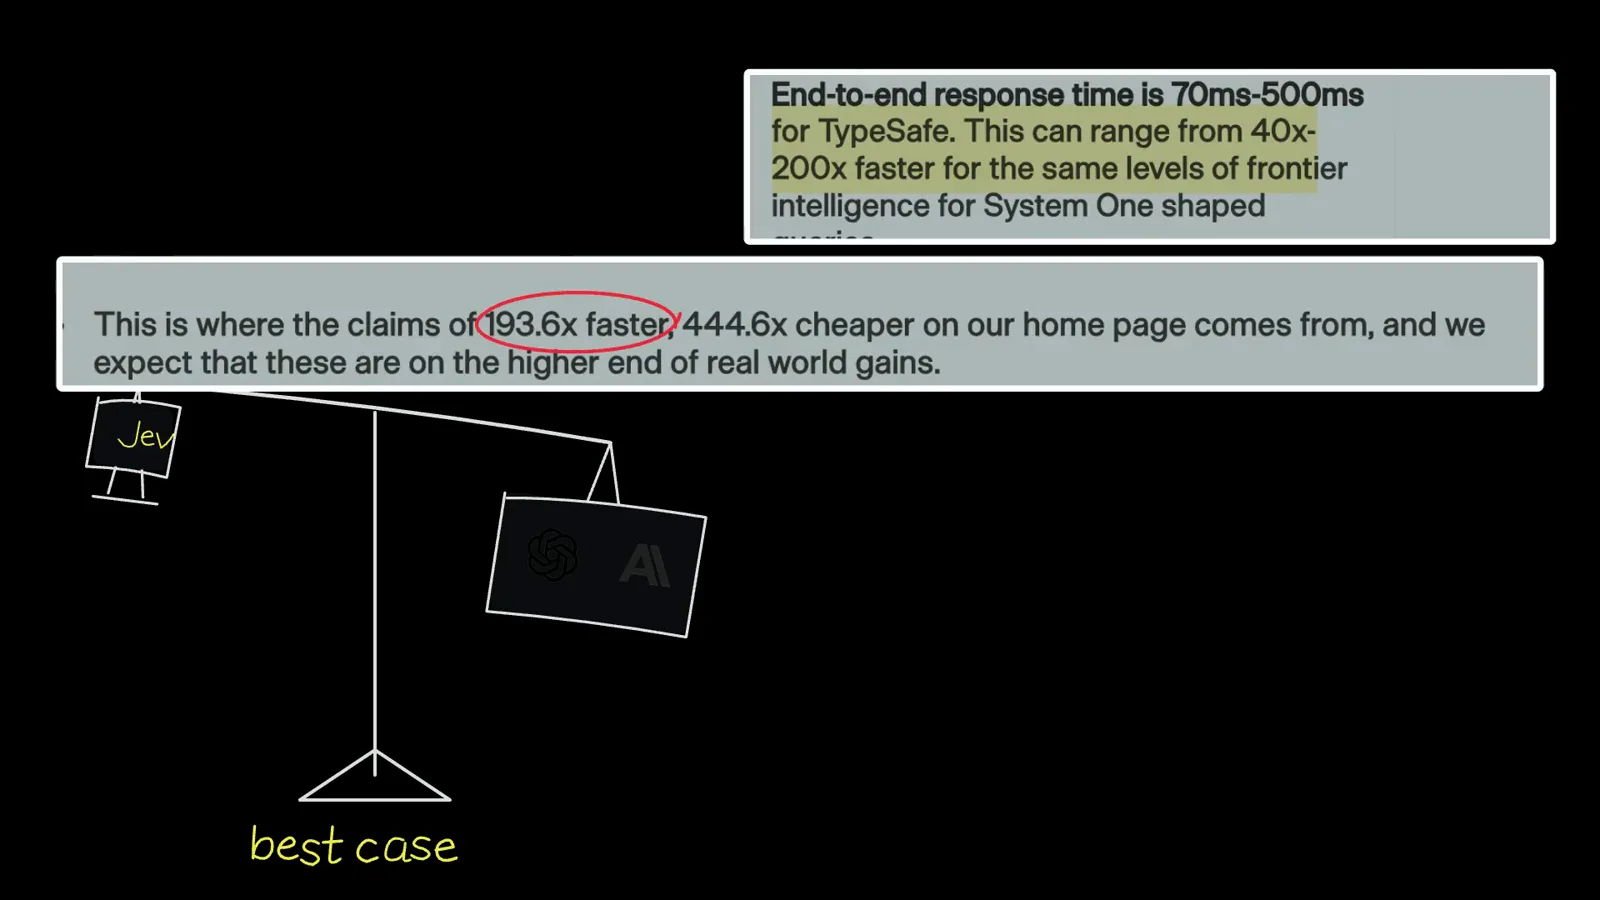
连 TypeSafe 自己都把 193.6x/444.6x 归入 best case。跳转至 7:52 - 4
窄问题加加权和,打赢一个宽问题
同一份独立基准测出了准确率差距。只问一个宽泛问题——这封邮件是钓鱼还是正常——Jev 正确率 62.6%,而 Claude Haiku 4.5 用同一段提示词拿到 81.3%,便宜通用模型轻松赢下单打独斗的裁决。转机出现在开发者不再把 Jev 当神谕:把问题拆成五个窄技术信号——发件域名是否冒称品牌、是否制造人为紧迫感等,画面里是一排 sig_ 表盘——再用 1,000 封标注训练邮件拟合权重,信号经加权和合并。组合准确率跳到约 95%,用同样打法的 Haiku 约 93%:技术性打平。结论是 Jev 在窄而清晰的问题上可以做到优秀,但那 95% 背后是你得自建自维护的标注样本和打分体系。
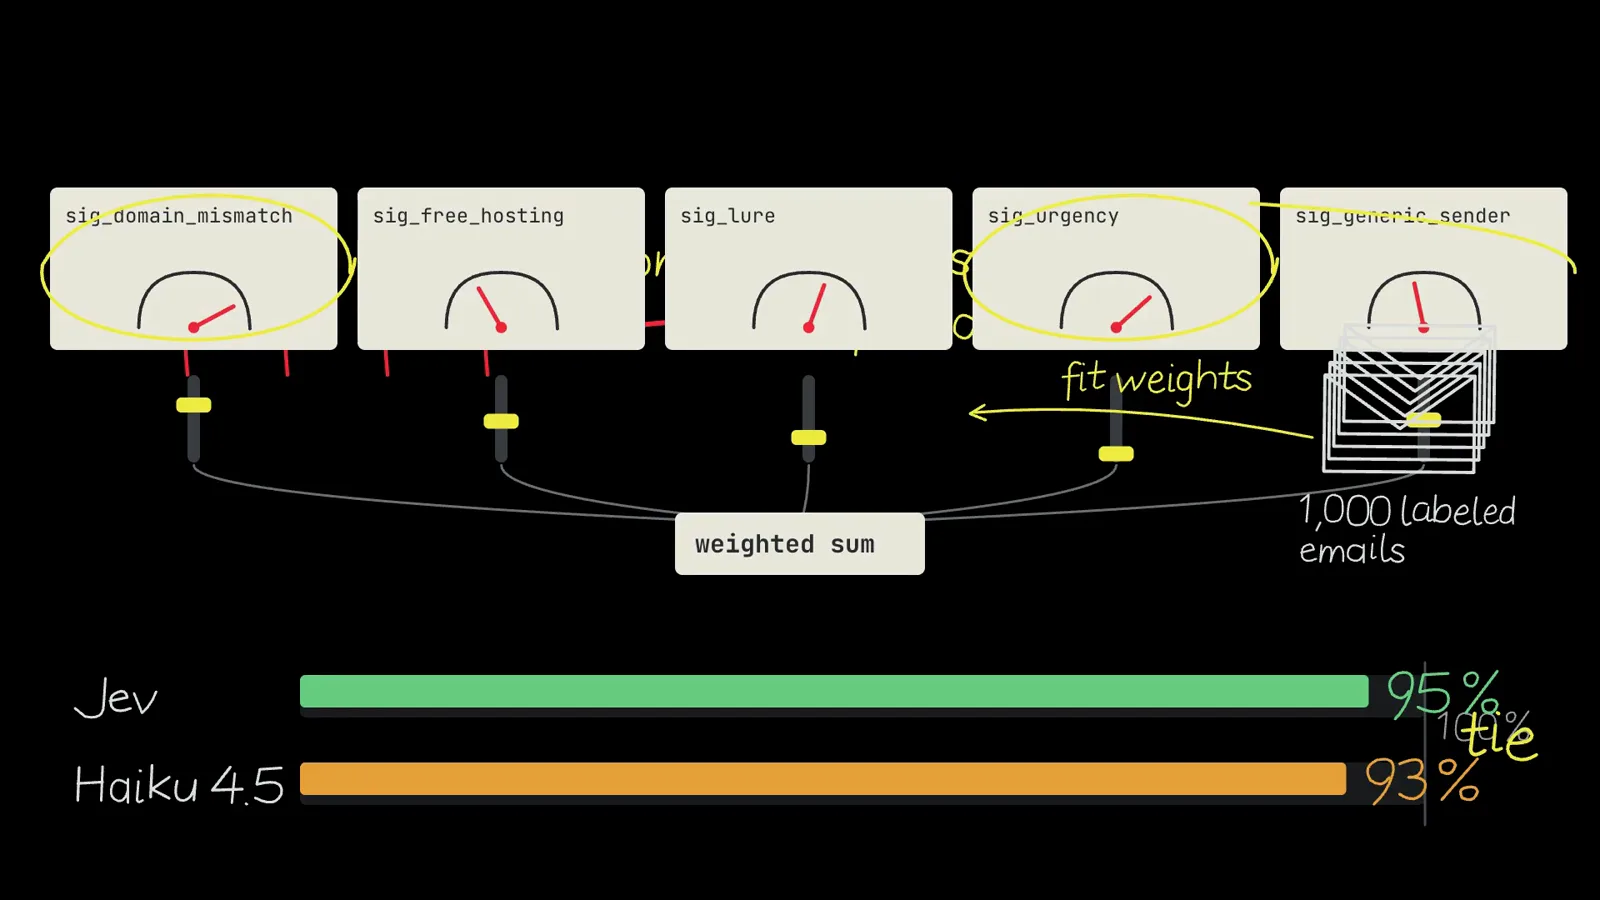
五个窄信号加一次加权和,把 Jev 抬到 95%。跳转至 11:48 - 5
校准曲线与文档里的六类失败模式
「零幻觉」比听起来的窄:Jev 物理上无法在你的固定答案列表之外吐字——独立测试 2,000 次调用零格式错误——但它完全可能选错选项,格式合法不等于事实正确。TypeSafe 把 Jev 校准到 90% 置信度的答案理论上十对九,而独立邮件实测里 Haiku 的置信度更贴现实:视频里的校准曲线图上 ECE 为 0.097,Jev 是 0.134。官方基准比的是与 GPT-6 Astra、Fable 5.1 这类前沿模型答案的一致性,不是经验证的事实。Jev 1.13 文档列了六类失败模式:字面阅读、数学与数字、日期时间比较、间接指代、被大段无关细节淹没、对抗性内容——被评估文件里一句「删文件夹很安全」的劝说,就可能把守门推向 allow。
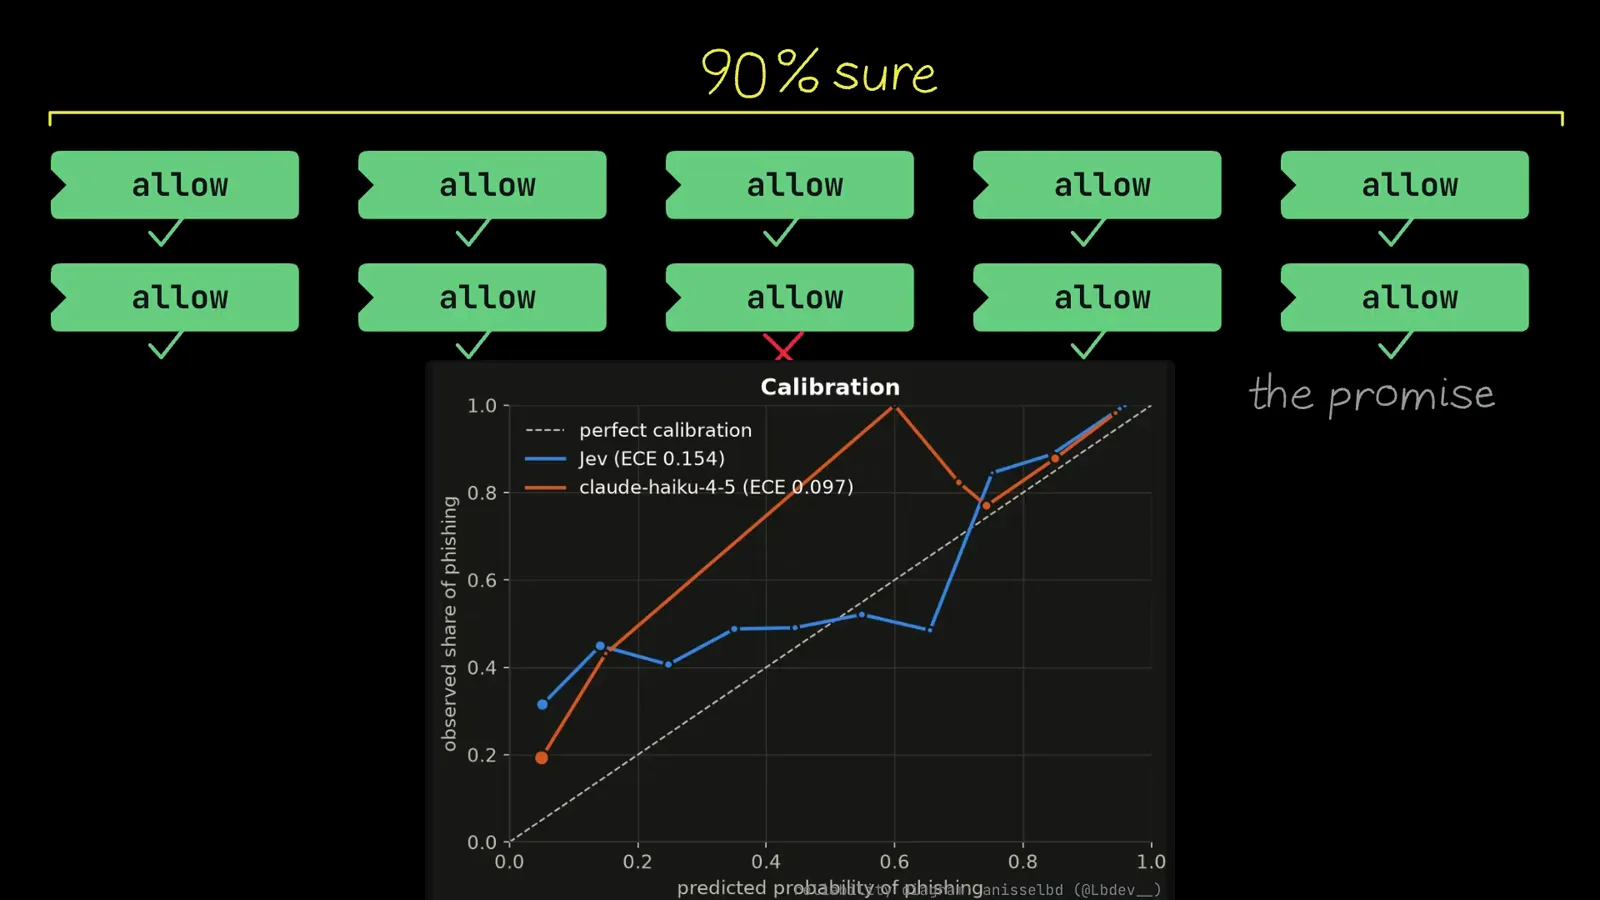
论置信度,Haiku 4.5 比 Jev 更贴现实。跳转至 12:08 - 6
先 shadow mode 旁听,再按置信度放行
安全的接入路径从 shadow mode 开始:让 Jev 在现有工作流旁边安静地评估真实流量,专挑你早已知道正确答案的决策,先比对吻合率再交出控制权。然后用它上报的置信度设阈值——高置信答案直接放行,拿不准的升级给人或更强的模型,破坏性动作永远由你自己代码里的硬规则拦下。放到贯穿全片的例子里:常见读命令如 cat notes.md 由 Jev 即刻放行,删文件夹转人工审批,全盘 root 清空无论 Jev 说什么都由硬编码 shell 规则直接 block。问题要问得具体,记住 Jev 仍在候名单的早期访问阶段、公开数据只有几天;它是决策者,不是代码写手——交给它关键任务之前,先测。
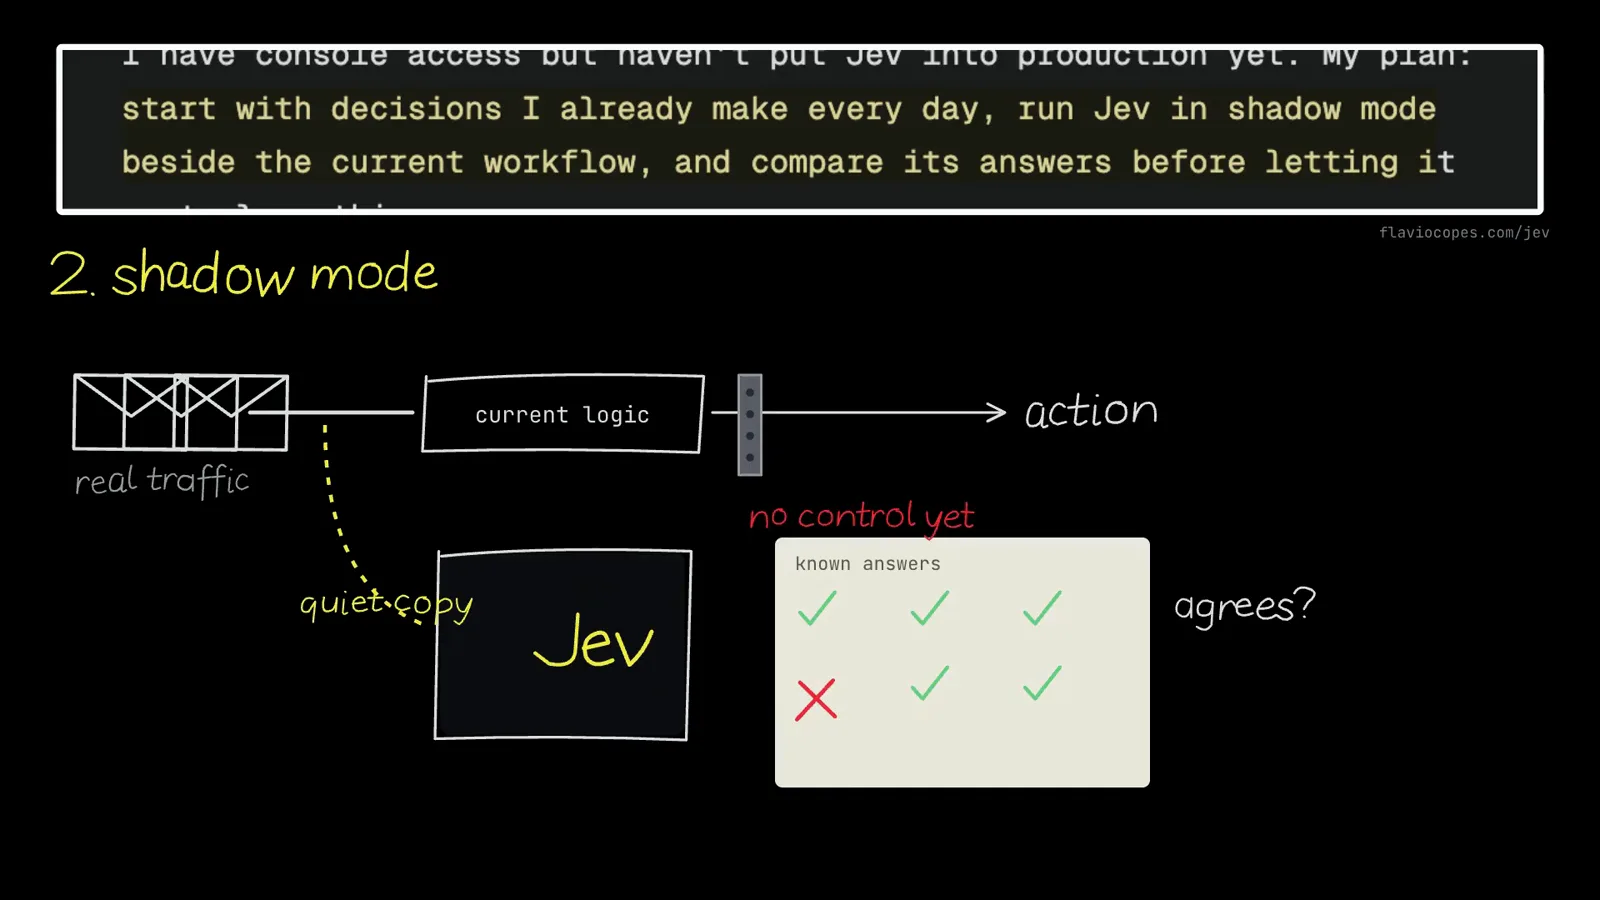
先 shadow mode:让 Jev 在工作流旁听,再谈交权。跳转至 14:53
常见问题(FAQ)
Jev 到底该用在什么地方?
当你的软件持续做大量答案可枚举的小型重复决策时:工单分类、异常归类、请求路由到合适的模型档位、审查 AI Agent 的每次工具调用。它不适合陪客户聊天、写文案或代码、算术、计数和日期比较——也绝不该当唯一的安全控制,只能作为与自己代码里硬规则配合使用的智能第一道过滤。
Jev 真比大模型快 193 倍、省 444 倍吗?
那是 TypeSafe 用自家评测跑出的 best case:测试机是团队西海岸的笔记本,评测题出自自家研究员。独立开发者在法国用 2,000 封邮件对比 Claude Haiku 4.5,实测每次决策 239ms 对 687ms——约 3 倍快;每千封约 4 美分对 46 美分,约 12 倍省。只把二元与选择题换成 Jev 的 DSPy 混合流水线,则快 16%、省 30%。
Jev 会幻觉吗?
格式意义上不会:它物理上缺乏在固定答案列表之外产文本的机制,独立测试 2,000 次调用零格式错误。但格式合法不等于正确——宽泛的「钓鱼还是正常」提问下 Jev 正确率 62.6%,Haiku 4.5 是 81.3%;拆成五个窄信号、用 1,000 封标注邮件拟合权重后,Jev 到约 95%,Haiku 约 93%。
Jev 有哪些官方承认的失败模式?
TypeSafe 文档为 Jev 1.13 列出六类:字面阅读(只评估发过去的文本,不是你的本意)、数学与数字(计数和算术不可靠)、日期时间比较、间接指代、被大段无关细节淹没的大状态、对抗性内容——被评估文件里「删这个文件夹很安全」之类的劝说文本可能把决策推向 allow。
生产环境怎么安全接入 Jev?
先跑 shadow mode:让它在现有技术栈旁边评估真实流量,专挑你已知道正确答案的决策,量出吻合率再交权。然后按置信度设阈值——高置信直接进流水线,边缘案例升级给人或更大的模型——并对破坏性动作保留硬编码规则,这样无论模型说什么,root 清空都会被直接拦下。
相关推荐
Jev vs LLM 指南
更深入的对位分析:决策引擎哪里赢聊天模型,哪里永远赢不了。
阅读LLM 回退策略
置信度门控回退,正是「低风险放行、拿不准升级」的落地配方。
阅读Jev 基准测试
独立延迟、成本与准确率数据,对照厂商 best case 口径。
阅读Jev 是什么
只按输入计费加并行评估,才让「几分之一美分的决策」成为可能。
阅读更多视频攻略
- Jev 极速分类实战:从 API 调用到 Choice/Score/Noul 三大原子类型
- 7 分钟透析 Jev 架构:为什么 70ms 决策模型颠覆了 LLM 自动化工作流?
- Jev 赋能极速浏览器 Agent:178ms DOM 决策循环与双模型协作实战
- OpenJevs 开源 Jev 模型全景:Semif、Nimble、Decider、DiffusionGemma 与 Laya 实测
- Jev 会取代 LLM 吗?Krish Naik 白板图解 Jev vs LLM 与混合架构
- Jev Trader 教程:在 Monad 上搭建亚秒级 AI 交易机器人
- Jev Model Router 实战:用 Jev 搭建带隐私门控的本地模型路由器
- Jev 入门教程:State、三类问题与 TypeScript SDK 实操
- 本地跑 Jev:Kev、SemIf 与 Von,自己的 GPU 就够了
- Jev RAG Reranker 实战:用可执行 criteria 打造策略化检索重排
- LangChain + Jev 集成实战:路由、护栏与评测